Kodu göster / gizle
library(readr)
library(dplyr)
library(tidyr)
library(tibble)
library(ggplot2)
library(scales)
library(janitor)IST5109 İleri Aktüerya Teknikleri · Sigorta Verileriyle İstatistiksel Programlama
Bir modelin güvenilirliği, onu besleyen verinin anlamı ve kalitesiyle sınırlıdır. Geçen hafta aktüeryal bir soruyu kurmayı ve R’nin temel nesnelerini elle hesaplamayı çalıştık; orada veriyi biz yazmıştık. Bu hafta veri dışarıdan geliyor ve ilk iş onu güvenilecek hâle getirmek. Bu hafta bir otomobil hasar verisini içe aktaracak, sütun adlarını standartlaştıracak, eksik ve yinelenen kayıtları inceleyecek ve ilk grafiklerle verinin öyküsünü kuracağız.
Oturum sonunda öğrenci:
janitor ile tutarlı hâle getirir;names(), glimpse() ve eksiklik özetleriyle veri yapısını denetler;dplyr ile türetilmiş değişken ve grup özeti üretir;| Süre | Etkinlik |
|---|---|
| 0–25 dk | Ham veri neden doğrudan modellenmez; veri sözlüğü: bir satır ne, sütunlar ne, veri neyi yanıtlayamaz |
| 25–50 dk | Dosyayı indirmek ve okumak, sütun adları ve kalite denetimi |
| 50–85 dk | Eksikliğin mekanizması: MCAR, MAR ve MNAR; ki-kare bağımsızlık testi |
| 85–95 dk | Ara |
| 95–125 dk | Eksik değer için beş yöntem, mice ve duyarlılık analizi; veri denetimi, yinelenen kayıt ve kimlik, kararları uygulamak: analiz tablosu |
| 125–135 dk | Hasar tutarının dağılımı: doğrusal ve log eksen; kuyruğun payı |
| 135–175 dk | AutoBi R laboratuvarı |
| 175–180 dk | Haftanın özeti ve açık sorular |
Sık görülen sorunlar şunlardır:
Ankara, ANKARA, ankara),0, -99, boş metin veya NA ile gösterilmesi,Temizleme “istenmeyen satırları silmek” değildir. Her kararın veri sözlüğü ve analiz amacıyla savunulabilmesi gerekir.
auto_claims.csv neyi anlatıyor?Bir dosyayı açmadan önce ne olduğunu bilmek gerekir. Bu haftanın her temizleme kararı “veri sözlüğü ne diyor?” sorusuna dayanacak; o hâlde sözlüğü önce yazalım.
Kaynak. insuranceData::AutoClaims — ABD otomobil kasko (maddi hasar) dosyası, tarihsel bir öğretim verisi: insuranceData 1.0 paketi (CRAN), GPL-2 lisanslı; kopyanın alındığı tarih 24 Ağustos 2026. Bu bilgilerin kaydı data_manifest.csv dosyasındadır. Güncel bir tarife çıkarımı için kullanılmaz.
Dosyanın kendisi. auto_claims.csv dosyasını buradan indirebilirsiniz — 6.776 satır, 6 sütun. Notu okumak için indirmeniz gerekmez; aşağıdaki bütün çıktılar sayfada hazır. Kodu kendi bilgisayarınızda çalıştırmak isterseniz gerekir.
Bir satır ne demek? Bir satır bir hasar kaydıdır — bir poliçe değil, bir sigortalı değil. Bu ayrım haftanın en çok tekrarlanan uyarısının kaynağıdır. Dosya düzenli veri (tidy data) biçimindedir:
| Sütun | Anlamı | Birim / kodlama |
|---|---|---|
claim_no |
Hasar kimliği | H00001 … H06773; benzersiz değildir — aynı numaranın iki kez geçmesi bu haftanın konularından biridir |
state |
Eyalet kodu | 13 düzeyli sırasız kategorik: STATE 01–STATE 04, STATE 06, STATE 07, STATE 10–STATE 15, STATE 17 — 05, 08, 09 ve 16 bu dosyada yoktur |
class |
Tarife sınıfı | 18 düzeyli kategorik (C1, C6, F11, …); paketin belgesine göre sürücünün yaşı, cinsiyeti, medeni durumu ve aracın kullanım biçimine dayanan risk sınıfı |
gender |
Sigortalının cinsiyeti | F / M |
age |
Sigortalının yaşı | Tam yıl; bu dosyada 50–97 — yaşlı sürücülerden seçilmiş bir alt küme |
claim_amount |
Ödenen hasar tutarı | Kaynaktaki dolar değerleri; derste birimi TL diye okuyoruz, kur çevrimi yapılmadı. Kaynakta PAID adıyla geçer |
Hangi soruyu soruyoruz? Bu hafta tek bir soru: hasar tutarının dağılımı nasıl ve bu dağılımı özetlerken hangi kararlar sonucu değiştirir?
Dosyada yalnızca gerçekleşmiş hasarlar vardır. Hasar bildirmemiş poliçeler ve poliçelerin maruziyet süreleri yoktur. Dolayısıyla:
claim_no bunu değiştirmez: kimlik hasarları sayar, poliçeleri değil.Bu hafta bu ölçüleri hesaplamayacağız; frekans modellemesi için uygun veri yapısını sonraki haftalarda ayrıca kuracağız.
Notun sayıları auto_claims.csv’den, laboratuvarınkiler auto_bi.csv’den gelir. Dosyalar dönem boyunca değişmez. Bunun tek bir amacı var: herkes aynı kodu çalıştırdığında aynı sayıyı görsün. İkisinin kaynağı da insuranceData paketidir, ama paketten yeni bir kopya almak iki dosyada farklı sonuç verir:
auto_claims.csv, paketteki AutoClaims tablosundan türetildi ama onunla aynı değildir: satır sayısı, sütunları ve eksik değerleri farklıdır, bu sayfanın sayıları da onunla tutmaz.auto_bi.csv, paketteki AutoBi tablosuyla aynı değerleri ve aynı eksikleri taşır; tek farkı sütun adlarıdır. Pakette adlar büyük harfle yazılır (CLMAGE, ATTORNEY, …); laboratuvarın kodu bu dosyanın küçük harfli adlarını (clmage, attorney, …) aradığı için o tabloda çalışmaz. Kodu kendi bilgisayarınızda çalıştırmak isterseniz iki dosyayı buradan indirebilirsiniz:
Bağlantıya tıkladığınızda dosya doğrudan bilgisayarınıza iner. Dersin bütün veri dosyaları ayrıca tek bir depoda durur; hepsini birden oradan ZIP olarak indirebilirsiniz.
İndirdiğiniz dosyaları betiğinizin yanında bir data/derived/ klasörüne koyarsanız aşağıdaki yollar olduğu gibi çalışır.
Bu haftada kullanılan paketleri en başta açıyoruz:
library(readr)
library(dplyr)
library(tidyr)
library(tibble)
library(ggplot2)
library(scales)
library(janitor)R’nin kendisiyle gelen mean(), nrow() gibi işlevler her oturumda hazırdır; bu haftanın işlevlerinin çoğu değildir:
library(readr) — tek bir paketi o oturum için açar, yani içindeki işlevleri adlarıyla çağrılabilir hâle getirir; her yeni R oturumunda tekrarlanması gerekir. Yazılmazsa çağrı could not find function "read_csv" hatasıyla durur.veri_yolu <- file.path("data", "derived", "auto_claims.csv")
bi_yolu <- file.path("data", "derived", "auto_bi.csv")
c(auto_claims = file.exists(veri_yolu), auto_bi = file.exists(bi_yolu))#> auto_claims auto_bi
#> TRUE TRUEYukarıdaki iki yol işlevi de dosyanın içeriğine dokunmaz:
file.path("data", "derived", "auto_claims.csv") — verilen parçaları eğik çizgiyle birleştirip tek bir yol metni üretir; R bu biçimi Windows’ta da kabul eder. Yolu ters bölülerle elle yazmak ise risklidir: ters bölü R metinlerinde kaçış karakteridir, bu yüzden bazı harflerin önünde satır hata verip durur, bazılarının önünde ise sessizce bambaşka bir metne dönüşür.file.exists(veri_yolu) — o yolda bir dosya bulunup bulunmadığını sorar. TRUE, orada bir dosya olduğunu söyler, doğru dosya olduğunu değil.İki değerin de TRUE olması gerekir. Biri FALSE ise o dosya beklenen yerde değildir: yukarıdaki bağlantıdan indirip klasör adını denetleyin. Kaynağından yeni bir kopya indirmeyin — o kopya bu dersin kopyasıyla aynı değildir.
Önce dosyayı okuyup sütun adlarını geldiği hâliyle görelim:
ham <- read_csv(veri_yolu, show_col_types = FALSE)
names(ham)
#> [1] "Claim No" "State" "CLASS" "Gender" "Age"
#> [6] "Claim Amount"Çıktıda Claim No, State, CLASS, Gender, Age ve Claim Amount adlarını görmelisiniz — dosyanın başlık satırı diskte tam olarak böyledir.
Okuma işini read_csv() yapar; sonucu ham adına bağlıyoruz:
read_csv(veri_yolu) — virgülle ayrılmış bir metin dosyasını satır–sütun düzeninde bir veri tablosuna çevirir ve o tabloyu döndürür.show_col_types = FALSE — okunan veriyi değil yalnızca ekrana yazılanı etkiler: readr’ın her okumada bastığı sütun türü raporunu susturur. Bu argüman olmadan, kodu kendi bilgisayarınızda çalıştırdığınızda, hangi sütunun metin hangisinin sayı okunduğunu bildiren o rapor da ekrana gelir; bu sayfada ise çıktılar sade tutulduğu için görünmez. Okunan tablo iki durumda da aynıdır.Altı adın altısı da sorunlu: State ve CLASS büyük harf karışımı, Claim No ile Claim Amount ise boşluk içeriyor. Boşluklu bir adı R’de kullanmak için her seferinde ters tırnak gerekir — ham$`Claim Amount` — ve bu ad uyuşmazlığı yüzünden ham$claim_amount yazan her satır NULL döndürür: tibble yalnızca bir uyarı verir, kod durmaz.
make_clean_names() hepsini tek biçime çevirir:
names(ham) <- make_clean_names(names(ham))
names(ham)
#> [1] "claim_no" "state" "class" "gender" "age"
#> [6] "claim_amount"Artık altısı da küçük harf ve snake_case biçiminde: bu biçim bir adı küçük harfe çevirir ve boşlukları alt çizgiyle değiştirir, yani Claim Amount adını claim_amount yapar. Yalnızca adı standartlaştırır; sütunun değerlerini veya anlamını değiştirmez. Bundan sonraki bütün kod bu adları kullanır.
glimpse(ham)#> Rows: 6,776
#> Columns: 6
#> $ claim_no <chr> "H00001", "H00002", "H00003", "H00004", "H00005", "H00006…
#> $ state <chr> "STATE 14", "STATE 15", "STATE 15", "STATE 15", "STATE 15…
#> $ class <chr> "C6", "C6", "C11", "F6", "F6", "F6", "C11", "C6", "C11", …
#> $ gender <chr> "M", "M", NA, "F", "M", "M", "M", "M", "M", "M", "M", "M"…
#> $ age <dbl> 97, NA, 95, NA, 95, NA, 94, 94, NA, 93, 93, 93, NA, 92, 9…
#> $ claim_amount <dbl> 1134.44, 3761.24, 7842.31, 2384.67, 650.00, 391.12, 3775.…glimpse() başlığında 6.776 satır ve altı sütun — claim_no, state, class, gender, age, claim_amount — görmelisiniz.
glimpse() yapıyı gösterir: kaç satır, kaç sütun, her sütun hangi türde. Satırların kendisine bakmak için head() kullanılır — ilk altı satırı tablo biçiminde verir:
head(ham)#> # A tibble: 6 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842.
#> 4 H00004 STATE 15 F6 F NA 2385.
#> 5 H00005 STATE 15 F6 M 95 650
#> 6 H00006 STATE 15 F6 M NA 391.İkisi birbirinin yerine geçmez. glimpse() çıktısında age sütununun ikinci değerinin NA olduğunu fark etmek zordur; head() tablosunda hemen görünür. Yeni bir dosyayı açtığınızda ikisine de bakın.
Veri sözlüğünde altı sütun bekliyorduk; names() ve head() çıktıları altısını da gösteriyor. Sözlükle dosya uyuşuyor, devam edebiliriz.
Bir sütundaki eksik değer sayısı:
sum(is.na(ham$claim_amount))#> [1] 133133 çıkmalıdır. Aynı satır, öğretim için eksik değer eklenmemiş kaynak veride (insuranceData::AutoClaims) 0 verirdi.
Tek tek saymak yerine tek bir zincir kuruyoruz. Bütün sütunlar için:
eksik_ozeti <- ham |>
  summarise(across(everything(), ~ sum(is.na(.x)))) |>
  pivot_longer(
    cols = everything(),
    names_to = "degisken",
    values_to = "eksik_sayi"
  ) |>
  arrange(desc(eksik_sayi))
eksik_ozeti
#> # A tibble: 6 × 2
#> degisken eksik_sayi
#> <chr> <int>
#> 1 age 599
#> 2 gender 297
#> 3 claim_amount 133
#> 4 claim_no 0
#> 5 state 0
#> 6 class 0Zincirin ilk halkası iki yeni işlevden oluşuyor:
summarise() — bir veri çerçevesinden özet üretir: içeri tablonun tamamı girer, dışarı yalnızca hesaplanan değerlerden oluşan yeni bir tablo çıkar; özgün satırlar çıktıda yer almaz.across(everything(), ~ sum(is.na(.x))) — “aynı işlemi her sütuna uygula” demenin yoludur. İlk argümanı işlemin hangi sütunlara uygulanacağını söyler; everything() hepsini seçer. İkincisi ne yapılacağını söyler: ~ ile başlayan kısa tarifte .x sırayla her sütunun yerine geçer. across() olmadan her sütunun adı elle yazılıp her biri için ayrı bir sum(is.na(...)) satırı kurulurdu.Tabloyu sıraya sokan iki çağrı şudur:
arrange() — sıralamayı yapar.desc() — sıralamanın yönünü belirler: en çok eksik veren değişken başa gelir. age 599, gender 297, claim_amount 133; claim_no, state ve class 0. Verilmezse: sıralama artan olur, başa hiç eksiği olmayan sütunlar geçer, age en sona düşer. Eksiklik tek bir sütunda toplanmadığı için sıralama gerçekten iş yapar — otuz sütunlu bir veride hangi sütunun sorunlu olduğunu tek bakışta görmek için tablo bu yüzden sıralanır.
Yukarıdaki zincir üç işlemden oluşuyor. Her adımı ayrı bir nesneye alıp yazdırdığımızda tablonun biçiminin nasıl değiştiği görünür.
Önce her sütundaki eksik sayısını sayıyoruz. Sonuç, her değişkenin bir sütun olduğu tek satırlık geniş bir tablodur — 1 satır, 6 sütun:
eksik_genis <- ham |>
  summarise(across(everything(), ~ sum(is.na(.x))))
eksik_genis
#> # A tibble: 1 × 6
#> claim_no state class gender age claim_amount
#> <int> <int> <int> <int> <int> <int>
#> 1 0 0 0 297 599 133pivot_longer() bu tek satırı uzun biçime çevirir: artık her değişken bir satır, sayılar tek bir sütunda toplanır — 6 satır, 2 sütun. Üç argümanı da sonucu doğrudan belirler:
cols = everything() — hangi sütunların çevrileceği; burada hepsi.names_to = "degisken" — eski sütun adlarının yazılacağı yeni sütunun adı.values_to = "eksik_sayi" — sayıların gideceği sütunun adı.Son iki argüman verilmezse yeni sütunlar name ve value adlarını alır; tablo yine kurulur ama başlıkları neyi taşıdıklarını söylemez. Asıl biçim değişikliği bu adımdadır:
eksik_uzun <- eksik_genis |>
  pivot_longer(
    cols = everything(),
    names_to = "degisken",
    values_to = "eksik_sayi"
  )
eksik_uzun
#> # A tibble: 6 × 2
#> degisken eksik_sayi
#> <chr> <int>
#> 1 claim_no 0
#> 2 state 0
#> 3 class 0
#> 4 gender 297
#> 5 age 599
#> 6 claim_amount 133Son adım yalnızca sıralar; satır sayısı da sütunlar da değişmez. Sonucu tek zincirle kurduğumuz eksik_ozeti ile karşılaştırıyoruz:
eksik_sirali <- eksik_uzun |>
  arrange(desc(eksik_sayi))
eksik_sirali
#> # A tibble: 6 × 2
#> degisken eksik_sayi
#> <chr> <int>
#> 1 age 599
#> 2 gender 297
#> 3 claim_amount 133
#> 4 claim_no 0
#> 5 state 0
#> 6 class 0Bu son tablo, yukarıdaki tek zincirin ürettiği eksik_ozeti ile aynıdır — karşılaştırıp kendiniz görebilirsiniz.
Asıl sayı ise bu tabloda yok — ve onu görmek için bakış açısını değiştirmek gerekiyor. Tablo sütun sütun sayıyor; oysa bir analiz satır satır çalışır ve tek bir eksik hücre o satırın tamamını tam vaka analizinden (complete-case analysis) düşürür. Aynı veriye bir de satır düzeyinden bakalım:
eksik_tamlik <- c(
  satir = nrow(ham),
  en_yuksek_sutun_orani = round(100 * max(eksik_ozeti$eksik_sayi) / nrow(ham), 1),
  eksik_tasiyan = sum(!complete.cases(ham)),
  yuzde = round(100 * mean(!complete.cases(ham)), 1)
)
eksik_tamlik
#> satir en_yuksek_sutun_orani eksik_tasiyan
#> 6776.0 8.8 993.0
#> yuzde
#> 14.7Çıktıdaki iki oranı yan yana koyun. En çok eksik veren sütun bile satırların yalnızca %8,8’ini etkiliyor; en az bir eksik taşıyan satırların oranı ise %14,7, yani 6.776 kaydın 993’ü. Sütun sütun bakan bir göz veriyi “çoğunlukla tam” sanır; tam vaka analizi ise dosyanın yedide birinden fazlasını sessizce atar. Atamanın (imputation) varlık gerekçelerinden biri bu iki oran arasındaki farktır.
Satır düzeyine geçişi sağlayan işlev şudur:
complete.cases(x) — her satır için “bu satırın bütün sütunları dolu mu?” sorusunu sorar ve satır sayısı kadar TRUE/FALSE döndürür. Başına ! koymak soruyu tersine çevirir, yani en az bir eksik taşıyan satırları işaretler; sum() onları sayar, mean() oranlarını verir.Eksik değerle ne yapılacağı otomatik bir seçim değildir. Eksikliğin nedeni, oranı ve kullanılacak model önemlidir.
Denetim yalnızca kusur aramak değildir; verinin ne olduğunu da ortaya çıkarır. Sayısal sütunların aralığına bakalım:
summary(ham[c("age", "claim_amount")])#> age claim_amount
#> Min. :50.00 Min. : -250.0
#> 1st Qu.:54.00 1st Qu.: 515.7
#> Median :61.00 Median : 983.2
#> Mean :63.05 Mean : 1733.7
#> 3rd Qu.:70.00 3rd Qu.: 2015.8
#> Max. :97.00 Max. :60000.0
#> NA's :599 NA's :133Bu tabloyu üreten işlev şudur:
summary() — bir veri çerçevesine uygulandığında her sayısal sütun için ayrı bir özet sütunu yazar: en küçük değer, birinci çeyrek, medyan, ortalama, üçüncü çeyrek ve en büyük değer alt alta gelir; yalnızca eksiği olan sütunların altına bir de NA's satırı eklenir. O satırın ayrı durması işimize yarar, çünkü summary() çeyrekleri ve ortalamayı yalnızca gözlenen değerlerden hesaplar; aynı sütuna doğrudan uygulanan yalın bir mean() çağrısı ise eksik yüzünden NA döndürürdü.Buradaki asıl bulgu age sütunundadır: en küçük yaş 50, en büyük 97. Bu veri genel bir sürücü portföyü değil, yaşlı sürücülerden oluşan seçilmiş bir alt kümedir. Bu, eksik değer ya da negatif tutar gibi bir kusur değildir; hiçbir temizleme kuralı bunu düzeltmez ve düzeltmemelidir. Yine de sonucu ağırdır: buradan çıkan hiçbir yaş etkisi genel bir portföye taşınamaz. Denetim yalnızca düzeltilecek şeyleri değil, verinin neyi temsil ettiğini de ortaya çıkarır — ve ikincisi çoğu zaman daha önemlidir.
Eksik değerin kaç tane olduğunu gördük. Asıl soru şu: neden eksik? Çünkü yapılacak işlemi sayı değil, eksikliğin nedeni belirler. Üç durum vardır ve üçünde farklı yöntem uygulanır (ayrımın kaynağı Rubin, 1976; açık erişimli bir anlatımı van Buuren, 2018, §1.2).
Mekanizma ne yapacağınızı belirlediği için — silmek, gözlenen bilgiyle doldurmak ya da sonucu bir varsayımla raporlamak — ayrımı 6.776 satırın üzerinde öğrenmeye çalışmak yerine önce altı satırlık küçük bir örnekte görelim.
Altı poliçenin yaşını önce eksiksiz bildiğimizi varsayalım. Sonra iki yaş kaybolsun — üç ayrı senaryoda, üç ayrı nedenle. Üçünde de kaybolan iki değer var; değişen, hangi ikisinin kaybolduğu:
| Poliçe | Sınıf | Gerçek yaş | MCAR senaryosu | MAR senaryosu | MNAR senaryosu |
|---|---|---|---|---|---|
| P1 | Genç | 30 | 30 | 30 | 30 |
| P2 | Genç | 40 | NA |
40 | 40 |
| P3 | Genç | 50 | 50 | 50 | 50 |
| P4 | Yaşlı | 70 | 70 | NA |
70 |
| P5 | Yaşlı | 80 | NA |
80 | NA |
| P6 | Yaşlı | 90 | 90 | NA |
NA |
| Ortalama | 60 | 60 | 50 | 47,5 |
Kaybolma nedenleri şunlar:
Son iki sütuna dikkat edin: ikisinde de Yaşlı sınıfından iki kayıt eksik. Fark yalnızca hangilerinin eksik olduğunda — ve gözlenen veriye bakan biri o farkı göremez, çünkü NA yazan hücrenin gerçek değerini bilemez.
Gerçek ortalama yaş 60’tır:
\[ \bar{x}=\frac{30+40+50+70+80+90}{6}=\frac{360}{6}=60. \]
Grup ortalamaları ise Genç için 40, Yaşlı için 80’dir.
Tablonun son satırındaki üç gözlenen ortalama, tek satırlık birer hesaptır:
\[ \begin{aligned} \text{MCAR:}\quad &\frac{30+50+70+90}{4}=\frac{240}{4}=60\\[3pt] \text{MAR:}\quad &\frac{30+40+50+80}{4}=\frac{200}{4}=50\\[3pt] \text{MNAR:}\quad &\frac{30+40+50+70}{4}=\frac{190}{4}=47{,}5 \end{aligned} \]
MCAR’da silmek yansız: 60 çıktı, gerçek de 60. Diğer ikisinde ortalama aşağı kaydı: MAR’da 10, MNAR’da 12,5 yaş.
Elimizdeki tek araç, eksikliğin gözlenen bir sütuna göre nasıl dağıldığına bakmaktır. Üç senaryo için sınıfa göre eksiklik oranı:
| Senaryo | Genç eksik | Yaşlı eksik | Tablo ne diyor? |
|---|---|---|---|
| MCAR | 1/3 (%33,3) | 1/3 (%33,3) | oranlar eşit — desen yok |
| MAR | 0/3 (%0,0) | 2/3 (%66,7) | oranlar farklı — desen var |
| MNAR | 0/3 (%0,0) | 2/3 (%66,7) | oranlar farklı — desen var |
MAR ile MNAR satırları birebir aynı. İkisinde de tablo “Yaşlı sınıfında üç kayıttan ikisi eksik” der. Gözlenen veriye bakan biri hangi senaryoda olduğunu bilemez — oysa aşağıdaki sonuç ikisinde farklıdır.
Her eksik yaşı kendi sınıfının gözlenen ortalamasıyla dolduralım.
| Senaryo | Gözlenen grup ortalaması (Genç / Yaşlı) | Atama sonrası ortalama | Gerçek 60’a göre |
|---|---|---|---|
| MCAR | 40 / 80 | 60 | tam |
| MAR | 40 / 80 | 60 | tam |
| MNAR | 40 / 70 | 55 | 5 yaş düşük |
Fark tek bir sayıdan doğuyor: Yaşlı sınıfının gözlenen ortalaması. MAR senaryosunda Yaşlı sınıfında gözlenen tek değer 80’dir ve sınıfın gerçek ortalamasına eşittir; MNAR senaryosunda gözlenen tek değer 70’tir ve eşit değildir, çünkü kaybolanlar tam da sınıfın en büyükleriydi.
MAR’ın tanımı buradadır: eksiklik gözlenen sınıfa bağlıdır, ama sınıfın içinde hangi kaydın kaybolduğu rastgeledir. MNAR’da sınıfın içinde de kimin kaybolduğu rastgele değildir: en büyükler kaybolduğu için sınıfın gözlenen ortalaması da yanlıdır ve bu ortalamayla yapılan atama aynı yanlılığı taşır.
Aynı hesabı R ile yapalım. Üç nesne kuracağız: altı poliçelik tablo, senaryoların tanımı ve açık bir döngüyle hesaplanan sonuç.
Önce tablo.
alti <- tibble(
  police = paste0("P", 1:6),
  sinif  = c("Genç", "Genç", "Genç", "Yaşlı", "Yaşlı", "Yaşlı"),
  yas    = c(30, 40, 50, 70, 80, 90)
)

alti
#> # A tibble: 6 × 3
#> police sinif yas
#> <chr> <chr> <dbl>
#> 1 P1 Genç 30
#> 2 P2 Genç 40
#> 3 P3 Genç 50
#> 4 P4 Yaşlı 70
#> 5 P5 Yaşlı 80
#> 6 P6 Yaşlı 90Bloğun çağrılarından ikisine yakından bakalım:
tibble() — sütunları ad = değerler biçiminde alıp bir veri tablosu kurar; bu haftanın bütün tabloları bu türdendir.paste0("P", 1:6) — tibble()’ın içinde, "P" ile 1:6 dizisini uç uca ekleyerek "P1"…"P6" adlarını tek satırda üretir. Altı adı elle yazmakla aynı sonucu verir, ama satır sayısını değiştirmek istediğinizde tek yeri değiştirirsiniz.Hangi yaşların kaybolduğunu tabloya işlemek yerine ayrı bir listede tutalım: senaryolar listesi her senaryo için, o senaryoda yaşı kaybolan poliçeleri tutar. Çıktıda her öğenin içindeki poliçe adları, altı poliçelik tablonun üç senaryo sütununda NA yazan hücrelerle eşleşmelidir.
senaryolar <- list(MCAR = c("P2", "P5"), MAR = c("P4", "P6"), MNAR = c("P5", "P6"))

senaryolar
#> $MCAR
#> [1] "P2" "P5"
#>
#> $MAR
#> [1] "P4" "P6"
#>
#> $MNAR
#> [1] "P5" "P6"Son nesne hesabın kendisi. Döngü üç senaryonun her biri için aynı üç işi yapar: o senaryoda kaybolan yaşları NA ile değiştirir, sınıf ortalamalarını alır ve dört sayıyı — gözlenen ortalama, Genç ve Yaşlı sınıflarının gözlenen ortalamaları ve atama sonrası ortalama — tek satır olarak uc_senaryo’ya ekler.
uc_senaryo <- tibble()
for (ad in names(senaryolar)) {
  gozlenen <- ifelse(alti$police %in% senaryolar[[ad]], NA_real_, alti$yas)
  grup_ort <- tapply(gozlenen, alti$sinif, mean, na.rm = TRUE)
  uc_senaryo <- bind_rows(uc_senaryo, tibble(
    senaryo          = ad,
    gozlenen_ort     = mean(gozlenen, na.rm = TRUE),
    genc_grup_ort    = grup_ort[["Genç"]],
    yasli_grup_ort   = grup_ort[["Yaşlı"]],
    grup_ici_atama   = mean(ifelse(is.na(gozlenen), grup_ort[alti$sinif], gozlenen))
  ))
}

uc_senaryo
#> # A tibble: 3 × 5
#> senaryo gozlenen_ort genc_grup_ort yasli_grup_ort grup_ici_atama
#> <chr> <dbl> <dbl> <dbl> <dbl>
#> 1 MCAR 60 40 80 60
#> 2 MAR 50 40 80 60
#> 3 MNAR 47.5 40 70 55Üç satırın da elle bulduğumuz sayıları vermesi gerekir: gözlenen ortalamalar 60, 50 ve 47,5; Genç sınıfının ortalaması üçünde de 40, Yaşlı’nınki 80, 80 ve 70; grup içi atama sonrası 60, 60 ve 55. Genç sütunu üç satırda da aynıdır: senaryoları ayıran tek grup ortalaması Yaşlı’nınkidir.
Döngünün kullandığı dört şey bu notta ilk kez geçiyor:
x %in% y — soldaki vektörün her öğesi için “bu değer sağdaki listede var mı?” sorusunu sorar ve altı öğe için altı TRUE/FALSE döndürür. Burada soru şudur: bu poliçe, o senaryoda kaybolanlar arasında mı?ifelse(koşul, doğruysa, yanlışsa) — koşulu vektörün her satırında ayrı ayrı sınar ve iki seçenekten birini yazar; kaybolan satırlara NA_real_, kalanlara gerçek yaş gelir. if ile karıştırmayın: if tek bir doğru/yanlış bekler ve altı elemanlı bir koşul verilirse hata verir; ifelse() altısını birden işler.tapply(değer, grup, fonksiyon) — değerleri gruba göre böler ve her gruba fonksiyonu ayrı ayrı uygular. Burada yaşları sınıfa göre bölüp ortalamasını alır, yani “Genç” ve “Yaşlı” için iki sayı döner. na.rm = TRUE verilmezse: içinde tek bir NA bulunan grubun ortalaması NA çıkar. Her senaryoda Yaşlı sınıfında eksik bulunduğu için üç satırda da yasli_grup_ort ve grup_ici_atama boşalır. genc_grup_ort yalnızca MCAR satırında boşalır, çünkü Genç sınıfında eksik yalnızca o senaryoda var; öbür ikisinde 40 kalır. Üç satırda da dolu kalan tek sayı sütunu, kendi na.rm = TRUE’sunu taşıyan gozlenen_ort’tur. bind_rows(a, b) — iki tabloyu alt alta ekler, yan yana değil. uc_senaryo bu yüzden boş bir tibble() olarak başlatılır: döngünün her turunda bir satır uzar, üçüncü turdan sonra üç satırlıdır.Son satırdaki grup_ort[alti$sinif] küçük görünür ama grup içi atamanın tamamıdır: grup_ort iki elemanlı (her sınıf için bir ortalama), alti$sinif ise altı elemanlıdır. Bir vektörü sınıf adlarıyla indislemek, altı satırın her birine kendi sınıfının ortalamasını getirir.
Üç çekince, üçü de bu kurgunun kendisinden doğuyor:
mice’ın havuzlanmış standart hatayı neden büyüttüğünü tartışırken bu cümleye döneceğiz: tek bir atama, doldurduğu değeri gözlenmiş gibi gösterir ve o değerin ne kadar yanılabileceğini gizler.Kurgudaki oranlar da abartılıdır: altı yaştan ikisi, Yaşlı sınıfında üçte ikisi eksik. Gerçek dosyada yaş eksikliği toplamda %8,8, en çok eksik veren sınıfta (F6) %35,4’tür.
Altı poliçelik kurgu burada bitiyor; bu bölümden itibaren yeniden auto_claims.csv dosyasıyla çalışıyoruz. Kurgunun sorusunu şimdi gerçek dosyaya soruyoruz: age, gender ve claim_amount sütunlarındaki eksik değerler hangi mekanizmayla oluşmuş olabilir? Cevabı şimdilik kimse söylemiyor; gerçek bir dosyayla çalışan analistin durumu da budur. Önce veriye bakacak, sonra her sütunu sınayacağız; verinin cevap veremediği yerde bir varsayım yapmak zorunda kalacağız. Mekanizma etiketlerini ancak bunlardan sonra, bölümün sonunda koyacağız.
Dosyanın neye benzediğini hatırlamak için ilk altı satırına yeniden bakalım:
head(ham)#> # A tibble: 6 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842.
#> 4 H00004 STATE 15 F6 F NA 2385.
#> 5 H00005 STATE 15 F6 M 95 650
#> 6 H00006 STATE 15 F6 M NA 391.Üç sütunu tek tek incelemeden önce üçünü aynı eksende görelim. Önce her sınıfta üç sütunun kaç eksik verdiğini sayıyoruz — aşağıdaki üç alt bölümün kullanacağı bütün sayılar bu tek tabloda:
mekanizma_panel_ham <- ham |>
  mutate(sinif = trimws(class)) |>
  group_by(sinif) |>
  summarise(
    kayit     = n(),
    age_na    = sum(is.na(age)),
    gender_na = sum(is.na(gender)),
    claim_na  = sum(is.na(claim_amount)),
    .groups = "drop"
  ) |>
  arrange(desc(age_na / kayit))

mekanizma_panel_ham
#> # A tibble: 18 × 5
#> sinif kayit age_na gender_na claim_na
#> <chr> <int> <int> <int> <int>
#> 1 F6 158 56 5 6
#> 2 C6 913 306 43 17
#> 3 F11 40 7 4 1
#> 4 F1 29 4 2 0
#> 5 C11 1151 86 56 22
#> 6 F7 59 4 2 0
#> 7 C1 726 48 27 20
#> 8 C7A 113 3 5 3
#> 9 C1C 38 1 2 0
#> 10 C7B 686 18 33 16
#> 11 C1A 77 2 4 1
#> 12 C7C 81 2 3 2
#> 13 C7 913 22 29 14
#> 14 C1B 424 10 13 8
#> 15 C72 85 2 3 1
#> 16 C71 1129 25 61 21
#> 17 F71 93 2 3 0
#> 18 C2 61 1 2 1Zincirde ilk kez kullandığımız dört işlev var:
mutate() — tabloya yeni bir sütun ekler ya da var olanı değiştirir; satır sayısı değişmez. Burada sinif sütununu kurar.trimws(class) — metnin başındaki ve sonundaki boşlukları atar, içerideki karakterlere dokunmaz; sinif sütunu sınıf kodunun bu kırpılmış hâlini taşır ve gruplama bu sütuna göre yapılır.group_by(sinif) — satırları sınıfa göre gruplar. Tablonun kendisi değişmez; değişen, sonraki summarise()’ın her sınıf için ayrı bir satır üretmesidir.n() — argüman almaz; summarise() içinde o grubun satır sayısını verir ve kayit sütununu bu doldurur. Eksik sayısı tek başına bir şey söylemez — bir sınıf yalnızca daha büyük olduğu için de daha çok eksik verebilir; karşılaştırmayı mümkün kılan payda budur. Yazılmasaydı arrange() eksik sayısını kayit sütununa böldüğü için zincir object 'kayit' not found diyerek dururdu.Grafik için bu geniş tabloyu uzun biçime çeviriyoruz: 18 satır, üç sütun için üçe katlanıp 54 satır olacak.
sutun_adi <- c("Yaş", "Cinsiyet", "Hasar tutarı")

mekanizma_panel_uzun <- mekanizma_panel_ham |>
  pivot_longer(c("age_na", "gender_na", "claim_na"),
               names_to = "sutun", values_to = "eksik") |>
  mutate(sutun = factor(sutun, c("age_na", "gender_na", "claim_na"), sutun_adi))

mekanizma_panel_uzun
#> # A tibble: 54 × 4
#> sinif kayit sutun eksik
#> <chr> <int> <fct> <int>
#> 1 F6 158 Yaş 56
#> 2 F6 158 Cinsiyet 5
#> 3 F6 158 Hasar tutarı 6
#> 4 C6 913 Yaş 306
#> 5 C6 913 Cinsiyet 43
#> 6 C6 913 Hasar tutarı 17
#> 7 F11 40 Yaş 7
#> 8 F11 40 Cinsiyet 4
#> 9 F11 40 Hasar tutarı 1
#> 10 F1 29 Yaş 4
#> # ℹ 44 more rowsZincirin son satırı sütun adlarını okunur etiketlere çevirir:
factor(sutun, c("age_na", "gender_na", "claim_na"), sutun_adi) — ikinci argüman düzeylerin sırasını, üçüncüsü görünen adlarını verir: age_na satırları artık Yaş yazar ve paneller bu sırayla dizilir.Şimdi her satıra bir belirsizlik aralığı ekliyoruz; istatistikte buna güven aralığı (confidence interval) denir. binom.test() şunu söyler: bu kadar kayıtla, sınıfın gerçek eksiklik oranı hangi aralıkta olabilir? Sınıf küçüldükçe aralık uzar, çünkü az kayıt az şey söyler. Bu bir sınama değil, oranın dayandığı kanıtın ölçüsüdür. Tabloyu orana göre sıralı basıyoruz, çünkü 54 satırın tamamı ekrana sığmaz ve öğretici olan uçlardır:
mekanizma_panel <- mekanizma_panel_uzun |>
  rowwise() |>
  mutate(
    oran = 100 * eksik / kayit,
    alt  = 100 * binom.test(eksik, kayit)$conf.int[1],
    ust  = 100 * binom.test(eksik, kayit)$conf.int[2]
  ) |>
  ungroup() |>
  mutate(etiket = paste0(sinif, " (",
                         format(kayit, big.mark = ".", trim = TRUE), ")"))

mekanizma_panel |> arrange(desc(oran))
#> # A tibble: 54 × 8
#> sinif kayit sutun eksik oran alt ust etiket
#> <chr> <int> <fct> <int> <dbl> <dbl> <dbl> <chr>
#> 1 F6 158 Yaş 56 35.4 28.0 43.4 F6 (158)
#> 2 C6 913 Yaş 306 33.5 30.5 36.7 C6 (913)
#> 3 F11 40 Yaş 7 17.5 7.34 32.8 F11 (40)
#> 4 F1 29 Yaş 4 13.8 3.89 31.7 F1 (29)
#> 5 F11 40 Cinsiyet 4 10 2.79 23.7 F11 (40)
#> 6 C11 1151 Yaş 86 7.47 6.02 9.15 C11 (1.151)
#> 7 F1 29 Cinsiyet 2 6.90 0.846 22.8 F1 (29)
#> 8 F7 59 Yaş 4 6.78 1.88 16.5 F7 (59)
#> 9 C1 726 Yaş 48 6.61 4.91 8.67 C1 (726)
#> 10 C71 1129 Cinsiyet 61 5.40 4.16 6.89 C71 (1.129)
#> # ℹ 44 more rowsYukarıdaki zincir üç iş yapıyor: önce tabloyu satır satır okunur hâle getiriyor, sonra her satıra belirsizlik aralığını ekliyor, en sonda grafiğin kullanacağı etiket sütununu kuruyor. Üçünü ayrı nesnelere alıp yazdırdığımızda hangi adımın neyi değiştirdiği görünür.
rowwise() veriyi değiştirmez; mutate()’in veriyi nasıl gördüğünü değiştirir. Aşağıdaki çıktıda satır sayısı da sütunlar da aynı kalır (54 × 4); tek fark başlığa eklenen # Rowwise: satırıdır. O satır şunu söyler: bundan sonraki mutate() her ifadeyi 54 satırlık sütunun tamamı için bir kez değil, her satır için ayrı ayrı hesaplayacaktır. Fark burada süs değil, zorunluluk: binom.test() tek bir başarı sayısıyla tek bir deneme sayısı bekler; 54’lük bir vektör verildiğinde incorrect length of 'x' hatasıyla durur.
mekanizma_panel_satirsal <- mekanizma_panel_uzun |>
  rowwise()

mekanizma_panel_satirsal
#> # A tibble: 54 × 4
#> # Rowwise:
#> sinif kayit sutun eksik
#> <chr> <int> <fct> <int>
#> 1 F6 158 Yaş 56
#> 2 F6 158 Cinsiyet 5
#> 3 F6 158 Hasar tutarı 6
#> 4 C6 913 Yaş 306
#> 5 C6 913 Cinsiyet 43
#> 6 C6 913 Hasar tutarı 17
#> 7 F11 40 Yaş 7
#> 8 F11 40 Cinsiyet 4
#> 9 F11 40 Hasar tutarı 1
#> 10 F1 29 Yaş 4
#> # ℹ 44 more rowsAsıl hesap ikinci adımda: her satır için üç yeni sütun doluyor — gözlenen oran ve aralığın iki ucu. Üçü de 100 ile çarpılıyor, çünkü grafiğin ekseni yüzde okunuyor; çarpmasaydık üç sütun da 0–1 arasında kalırdı. Sonucu belirleyen parçalar şunlar:
binom.test(eksik, kayit) — ilk argüman o satırdaki eksik sayısı (başarı), ikincisi sınıftaki kayıt sayısı (deneme). Sıra bir tercih değil: binom.test(913, 306) çağrısı 'n' must be a positive integer >= 'x' hatasıyla durur.$conf.int[1] — aralığın alt ucu. binom.test() dokuz bileşenli bir liste döndürür; $ hangi bileşeni istediğimizi söyler. Bunun yerine $estimate yazsaydık aralığı değil oranın kendisini alırdık — C6’nın yaş satırında 0,335, yani oran sütunundaki 33,5 değerinin yüzle çarpılmamış hâli. $conf.int[2] — aynı bileşenin üst ucu. Köşeli parantez yazılmazsa mutate() tek bir hücreye iki sayı birden koymak zorunda kalır ve `ust` must be size 1, not 2 diyerek durur.conf.level — aralığın güven düzeyi; blokta yazılmadığı için öntanımlı 0,95 geçerlidir, yani %95’lik Clopper–Pearson (tam binom) aralığı kurulur. Aralığın kayıt sayısına nasıl bağlandığı çıktının ilk on satırında yan yana okunur: 913 kayıtlık C6’nın yaş aralığı %30,5–%36,7 (6,2 puan genişliğinde), 29 kayıtlık F1’inki %3,9–%31,7 (27,8 puan). F1’in oranı daha düşük olduğu hâlde aralığı dört kattan fazla geniş; genişliği asıl belirleyen, oranın kendisi değil arkasındaki kayıt sayısıdır. Zincirin son halkası ungroup(): satır satır kipini kapatır. Çağrılmazsa tablo satırsal kalır ve sonraki bir özet sessizce yanlış çıkar: summarise(ortalama = mean(oran)) tek bir sayı yerine 54 satır döndürür, çünkü her satırın ortalaması kendisidir.
mekanizma_panel_aralikli <- mekanizma_panel_satirsal |>
  mutate(
    oran = 100 * eksik / kayit,
    alt  = 100 * binom.test(eksik, kayit)$conf.int[1],
    ust  = 100 * binom.test(eksik, kayit)$conf.int[2]
  ) |>
  ungroup()

mekanizma_panel_aralikli
#> # A tibble: 54 × 7
#> sinif kayit sutun eksik oran alt ust
#> <chr> <int> <fct> <int> <dbl> <dbl> <dbl>
#> 1 F6 158 Yaş 56 35.4 28.0 43.4
#> 2 F6 158 Cinsiyet 5 3.16 1.04 7.23
#> 3 F6 158 Hasar tutarı 6 3.80 1.41 8.08
#> 4 C6 913 Yaş 306 33.5 30.5 36.7
#> 5 C6 913 Cinsiyet 43 4.71 3.43 6.29
#> 6 C6 913 Hasar tutarı 17 1.86 1.09 2.96
#> 7 F11 40 Yaş 7 17.5 7.34 32.8
#> 8 F11 40 Cinsiyet 4 10 2.79 23.7
#> 9 F11 40 Hasar tutarı 1 2.5 0.0633 13.2
#> 10 F1 29 Yaş 4 13.8 3.89 31.7
#> # ℹ 44 more rowsSon adım hesap yapmaz, yazı yazar: paste0() sınıf adıyla kayıt sayısını tek bir metinde birleştirir; grafikte y ekseninin etiketleri bu sütundan gelir. Kayıt sayısını etikete koymak bir tercihtir — okuyucu bir aralığın neden o kadar geniş olduğunu ancak sınıfın büyüklüğünü görürse anlar. Sayının biçimini format()’ın iki argümanı belirler:
big.mark = "." — binler ayracı. On sekiz sınıfın yalnızca ikisi dört basamaklı olduğu için fark iki etikette görünür: C11 (1.151) ve C71 (1.129). Verilmezse: C11 (1151) yazılır, Türkçe sayı yazımı bozulur.trim = TRUE — format() bir vektörü biçimlendirirken bütün sonuçları en uzununun genişliğine tamamlar; trim bu doldurmayı kapatır. Verilmezse: en uzun sayı beş karakterlik 1.151 olduğundan kısa sayıların soluna boşluk eklenir ve F11 etiketinde parantezle 40 arasında üç boşluk kalır.Bu son adım kutunun üstündeki bloğun aynısıdır: aynı nesneyi kurar ve aynı tabloyu basar. arrange(desc(oran)) yalnızca sırayı değiştirir; satır sayısı da sütunlar da aynı kalır. Sıralamanın nedeni 54 satırın ekrana sığmamasıdır: başa en yüksek oranlı sınıflar gelir ve ilk on satırın yedisi yaş panelindendir. Çıktıyı yukarıdaki blokla karşılaştırın; ikisi aynı olmalıdır.
mekanizma_panel <- mekanizma_panel_aralikli |>
  mutate(etiket = paste0(sinif, " (",
                         format(kayit, big.mark = ".", trim = TRUE), ")"))

mekanizma_panel |> arrange(desc(oran))
#> # A tibble: 54 × 8
#> sinif kayit sutun eksik oran alt ust etiket
#> <chr> <int> <fct> <int> <dbl> <dbl> <dbl> <chr>
#> 1 F6 158 Yaş 56 35.4 28.0 43.4 F6 (158)
#> 2 C6 913 Yaş 306 33.5 30.5 36.7 C6 (913)
#> 3 F11 40 Yaş 7 17.5 7.34 32.8 F11 (40)
#> 4 F1 29 Yaş 4 13.8 3.89 31.7 F1 (29)
#> 5 F11 40 Cinsiyet 4 10 2.79 23.7 F11 (40)
#> 6 C11 1151 Yaş 86 7.47 6.02 9.15 C11 (1.151)
#> 7 F1 29 Cinsiyet 2 6.90 0.846 22.8 F1 (29)
#> 8 F7 59 Yaş 4 6.78 1.88 16.5 F7 (59)
#> 9 C1 726 Yaş 48 6.61 4.91 8.67 C1 (726)
#> 10 C71 1129 Cinsiyet 61 5.40 4.16 6.89 C71 (1.129)
#> # ℹ 44 more rowsGrafiğin iki yardımcı nesnesi kaldı: sınıfların sıralaması ve her panele çizilecek genel oran. İkisini de grafikten önce, sırayla kuruyoruz; ikincisi bölümün bütün savının dayandığı üç sayıdır.
panel_sirasi <- mekanizma_panel |>
  filter(sutun == "Yaş") |>
  arrange(oran) |>
  pull(etiket)

panel_sirasi
#> [1] "C2 (61)" "F71 (93)" "C71 (1.129)" "C72 (85)" "C1B (424)"
#> [6] "C7 (913)" "C7C (81)" "C1A (77)" "C7B (686)" "C1C (38)"
#> [11] "C7A (113)" "C1 (726)" "F7 (59)" "C11 (1.151)" "F1 (29)"
#> [16] "F11 (40)" "C6 (913)" "F6 (158)"filter(sutun == "Yaş") yalnızca koşulu sağlayan satırları, yani yaş panelinin satırlarını tutar; arrange(oran) onları orana göre dizer. pull() seçilen sütunu tablodan çıkarır; çıktı bu yüzden bir tablo değil, sınıf etiketlerinden oluşan bir metin vektörüdür: yaş panelindeki oran en düşük olan sınıftan en yüksek olana doğru sıralanır ve bu sıra grafikte y ekseninin düzenini belirler. Yazılmazsa: elde vektör değil zincirin tablosu kalır ve grafikteki factor(..., levels = panel_sirasi) çağrısı ne hata ne uyarı verir; sınıf etiketlerinin hepsini sessizce NA yapar.
Aşağıdaki küçük tablo üç sütunu alt alta dizer; oran o sütunun dosya genelindeki eksiklik oranıdır:
genel_oranlar <- tibble(
  sutun = factor(sutun_adi, sutun_adi),
  oran  = 100 * c(mean(is.na(ham$age)), mean(is.na(ham$gender)),
                  mean(is.na(ham$claim_amount)))
)

genel_oranlar
#> # A tibble: 3 × 2
#> sutun oran
#> <fct> <dbl>
#> 1 Yaş 8.84
#> 2 Cinsiyet 4.38
#> 3 Hasar tutarı 1.96Üç panelin yatay ekseni de aynıdır; sorulan soru “hangi sütunda oran yüksek?” değil, “hangi sütunda sınıflar birbirinden ayrışıyor?” sorusudur:
mekanizma_panel_grafigi <- mekanizma_panel |>
  mutate(etiket = factor(etiket, levels = panel_sirasi)) |>
  ggplot(aes(x = oran, y = etiket)) +
  geom_vline(data = genel_oranlar, aes(xintercept = oran),
             colour = "#C8A45C", linewidth = 0.9) +
  geom_errorbar(aes(xmin = alt, xmax = ust), orientation = "y",
                width = 0, colour = "#2E75B6", linewidth = 0.6) +
  geom_point(colour = "#1F4E79", size = 1.7) +
  facet_wrap(vars(sutun), ncol = 3) +
  scale_x_continuous(
    breaks = seq(0, 40, 10),
    labels = label_number(prefix = "%", big.mark = ".", decimal.mark = ",")
  ) +
  # limits = c(...) ekseni kirpmakla kalmaz, aralik disindaki veriyi de ATAR ve
  # uyarisi bu sitede bastirilmistir; coord_cartesian yalnizca yakinlastirir.
  coord_cartesian(xlim = c(0, 45)) +
  labs(x = "Sınıftaki eksik değer oranı (nokta) ve belirsizlik aralığı (çizgi)",
       y = "Tarife sınıfı (parantez içinde kayıt sayısı)") +
  theme_minimal(base_size = 11)

mekanizma_panel_grafigi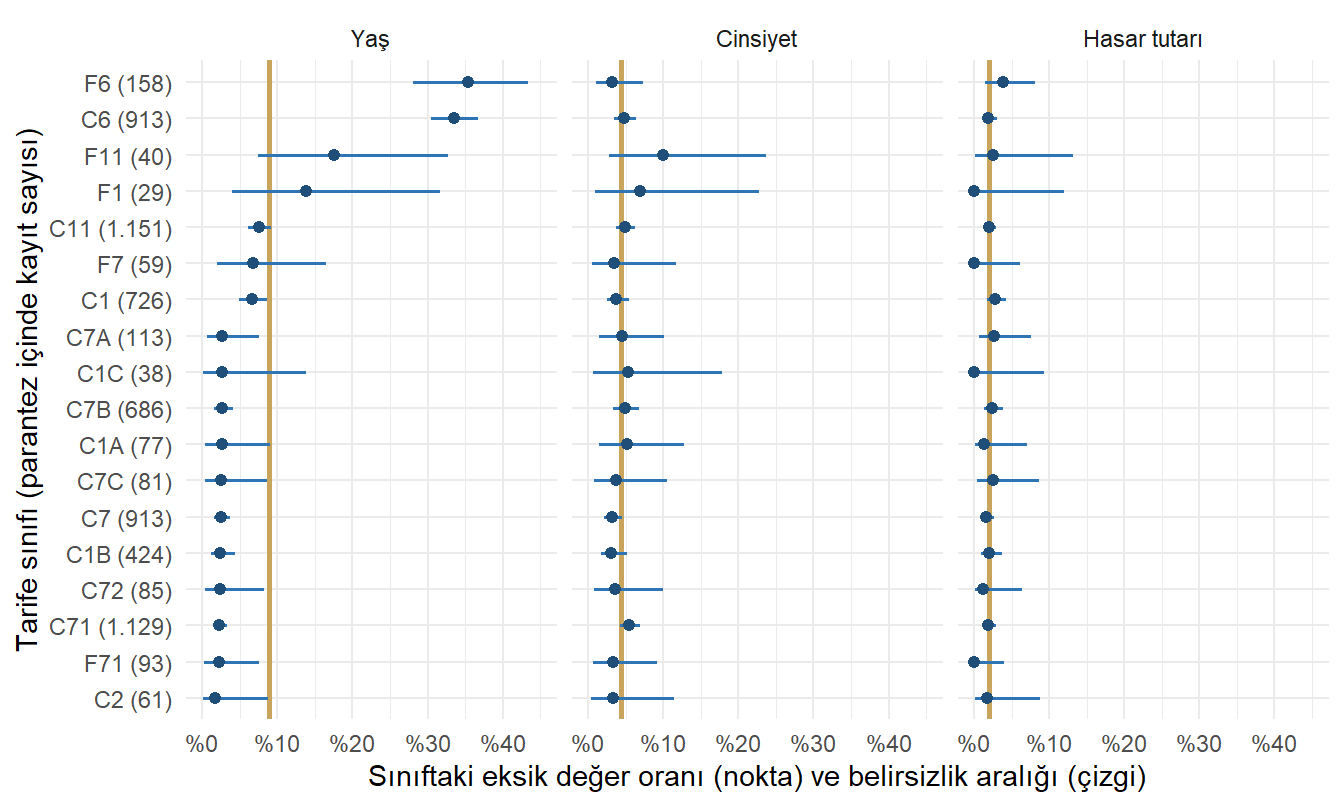
Grafiği mekanizma_panel_grafigi adıyla saklayıp öyle çiziyoruz: cinsiyeti okurken aynı grafiği yeniden göstereceğiz.
Bu blok üç geometriyi üst üste bindiriyor ve üçü birbirinden farklı üç soruya karşılık geliyor: nokta sınıfın oranını, mavi çizgi o oranın dayandığı kanıtı, altın çizgi ise oranın karşılaştırılacağı ölçütü verir. Grafiği dört aşamada kuralım; ilk üçü bir öncekine tek bir geometri ekler, dördüncüsü biçimlendirme katmanlarını bir arada getirir ve yukarıdaki asıl bloğun tamamıdır — çıktısını yukarıdakiyle karşılaştırıp parçalamanın eksiksiz olduğunu kendiniz denetleyebilirsiniz.
Aşama 1 — yalnızca noktalar. Önce 54 satırın her birini tek bir nokta olarak koyalım: 18 tarife sınıfı, üç sütun için üç panel. ggplot() hangi tablonun kullanılacağını ve hangi sütunun hangi eksene gideceğini (aes()) bildirir, ama tek başına bir şey çizmez; çizimi geom_point() gibi bir geometri katmanı yapar ve katmanlar + ile eklenir. Bu hâliyle grafik yalnızca “hangi sınıfta oran yüksek?” sorusunu yanıtlar:
mekanizma_panel |>
  mutate(etiket = factor(etiket, levels = panel_sirasi)) |>
  ggplot(aes(x = oran, y = etiket)) +
  geom_point(colour = "#1F4E79", size = 1.7) +
  facet_wrap(vars(sutun), ncol = 3)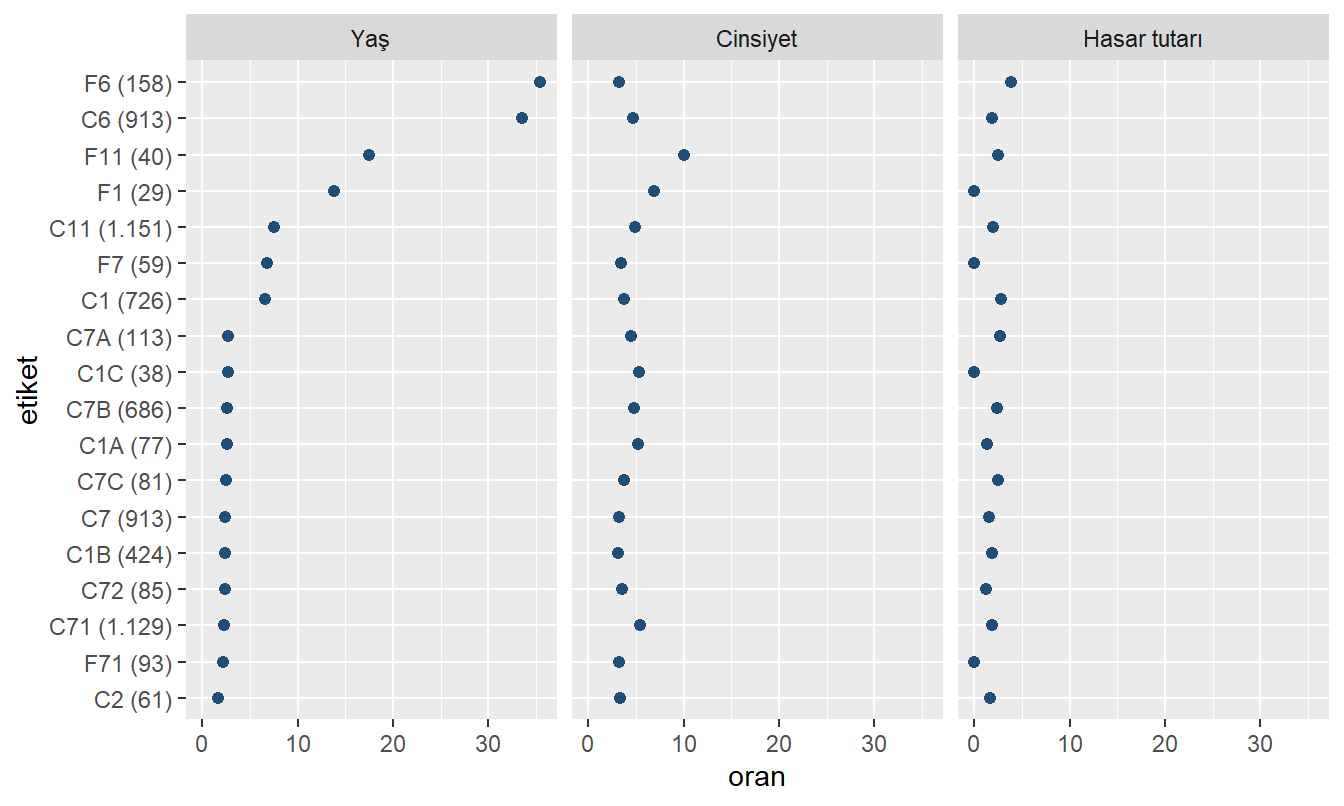
Bu aşamanın davranış değiştiren argümanları:
levels = panel_sirasi — y eksenindeki sınıf sırasını yaş eksikliği oranına göre kurar; üç panel de aynı sırayı kullandığı için satırlar yan yana okunabilir. Verilmezse: factor() düzeyleri alfabetik sıralar ve eksen de öyle dizilir, yani soldaki panelin basamak deseni dağılır.colour = "#1F4E79" — noktanın rengi, dersin lacivert tonu. Verilmezse: noktalar siyah çizilir ve birazdan eklenecek çelik mavisi aralık çizgisinden ayırt edilmeleri zorlaşır.size = 1.7 — nokta çapı. Varsayılan 1,5’tir; 54 noktanın üç panele bölündüğü bu grafikte biraz büyütülmüştür. vars(sutun) — hangi değişkenin panelleri ayıracağını söyler. Üç panelin çıkmasının nedeni bu sütunun üç düzeyi olmasıdır.ncol = 3 — panelleri tek satırda yan yana dizer. Yazılmasa da bu grafikte görünüm değişmez, çünkü ggplot2 üç panel için zaten 1 satır × 3 sütun seçer; ncol sütun sayısını üçe sabitler, yani panel sayısı değişse bile düzeni ggplot2’nin kendi seçimine bırakmaz.Grafik bu aşamada bir şeyi göstermiyor: her noktanın kaç kayıttan hesaplandığını. F6 (158 kayıt) %35,4 ile C6 (913 kayıt) %33,5 neredeyse aynı yerde duruyor, ama biri 158 diğeri 913 kayda dayanıyor. Nokta bu farkı yutar.
Aşama 2 — belirsizlik aralığı. Bu aşamanın kattığı katman her noktanın hizasına, tablodaki alt–ust sütunlarından gelen yatay bir çizgi çizer. Oran artık tek bir konum değil, bir aralıktır:
mekanizma_panel |>
  mutate(etiket = factor(etiket, levels = panel_sirasi)) |>
  ggplot(aes(x = oran, y = etiket)) +
  geom_errorbar(aes(xmin = alt, xmax = ust), orientation = "y",
                width = 0, colour = "#2E75B6", linewidth = 0.6) +
  geom_point(colour = "#1F4E79", size = 1.7) +
  facet_wrap(vars(sutun), ncol = 3)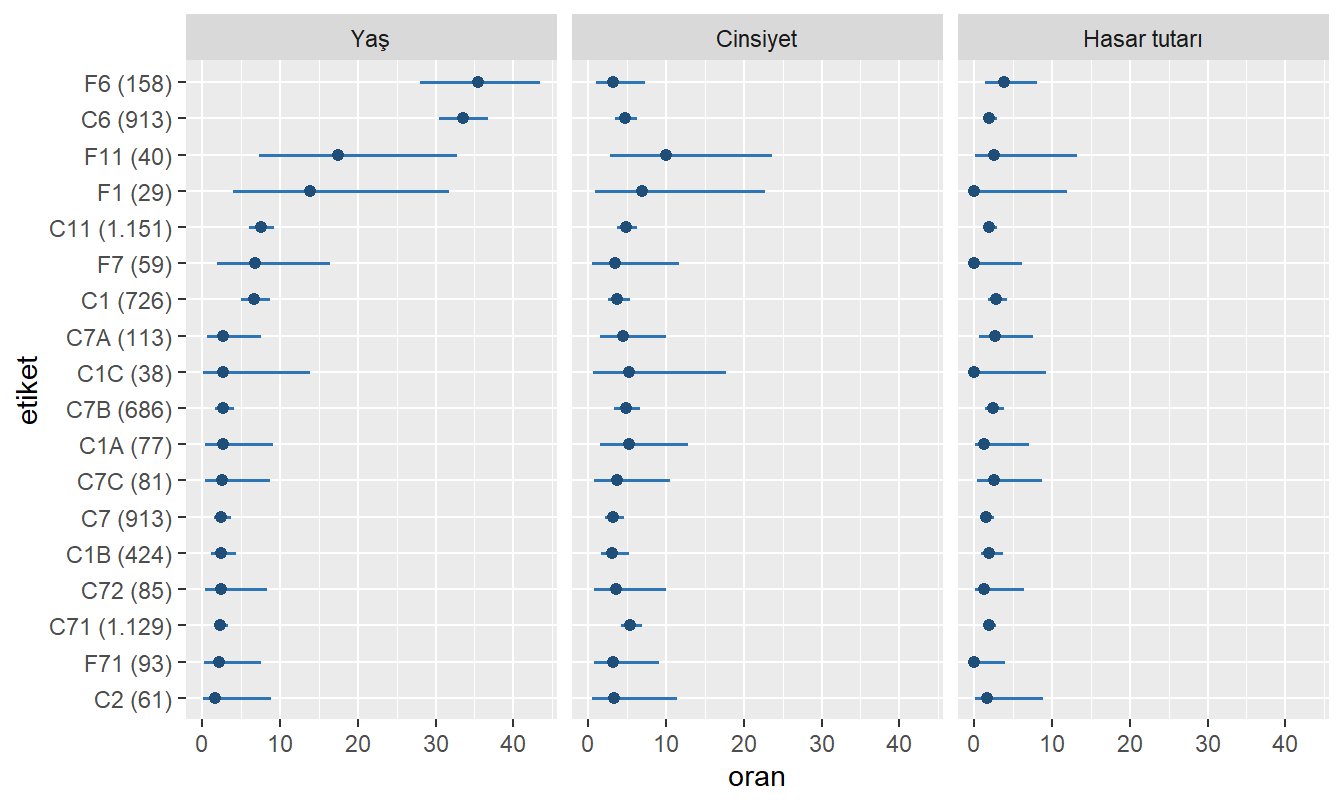
Bu katman ve argümanları:
geom_errorbar() — o çizgiyi çizen katman. Çizginin hangi satıra düşeceği bu çağrıda yazmaz: y eşlemesi grafiğin ana aes()’inden devralınır.aes(xmin = alt, xmax = ust) — çizginin iki ucu, tabloda binom.test() ile hesapladığımız iki sütundan gelir. Aralık grafikte üretilmez, veriden okunur.orientation = "y" — çizgiyi yatay çizer: aralık x ekseni boyunca uzanır, her sınıfa y ekseninde bir çizgi düşer. ggplot2 yönü xmin ile xmax eşlemesinden kendisi de çıkarır; argüman yazılmasa da aynı grafik çıkar, ama yazıldığında yön koddan okunur. Eski kodlarda yatay aralık için ayrı bir geom_errorbarh() görürsünüz; ggplot2 4.0 onu kullanımdan kaldırdı ve yerine bu argümanı önerir.width = 0 — çizginin uçlarındaki çentiğin boyu. Yön yatay olduğu için bu boy y ekseni boyunca ölçülür. Verilmezse: ggplot2 çentiği satır aralığının %90’ı kadar çizer (ölçülen değer: satırın ±0,45’i); 18 satırlık bu panelde bitişik iki sınıfın çentikleri arasında satır aralığının yalnızca onda biri kalır. Sıfır vermek çizgiyi çentiksiz, düz bir çubuğa indirger.colour = "#2E75B6" — çelik mavisi; noktanın laciverdinden ayrılsın diye bilerek farklı bir tondur.linewidth = 0.6 — çizgi kalınlığı. Varsayılan 0,5’tir; birazdan eklenecek altın çizginin 0,9’undan ince tutulması, hangi çizginin veri hangisinin ölçüt olduğunu görsel olarak ayırır. Aralık eklenince grafik başka bir şey söylemeye başlıyor. F1 sınıfının (29 kayıt) yaş oranı %13,8’dir ama aralığı %3,9 ile %31,7 arasındadır — 27,8 puan genişliğinde, yani neredeyse hiçbir şey söylemez. C6’nın (913 kayıt) aralığı ise %30,5 ile %36,7 arasına sıkışır. Bütün grafiğin en dar aralığı, hasar tutarı panelinde 1.129 kayıtlık C71 sınıfınındır: %1,2 ile %2,8 arası, 1,7 puan.
Aynı katman bir tuzağı da görünür kılar: hasar tutarı panelinde 4 sınıfın noktası tam %0’dadır, ama örneğin F1’in aralığı yine de %11,9’a kadar uzanır. “Bu sınıfta hiç eksik yok” cümlesi, “bu sınıfta eksiklik oranı sıfırdır” cümlesiyle aynı şey değildir; 29 kayıt ikincisini söylemeye yetmez.
Aşama 3 — genel oran çizgisi. İki aşamadır grafikte eksik olan şey bir ölçüt: bir oranın yüksek olup olmadığı neye göre söylenecek? Bu aşamanın kattığı katman her panele o sütunun dosya geneli oranını çizer:
mekanizma_panel |>
  mutate(etiket = factor(etiket, levels = panel_sirasi)) |>
  ggplot(aes(x = oran, y = etiket)) +
  geom_vline(data = genel_oranlar, aes(xintercept = oran),
             colour = "#C8A45C", linewidth = 0.9) +
  geom_errorbar(aes(xmin = alt, xmax = ust), orientation = "y",
                width = 0, colour = "#2E75B6", linewidth = 0.6) +
  geom_point(colour = "#1F4E79", size = 1.7) +
  facet_wrap(vars(sutun), ncol = 3)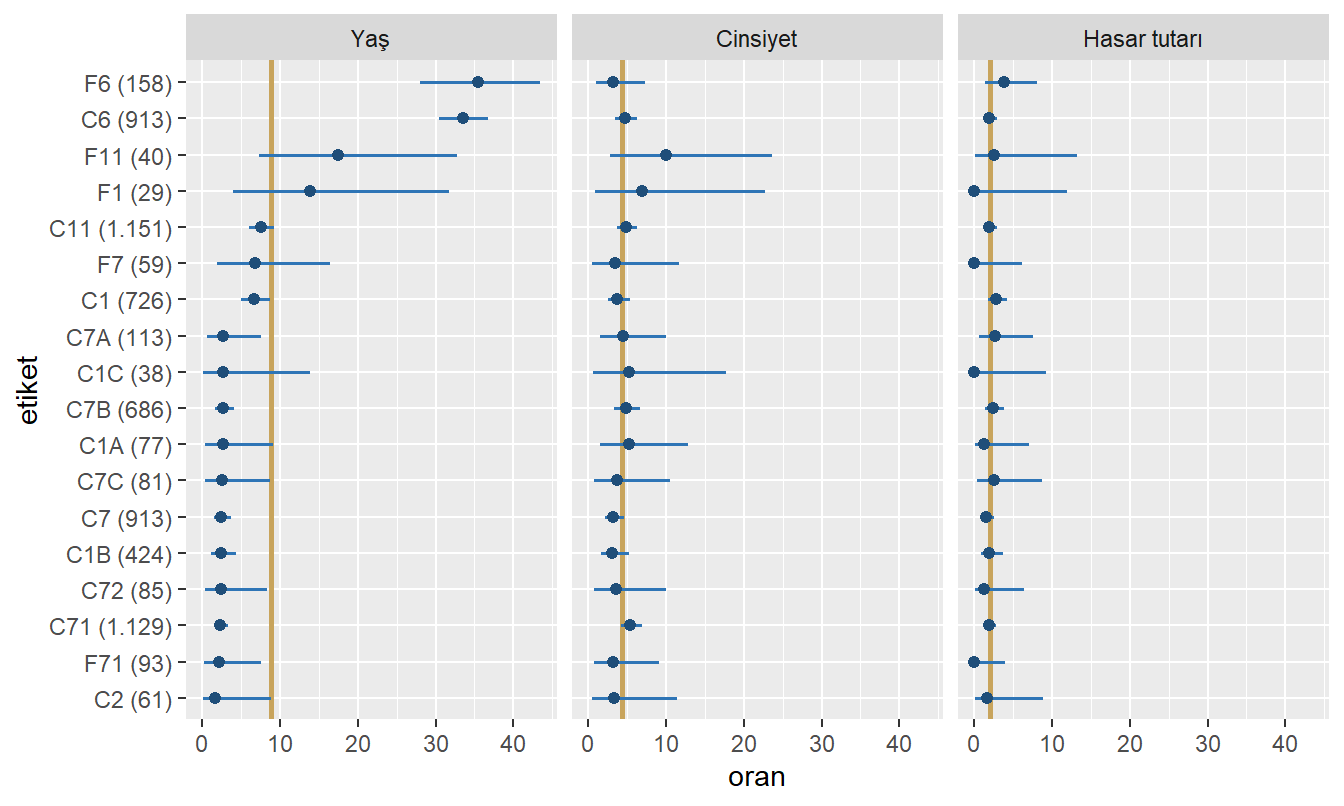
Bu katman ve argümanları:
geom_vline() — o çizgiyi çizen katman; v düşey demektir ve çizgi panelin alt kenarından üst kenarına uzanır. Bir önceki katmandan ayrıldığı nokta şudur: grafiğin ana aes()’ini devralmaz. etiket sütunu taşımayan bir tablonun ona hatasız verilebilmesinin nedeni budur.data = genel_oranlar — katmana başka bir tablo veriliyor: üç satırlık genel_oranlar. O tablo da sutun sütununu taşıdığı için facet_wrap() her satırı kendi paneline yerleştirir; her panele bir çizgi düşmesinin nedeni budur. Verilmezse: katman grafiğin kendi 54 satırlık verisini devralır ve her panele 18 çizgi çizer — sınıf oranlarının kendileri düşey çizgiye dönüşür.aes(xintercept = oran) — çizginin yeri sabit bir sayı değil, tablodaki sütundur; üç panelde üç ayrı hizada çıkmasının nedeni de budur.colour = "#C8A45C" — dersin altın tonu. İki mavi tonun dışında bir renk seçilmesi kasıtlıdır: bu çizgi bir veri noktası değil, bir ölçüttür.linewidth = 0.9 — aralık çizgisinin 0,6’sından kalın. Ölçüt, üstünden geçen noktaların altında kaybolmamalıdır.Üç katman tamamlanınca bölümün sorusu ilk kez yanıtlanabilir hâle gelir: bir sınıf ancak kendi aralığı altın çizgiyi dışarıda bırakıyorsa ayrışıyor sayılır. Yaş panelinde bunu 12 sınıf yapar — ve dikkat edin, ayrışma iki yönlüdür: 2 sınıfın aralığı çizginin tamamen sağında, 10 sınıfınki tamamen solundadır. Eksikliğin sınıfa bağlı olması yalnızca “bazı sınıflarda daha çok eksik” demek değildir; bağın aşağı yönlü olanı da kanıttır. Diğer iki panelde hiçbir aralık altın çizgiyi dışarıda bırakmaz.
Aşama 4 — eksen biçimi, pencere, adlar ve tema. Son aşama dört katman birden ekler ve kutunun yukarısındaki asıl bloğun çizim zincirinin tamamıdır. Dördü de veriyi değil, okunuşunu değiştirir:
mekanizma_panel |>
  mutate(etiket = factor(etiket, levels = panel_sirasi)) |>
  ggplot(aes(x = oran, y = etiket)) +
  geom_vline(data = genel_oranlar, aes(xintercept = oran),
             colour = "#C8A45C", linewidth = 0.9) +
  geom_errorbar(aes(xmin = alt, xmax = ust), orientation = "y",
                width = 0, colour = "#2E75B6", linewidth = 0.6) +
  geom_point(colour = "#1F4E79", size = 1.7) +
  facet_wrap(vars(sutun), ncol = 3) +
  scale_x_continuous(
    breaks = seq(0, 40, 10),
    labels = label_number(prefix = "%", big.mark = ".", decimal.mark = ",")
  ) +
  # limits = c(...) ekseni kirpmakla kalmaz, aralik disindaki veriyi de ATAR ve
  # uyarisi bu sitede bastirilmistir; coord_cartesian yalnizca yakinlastirir.
  coord_cartesian(xlim = c(0, 45)) +
  labs(x = "Sınıftaki eksik değer oranı (nokta) ve belirsizlik aralığı (çizgi)",
       y = "Tarife sınıfı (parantez içinde kayıt sayısı)") +
  theme_minimal(base_size = 11)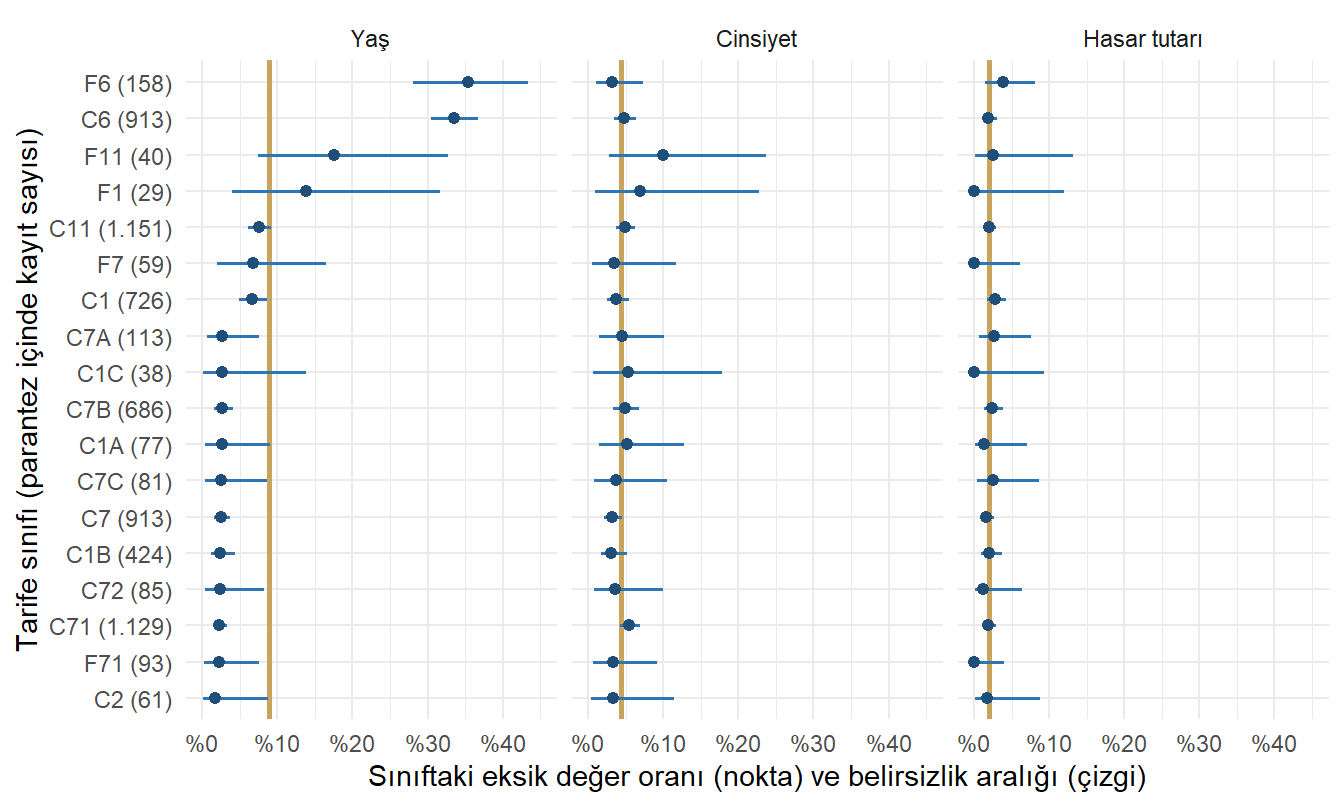
Bu aşamanın argümanları:
breaks = seq(0, 40, 10) — yatay eksenin tikleri: 0, 10, 20, 30, 40. Bu veride varsayılan seçim de aynı yerlere denk gelir; breaks onları sabitler, yani veri değiştiğinde tikler kaymaz.labels = label_number(...) — tik sayılarını metne çevirir. Etiketi üreten şey budur: breaks nereye, labels ne yazılacağını söyler.prefix = "%" — yüzde işaretini sayının soluna koyar, Türkçe yazım kuralı budur. Verilmezse: eksende çıplak 0 10 20 30 40 kalır — ikinci ve üçüncü aşamanın ekseni tam olarak böyleydi; birincide, aralıklar henüz yokken, tikler 30’da bitiyordu — ve okuyucu bu sayıların yüzde mi puan mı olduğunu grafikten anlayamaz.big.mark = "." — binlik ayırıcı. Bu eksende görünür etkisi yoktur, çünkü en büyük etiket 40’tır; kalıbın yine de yazılması, aynı biçimlendirmenin binlik sayı taşıyan bir eksende de doğru çalışmasını sağlar.decimal.mark = "," — ondalık ayırıcı. Burada da görünmez, çünkü tiklerin hiçbiri ondalık taşımaz; ikisi bir arada Türkçe sayı kuralının grafiğe uygulanmış hâlidir.xlim = c(0, 45) — coord_cartesian()’a verilen pencere. Bu katmanın bu grafikteki görünür etkisi neredeyse yoktur: en uzun aralık %43,4’e (F6, yaş) kadar uzandığı için eksen coord_cartesian() olmadan da 40 tikinin ötesine açılıyordu; pencere yalnızca sağ kenarı bir parça daha ileri taşır. Katmanın işi görünümü değiştirmek değil, pencereyi beyan etmektir.limits = c(0, 45) — bloğun içindeki yorum satırının uyardığı şey: aynı aralığı scale_x_continuous() içinde limits ile yazmak aynı şey değildir. limits ekseni kırpmakla kalmaz, aralık dışında kalan satırları da atar; bu sitede ggplot2 uyarıları bastırıldığı için atıldıklarını size kimse söylemez. Pencere daraltmak istendiğinde doğru katman coord_cartesian()’dır.labs(x = ..., y = ...) — eksen adları. x adı iki geometriyi birden adlandırır (“nokta” ve “çizgi”), çünkü aynı eksende iki ayrı şey okunuyor. Verilmezse: eksen adları ilk üç aşamadaki gibi ham sütun adlarında — oran ve etiket — kalır.base_size = 11 — theme_minimal()’ın taban punto boyutu; bütün yazılar birden ölçeklenir. Değeri temanın varsayılanıyla aynıdır, yani bu grafikte görünümü değiştirmez; yazılı olması punto ayarının nerede yapıldığını gösterir.İki kapanış notu:
Aşağıda her sütunu kendi alt bölümünde, panelin o sütuna ait grafiği ve bir testle ele alacağız. Aradaki farkı en kısa söyleyen sayı şudur: yaş panelinde 18 aralığın 12’si genel oranı (%8,8) dışarıda bırakıyor; cinsiyet ve tutar panellerinde bunu yapan aralık sayısı 0. Yani soldaki panelde sınıflar birbirinden ayrışıyor, diğer ikisinde ayrışmıyor.
Belirsizlik aralığı burada süs değil, kuralın kendisi: bir sınıfın oranı ancak kendi aralığı genel oranı dışarıda bırakıyorsa “ayrışıyor” sayılır. 29 kayıtlık F1 sınıfının yaş oranı %13,8’dir ama aralığı %3,9’a kadar iner; 913 kayıtlık C6’nın oranı %33,5’tir ve aralığı hiçbir yerde %8,8’e yaklaşmaz. İkisini aynı gözle okumak, ikinci sınıfın taşıdığı kanıtı görmezden gelmektir.
Kuralı tek tek aralıklara değil panelin tamamına uygulayın: 18 aralık birlikte okunduğunda, eksiklik tamamen rastgele olsa bile yaklaşık bir aralığın şans eseri genel oranı dışarıda bırakması beklenir. Yaş panelindeki 12 aralık şansla açıklanamaz; öbür iki paneldeki sıfır ise şansın beklediği sonuçtur.
Eksikliğin bir desene sahip olup olmadığını görmenin yolu, onu gözlenen bir değişkenle çaprazlamaktır:
eksik_yas_sinif <- ham |>
  mutate(sinif = trimws(class)) |>
  group_by(sinif) |>
  summarise(
    kayit = n(),
    eksik_yas = sum(is.na(age)),
    oran = 100 * mean(is.na(age)),
    .groups = "drop"
  ) |>
  arrange(desc(oran))

eksik_yas_sinif
#> # A tibble: 18 × 4
#> sinif kayit eksik_yas oran
#> <chr> <int> <int> <dbl>
#> 1 F6 158 56 35.4
#> 2 C6 913 306 33.5
#> 3 F11 40 7 17.5
#> 4 F1 29 4 13.8
#> 5 C11 1151 86 7.47
#> 6 F7 59 4 6.78
#> 7 C1 726 48 6.61
#> 8 C7A 113 3 2.65
#> 9 C1C 38 1 2.63
#> 10 C7B 686 18 2.62
#> 11 C1A 77 2 2.60
#> 12 C7C 81 2 2.47
#> 13 C7 913 22 2.41
#> 14 C1B 424 10 2.36
#> 15 C72 85 2 2.35
#> 16 C71 1129 25 2.21
#> 17 F71 93 2 2.15
#> 18 C2 61 1 1.64Bu zincir dört işlemden oluşuyor. Yukarıdaki genel bakış panelinin üç sütununu da aynı zincir üretti; burada yalnızca yaş sütunu için parçalıyoruz.
Önce gruplama anahtarını hazırlıyoruz. trimws() sınıf kodundaki olası dolgu boşluğunu atar; satır sayısı değişmez:
sinifli <- ham |>
  mutate(sinif = trimws(class))

sinifli
#> # A tibble: 6,776 × 7
#> claim_no state class gender age claim_amount sinif
#> <chr> <chr> <chr> <chr> <dbl> <dbl> <chr>
#> 1 H00001 STATE 14 C6 M 97 1134. C6
#> 2 H00002 STATE 15 C6 M NA 3761. C6
#> 3 H00003 STATE 15 C11 <NA> 95 7842. C11
#> 4 H00004 STATE 15 F6 F NA 2385. F6
#> 5 H00005 STATE 15 F6 M 95 650 F6
#> 6 H00006 STATE 15 F6 M NA 391. F6
#> 7 H00007 STATE 15 C11 M 94 3776. C11
#> 8 H00008 STATE 10 C6 M 94 415. C6
#> 9 H00009 STATE 14 C11 M NA 2284. C11
#> 10 H00010 STATE 03 C11 M 93 665. C11
#> # ℹ 6,766 more rowsgroup_by() ile summarise() birlikte her sınıfı tek satıra indirir. kayit = n() sınıftaki satır sayısını verir; diğer iki özet ise aynı is.na(age) mantıksal vektöründen üretilir: sum() kaç tane olduğunu, mean() ise oranını verir — mantıksal vektörde TRUE 1 sayıldığı için ortalama doğrudan orandır. 100 * çarpanı yüzdeye çevirir. .groups = "drop" özetten sonra gruplamayı kaldırır; burada tek gruplama değişkeni olduğu için yazılmasa da sonuç gruplu kalmazdı. Yazılmasının nedeni, iki gruplama değişkeniyle summarise()’in yalnızca sonuncusunu düşürüp tabloyu gruplu bırakacak olmasıdır.
sinif_ozeti <- sinifli |>
  group_by(sinif) |>
  summarise(
    kayit = n(),
    eksik_yas = sum(is.na(age)),
    oran = 100 * mean(is.na(age)),
    .groups = "drop"
  )

sinif_ozeti
#> # A tibble: 18 × 4
#> sinif kayit eksik_yas oran
#> <chr> <int> <int> <dbl>
#> 1 C1 726 48 6.61
#> 2 C11 1151 86 7.47
#> 3 C1A 77 2 2.60
#> 4 C1B 424 10 2.36
#> 5 C1C 38 1 2.63
#> 6 C2 61 1 1.64
#> 7 C6 913 306 33.5
#> 8 C7 913 22 2.41
#> 9 C71 1129 25 2.21
#> 10 C72 85 2 2.35
#> 11 C7A 113 3 2.65
#> 12 C7B 686 18 2.62
#> 13 C7C 81 2 2.47
#> 14 F1 29 4 13.8
#> 15 F11 40 7 17.5
#> 16 F6 158 56 35.4
#> 17 F7 59 4 6.78
#> 18 F71 93 2 2.15Son adım sıralar. arrange(desc(...)) olmadan tablo sınıf adına göre alfabetik gelir ve desen görünmez — sıralama burada bir süs değil, bulguyu görünür kılan adımdır:
sinifli |>
  group_by(sinif) |>
  summarise(
    kayit = n(),
    eksik_yas = sum(is.na(age)),
    oran = 100 * mean(is.na(age)),
    .groups = "drop"
  ) |>
  arrange(desc(oran))
#> # A tibble: 18 × 4
#> sinif kayit eksik_yas oran
#> <chr> <int> <int> <dbl>
#> 1 F6 158 56 35.4
#> 2 C6 913 306 33.5
#> 3 F11 40 7 17.5
#> 4 F1 29 4 13.8
#> 5 C11 1151 86 7.47
#> 6 F7 59 4 6.78
#> 7 C1 726 48 6.61
#> 8 C7A 113 3 2.65
#> 9 C1C 38 1 2.63
#> 10 C7B 686 18 2.62
#> 11 C1A 77 2 2.60
#> 12 C7C 81 2 2.47
#> 13 C7 913 22 2.41
#> 14 C1B 424 10 2.36
#> 15 C72 85 2 2.35
#> 16 C71 1129 25 2.21
#> 17 F71 93 2 2.15
#> 18 C2 61 1 1.64Bu son aşama kutunun yukarısındaki blokla aynı çıktıyı verir; parçalamanın eksiksiz olduğunu bu karşılaştırma gösterir.
Desen tartışmasız: F6 sınıfında yaşların %35,4’ü eksik, C2 sınıfında %1,6’sı — yirmi kattan fazla fark.
Tablo da panel de her sınıfı tek tek okutuyor. Aynı soruyu tek bir sayıyla soran bir test de var: ki-kare bağımsızlık testi (chi-squared test of independence). Test iki kategorik değişkenin çapraz tablosuna bakar ve şunu sorar: iki değişken birbirinden bağımsız olsaydı, hücrelerdeki sayılar bu kadar farklı çıkar mıydı? Bizim sorumuzda değişkenlerden biri “değer eksik mi?”, öbürü gözlenen bir sütun.
Test, MCAR’ın veriden sınanabilen yanını sınar. MCAR doğruysa eksiklik hiçbir sütuna bağlı değildir, gözlenenlere de. Test bağımsızlığı reddederse o sütun MCAR olamaz. Reddetmezse MCAR ile çelişen bir şey bulunmamış olur; ama bu MCAR’ın kanıtı değildir, çünkü kurguda gördüğümüz gibi MNAR da gözlenen sütunlarda hiçbir iz bırakmayabilir.
Önce testin neye baktığını görelim: yaş eksikliğinin sınıflara göre çapraz tablosu.
yas_sinif_tablosu <- table(sinif = trimws(ham$class), yas_eksik = is.na(ham$age))
yas_sinif_tablosu
#> yas_eksik
#> sinif FALSE TRUE
#> C1 678 48
#> C11 1065 86
#> C1A 75 2
#> C1B 414 10
#> C1C 37 1
#> C2 60 1
#> C6 607 306
#> C7 891 22
#> C71 1104 25
#> C72 83 2
#> C7A 110 3
#> C7B 668 18
#> C7C 79 2
#> F1 25 4
#> F11 33 7
#> F6 102 56
#> F7 55 4
#> F71 91 2table(sinif = …, yas_eksik = …) — iki vektörün her değer çiftinin kaç kez görüldüğünü sayar. Her satır bir sınıftır; FALSE sütunu o sınıfta yaşı gözlenen, TRUE sütunu yaşı eksik kayıtların sayısıdır. Argümanlara verdiğimiz adlar tablonun başlıklarına geçer.Test tablonun her hücresindeki sayıyı o hücrenin beklenen sayısıyla (expected count) karşılaştırır: iki değişken bağımsız olsaydı orada görülecek sayı. Bağımsızlık altında her sınıfın eksik payı dosya genelindeki payla aynıdır; beklenen sayı \(E\) bu yüzden hücrenin satır ve sütun toplamlarından gelir. \(O\) hücrede gözlenen sayı, \(n\) tablonun toplamı olmak üzere:
\[ E=\frac{\text{satır toplamı}\times\text{sütun toplamı}}{n}, \qquad \chi^2=\sum_{\text{hücreler}}\frac{(O-E)^2}{E}. \]
Her hücre, gözlenenle beklenen arasındaki farkın karesini beklenene bölerek katkıda bulunur; iki değişken bağımsızsa hücreler beklenene yakın düşer ve toplam küçük kalır. C6 satırının eksik hücresini elle hesaplayalım: satırın toplamı 913 (607 + 306), sütunun toplamı yaşı eksik 599 kayıt, \(n\) = 6.776.
\[ E=\frac{913\times599}{6.776}\approx80{,}71, \qquad \frac{(306-80{,}71)^2}{80{,}71}\approx628{,}9. \]
Bağımsızlık altında C6’da yaklaşık 81 eksik yaş beklenirdi; gözlenen 306.
Testi chisq.test() yapar; çapraz tabloyu verip çağırmak yeter:
chisq.test(yas_sinif_tablosu)#>
#> Pearson's Chi-squared test
#>
#> data: yas_sinif_tablosu
#> X-squared = 1032.5, df = 17, p-value < 2.2e-16Çıktıdaki X-squared yukarıdaki \(\chi^2\)’dir, yani 36 hücrenin katkılarının toplamı: 1.032,5. df serbestlik derecesidir: 18 sınıf ve iki durum için (18 − 1) × (2 − 1) = 17 olur. p-value ise iki değişken bağımsız olsaydı en az bu büyüklükte bir istatistik görme olasılığıdır; < 2.2e-16 R’ın gösterebildiği en küçük değerdir, yani pratikte sıfır. Yaş eksikliği sınıftan bağımsız değildir.
İstatistiğin %61’ini tek bir hücre taşıyor: C6’nın eksik hücresi, 628,9.
Bu p değeri bir yaklaşımdır ve yaklaşımın bir koşulu vardır: her hücrenin beklenen sayısı \(E\) en az 5 olmalıdır. Küçük sınıflarda bu tutmuyor:
sum(chisq.test(yas_sinif_tablosu)$expected < 5)#> [1] 3chisq.test(...)$expected — testin sonucunda her hücrenin beklenen sayısı, yani \(E\); < 5 her birini sınar, sum() koşulu sağlamayanları sayar.Beklenen sayısı 5’in altında kalan 3 hücre var. R bu durumda bir uyarı yazar, ama bu sitede uyarılar gösterilmiyor; uyarısı görülmeden okunan bir p değeri yanıltabilir. Çözüm p değerini benzetimle hesaplamaktır: R, satır ve sütun toplamları gözlenen tabloyla aynı olan binlerce rastgele tablo üretir ve istatistiği gözleneni aşanların payını sayar. Bu yol beklenen sayı koşuluna ihtiyaç duymaz.
Sınıf tek gözlenen sütun değil. Yaş eksikliğini dört gözlenen sütunla aynı yoldan sınayalım: her satırda dolu olan sınıf ve eyalet, bir de öbür iki sütun, cinsiyet ve hasar tutarı. Cinsiyetin ve tutarın testleri aynı tabloyu kullanacak ve yaşı da gözlenen bir sütun olarak alacak; yaşın gruplarını bu yüzden şimdiden kuruyoruz. Yaş da tutar da sayı olduğu için önce gruplara ayrılır:
gozlenen <- ham |>
  transmute(
    sinif        = trimws(class),
    eyalet       = trimws(state),
    cinsiyet     = gender,
    yas_bandi    = cut(age, c(49, 59, 69, 79, 100)),
    tutar_ceyrek = ntile(claim_amount, 4)
  )

head(gozlenen)
#> # A tibble: 6 × 5
#> sinif eyalet cinsiyet yas_bandi tutar_ceyrek
#> <chr> <chr> <chr> <fct> <int>
#> 1 C6 STATE 14 M (79,100] 3
#> 2 C6 STATE 15 M <NA> 4
#> 3 C11 STATE 15 <NA> (79,100] 4
#> 4 F6 STATE 15 F <NA> 4
#> 5 F6 STATE 15 M (79,100] 2
#> 6 F6 STATE 15 M <NA> 1transmute() — mutate() gibi yeni sütunlar kurar, ama tabloda yalnızca adı yazılan sütunları bırakır: gozlenen bu yüzden beş sütundur. cut(age, c(49, 59, 69, 79, 100)) — sayıyı verilen sınırlarla aralıklara böler. (49,59] 50 ile 59 arası demektir: yuvarlak parantez sınırın dahil olmadığını, köşeli parantez dahil olduğunu söyler. Dosyadaki gözlenen yaşların en küçüğü 50, en büyüğü 97 olduğu için hiçbir yaş aralıkların dışında kalmaz; yaşı eksik satır NA kalır.ntile(claim_amount, 4) — tutarları sıralayıp eşit büyüklükte dört gruba ayırır: 1 en küçük çeyrek, 4 en büyük. Tutarı eksik satır NA kalır.Asıl hesap: bir eksik sütunla bir gözlenen sütunu alıp testi benzetimle yapan küçük bir işlev, ve yaş için dört çağrı:
bagimsizlik_testi <- function(eksik_sutun, gozlenen_sutun) {
  tablo <- table(gozlenen[[gozlenen_sutun]], is.na(ham[[eksik_sutun]]))
  test  <- chisq.test(tablo, simulate.p.value = TRUE, B = 10000)
  tibble(
    eksik    = eksik_sutun,
    gozlenen = gozlenen_sutun,
    kayit    = sum(tablo),
    ki_kare  = test$statistic,
    p        = test$p.value,
    cramer_v = sqrt(test$statistic / sum(tablo))
  )
}

set.seed(5114)
yas_bagimsizlik <- bind_rows(
  bagimsizlik_testi("age", "sinif"),
  bagimsizlik_testi("age", "eyalet"),
  bagimsizlik_testi("age", "cinsiyet"),
  bagimsizlik_testi("age", "tutar_ceyrek")
)

yas_bagimsizlik
#> # A tibble: 4 × 6
#> eksik gozlenen kayit ki_kare p cramer_v
#> <chr> <chr> <int> <dbl> <dbl> <dbl>
#> 1 age sinif 6776 1033. 0.000100 0.390
#> 2 age eyalet 6776 43.7 0.000200 0.0803
#> 3 age cinsiyet 6479 0.164 0.678 0.00504
#> 4 age tutar_ceyrek 6643 2.49 0.475 0.0194chisq.test(tablo, simulate.p.value = TRUE, B = 10000) — testi yapar; iki argüman p değerinin nasıl hesaplanacağını seçer:
simulate.p.value = TRUE — p değerini yaklaşımla değil benzetimle hesaplar, yani yukarıdaki beklenen sayı koşulu ortadan kalkar. Yaşın dört testinde iki yol aynı karara varıyor; farkın bir kararı değiştirebilecek kadar büyüdüğü yeri hasar tutarında göreceğiz. B = 10000 — üretilecek rastgele tablo sayısı. Benzetimle bulunabilecek en küçük p değeri 1 / (B + 1), yani 0,0001’dir; yaş–sınıf testi tam bu sınıra düşer, bu yüzden “p < 0,001” diye okunur. set.seed(5114) — benzetim rastgele tablolar ürettiği için her çalıştırmada p değerleri biraz oynar; tohum (seed), aynı kodu çalıştıran herkesin aynı sayıları görmesini sağlar. Tohumu yaşın dört testinden önce bir kez koyuyoruz, bu yüzden bu dört p değeri çağrıların sırasına da bağlıdır. Cinsiyetin ve tutarın testleri kendi alt bölümlerinde kendi tohumlarıyla koşar; bir bölümün sayıları öbürünün koşup koşmadığına bağlı kalmaz.sqrt(test$statistic / sum(tablo)) — Cramér V: ilişkinin gücünü 0 (hiç ilişki yok) ile 1 (tam ilişki) arasında tek sayıyla özetler. p değeri ilişkinin var olup olmadığını, V ne kadar güçlü olduğunu söyler; 6.776 kayıtlık bir dosyada çok zayıf bir ilişki de küçük bir p üretebilir. İki sütunlu bir tabloda formül bu kadar basittir. gozlenen[[gozlenen_sutun]] — sütunu adıyla seçer. table() NA olan değerleri saymadığı için, gözlenen sütunun kendisi eksik olan satırlar o testte yer almaz; kayit sütunu her testin kaç satıra dayandığını gösterir: cinsiyetle yapılan testte 6.479, tutar çeyreğiyle 6.643. Tablonun her satırı bir test. Sınıfla bağımsızlık reddediliyor (p < 0,001, Cramér V = 0,390). Eyaletle de bir ilişki var ama çok daha zayıf (V = 0,080); cinsiyet ve tutar çeyreğiyle yok (p = 0,678 ve 0,475). Eksiklik gözlenen bir değişkene bağlı olduğuna göre yaş MCAR değildir. Ama asıl mesele oranın büyüklüğü değil, hangi sınıfların kaybettiği. Sınıfın ortalama yaşını da ekleyelim — önce sınıf başına yaş ortalamasını hesaplayarak:
sinif_yas_ortalamasi <- ham |>
  mutate(sinif = trimws(class)) |>
  group_by(sinif) |>
  summarise(sinif_yasi = mean(age, na.rm = TRUE), .groups = "drop")

sinif_yas_ortalamasi
#> # A tibble: 18 × 2
#> sinif sinif_yasi
#> <chr> <dbl>
#> 1 C1 63.3
#> 2 C11 68.7
#> 3 C1A 57.7
#> 4 C1B 57.1
#> 5 C1C 55.7
#> 6 C2 59.1
#> 7 C6 77.9
#> 8 C7 59.9
#> 9 C71 58.8
#> 10 C72 58.4
#> 11 C7A 58.5
#> 12 C7B 56.4
#> 13 C7C 55.1
#> 14 F1 68.4
#> 15 F11 71.8
#> 16 F6 78.9
#> 17 F7 61.3
#> 18 F71 59.9Bu özet tek başına eksiklikten söz etmiyor; her sınıf için yalnızca gözlenen yaşların ortalamasını taşıyor. Karşılaştırma, onu bir önceki eksiklik tablosunun yanına getirdiğimizde doğuyor: left_join() iki özeti sinif anahtarı üzerinden eşleştirir, böylece bir sınıfın ne kadarını kaybettiği ile o sınıfın yaşı aynı satıra düşer. Çıktıda eksik oranı yüksek sınıfların yaş ortalamasına bakalım.
mekanizma_yas_egim <- eksik_yas_sinif |>
  left_join(sinif_yas_ortalamasi, by = "sinif")

mekanizma_yas_egim
#> # A tibble: 18 × 5
#> sinif kayit eksik_yas oran sinif_yasi
#> <chr> <int> <int> <dbl> <dbl>
#> 1 F6 158 56 35.4 78.9
#> 2 C6 913 306 33.5 77.9
#> 3 F11 40 7 17.5 71.8
#> 4 F1 29 4 13.8 68.4
#> 5 C11 1151 86 7.47 68.7
#> 6 F7 59 4 6.78 61.3
#> 7 C1 726 48 6.61 63.3
#> 8 C7A 113 3 2.65 58.5
#> 9 C1C 38 1 2.63 55.7
#> 10 C7B 686 18 2.62 56.4
#> 11 C1A 77 2 2.60 57.7
#> 12 C7C 81 2 2.47 55.1
#> 13 C7 913 22 2.41 59.9
#> 14 C1B 424 10 2.36 57.1
#> 15 C72 85 2 2.35 58.4
#> 16 C71 1129 25 2.21 58.8
#> 17 F71 93 2 2.15 59.9
#> 18 C2 61 1 1.64 59.1Tablo eksik oranına göre sıralı; iki sütununu birlikte okuyalım. En çok kaybeden iki sınıf, F6 (%35,4) ve C6 (%33,5), aynı zamanda en yaşlı iki sınıftır: gözlenen yaş ortalamaları 78,9 ve 77,9.
Öbür uçta oranı %3’ün altında kalan 11 sınıf var ve hepsinin yaş ortalaması 55,1 ile 59,9 arasında, yani dosyanın genel gözlenen ortalamasının (63,05) altında. Eksik satırları silmek bu yüzden yaş ortalamasını aşağı çeker — tesadüfen değil, sistematik olarak. Yanlılığın mekanizması budur: en çok satır kaybeden sınıflar en yaşlı sınıflardır.
Tablo bir eğim değil bir basamak gösteriyor: 11 sınıf %1,6 ile %2,7 arasında dar bir kümede, iki sınıf %33’ün üstünde, arada yalnızca beş sınıf var. “Her yüzde birlik eksiklik yaşı şu kadar artırır” diye bir doğru uydurmak bu tabloyu yanlış okumak olur.
Eksik yaşların %65,4’ü de yalnızca iki sınıftan geliyor: 913 kayıtlık C6 (306 eksik) ve 1.151 kayıtlık C11 (86 eksik). C11’in oranı düşüktür, ama sınıf büyük olduğu için eksik sayısı yüksektir.
Bir çekince: sinif_yasi sütunu o sınıfta gözlenen yaşlardan hesaplanıyor. Yani tablo MAR varsayımını sınamıyor, kullanıyor: gerçek sınıf ortalamalarını göremiyoruz, çünkü eksik yaşlar tam da bu ortalamaya girmesi gereken değerlerdir.
Yaş için veri bu kadarını söylüyor: eksiklik MCAR değildir ve büyük ölçüde sınıfla açıklanır. Sınıf içinde eksikliğin yaşın kendisine de bağlı olup olmadığını ise veri söyleyemez; bunu görmek için eksik yaşları görmemiz gerekirdi. Sınıf farkı eksikliği bu kadar iyi açıkladığına göre MAR, yani “sınıf bilindiğinde eksiklik yaşın kendisine bağlı değildir”, makul bir çalışma varsayımıdır. Kararı üç sütunu da sınadıktan sonra vereceğiz.
Genel bakış paneli bu alt bölümün epey yukarısında kaldı. Grafiği bölümün başında mekanizma_panel_grafigi adıyla saklamıştık; adını yazmak onu yeniden çizer:
mekanizma_panel_grafigi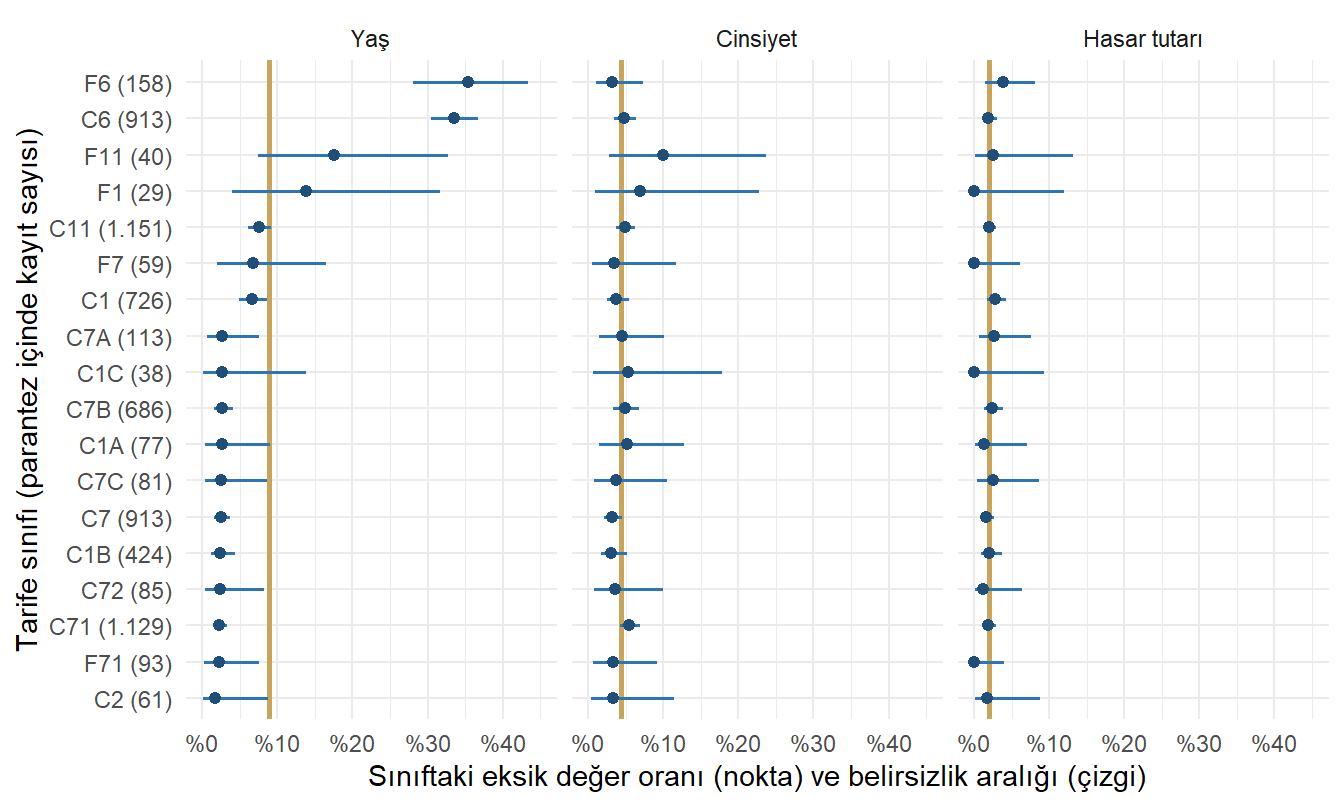
Şimdi panelin ortadaki grafiğine bakın. Oranlar %3,1 ile %10,0 arasında, genel oran %4,4 ve 18 aralığın 18’i bu genel oranı içine alıyor. En yüksek değer 40 kayıtlık F11 sınıfına ait (%10,0, yani dört kayıt), ama o sınıfın aralığı %2,8 ile %23,7 arasına yayılıyor — 40 kayıt bir oranı bu kadar belirsiz bırakır.
Aynı soruyu testle soralım: cinsiyet eksikliği sınıf, eyalet, yaş bandı ve tutar çeyreğiyle. İşlev ile gözlenen sütunlar yaşın alt bölümünde kuruldu; burada yalnızca çağrılar ve tohum değişiyor:
set.seed(5116)
cinsiyet_bagimsizlik <- bind_rows(
  bagimsizlik_testi("gender", "sinif"),
  bagimsizlik_testi("gender", "eyalet"),
  bagimsizlik_testi("gender", "yas_bandi"),
  bagimsizlik_testi("gender", "tutar_ceyrek")
)

cinsiyet_bagimsizlik
#> # A tibble: 4 × 6
#> eksik gozlenen kayit ki_kare p cramer_v
#> <chr> <chr> <int> <dbl> <dbl> <dbl>
#> 1 gender sinif 6776 14.7 0.608 0.0466
#> 2 gender eyalet 6776 11.7 0.465 0.0416
#> 3 gender yas_bandi 6177 0.837 0.835 0.0116
#> 4 gender tutar_ceyrek 6643 0.971 0.806 0.0121Yaş bandıyla yapılan test 6.177 satıra dayanıyor: yaşı eksik 599 satırın yaş bandı da yok ve table() onları saymaz.
Ki-kare testleri de bir desen bulmuyor: dört testin hiçbiri bağımsızlığı reddetmiyor, p değerleri 0,465 ile 0,835 arasında. İlişkinin gücü de ihmal edilebilir: Cramér V sınıfla 0,047, eyaletle 0,042, yaş bandı ve tutar çeyreğiyle 0,012; yaş eksikliğinin sınıfla ilişkisi 0,390’dı.
Cümleyi dikkatli kurmak gerekiyor. Testler bir desen bulmadı; bu, desen olmadığının kanıtı değildir. Cinsiyet için veri MCAR ile çelişmiyor, o kadar. Bu yüzden MCAR makul bir çalışma varsayımıdır — ve MCAR doğruysa o satırları silmek cinsiyet dağılımını bozmaz. Kurgu, iz bırakmayan bir eksikliğin MNAR da olabileceğini göstermişti; cinsiyet için bu olasılığı dışarıda bırakan şey veri değil, varsayımımızdır.
Şimdi panelin sağdaki grafiğine bakın ve onu ortadakiyle karşılaştırın. Oranlar %0,0 ile %3,8 arasında, genel oran %2,0, ve yine 18 aralığın 18’i genel oranı içine alıyor. İki panel elbette birebir aynı görünmüyor — sağdaki daha dar. Ama teşhis açısından ikisi de aynı şeyi söylüyor: ayrışan sınıf sayısı ikisinde de sıfır.
Tutarın dört testi, bu kez sınıf, eyalet, cinsiyet ve yaş bandıyla:
set.seed(5117)
tutar_bagimsizlik <- bind_rows(
  bagimsizlik_testi("claim_amount", "sinif"),
  bagimsizlik_testi("claim_amount", "eyalet"),
  bagimsizlik_testi("claim_amount", "cinsiyet"),
  bagimsizlik_testi("claim_amount", "yas_bandi")
)

tutar_bagimsizlik
#> # A tibble: 4 × 6
#> eksik gozlenen kayit ki_kare p cramer_v
#> <chr> <chr> <int> <dbl> <dbl> <dbl>
#> 1 claim_amount sinif 6776 11.9 0.792 0.0420
#> 2 claim_amount eyalet 6776 27.5 0.0155 0.0637
#> 3 claim_amount cinsiyet 6479 0.279 0.643 0.00657
#> 4 claim_amount yas_bandi 6177 0.568 0.904 0.00959Ki-kare testleri sınıf, cinsiyet ve yaş bandıyla bağımsızlığı reddetmiyor (p = 0,792; 0,643; 0,904). Tek istisna eyalet: p = 0,0155 ve Cramér V = 0,064, yaşın sınıfla ilişkisinin (0,390) altıda biri kadar zayıf.
Eyalet testi benzetimin neden gerektiğini de gösteriyor. Tutar–eyalet tablosunda beklenen sayısı 5’in altında kalan beş hücre var. simulate.p.value = TRUE verilmeseydi yaklaşık p kullanılır ve 0,0155 yerine 0,0066 çıkardı, yaklaşık 2,3 kat küçük; bunu haber veren uyarı da bu sitede görünmez.
Bu tek sonucu dikkatle okumak gerekiyor. Üç sütun için toplam on iki test yaptık ve üçü bağımsızlığı %5 düzeyinde reddetti: ikisi yaşta, biri burada. Eksiklik hiçbir şeye bağlı olmasa bile on iki testten birinin şans eseri 0,05’in altına düşmesi şaşırtıcı olmazdı. Yine de izin nereden gelebileceğini gözlenen tutarlardan görebiliriz. Önce “büyük hasar” için bir eşik koyalım: gözlenen tutarların %90’ının altında kaldığı değer.
esik_90 <- quantile(ham$claim_amount, 0.90, na.rm = TRUE)
esik_90
#> 90%
#> 3820.09quantile(ham$claim_amount, 0.90, na.rm = TRUE) — gözlenen tutarların %90’ının altında kaldığı değeri verir: 3.820,09. na.rm = TRUE eksik tutarları hesabın dışında bırakır. Sonra her eyalette bu eşiği aşan hasarların payı:
buyuk_hasar_payi <- tapply(ham$claim_amount >= esik_90, trimws(ham$state),
                           mean, na.rm = TRUE)
round(100 * sort(buyuk_hasar_payi), 1)
#> STATE 14 STATE 01 STATE 04 STATE 02 STATE 07 STATE 15 STATE 13 STATE 03
#> 4.2 7.8 7.9 8.7 9.1 9.5 9.9 10.5
#> STATE 11 STATE 10 STATE 17 STATE 06 STATE 12
#> 11.1 11.2 12.8 13.8 15.5Büyük hasarların payı eyaletten eyalete %4,2 ile %15,5 arasında değişiyor. Demek ki eyaletteki izin iki okuması var ve ikisi de veriyle uyumlu:
Kurgudaki altı poliçe tam bunu göstermişti: iki senaryo aynı teşhis tablosunu üretir. Eksik tutarları göremediğimiz için veri bu iki okumayı ayıramaz.
Burada bir varsayım yapmak zorundayız ve varsayım tablodan değil, verinin nasıl toplandığından gelir. Hasar birimine sorulacak soru şudur: tutarı girilmemiş dosyalar hangileri? “Büyük hasarlar daha uzun süre açık kalır, kapanış tutarları henüz girilmemiştir” cevabı MNAR demektir. Bu dosya için o cevap elimizde yok. Cevap yokken temkinli analist MNAR’ı dışarıda bırakmaz, çünkü MAR sanılıp düzeltilen bir MNAR tahmini yanlış olduğu hâlde güven verir. Tutar için çalışma varsayımımız bu yüzden MNAR.
Üç sütunu sınadık. Kararlar ve her kararın neye dayandığı:
| Sütun | Sınamanın gösterdiği | Karar | Dayanağı |
|---|---|---|---|
age |
Sınıfla güçlü ilişki (V = 0,390), eyaletle zayıf | MCAR değil; MAR | MCAR’ın reddi veriden; MAR bir varsayım: sınıf içinde eksiklik yaşa bağlı değil |
gender |
Dört testin hiçbirinde ilişki yok | MCAR | Veri çelişmiyor ama kanıtlamıyor da: varsayım |
claim_amount |
Yalnız eyaletle zayıf ilişki (V = 0,064) | MCAR değil; MNAR | Veri MAR ile MNAR’ı ayıramıyor: veri toplamaya dair varsayım |
Şimdi cevabı açıklayabiliriz. Bu dosyanın eksiklerini öğretim için biz oluşturduk; nasıl oluşturduğumuz data_manifest.csv dosyasında yazılı. Yaşları sınıfa bağlı olasılıklarla sildik: MAR. Cinsiyetleri her satırda aynı olasılıkla sildik: MCAR. Tutarları ise yalnızca büyük hasarlardan, gözlenmeyen değerin kendisine bakarak sildik: MNAR. Kurgunun diliyle age P4/P6 senaryosuna, gender P2/P5’e, claim_amount P5/P6’ya karşılık geliyor.
Üç kararın üçü de doğru çıktı, ama farklı yollardan. Yaşınkini büyük ölçüde veri verdi, cinsiyetinki verinin çelişmemesine dayandı, tutarınki yalnızca varsayıma. Tutarda veriye güvenen biri eyaletle bulunan zayıf ilişkiye bakıp “MAR, eyalete göre düzeltelim” derdi ve yanılırdı: iz eyaletin değil, büyük hasarların izidir. Bir sonraki bölüm, tutardaki kaybı hiçbir yöntemin gideremediğini gerçek tutarlarla ölçecek.
Buradan çıkan iki cümle bu haftanın en önemli çiftidir:
Dolayısıyla MAR ile MNAR arasındaki karar veriden değil, verinin nasıl toplandığından çıkar. Tutar için yaptığımız varsayım bu türdendir: bir veri sözlüğü ya da kaynak sistem bilgisidir, tablo değildir.
Bir sonraki bölümde bu üç sütuna beş yöntemden uygun olanları uygulayıp hangisinin nerede doğru olduğunu ölçeceğiz.
Beş yöntemi artan karmaşıklık sırasıyla deniyoruz: silmek; ortalamayla, medyanla, grup ortalamasıyla ve modla doldurmak. Her yöntemi hangi sütuna uyguladığımız rastgele değil: her sütun farklı bir mekanizma taşıdığı için her yöntem farklı bir sonuç veriyor.
Dört yöntemi tek tabloda karşılaştıralım. Ortalamanın yanına standart sapma ve standart hata da koyuyoruz — nedenini birazdan göreceksiniz.
Tablo tek bir blokta değil, üç adımda kuruluyor: önce sınıf ortalamalarından küçük bir arama tablosu, sonra dört yöntemin dört sütunu, en sonunda ozet() bu dört sütunu tek matriste topluyor. Ara nesneleri ayrı ayrı yazdırdığımız için tablodaki her satırın nereden geldiği görünür.
Önce dört yöntemin en karmaşığı olan grup içi ortalamanın kaynağı: sınıf ortalamaları.
sinif_ortalamasi <- ham |>
  mutate(sinif = trimws(class)) |>
  group_by(sinif) |>
  summarise(sinif_yas = mean(age, na.rm = TRUE), .groups = "drop")

sinif_ortalamasi
#> # A tibble: 18 × 2
#> sinif sinif_yas
#> <chr> <dbl>
#> 1 C1 63.3
#> 2 C11 68.7
#> 3 C1A 57.7
#> 4 C1B 57.1
#> 5 C1C 55.7
#> 6 C2 59.1
#> 7 C6 77.9
#> 8 C7 59.9
#> 9 C71 58.8
#> 10 C72 58.4
#> 11 C7A 58.5
#> 12 C7B 56.4
#> 13 C7C 55.1
#> 14 F1 68.4
#> 15 F11 71.8
#> 16 F6 78.9
#> 17 F7 61.3
#> 18 F71 59.9Zincir üç işlemden oluşuyor:
mutate() — sınıf kodundaki olası dolgu boşluğunu trimws() ile atar.group_by() — satırları sınıfa böler.summarise() — her sınıfı tek satıra indirir.Sonuç 18 satırlık bir arama tablosudur. İki argümanı da sonucu doğrudan belirler:
na.rm = TRUE — ortalamayı almadan önce eksik yaşları dışarıda bırakır. Verilmezse: 18 sınıfın hepsi en az bir eksik yaş taşıdığı için 18 sınıf ortalamasının tamamı NA olur; grup içi ortalama da eksikleri NA ile “doldurur”, yani hiçbir şey doldurmaz. .groups = "drop" — özetten sonra gruplamayı kaldırır. Tek gruplama değişkeniyle sonuç zaten gruplanmamış olurdu; yazılmasının nedeni, iki gruplama değişkeninde summarise()’in yalnızca sonuncusunu düşürmesidir.Sonra dört yöntem, dört sütun.
yas_dolu <- ham |>
  mutate(sinif = trimws(class)) |>
  left_join(sinif_ortalamasi, by = "sinif") |>
  mutate(
    silme = age,
    ortalama_atamasi = ifelse(is.na(age), mean(age, na.rm = TRUE), age),
    medyan_atamasi = ifelse(is.na(age), median(age, na.rm = TRUE), age),
    grup_ici_ortalama = ifelse(is.na(age), sinif_yas, age)
  )

yas_dolu |>
  select(sinif, sinif_yas, silme,
         ortalama_atamasi, medyan_atamasi, grup_ici_ortalama)
#> # A tibble: 6,776 × 6
#> sinif sinif_yas silme ortalama_atamasi medyan_atamasi grup_ici_ortalama
#> <chr> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 C6 77.9 97 97 97 97
#> 2 C6 77.9 NA 63.1 61 77.9
#> 3 C11 68.7 95 95 95 95
#> 4 F6 78.9 NA 63.1 61 78.9
#> 5 F6 78.9 95 95 95 95
#> 6 F6 78.9 NA 63.1 61 78.9
#> 7 C11 68.7 94 94 94 94
#> 8 C6 77.9 94 94 94 94
#> 9 C11 68.7 NA 63.1 61 68.7
#> 10 C11 68.7 93 93 93 93
#> # ℹ 6,766 more rowsyas_dolu 6.776 satır ve 12 sütundur; hepsi ekrana sığmadığı için yalnızca sınıfı, sınıfın ortalama yaşını ve dört yöntem sütununu basıyoruz. İlk on satırın dördünde yaş eksik (2, 4, 6 ve 9 numaralı satırlar). O satırlarda yöntemler ayrışır:
silme hâlâ NA taşır, çünkü silmek bir doldurma yöntemi değildir: eksik değeri olduğu yerde bırakır.ortalama_atamasi dört satıra da aynı sayıyı yazar, gözlenen yaşların ortalamasını (63,05; tibble onu kısaltıp 63.1 diye basar). medyan_atamasi da hepsine aynı sayıyı yazar: gözlenen yaşların medyanı, 61. grup_ici_ortalama her satıra kendi sınıfının ortalamasını yazar, yani sinif_yas sütunundaki sayıyı: C6 için 77,9, F6 için 78,9, C11 için 68,7. Yaşı gözlenen satırlarda dört sütun aynıdır: yöntemler yalnızca eksik hücrede ayrışır. Doldurulan üç sütunda eksik kalmadığını aşağıdaki karşılaştırma tablosunun n sütunundan okuyacaksınız.
Bloğun çağrılarına ve argümanlarına yakından bakalım:
left_join() — her hasar satırının yanına kendi sınıfının ortalamasını yazar.by = "sinif" — birleştirme anahtarı. sinif_ortalamasi’nda her sınıf bir kez geçtiği için satır sayısı değişmez, 6.776 kalır. Yazılmasa da dplyr tek ortak adı, sinif’i, kendisi bulurdu; anahtarı yazmak, ikinci bir ortak ad eklendiği gün birleştirmenin sessizce değişmesini önler. mutate() — tek bir blok dört sütunu birden kurar; dördü de age sütunundan türer, ama aynı biçimde değil.silme = age — sütunun düz kopyasıdır; hiçbir dalı yoktur, bu yüzden eksikleri de olduğu gibi taşır.ifelse() — diğer üç sütunda her satırda tek bir soru sorar: bu satırda yaş eksik mi? Eksik değilse üçü de gözlenen yaşı yazar; yöntemler yalnızca “eksikse” dalında ayrışır — genel ortalama, genel medyan ya da satırın kendi sınıfının ortalaması.na.rm = TRUE — bu kez mean() ve median() içinde: dolgu değerini gözlenen 6.177 yaştan hesaplar. Verilmezse: mean(age) NA döner, ifelse() eksik satırlara NA yazar ve “atama yapılmış” sütunda 599 eksik olduğu gibi kalır. select(...) — tablonun yalnızca adı verilen sütunlarını, verilen sırayla basar. yas_dolu’nun kendisi değişmez, 12 sütun yerinde durur; daralan yalnızca ekrana giden görünümdür. Son adım özet fonksiyonunu tanımlar ve dört sütunu tek tabloda toplar.
ozet <- function(x) {
  x <- x[!is.na(x)]
  c(n = length(x), ortalama = mean(x), std_sapma = sd(x), std_hata = sd(x) / sqrt(length(x)))
}

karsilastirma_yas <- rbind(
  silme = ozet(yas_dolu$silme),
  ortalama_atamasi = ozet(yas_dolu$ortalama_atamasi),
  medyan_atamasi = ozet(yas_dolu$medyan_atamasi),
  grup_ici_ortalama = ozet(yas_dolu$grup_ici_ortalama)
)
round(karsilastirma_yas, 4)
#> n ortalama std_sapma std_hata
#> silme 6177 63.0515 10.3606 0.1318
#> ortalama_atamasi 6776 63.0515 9.8920 0.1202
#> medyan_atamasi 6776 62.8701 9.9092 0.1204
#> grup_ici_ortalama 6776 63.8770 10.4922 0.1275Dört satırın dördü de aynı ozet()’ten geçer, ama n sütunu tek bir sayı göstermez — silme için 6.177, diğer üçü için 6.776 çıkar. Nedeni fonksiyonun kendi satırlarıdır:
x <- x[!is.na(x)] — her sütunu özetlemeden önce eksikleri atar. silme hâlâ 599 NA taşıdığı için ondan geriye 6.177 değer kalır; doldurulmuş üç sütunda atılacak hiçbir şey yoktur. Tablonun bütün sayıları bu tek satırın arkasından gelir.sd(x) / sqrt(length(x)) — standart hata: standart sapmayı \(\sqrt{n}\)’e böler. Ortalama ataması bu kesrin iki yanını birden oynatır; payı 10,3606’dan 9,8920’ye indirir, paydayı 6.177 yerine 6.776’nın köküne çıkarır. Yalnızca payda büyüseydi standart hata 0,1318’den 0,1259’a inerdi; gerçekte 0,1202’ye iniyor. Aradaki fark payın düşüşüdür: 599 kaydı tek bir noktaya yığmak yayılımı da daraltır. rbind() — dört özet vektörünü satır adlarıyla tek matriste toplar; tablonun sol sütununda okuduğunuz yöntem adları bu satır adlarıdır.round(karsilastirma_yas, 4) — yalnızca basımı kısaltır. karsilastirma_yas nesnesinin kendisi yuvarlanmaz; hesaplanan değerler tam duyarlıkta kalır.Öğretim için eksik değerler eklenmeden önce yaş ortalaması 63,82’ydi. Tablodan üç sonuç çıkıyor ve üçü de dersin kendisi:
Üç hüküm de tek bir karşılaştırmaya dayanıyor: eksik değerler eklenmeden önceki yaş ortalaması olan 63,82 ile. Bu sayıyı biliyoruz, çünkü eksikliği biz ürettik: kaynaktaki yaş sütunu eksiksizdi ve 599 yaşı öğretim için biz sildik; 63,82, silmeden önce dosyadaki 6.776 yaşın ortalamasıdır. Gerçek bir hasar dosyasında böyle bir sayı yoktur; elinizde yalnızca yukarıdaki tablo olur.
Her yöntemin ortalamasından bu sayıyı çıkaralım, sonra farkın büyüklüğünü o satırın kendi standart hatasına bölelim:
| Yöntem | Ortalama | Fark (yıl) | Kaç std hata |
|---|---|---|---|
| silme | 63,05 | −0,77 | 5,8 |
| ortalama ataması | 63,05 | −0,77 | 6,4 |
| medyan ataması | 62,87 | −0,95 | 7,9 |
| grup içi ortalama | 63,88 | +0,06 | 0,4 |
Standart hata, bir ortalamanın ne kadar kesin bilindiğini ölçer: yansız bir tahmin gerçek değerden çoğunlukla iki standart hatadan az uzaktır (yaklaşık %95 güven aralığı bu yüzden tahmin ± iki standart hatadır). Fark bunun çok üstündeyse rastlantıyla açıklanamaz; yöntemin kendisinden gelir.
mice bölümünde ölçeceğiz); doğru ölçüyle fark daha da küçük kalır. Tam tutturmaması ise beklenen bir şey: altı poliçelik örneğin ilk çekincesinde gördüğümüz gibi, grup içi ortalama ataması MAR altında beklenen değerde yansızdır, her seferinde tam tutturmaz. Gerçek bir projede 63,82 elinizde olmaz ve bu tabloyu kuramazsınız. Yöntemi o zaman sonuca bakarak değil, eksikliğin neye bağlı olduğunu bilerek seçersiniz. Yaş eksikliğinin sınıfa bağlı olduğunu Yaş: eksiklik neye bağlı? bölümündeki tablolar ve ki-kare testi gösterdi; sınıf bilindiğinde eksikliğin yaşın kendisine bağlı olmadığı ise veriden sınanamaz, bir varsayımdır.
Kategorik bir sütunda ortalama alamazsınız; merkez ölçüsü mod (mode), yani en sık görülen düzeydir.
mod_cinsiyet <- names(sort(table(ham$gender), decreasing = TRUE))[1]

mod_cinsiyet
#> [1] "M"Çıktı tek bir düzey adıdır ve mod_cinsiyet onu tutar: eksik cinsiyet hücrelerine yazılacak değer odur.
Yukarıdaki satır içten dışa okunur: her işlev bir öncekinin çıktısını alır.
table(x) — bir vektörü sayıma çevirir: girdi tek tek gözlemler, çıktı her düzey için bir sayı. Çıktının adları düzeylerin kendisi, değerleri o düzeyin kaç kez geçtiğidir; en dıştaki names() de o adları geri alır.sort(..., decreasing = TRUE) — sayımı büyükten küçüğe dizer, ki en sık düzey başa gelsin ve [1] onu seçsin. Verilmezse: sort() varsayılan olarak artan sıralar ve [1] en sık düzeyi değil en seyrek düzeyi seçer; kod yine çalışır, uyarı da vermez, yalnızca yanıt yanlış olur.Şimdi bu değerle doldurmanın F payını nereye taşıdığını ölçelim; cinsiyet_karsilastirma tam vaka payını modla doldurulmuş payın yanına koyar.
cinsiyet_karsilastirma <- c(
  tam_vaka_F_payi = 100 * mean(ham$gender[!is.na(ham$gender)] == "F"),
  mod_ile_F_payi = 100 * mean(ifelse(is.na(ham$gender), mod_cinsiyet, ham$gender) == "F")
)
round(cinsiyet_karsilastirma, 2)
#> tam_vaka_F_payi mod_ile_F_payi
#> 38.18 36.51Çıktıda iki pay var ve birbirinden 1,7 puan uzak. Hangisinin doğru olduğunu söylemek için bir ölçü gerekir: bu 297 cinsiyeti öğretim için biz sildik, silmeden önce F payı %38,11’di. Gerçek bir projede bu sayı elinizde olmaz; burada yalnızca yöntemleri sınamak için kullanıyoruz.
Silmek neden doğru? MCAR’da eksiklik veriyle hiç ilgisi olmayan bir nedene bağlıdır: ne eksik cinsiyetin kendisine ne de başka bir bilgiye; Cinsiyet: eksiklikte bir desen var mı? bölümündeki dört test de bir bağ bulmadı. O zaman eksik 297 kayıt 6.776 kaydın içinden rastgele seçilmiş gibidir ve geriye kalan 6.479 kayıt, dosyanın küçülmüş ama dengesini koruyan bir örneğidir. Böyle bir örneğin F payı bütününkinden ancak örnekleme gürültüsü kadar ayrılır. Tam vaka analizi %38,18 veriyor: gerçeğin 0,1 puandan az üstünde.
Modla doldurmak neden yanlış? Mod ataması 297 boş hücrenin hepsine M yazar. Oysa MCAR altında bu kayıtlar rastgele bir karışımdır: yaklaşık %38’i, yani 113 kadarı kadın olmalıdır. Gerçekte 297 kaydın 108’i kadındı ve doldurma bu 108 kadının hepsini erkek sayar. F sayısı 2.474’te kalır, M sayısı 4.005’ten 4.302’ye çıkar, payda da 6.479’dan 6.776’ya büyür:
\[ \frac{2.474}{6.776}=0{,}3651 . \]
F payı %36,51’e bu yüzden iner. Yanlılığın büyüklüğü de bellidir: doldurulan pay, tam vaka payının kayıtlı cinsiyetlerin oranıyla çarpımıdır, \(38{,}18\times(1-297/6.776)=36{,}51\); eksik oranı büyüdükçe yanlılık da büyür.
Bu farkların büyük mü küçük mü olduğunu payın standart hatası söyler. Bir oranın standart hatası \(\sqrt{p(1-p)/n}\)’dir; yaş bölümündeki gibi her yöntemi kendi standart hatasıyla ölçelim. Silmede:
\[ \sqrt{\frac{0{,}3818\times0{,}6182}{6.479}}=0{,}0060, \]
mod atamasında:
\[ \sqrt{\frac{0{,}3651\times0{,}6349}{6.776}}=0{,}0058. \]
Yani silmenin standart hatası 0,60, mod atamasınınki 0,58 puandır.
Doldurulmuş tablo bu kadınları erkeklerin sütununda sayar ve bunu hiçbir yerde belli etmez; üstelik 6.776 kaydın cinsiyetini biliyormuş gibi davrandığı için standart hatası silmeninkinden bile küçüktür. Ders şu: MCAR’da silmek yansızdır ve yalnızca kesinlik kaybettirir; mod ataması veride olmayan bir yanlılık yaratır ve onu olduğundan kesin gösterir. Yaşta aynı silme yanlıydı, çünkü orada eksiklik sınıfa bağlıydı ve kaybolan yaşlar en yaşlı sınıflardan geliyordu. Silmenin doğru olup olmadığını yöntemin kendisi değil, eksikliğin mekanizması belirler.
Temel R’de istatistiksel mod fonksiyonu yoktur. mode(x) diye bir işlev vardır ama o depolama kipini döndürür ve hiçbir uyarı vermez. Bu, haftanın “sessiz hata” temasının doğrudan kardeşidir: kod patlamaz, yanlış çalışır.
Elle. Yedi elemanlı bir vektörde sayarız: F, M, M, NA, F, M, M — M dört kez, F iki kez, bir eksik. Mod M.
Açık kod. Sayımı ve seçimi görünür yazalım.
en_sik <- function(x) {
  x <- x[!is.na(x)]          # eksikler moda katilmaz: karar burada verilir
  sayim <- table(x)
  names(sayim)[which.max(sayim)]
}

ornek <- c("F", "M", "M", NA, "F", "M", "M")
en_sik(ornek)
#> [1] "M"Buradaki tek yeni işlev which.max().
which.max(sayim) — bir sayım vektöründe en büyük değeri değil, o değerin konumunu — kaçıncı sırada olduğunu — döndürür. İki düzey eşit sayıda geçerse uyarı vermeden ilk konumu döndürür; table() düzeyleri alfabetik dizdiği için bu, veride önce geçen düzey değil, adı alfabede önce gelen düzeydir. Mod aslında iki tane olduğunda bu kod bunu söylemez.names(sayim)[...] — konumu düzey adına çevirmek bu yüzden ayrı bir adımdır: names(sayim) düzey adlarını verir, köşeli parantez de bulunan konumu o adlar içinden seçer.Temel R kontrolü. Aynı işi hazır araçlarla:
mod_hazir <- names(sort(table(ornek), decreasing = TRUE))[1]
mod_hazir
#> [1] "M"Karşılaştırma. İki yol aynı sonucu vermeli; ayrıca mode() tuzağını da gösterelim. Doğrulama kalıbını — isTRUE(all.equal(...)) ve stopifnot() — Hafta 1’de kurmuştuk; burada bir tek fark var: karşılaştırılan iki değer metin olduğu için all.equal()’in tolerans payı hiç devreye girmiyor. Kalıbın yine de == yerine bu işlevle yazılmasının nedeni, aynı kalıbın haftalar boyunca sayısal karşılaştırmalarda da kullanılıyor olmasıdır.
mod_kontrol <- isTRUE(all.equal(en_sik(ornek), mod_hazir))
stopifnot(mod_kontrol)
list(elle = "M", acik_kod = en_sik(ornek), hazir = mod_hazir,
     uyumlu = mod_kontrol, mode_ne_dondurur = mode(ornek))
#> $elle
#> [1] "M"
#>
#> $acik_kod
#> [1] "M"
#>
#> $hazir
#> [1] "M"
#>
#> $uyumlu
#> [1] TRUE
#>
#> $mode_ne_dondurur
#> [1] "character"Üç yol da M demeli ve uyumlu TRUE olmalıdır. Son alan uyarıdır: mode(ornek) "character" döndürür — istatistiksel mod değil, depolama kipi. Kodunuz hata vermez, sessizce yanlış çalışır.
en_sik() içindeki x <- x[!is.na(x)] satırı teknik bir ayrıntı değil, bir karardır: eksik değerler modun hesabına katılmaz. table() eksikleri zaten saymadığı için bu satır sonucu değiştirmez; kararı koda açıkça yazar. table(x, useNA = "ifany") yazılsaydı eksikler de bir düzey gibi sayılır ve eksiklik yeterince çoksa “en sık düzey” NA çıkardı. Kararı kod içinde açıkça vermek, onu görünür kılar.
Şimdi asıl soruya geliyoruz. Tutar eksikliği MNAR’dı; bakalım yöntemler ne yapıyor. Burada bir ayrıcalığımız var: kaybı biz ürettiğimiz için gerçek değerleri biliyoruz.
auto_claims_truth.csv dosyası gerçek hayatta yoktur. Kaybın büyüklüğünü ölçebiliyor olmamızın nedeni yöntemin iyiliği değil, eksikliği bizim üretmiş olmamızdır. Aşağıdaki karşılaştırmayı gerçek bir projede yapamazsınız — bu bölümün varlık nedeni de tam olarak budur. Bu bölümün kodunu kendi bilgisayarınızda çalıştıracaksanız bu dosyayı da indirmeniz gerekir.
Ne olduğu. auto_claims.csv’nin kaynağından (insuranceData 1.0, CRAN, GPL-2; kopyanın alındığı tarih 1 Eylül 2026) alınan kusursuz tutar sütunu. Bir satır bir hasar kimliğidir; 6.773 satır, yani kimlik başına tek satır. İki sütunu vardır: claim_no (hasar kimliği, metin, auto_claims.csv ile eşleşen anahtar) ve claim_amount_true (öğretim için eksik değer eklenmeden önceki tutar, TL, eksiksiz).
Neyi yanıtlayamaz. Bir veri kaynağı değildir, bir öğretim aracıdır: tek işlevi, ürettiğimiz kaybın büyüklüğünü ölçmemizi sağlamaktır. Gerçek bir projede karşılığı yoktur.
dogruluk_yolu <- file.path("data", "derived", "auto_claims_truth.csv")
file.exists(dogruluk_yolu)
#> [1] TRUETRUE görmelisiniz. FALSE ise dosya beklenen yerde değildir: yukarıdaki bağlantıdan indirip data/derived/ klasörüne koyun. Şimdi dosyayı okuyalım:
dogruluk <- read_csv(dogruluk_yolu, show_col_types = FALSE)
dogruluk
#> # A tibble: 6,773 × 2
#> claim_no claim_amount_true
#> <chr> <dbl>
#> 1 H00001 1134.
#> 2 H00002 3761.
#> 3 H00003 7842.
#> 4 H00004 2385.
#> 5 H00005 650
#> 6 H00006 391.
#> 7 H00007 3776.
#> 8 H00008 415.
#> 9 H00009 2284.
#> 10 H00010 665.
#> # ℹ 6,763 more rowsdogruluk dosyasında hasar kimliği claim_no ile öğretim için eksik değer eklenmeden önceki tutar claim_amount_true yan yana durur. Bu dosyada tutar sütunu eksiksizdir; kayıp burada değil, üzerinde çalıştığımız dosyadadır.
Şimdi iki dosyayı hasar kimliği üzerinden birleştirelim, ki her satırda gözlenen tutar ile gerçek tutar yan yana gelsin:
ham_gercek <- ham |> left_join(dogruluk, by = "claim_no")
ham_gercek
#> # A tibble: 6,776 × 7
#> claim_no state class gender age claim_amount claim_amount_true
#> <chr> <chr> <chr> <chr> <dbl> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134. 1134.
#> 2 H00002 STATE 15 C6 M NA 3761. 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842. 7842.
#> 4 H00004 STATE 15 F6 F NA 2385. 2385.
#> 5 H00005 STATE 15 F6 M 95 650 650
#> 6 H00006 STATE 15 F6 M NA 391. 391.
#> 7 H00007 STATE 15 C11 M 94 3776. 3776.
#> 8 H00008 STATE 10 C6 M 94 415. 415.
#> 9 H00009 STATE 14 C11 M NA 2284. 2284.
#> 10 H00010 STATE 03 C11 M 93 665. 665.
#> # ℹ 6,766 more rowsÇıktıda ham’ın sütunlarına claim_amount_true’nun eklendiğini görürüz. claim_amount hâlâ eksiklerini taşır: birleştirme kaybı onarmaz, yalnızca kaybedilen değeri kaybın yanına koyar.
Karşılaştırmayı bir özet tablosuna indirgeyelim. Gerçek ortalama ile eksiklerin gerçek ortalaması aynı claim_amount_true sütunundan gelir; aralarındaki tek fark, hangi satırların hesaba katıldığıdır.
ham_gercek |>
  summarise(
    gercek_ortalama = mean(claim_amount_true),
    tam_vaka_ortalama = mean(claim_amount, na.rm = TRUE),
    eksiklerin_gercek_ortalamasi = mean(claim_amount_true[is.na(claim_amount)])
  )
#> # A tibble: 1 × 3
#> gercek_ortalama tam_vaka_ortalama eksiklerin_gercek_ortalamasi
#> <dbl> <dbl> <dbl>
#> 1 1853. 1734. 7727.Sayılar açık: gerçek ortalama 1.853,03 TL, tam vaka ortalaması 1.733,67 TL — yani %6,4 aşağı yanlı. Nedeni de görünüyor: kaybolan kayıtların gerçek ortalaması 7.726,93 TL, yani gözlenenlerin 4,5 katı. Eksilen şey rastgele bir örneklem değil, tam da büyük hasarlar.
Şimdi yöntemleri deneyelim. İki yöntem aynı sayıya dayandığı için önce onu ayrı bir nesneye alalım:
tam_vaka <- mean(ham_gercek$claim_amount, na.rm = TRUE)

tam_vaka
#> [1] 1733.665tam_vaka, eksik tutarlar dışarıda bırakılarak hesaplanan gözlenen ortalamadır; bir önceki çıktının tam vaka sütunuyla aynı değeri vermelidir. Ayrı tutuyoruz, çünkü hem silme hem de ortalama ataması aynı sayıya dayanır. Çıktıda her yöntemin gercek öğesinin yanında nereye düştüğüne bakacağız.
karsilastirma_tutar <- c(
  gercek = mean(ham_gercek$claim_amount_true),
  silme = tam_vaka,
  ortalama_atamasi = mean(ifelse(is.na(ham_gercek$claim_amount),
                                 tam_vaka, ham_gercek$claim_amount)),
  medyan_atamasi = mean(ifelse(is.na(ham_gercek$claim_amount),
                               median(ham_gercek$claim_amount, na.rm = TRUE),
                               ham_gercek$claim_amount))
)
round(karsilastirma_tutar, 2)
#> gercek silme ortalama_atamasi medyan_atamasi
#> 1853.03 1733.67 1733.67 1718.94Gerçek ortalama 1.853,03 TL iken silme ve ortalama ataması 1.733,67 TL, medyan ataması 1.718,94 TL veriyor: üçü de aynı yönde yanılıyor, medyan ataması daha da kötü. Hiçbiri gerçeğe yaklaşmıyor, çünkü hepsi “eksikler gözlenenlere benzer” varsayımına dayanıyor ve burada bu varsayım yanlış.
Yaşta yanlılığı kaldıran yöntem, grup içi ortalama, bu varsayımı bir adım gevşetir: eksiklerin gözlenenlere aynı grubun içinde benzediğini varsayar. Tutarda bu da işe yarar mı? Mekanizma bölümünde tutarın eksikliği sınıfla ilişkili çıkmamıştı (p = 0,792); yalnızca eyaletle zayıf bir ilişki vardı (p = 0,0155) ve “MAR, eyalete göre düzeltelim” diyenin yanılacağını söylemiştik. İki gruplamayı da deneyelim: tutar_dolu eksik tutarları bir kez sınıfın, bir kez eyaletin gözlenen ortalamasıyla doldurur.
tutar_dolu <- ham_gercek |>
  mutate(sinif = trimws(class), eyalet = trimws(state)) |>
  group_by(sinif) |>
  mutate(grup_ici_sinif = ifelse(is.na(claim_amount),
                                 mean(claim_amount, na.rm = TRUE),
                                 claim_amount)) |>
  group_by(eyalet) |>
  mutate(grup_ici_eyalet = ifelse(is.na(claim_amount),
                                  mean(claim_amount, na.rm = TRUE),
                                  claim_amount)) |>
  ungroup()

tutar_dolu |>
  filter(is.na(claim_amount)) |>
  select(sinif, eyalet, claim_amount_true,
         grup_ici_sinif, grup_ici_eyalet)
#> # A tibble: 133 × 5
#> sinif eyalet claim_amount_true grup_ici_sinif grup_ici_eyalet
#> <chr> <chr> <dbl> <dbl> <dbl>
#> 1 C6 STATE 04 4624. 1798. 1613.
#> 2 F6 STATE 15 7238. 1646. 1666.
#> 3 C11 STATE 15 6710. 1706. 1666.
#> 4 C6 STATE 12 4338. 1798. 2099.
#> 5 C6 STATE 02 4277. 1798. 1649.
#> 6 C11 STATE 07 9438. 1706. 1826.
#> 7 F6 STATE 17 6987. 1646. 1964.
#> 8 C6 STATE 15 6747. 1798. 1666.
#> 9 F6 STATE 02 9378. 1646. 1649.
#> 10 C1 STATE 06 7487. 1694. 1980.
#> # ℹ 123 more rowstutar_dolu 6.776 satır ve 11 sütundur. Ekrana yalnızca tutarı eksik 133 satırı basıyoruz, çünkü iki yöntem yalnızca orada ayrışır; her satırda gerçek tutar iki dolgunun yanında duruyor.
İlk on satırda gerçek tutarlar 4.277 ile 9.438 TL arasında; yazılan sınıf ortalamaları ise 1.646 ile 1.798 TL, eyalet ortalamaları 1.613 ile 2.099 TL arasında. On satırın hiçbirinde dolgu gerçek tutarın yarısına varmıyor.
Bloğun çağrılarının hepsi daha önce geçti; yeni olan gruplamanın mutate() ile birlikte yazılışı:
group_by(sinif), ardından mutate() — gruplu bir tabloda mutate() her hesabı grubun içinde yapar, ama summarise()’ın tersine satır sayısını düşürmez: grubun değeri o grubun bütün satırlarına yazılır. Burada mean(claim_amount, na.rm = TRUE) her satırda o satırın sınıfının gözlenen ortalamasıdır; ifelse() onu yalnızca eksik hücrelere yazar. Yaşın grup içi ortalamasını bir arama tablosu ve left_join() ile kurmuştuk; iki yol aynı sayıları verir. group_by(eyalet) — yeni bir group_by() öncekinin yerine geçer, bu yüzden ikinci mutate() eyalet gruplarında çalışır. Yazılmazsa: ikinci mutate() hâlâ sınıf gruplarında çalışır ve grup_ici_eyalet sütununa uyarı vermeden sınıf ortalamalarını yazar; iki sütun birebir aynı çıkar. filter(is.na(claim_amount)) — ekrana yalnızca tutarı eksik satırları getirir; tutar_dolu’nun kendisi 6.776 satır olarak kalır. Şimdi iki dolgunun ortalamasını gerçekle ve silmeyle yan yana koyalım:
karsilastirma_grup_ici <- c(
  gercek = mean(tutar_dolu$claim_amount_true),
  silme = tam_vaka,
  grup_ici_sinif = mean(tutar_dolu$grup_ici_sinif),
  grup_ici_eyalet = mean(tutar_dolu$grup_ici_eyalet)
)
round(karsilastirma_grup_ici, 2)
#> gercek silme grup_ici_sinif grup_ici_eyalet
#> 1853.03 1733.67 1733.93 1734.38Sınıfa göre doldurmak ortalamayı 1.733,67 TL’den 1.733,93 TL’ye, eyalete göre doldurmak 1.734,38 TL’ye taşıyor; gerçek ortalama 1.853,03 TL. Aradaki farkın sınıfa göre doldurmada %0,2’si, eyalete göre doldurmada %0,6’sı kapanıyor: fark neredeyse olduğu gibi duruyor.
Eyaletle görülen zayıf ilişki bir düzeltme getirmedi: mekanizma bölümünde dediğimiz gibi iz eyaletin değil, büyük hasarların iziydi. Nedeni tutar_dolu’nun satırlarında görünüyor. Tutarları yalnızca büyük hasarlardan sildik; bu yüzden her grubun eksikleri o grubun büyük hasarlarıdır, grubun ortalaması ise o grupta kalan tutarlardan hesaplanır. Yukarıdaki on satırda olduğu gibi 133 satırın hepsinde yazılan değer gerçek tutarın altında kalıyor. Yaşta aynı yöntem işe yaramıştı, çünkü sınıfın içinde eksik yaşlar gözlenen yaşlara benziyordu (MAR). Tutarda hiçbir gruplama bunu sağlamaz: eksiklik gruba değil, değerin kendisine bağlı.
mice ile belirsizliği taşımakBuraya kadar denediğimiz atama yöntemlerinin hepsi tek atama (single imputation) yapıyordu: her eksik hücreye bir sayı koyup sonra o sayıyı gerçekmiş gibi kullanıyorduk. Standart hatanın sahte biçimde küçülmesinin nedeni buydu — koyduğumuz değerin tahmin olduğunu unutmuş oluyoruz.
Çoklu atama (multiple imputation) bunu düzeltir. Eksik hücreler tek bir değerle değil, m farklı makul değerle doldurulur; m tam veri seti üzerinde aynı analiz koşulur; sonuçlar Rubin kurallarıyla (Rubin’s rules) havuzlanır. Havuzlanan belirsizlik iki parçadan gelir: her veri setinin kendi içindeki belirsizlik, ve setler arasındaki fark — yani “bilmiyor olmanın” bedeli.
atama_verisi <- ham |>
  mutate(
    state = factor(state),
    class = factor(trimws(class)),
    gender = factor(gender)
  )

atama_verisi
#> # A tibble: 6,776 × 6
#> claim_no state class gender age claim_amount
#> <chr> <fct> <fct> <fct> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842.
#> 4 H00004 STATE 15 F6 F NA 2385.
#> 5 H00005 STATE 15 F6 M 95 650
#> 6 H00006 STATE 15 F6 M NA 391.
#> 7 H00007 STATE 15 C11 M 94 3776.
#> 8 H00008 STATE 10 C6 M 94 415.
#> 9 H00009 STATE 14 C11 M NA 2284.
#> 10 H00010 STATE 03 C11 M 93 665.
#> # ℹ 6,766 more rowsmice metin olarak duran sütunları sabit sayıp dışarıda bırakır: onları ne yordayıcı olarak kullanır ne de eksiklerini doldurur — cinsiyetteki 297 eksik olduğu gibi kalırdı. Kategorik sütunları bu yüzden faktöre çeviriyoruz. class daha önce olduğu gibi trimws()’ten geçirilip öyle çevriliyor. Çıktıda başlık satırının altındaki tür işaretlerine bakalım: dönüştürdüğümüz sütunlar artık metin değil faktör görünür.
kalip <- mice::make.predictorMatrix(atama_verisi)
kalip[, "claim_no"] <- 0
kalip["claim_no", ] <- 0

kalip
#> claim_no state class gender age claim_amount
#> claim_no 0 0 0 0 0 0
#> state 0 0 1 1 1 1
#> class 0 1 0 1 1 1
#> gender 0 1 1 0 1 1
#> age 0 1 1 1 0 1
#> claim_amount 0 1 1 1 1 0make.predictorMatrix() varsayılan yordayıcı matrisini (predictor matrix) kurar: hangi sütunun hangisini yordayacağını gösteren 0/1 tablosu; kodda ona kalip diyoruz. Matrisi basmamızın nedeni, sonraki iki satırın etkisinin kodda sessiz kalmasıdır: ancak matris çıktısına bakınca claim_no satırının ve sütununun baştan sona sıfırlandığı görünür. Köşegen de sıfırdır: hiçbir sütun kendini yordamaz, bu make.predictorMatrix()’in varsayılanıdır.
Matris hazır; sıra atama modelini kurmakta. Atamayı yapan mice::mice()’tır: eksik hücreleri bir kez değil, birbirinden bağımsız olarak birden çok kez doldurur ve hepsini tek nesnede döndürür. atama işte o nesnedir; beş tamamlanmış veri setini birden taşır.
atama <- mice::mice(
  atama_verisi,
  m = 5, maxit = 5, method = "pmm",
  predictorMatrix = kalip,
  seed = 5109, printFlag = FALSE
)

atama$method
#> claim_no state class gender age claim_amount
#> "" "" "" "pmm" "pmm" "pmm"Verilen her argüman bir karardır:
m = 5 — kaç tam veri seti üretilecek. Beş, mice’ın varsayılanıdır ve ortalama gibi tek bir tahmin için çoğu zaman yeter; standart hataların da kararlı çıkması için sık kullanılan kural m’yi eksik satır yüzdesi kadar almaktır — burada yaklaşık 15 (van Buuren, 2018, §2.8; White, Royston ve Wood, 2011). m büyüdükçe havuzlanmış tahmin kararlı hâle gelir ama koşu süresi de artar. maxit = 5 — her set için kaç tur döngü. Sütunlar birbirini yordadığı için atama yinelemeli çalışır.method = "pmm" — tahmini ortalama eşleştirme (predictive mean matching): model her satır için bir tahmin üretir; eksik hücreye, tahmini ona en yakın beş gözlenmiş satırdan rastgele birinin gerçek değeri konur. Böylece atanan değerler veride var olan değerlerdir; 63,4172 gibi bir yaş uydurulmaz. seed = 5109 — atama rastgeledir; tohum verilmezse kod her çalıştırıldığında farklı sayılar üretir.printFlag = FALSE — yoksa source() altında sayfalarca yakınsama çıktısı basar.predictorMatrix — asıl karar burada. Aşağıda anlatıyoruz.mice varsayılan olarak sayısal ve faktör her sütunu diğerlerini yordamakta kullanır. Bu dosyada claim_no metin olduğu için mice onu zaten dışarıda bırakırdı; ama kimlik bir sayı ya da faktör olarak dursaydı modele girerdi ve hiçbir şey yordamayan 6.773 farklı değer atamayı anlamsızlaştırırdı. Laboratuvardaki casenum tam böyle, sayısal bir kimliktir.
kalip[, "claim_no"] <- 0 satırı onu yordayıcı olmaktan çıkarır, kalip["claim_no", ] <- 0 ise kendisinin atanmasını engeller. Kimlik eklemenin bedeli budur: kimlik analiz için değil kayıt eşleştirmek için vardır ve modele girmemesi gerektiğini siz söylemek zorundasınız.
atama$method çıktısı hangi sütuna hangi yöntemin uygulandığını gösterir: eksik değeri olmayan sütunlar boş ("") kalır, gender, age ve claim_amount için pmm çalışır.
Atamanın sonucu bir şeye daha bağlı: mice’ın sürümüne. Tohum aynı sayıları ancak aynı sürümde üretir. Bu bölümdeki sayılar şu sürümle hesaplandı:
packageVersion("mice")#> [1] '3.17.0'packageVersion() kurulu bir paketin sürümünü verir. mice 3.17.0’da faktör sütunlarının pmm ile atanma yolu değişti (sürüm notları): eski sürümler bir faktörün düzeylerini sıra numaralarına çevirip eşleştiriyordu, 3.17.0 ise her düzeye öbür sütunlarla ilişkisinden hesaplanan bir sayı veriyor. gender bir faktör olduğu için 3.16.0 aynı tohumla başka atamalar üretir, ve başka sürümler de farklı sayılar verebilir. Kodu kendi bilgisayarınızda çalıştırıp buradakilerden farklı sayılar görürseniz önce mice sürümünüze bakın.
Beş veri setinin her birinde aynı analizi koşup sonuçları havuzlarız. \(m\) setin \(i\)’incisi bir tahmin \(\widehat{Q}_i\) (burada ortalama yaş) ve o tahminin varyansını \(U_i\) (standart hatasının karesi) verir. Rubin kuralları bunları şöyle birleştirir:
\[ \begin{aligned} \bar{Q}&=\frac{1}{m}\sum_{i=1}^{m}\widehat{Q}_i &&\text{havuzlanmış tahmin}\\[3pt] \bar{U}&=\frac{1}{m}\sum_{i=1}^{m}U_i &&\text{set içi varyans}\\[3pt] B&=\frac{1}{m-1}\sum_{i=1}^{m}\bigl(\widehat{Q}_i-\bar{Q}\bigr)^2 &&\text{setler arası varyans}\\[3pt] T&=\bar{U}+\Bigl(1+\frac{1}{m}\Bigr)B &&\text{toplam varyans} \end{aligned} \]
Havuzlanmış standart hata \(\sqrt{T}\)’dir. \(\bar{U}\), veri eksiksiz olsaydı da kalacak örnekleme belirsizliğidir. \(B\) eksik değerleri bilmemenin bedelidir: setler eksik hücrelere farklı değerler yazdığı için tahminleri birbirinden ayrılır. \(B/m\) terimi ise yalnızca \(m\) set kullanmanın payıdır ve \(m\) büyüdükçe sıfıra iner.
havuz_yas <- mice::pool(with(atama, lm(age ~ 1)))
havuz_yas
#> Class: mipo m = 5
#> term m estimate ubar b t dfcom df
#> 1 (Intercept) 5 63.89339 0.01710729 0.001250034 0.01860734 6775 560.127
#> riv lambda fmi
#> 1 0.08768431 0.08061559 0.08388087Bu satırdaki çağrılar şunları yapar:
with(atama, ...) — her sette modeli kurar ve kurduğu modellerin hepsini tek bir nesnede toplar, çünkü pool() tek bir modeli değil model topluluğunu bekler. Temel R’nin işlevidir; atama’nın türüne bakıp mice’ın bu tür için yazdığı koda yönelir, bu yüzden mice::with diye ayrı bir işlev de yoktur.lm(age ~ 1) — ortalamayı bu modelle alıyoruz, çünkü sabit terimi ortalamaya eşittir ve pool() regresyon çıktılarıyla çalışır.havuz_yas havuzlama nesnesidir ve çıktısı bu parçaları adlarıyla gösterir: estimate sütunu \(\bar{Q}\)’yu, ubar \(\bar{U}\)’yu, b \(B\)’yi, t de \(T\)’yi taşır. Çıktının öbür sütunları serbestlik derecesini (dfcom, df) ve eksikliğin belirsizliğe kattığı payı (riv, lambda, fmi) ölçer; bu hafta onları okumuyoruz. Çıktıdaki değerlerle, \(m = 5\) için:
\[ T=0{,}017107+1{,}2\times0{,}001250=0{,}018607,\qquad\sqrt{T}\approx0{,}1364. \]
\(B\) olmasaydı standart hata \(\sqrt{\bar{U}}\approx0{,}1308\) olurdu; \(B\) onu 0,1364’e çıkarıyor. Tek atama \(B\)’yi hiç hesaplamaz: tek bir veri seti vardır ve doldurulan değerler gözlenmiş gibi kullanılır — altı poliçelik örneğin son çekincesinde söylediğimiz buydu. \(\sqrt{\bar{U}}\) da grup içi ortalamanın standart hatasından (0,1275) büyüktür, çünkü pmm eksik hücrelere sınıfın tek bir ortalamasını değil gözlenmiş yaşlar yazar ve her setin yayılımı korunur.
Rapor edeceğimiz tabloyu summary() çıkarır; aşağıdaki karşılaştırmada mice satırının hem ortalaması hem standart hatası bu özetten gelecek.
oz <- summary(havuz_yas)
oz
#> term estimate std.error statistic df p.value
#> 1 (Intercept) 63.89339 0.1364087 468.3967 560.127 0mice: ortalama ve standart hataŞimdi dört yöntemi tek tabloda görelim — ve standart hata sütununa bakın.
sonuc <- data.frame(
  yontem = c("silme", "ortalama atamasi", "grup ici ortalama", "mice (havuzlanmis)"),
  ortalama = c(
    mean(yas_dolu$silme, na.rm = TRUE),
    mean(yas_dolu$ortalama_atamasi),
    mean(yas_dolu$grup_ici_ortalama),
    oz$estimate[1]
  ),
  std_hata = c(
    sd(yas_dolu$silme, na.rm = TRUE) / sqrt(sum(!is.na(yas_dolu$silme))),
    sd(yas_dolu$ortalama_atamasi) / sqrt(nrow(yas_dolu)),
    sd(yas_dolu$grup_ici_ortalama) / sqrt(nrow(yas_dolu)),
    oz$std.error[1]
  )
)
sonuc$ortalama <- round(sonuc$ortalama, 4)
sonuc$std_hata <- round(sonuc$std_hata, 4)
sonuc
#> yontem ortalama std_hata
#> 1 silme 63.0515 0.1318
#> 2 ortalama atamasi 63.0515 0.1202
#> 3 grup ici ortalama 63.8770 0.1275
#> 4 mice (havuzlanmis) 63.8934 0.1364Tabloyu kuran çağrı şudur:
data.frame() — tibble()’ın temel R’deki karşılığıdır; sütunları aynı biçimde, ad = değerler olarak alır.Gerçek ortalama 63,82 olduğuna göre tablo şunu söylüyor:
| Yöntem | Ortalama | Std hata | Hüküm |
|---|---|---|---|
| silme | 63,05 | 0,1318 | yanlı |
| ortalama ataması | 63,05 | 0,1202 | yanlı ve sahte kesin |
| grup içi ortalama | 63,88 | 0,1275 | yansız, ama belirsizlik hâlâ eksik |
mice havuzlanmış |
63,89 | 0,1364 | yansız ve dürüst |
mice’ın standart hatası tek atama yapan satırlarınkinden büyük — ve doğru olan da bu. 599 yaşı bilmiyoruz; bilmiyor olmak bir maliyettir ve o maliyet ancak havuzlamada görünür. Tam vaka satırınınkinden de büyük çıkması ise bu veriye özgüdür, bir kural değildir: eksik yaşı iyi yordayan başka sütunlar olsaydı çoklu atama tam vakadan daha küçük bir standart hata da verebilirdi. Ortalama ataması aynı bilgisizlikle en küçük standart hatayı üretiyordu: en yanıltıcı satır, en kesin görünen satırdır.
Tablo yöntemlerin ortalamasını ve standart hatasını veriyor, ama eksik hücrelere ne yazdıklarını göstermiyor. mice’ın beş setindeki yaşları da yas_dolu’nun yanına beş sütun olarak koyalım: yas_dolu_mice, yas_dolu’nun 12 sütununu ve mice_1…mice_5’i taşır.
yas_dolu_mice <- yas_dolu |>
  mutate(
    mice_1 = mice::complete(atama, 1)$age,
    mice_2 = mice::complete(atama, 2)$age,
    mice_3 = mice::complete(atama, 3)$age,
    mice_4 = mice::complete(atama, 4)$age,
    mice_5 = mice::complete(atama, 5)$age
  )

yas_dolu_mice |>
  select(sinif, silme, grup_ici_ortalama, mice_1:mice_5)
#> # A tibble: 6,776 × 8
#> sinif silme grup_ici_ortalama mice_1 mice_2 mice_3 mice_4 mice_5
#> <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 C6 97 97 97 97 97 97 97
#> 2 C6 NA 77.9 86 77 77 84 76
#> 3 C11 95 95 95 95 95 95 95
#> 4 F6 NA 78.9 75 78 74 74 86
#> 5 F6 95 95 95 95 95 95 95
#> 6 F6 NA 78.9 78 78 74 72 72
#> 7 C11 94 94 94 94 94 94 94
#> 8 C6 94 94 94 94 94 94 94
#> 9 C11 NA 68.7 51 55 53 81 71
#> 10 C11 93 93 93 93 93 93 93
#> # ℹ 6,766 more rowsEkrana yas_dolu’nun görünümündeki ilk on satır geliyor; ortalama ve medyan ataması sütunları sığmadığı için dışarıda. Yaşı gözlenen altı satırda beş mice sütunu da gözlenen yaşı taşır: mice yalnızca eksik hücreleri doldurur. Yaşı eksik dört satırda (2, 4, 6 ve 9) yöntemlerin farkı görünür:
grup_ici_ortalama aynı sınıftaki her eksik hücreye aynı sayıyı yazar: dördüncü ve altıncı satırın ikisi de F6’dır, ikisine de 78,9 düşer. mice aynı hücreye her sette başka bir değer yazar: ikinci satıra (C6) 86, 77, 77, 84 ve 76. pmm eksik hücreye benzer bir satırın gerçek yaşını koyar. Bloğun iki yeni parçası:
mice::complete(atama, i) — atama’nın taşıdığı beş tamamlanmış tablodan i’incisini verir: eksik hücreler o setin değerleriyle dolmuş, satırlar ham’daki sırada. $age o tablonun yaş sütununu alır; sıra aynı olduğu için sütun yas_dolu’nun yanına satır satır eklenebilir. mice_1:mice_5 — select() içinde iki sütun adı arasındaki iki nokta, aradaki bütün sütunları sırasıyla seçer; beş adı tek tek yazmakla aynıdır.Dört satır bir örnek. Yaşı eksik 599 hücrenin hepsinde her yöntemin kaç farklı değer yazdığını sayalım:
yas_farkli_deger <- yas_dolu_mice |>
  filter(is.na(age)) |>
  summarise(across(c(ortalama_atamasi, medyan_atamasi, grup_ici_ortalama, mice_1:mice_5),
                   n_distinct)) |>
  pivot_longer(everything(), names_to = "yontem", values_to = "farkli_deger")

yas_farkli_deger
#> # A tibble: 8 × 2
#> yontem farkli_deger
#> <chr> <int>
#> 1 ortalama_atamasi 1
#> 2 medyan_atamasi 1
#> 3 grup_ici_ortalama 18
#> 4 mice_1 44
#> 5 mice_2 46
#> 6 mice_3 42
#> 7 mice_4 45
#> 8 mice_5 44Ortalama ve medyan ataması 599 hücrenin hepsine tek bir değer yazar, grup içi ortalama 18 değer: her sınıfa bir tane. mice’ın her seti 42 ile 46 arasında farklı yaş yazar.
filter(is.na(age)) — yalnızca yaşı eksik satırları tutar; yöntemler yalnızca orada ayrışır.across(..., n_distinct) — seçilen her sütuna n_distinct() uygular; n_distinct() bir vektörde kaç farklı değer geçtiğini sayar.pivot_longer(everything(), ...) — tek satırlık geniş sonucu her yöntemin bir satır olduğu uzun tabloya çevirir; sekiz sütun ekrana sığmazdı.Son olarak tek tek hücrelere bakalım: beş set aynı hücreye kaç farklı değer yazdı?
yas_dolu_mice |>
  filter(is.na(age)) |>
  select(mice_1:mice_5) |>
  apply(1, n_distinct) |>
  table()
#>
#> 2 3 4 5
#> 4 48 221 326Üst satır farklı değer sayısını, alt satır o kadar farklı değer alan hücre sayısını verir. Beş setin aynı değeri yazdığı hücre yok; 326 hücrede beşi de farklı. Setlerin eksik hücrelere farklı değerler yazması havuzlamadaki \(B\)’nin kaynağıdır: setlerin ortalamaları bu yüzden birbirinden ayrılır ve havuzlanmış standart hata tek atamanınkinden büyük çıkar.
apply(1, n_distinct) — tablonun her satırına n_distinct() uygular (1 satır, 2 sütun demektir); her eksik hücre için beş setin kaç farklı değer yazdığını verir.table() — bu sayıları sayar.Beş sütun, beş ayrı makul veri setidir. Peki raporda hangisi kullanılır? İki kestirme akla gelir: bir seti seçmek, ya da her hücreye beş değerin ortalamasını yazıp tek bir tablo kurmak. İkisi de yanlıştır; doğru yol, Havuzlama: Rubin kuralları bölümünde ortalama yaş için yaptığımız gibi, analizi beş setin her birinde ayrı koşup sonuçları havuzlamaktır. Önce bir eksik hücreye neden tek bir değer yazılmadığını görelim. Yaşı eksik ilk on satırda beş setin yazdığı yaşları, en büyükle en küçüğün farkını ve beş değerin ortalamasını yan yana koyalım:
ilk_on_eksik <- yas_dolu_mice |>
  filter(is.na(age)) |>
  select(sinif, mice_1:mice_5) |>
  head(10) |>
  mutate(
    aralik = pmax(mice_1, mice_2, mice_3, mice_4, mice_5) - pmin(mice_1, mice_2, mice_3, mice_4, mice_5),
    hucre_ortalamasi = (mice_1 + mice_2 + mice_3 + mice_4 + mice_5) / 5
  )

ilk_on_eksik
#> # A tibble: 10 × 8
#> sinif mice_1 mice_2 mice_3 mice_4 mice_5 aralik hucre_ortalamasi
#> <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 C6 86 77 77 84 76 10 80
#> 2 F6 75 78 74 74 86 12 77.4
#> 3 F6 78 78 74 72 72 6 74.8
#> 4 C11 51 55 53 81 71 30 62.2
#> 5 F6 71 84 77 75 85 14 78.4
#> 6 C6 75 80 75 82 78 7 78
#> 7 C6 82 92 83 81 83 11 84.2
#> 8 C6 75 73 83 77 74 10 76.4
#> 9 C6 79 71 75 79 78 8 76.4
#> 10 C11 55 62 57 57 64 9 59Her eksik hücreye beş set beş ayrı yaş yazdı. Dördüncü satırda (sınıf C11) değerler 51 ile 81 arasında, aralık 30 yıl: bu kişinin yaşı 51 de olabilir 81 de, veri ikisini ayırt edemiyor.
mice’ın bir eksik hücre için ürettiği şey tek bir tahmin değil, olası yaşların bir dağılımıdır; beş set o dağılımdan beş çekiliştir. Değerlerin farklı çıkması bir kusur değil, “bu yaşı bilmiyoruz” bilgisinin kendisidir.
Son sütun beş değerin ortalaması, yani hücre ortalaması: dördüncü satırda \((51+55+53+81+71)/5=62{,}2\). Hücreye bu sayıyı yazmak 30 yıllık belirsizliği sıfırlar; tablo artık bu yaşı biliyormuş gibi davranır.
İlk on ortalamanın yedisi de küsuratlı; 77,4 yaşında bir sigortalı dosyada yoktur, çünkü dosyadaki yaşlar tam sayıdır. pmm her hücreye dosyada gözlenmiş bir yaş yazıyordu; ortalama bu özelliği de bozar.
pmax(...) ve pmin(...) — verilen sütunları satır satır karşılaştırır ve her satırın en büyüğünü ya da en küçüğünü döndürür. max() ise bütün sütunların tek bir en büyüğünü verirdi.Bu yüzden “havuzlanmış yaş” diye bir sütun yoktur. Havuzlama hücreleri değil sonuçları birleştirir: önce her sette ortalama yaş ve standart hatası hesaplanır, sonra bu beş sonuç birleştirilir. Beş seti tek tek özetleyelim: ortalama yaş, standart hatası ve 90 yaş ve üstündekilerin yüzde payı.
yas_ozeti <- function(x) {
  c(ortalama = mean(x), std_hata = sd(x) / sqrt(length(x)), pay_90_ustu = 100 * mean(x >= 90))
}

set_ozetleri <- rbind(
  set_1 = yas_ozeti(yas_dolu_mice$mice_1),
  set_2 = yas_ozeti(yas_dolu_mice$mice_2),
  set_3 = yas_ozeti(yas_dolu_mice$mice_3),
  set_4 = yas_ozeti(yas_dolu_mice$mice_4),
  set_5 = yas_ozeti(yas_dolu_mice$mice_5)
)
round(set_ozetleri, 4)
#> ortalama std_hata pay_90_ustu
#> set_1 63.9165 0.1303 0.6641
#> set_2 63.9184 0.1319 1.0478
#> set_3 63.8619 0.1306 0.8264
#> set_4 63.8483 0.1297 0.7527
#> set_5 63.9219 0.1315 0.9445Setlerin ortalamaları 63,8483 ile 63,9219 arasında: bir set seçilirse sonuç hangi setin seçildiğine bağlı olur.
Standart hataları 0,1297 ile 0,1319 arasında ve hepsi havuzlanmış 0,1364’ün altında. Her biri yalnızca kendi setinin içindeki belirsizliği taşır; setler arasındaki farkı, yani \(B\)’yi bilmez.
90 yaş ve üstünün payı da setten sete %0,66 ile %1,05 arasında değişiyor.
mean(x >= 90) — x >= 90 her yaş için TRUE ya da FALSE verir; mean() bunları 1 ve 0 sayar, sonuç TRUE’ların payıdır. 100 ile çarpınca yüzde olur.Havuzlanmış değer bu beş satırdan elde edilir. Rubin kurallarının üç parçasını elle hesaplayalım: \(\bar{Q}\) beş ortalamanın ortalaması, \(\bar{U}\) beş standart hatanın karelerinin ortalaması, \(B\) beş ortalamanın varyansı.
havuz_elle <- c(
  Q_ort = mean(set_ozetleri[, "ortalama"]),
  U_ort = mean(set_ozetleri[, "std_hata"]^2),
  B     = var(set_ozetleri[, "ortalama"])
)
round(havuz_elle, 6)
#> Q_ort U_ort B
#> 63.893388 0.017107 0.001250\(\bar{Q}=63{,}8934\), \(\bar{U}=0{,}017107\), \(B=0{,}001250\): Rubin bölümündeki havuz_yas çıktısının sayıları.
var(x) — örneklem varyansını \(n-1\)’e bölerek hesaplar; \(B\)’nin formülündeki \(1/(m-1)\) budur.Standart hata \(T=\bar{U}+(1+1/5)\,B\)’nin kareköküdür:
havuz_elle_std_hata <- sqrt(havuz_elle[["U_ort"]] + (1 + 1/5) * havuz_elle[["B"]])
havuz_elle_std_hata
#> [1] 0.1364087Sonuç 0,1364. Elle bulduğumuz iki sayıyı pool()’un verdiğiyle karşılaştıralım:
havuz_kontrol <- isTRUE(all.equal(
  c(ortalama = havuz_elle[["Q_ort"]], std_hata = havuz_elle_std_hata),
  c(ortalama = havuz_yas$pooled$estimate, std_hata = sqrt(havuz_yas$pooled$t))
))
stopifnot(havuz_kontrol)
havuz_kontrol
#> [1] TRUETRUE: pool()’un yaptığı tam olarak bu üç ortalama ve bir kareköktür. FALSE çıksaydı ya bir formülü yanlış yazmış ya da pool()’a başka bir analizin sonuçlarını vermiş olurduk. Havuzlanmış ortalama yaş 63,89, standart hatası 0,1364: rapora giden tek değer budur, ve hücre düzeyinde değil sonuç düzeyinde elde edilir.
Şimdi havuzlamayı hücre ortalamasıyla karşılaştıralım. Havuzlama satırının ortalaması ve standart hatası havuz_yas’tan gelir; payı beş setin paylarının ortalamasıdır, çünkü havuzlanmış tahmin her zaman beş tahminin ortalamasıdır. Hücre ortalaması satırı ise her eksik hücreye beş değerin ortalamasını yazan tek bir tablonun özetidir.
tek_sonuc <- rbind(
  havuzlama = c(ortalama = havuz_yas$pooled$estimate,
                std_hata = sqrt(havuz_yas$pooled$t),
                pay_90_ustu = mean(set_ozetleri[, "pay_90_ustu"])),
  hucre_ortalamasi = yas_ozeti(rowMeans(yas_dolu_mice[paste0("mice_", 1:5)]))
)
round(tek_sonuc, 4)
#> ortalama std_hata pay_90_ustu
#> havuzlama 63.8934 0.1364 0.8471
#> hucre_ortalamasi 63.8934 0.1286 0.5608İki satırın ortalaması aynı, 63,8934. Ortalama doğrusal bir ölçüdür: hücrelerin ortalamasının ortalaması, setlerin ortalamalarının ortalamasıdır.
Ama hücre ortalamasının standart hatası 0,1286: havuzlanmışınkinden de, her setinkinden de küçük. Beş değeri tek bir sayıya indirmek yöntemi yeniden tek atamaya çevirir; setler arasındaki fark kaybolur ve tablo olduğundan kesin görünür.
90 yaş ve üstünün payı ise %0,85’ten %0,56’ya, yaklaşık üçte bir düşüyor. Ortalama, setlerin uçta yazdığı yaşları ortaya doğru çeker; dördüncü satırın 81’i 62,2 olur. Ortalama dışındaki bir sonuç, bu pay gibi, hücre ortalamasından yanlı çıkar.
rowMeans(...) — her satırın ortalamasını alır; ilk on satırda elle topladığımız hücre ortalamasını bütün satırlar için hesaplar. Yaşı gözlenen satırlarda beş değer aynı olduğu için ortalama o yaşın kendisidir.Kural şu: rapora girecek her sonuç beş sette ayrı ayrı hesaplanır ve havuzlanır. Havuzlanmış tahmin beş tahminin ortalamasıdır; ortalamanın standart hatası \(\sqrt{T}\)’dir ve \(T\) set içi ile setler arası belirsizliği birlikte taşır. Regresyon modellerinde bunu with() ile pool() yapar; yukarıdaki pay gibi başka bir sonucun tahmini de beş setteki değerlerin ortalamasıdır. Tek bir set, dağılımın biçimini göstermek gibi bir amaçla kullanılabilir; o zaman hangi setin kullanıldığı söylenir ve sayılar o setin sayıları diye okunur.
Mekanizma bölümünde yaşın eksikliği iki gözlenen sütunla ilişkili çıktı: sınıf (Cramér V = 0,390) ve eyalet (V = 0,080). kalip ise yaşı öbür bütün sütunlarla, cinsiyet ve tutar dahil, yordatıyor. Atama modeline yalnızca bu iki sütunu koysaydık sonuç değişir miydi? kalip’in yaş satırını değiştirelim:
kalip_iki <- kalip
kalip_iki["age", ] <- 0
kalip_iki["age", c("class", "state")] <- 1

kalip_iki
#> claim_no state class gender age claim_amount
#> claim_no 0 0 0 0 0 0
#> state 0 0 1 1 1 1
#> class 0 1 0 1 1 1
#> gender 0 1 1 0 1 1
#> age 0 1 1 0 0 0
#> claim_amount 0 1 1 1 1 0Yalnızca age satırı değişti: yaşı artık yalnızca state ve class yordar. Öbür satırlar kalip’tekiyle aynı; cinsiyet ve tutar atanırken yaş hâlâ yordayıcıdır.
Atamayı öncekiyle aynı ayarlarla ve aynı tohumla yapalım, ki iki atama arasında değişen tek şey yordayıcı matris olsun:
atama_iki <- mice::mice(
  atama_verisi,
  m = 5, maxit = 5, method = "pmm",
  predictorMatrix = kalip_iki,
  seed = 5109, printFlag = FALSE
)

atama_iki$predictorMatrix["age", ]
#> claim_no state class gender age claim_amount
#> 0 1 1 0 0 0Çıktı, mice’ın yaş için bu matrisi kullandığını gösterir. Tohumu bilerek yeniden kullanıyoruz: bu ayrı bir çekiliş değil, aynı rastgele sayılarla iki modelin karşılaştırmasıdır.
İki atamayı havuzlayıp yan yana koyalım. yas_havuzla() her atama için havuzlama bölümündeki üç sayıyı verir: havuzlanmış ortalama, standart hata ve setler arası varyans \(B\).
yas_havuzla <- function(imp) {
  h <- mice::pool(with(imp, lm(age ~ 1)))$pooled
  c(ortalama = h$estimate, std_hata = sqrt(h$t), b = h$b)
}

iki_sutun_karsilastirma <- rbind(
  butun_sutunlar = yas_havuzla(atama),
  sinif_eyalet = yas_havuzla(atama_iki)
)
round(iki_sutun_karsilastirma, 4)
#> ortalama std_hata b
#> butun_sutunlar 63.8934 0.1364 0.0013
#> sinif_eyalet 63.8778 0.1559 0.0061Ortalama değişmedi: 63,89 ve 63,88. Eksikliği yaratan sınıf iki modelde de var, yanlılığı kaldıran da oydu; MAR’ın istediği, eksikliği açıklayan sütuna koşullanmaktır.
Standart hata ise 0,1364’ten 0,1559’a, yaklaşık %14 büyüyor; onu büyüten setler arası fark \(B\) beş katına çıkıyor.
mice::pool(...)$pooled — havuzlama nesnesinin içindeki tablo; estimate, t ve b sütunları Havuzlama bölümündeki \(\bar{Q}\), \(T\) ve \(B\)’dir. yas_havuzla() bunları bir atama için tek satırda toplar. Dışarıda kalan cinsiyet ve tutar yaş hakkında bilgi mi taşıyordu? Her modelin gözlenen yaşları ne kadar açıkladığına bakalım:
yas_r2 <- c(
  sinif = summary(lm(age ~ class, data = atama_verisi))$r.squared,
  sinif_eyalet = summary(lm(age ~ class + state, data = atama_verisi))$r.squared,
  butun_sutunlar = summary(lm(age ~ class + state + gender + claim_amount,
                              data = atama_verisi))$r.squared
)
round(yas_r2, 4)
#> sinif sinif_eyalet butun_sutunlar
#> 0.4322 0.4432 0.4439yas_r2 her model için belirlilik katsayısını (coefficient of determination), R²’yi verir: modelin gözlenen yaşların varyansının ne kadarını açıkladığı, 0 ile 1 arasında. Sınıf tek başına %43,2’sini açıklıyor; eyalet bunu %44,3’e, cinsiyet ve tutar %44,4’e çıkarıyor. Cinsiyet ve tutar yaşı neredeyse hiç açıklamıyor: standart hatadaki büyüme kaybedilen bir bilginin bedeli değil.
summary(lm(...))$r.squared — modelin özetinden R²’yi alır.Büyümenin kaynağı pmm’in eşleştirme biçimidir. Yordayıcıların hepsi kategorik olunca aynı sınıf ve eyaletteki bütün satırlar birebir aynı tahmini alır; tahminler basamaklı olur ve her set bağışçıları bu basamaklardan seçer. Sürekli bir sütun basamakları yumuşatır: yaşla hiçbir ilgisi olmayan rastgele bir sayı sütunu sınıf ve eyaletin yanına eklendiğinde bile standart hata 0,1350’ye iner.
Ders iki parçalı. Ki-kare testleri eksikliğin neye bağlı olduğunu gösterir: o sütunlar atama modelinde olmalıdır, dışarıda kalırlarsa yanlılık kalır. Ama atamanın standart hatası yalnızca onlara bağlı değildir. Laboratuvarın Görev D’si aynı soruya başka bir yanıt veriyor: orada dışarıda kalan sütunlar yaşın değerini açıklıyor ve ortalama da kayıyor.
mice cinsiyete ne yazdı?Aynı atama cinsiyetin 297 eksiğini de doldurdu: atama$method’da gender için pmm çalışıyordu. Cinsiyet bölümünde bu eksikleri modla doldurmayı denemiştik. İki yöntemin eksik hücrelere yazdıklarını yan yana koyalım; cinsiyet_mice her satırda gözlenen cinsiyeti, mod atamasını ve mice’ın beş setini taşır.
cinsiyet_mice <- ham |>
  transmute(
    gender,
    mod_atamasi = ifelse(is.na(gender), mod_cinsiyet, gender),
    mice_1 = mice::complete(atama, 1)$gender,
    mice_2 = mice::complete(atama, 2)$gender,
    mice_3 = mice::complete(atama, 3)$gender,
    mice_4 = mice::complete(atama, 4)$gender,
    mice_5 = mice::complete(atama, 5)$gender
  )

cinsiyet_mice |>
  filter(is.na(gender))
#> # A tibble: 297 × 7
#> gender mod_atamasi mice_1 mice_2 mice_3 mice_4 mice_5
#> <chr> <chr> <fct> <fct> <fct> <fct> <fct>
#> 1 <NA> M M M M M M
#> 2 <NA> M M M F F M
#> 3 <NA> M F F M M M
#> 4 <NA> M F M F F M
#> 5 <NA> M F F F M M
#> 6 <NA> M M M F M M
#> 7 <NA> M F M M F M
#> 8 <NA> M M M M M F
#> 9 <NA> M M M M M F
#> 10 <NA> M M M F F M
#> # ℹ 287 more rowsEkrana cinsiyeti eksik 297 satırın ilk onu geliyor. Mod ataması her satıra M yazar; mice aynı satıra bir sette M, öbüründe F yazabilir. Cinsiyeti gözlenen satırlarda mice sütunları gözlenen değeri taşır. mice sütunları <fct>, mod sütunu <chr> görünür, çünkü atamadan önce gender’ı faktöre çevirmiştik; bir sonraki blokta ikisi == ile aynı biçimde karşılaştırılır.
Eksik hücrelere yazılan F’leri sayalım:
cinsiyet_mice |>
  filter(is.na(gender)) |>
  summarise(across(c(mod_atamasi, mice_1:mice_5), ~ sum(.x == "F")))
#> # A tibble: 1 × 6
#> mod_atamasi mice_1 mice_2 mice_3 mice_4 mice_5
#> <int> <int> <int> <int> <int> <int>
#> 1 0 121 123 107 108 101Mod ataması 297 hücrenin hiçbirine F yazmaz. mice’ın setleri 101 ile 123 arasında F yazar; MCAR altında beklenen yaklaşık 113’tü, gerçekte 297 kaydın 108’i kadındı.
Bu yüzden her tamamlanmış setin F payı gerçeğe yakın kalır: %38,00 ile %38,33 arasında, gerçek %38,11; mod ataması payı %36,51’e çekiyordu.
mice hangi hücrenin kadın olduğunu bilmez — aynı hücreye setten sete farklı değer yazması bunu gösterir —, ama gözlenen kayıtlardan kaç tanesinin kadın olabileceğini taşır. Cinsiyetin kararı silmekti ve MCAR’da o da yansızdır; mice başka bir yoldan aynı paya varır, mod ataması varamaz.
mice MNAR’ı düzeltmezAynı havuzlamayı hasar tutarı için yapalım ve doğruluk dosyasıyla karşılaştıralım:
havuz_tutar <- mice::pool(with(atama, lm(claim_amount ~ 1)))

c(
  gercek = mean(ham_gercek$claim_amount_true),
  tam_vaka = mean(ham_gercek$claim_amount, na.rm = TRUE),
  mice_havuzlanmis = summary(havuz_tutar)$estimate[1]
) |> round(2)
#> gercek tam_vaka mice_havuzlanmis
#> 1853.03 1733.67 1733.21mice 1.733,21 veriyor; tam vaka 1.733,67, gerçek ise 1.853,03. Yanlılık %6,5 ve neredeyse hiç değişmedi.
Ortalama neden neredeyse hiç kıpırdamadı? mice’ın eksik tutarlara ne yazdığını tutar_dolu’nun yanına koyalım; orada her satırın gerçek tutarı ve sınıfa göre grup içi ortalama da duruyor.
tutar_dolu_mice <- tutar_dolu |>
  mutate(
    mice_1 = mice::complete(atama, 1)$claim_amount,
    mice_2 = mice::complete(atama, 2)$claim_amount,
    mice_3 = mice::complete(atama, 3)$claim_amount,
    mice_4 = mice::complete(atama, 4)$claim_amount,
    mice_5 = mice::complete(atama, 5)$claim_amount
  )

tutar_dolu_mice |>
  filter(is.na(claim_amount)) |>
  select(claim_amount_true, grup_ici_sinif, mice_1:mice_5)
#> # A tibble: 133 × 7
#> claim_amount_true grup_ici_sinif mice_1 mice_2 mice_3 mice_4 mice_5
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 4624. 1798. 950 997. 266. 664. 7620.
#> 2 7238. 1646. 445. 1197. 593. 1193. 361.
#> 3 6710. 1706. 101. 1475. 1438. 1204. 572.
#> 4 4338. 1798. 3939. 1656. 1996 715. 819.
#> 5 4277. 1798. 5234. 271. 2349. 674. 219.
#> 6 9438. 1706. 765. 7610 424. 989. 323.
#> 7 6987. 1646. 3519. 1689. 150. 499. 498.
#> 8 6747. 1798. 949. 1391. 4150. 900 721.
#> 9 9378. 1646. 926. 1506 1274. 1391. 66.0
#> 10 7487. 1694. 501. 2523. 2936. 5306. 700
#> # ℹ 123 more rowsGrup içi ortalama her eksik hücreye sınıfının ortalamasını yazıyordu; mice her hücreye ve her sete başka bir gözlenmiş tutar yazıyor: ilk on satırda 66 TL’den 7.620 TL’ye kadar. Gerçek tutarlar ise bu on satırda 4.277 ile 9.438 TL arasında.
Kaç hücrede mice’ın yazdığı değer gerçek tutarın altında kaldı?
tutar_dolu_mice |>
  filter(is.na(claim_amount)) |>
  summarise(across(mice_1:mice_5, ~ sum(.x < claim_amount_true)))
#> # A tibble: 1 × 5
#> mice_1 mice_2 mice_3 mice_4 mice_5
#> <int> <int> <int> <int> <int>
#> 1 122 126 131 129 126Her sette 133 hücrenin 122 ile 131 arasındakinde.
pmm eksik hücreye, öbür sütunlarına bakınca benzer görünen bir satırın gözlenmiş tutarını koyar; ama tutarı eksik bir satırı tutarı gözlenen satırlardan ayıracak bir sütun yok, çünkü eksikliği yaratan tutarın kendisiydi. Bu yüzden mice eksik hücrelere dosyanın sıradan tutarlarını yazar. Yaşta eksik hücreyi sınıfı ele veriyordu; burada hiçbir sütun ele vermiyor.
mice söz verdiği şeyi yaptı: eksikleri gözlenenler verildiğinde modelledi. Sorun algoritmada değil, varsayımda. mice’ın burada kullandığımız yöntemleri MAR varsayar ve tutar sütununda bu varsayım yanlıştır — eksiklik gözlenmeyen değerin kendisine bağlıydı, ve modelin göremediği bir şeye koşullanması mümkün değildir.
Yaş sütununda aynı mice çağrısı yanlılığı tamamen giderdi. Aynı algoritma, aynı ayarlar, iki farklı sonuç — çünkü mekanizmalar farklı. Atama bir teknik değil, bir varsayımdır.
Ne yapılır? Sırasıyla: (1) kaynak sisteme dönüp büyük hasarların neden eksik olduğunu sormak, (2) eksikliği bir değişken olarak saklayıp nerede yoğunlaştığını incelemek — bu tek başına yanlılığı düzeltmez, ama sorunun nerede olduğunu gösterir, (3) tek bir sayı yerine bir duyarlılık analizi raporlamak — eksik tutarların gözlenenlerden ne kadar büyük olduğunu bir δ ile varsayıp sonucun δ ile nasıl değiştiğini göstermek; kutunun hemen altında bu dosyada koşuyoruz. δ veriden tahmin edilemez; onu daraltan şey istatistik değil, hasar dosyalarının kendisidir. Bu ayarı mice de yapabilir: mnar.norm yöntemine δ’yı ums argümanıyla verirsiniz (belgeler; yöntemin dayanağı Tompsett vd., 2018).
Kutudaki üçüncü yolu bu dosyada koşalım. Eksik 133 tutarı gözlenen ortalamanın, tam_vaka’nın, \((1+\delta)\) katıyla dolduruyoruz: \(\delta=0\) ortalama atamasıdır, \(\delta=0{,}1\) ise mekanizma bölümündeki örnek varsayım, «eksik tutarlar gözlenenlerden ortalama %10 büyüktür». Döngü, altı poliçelik örnekteki gibi her \(\delta\) için bir satır ekler: ortalama ve gerçek ortalamadan farkı.
duyarlilik <- data.frame()
for (delta in c(0, 0.1, 0.5, 1, 3.5)) {
  dolu <- ifelse(is.na(ham_gercek$claim_amount),
                 (1 + delta) * tam_vaka, ham_gercek$claim_amount)
  duyarlilik <- bind_rows(duyarlilik, data.frame(
    delta    = delta,
    ortalama = mean(dolu),
    fark     = mean(dolu) - mean(ham_gercek$claim_amount_true)
  ))
}

round(duyarlilik, 2)
#> delta ortalama fark
#> 1 0.0 1733.67 -119.37
#> 2 0.1 1737.07 -115.96
#> 3 0.5 1750.68 -102.35
#> 4 1.0 1767.69 -85.34
#> 5 3.5 1852.77 -0.27İlk satır ortalama atamasının 1.733,67 TL’sidir. %10’luk varsayım ortalamayı yalnızca 1.737,07 TL’ye taşıyor; eksikleri gözlenen ortalamanın iki katıyla doldurmak (\(\delta=1\)) bile 1.767,69 TL veriyor ve gerçek ortalamaya (1.853,03 TL) olan farkın ancak %28,5’ini kapatıyor.
Fark \(\delta=3{,}5\)’te 0,27 TL’ye iniyor, yani eksik tutarların ortalamada gözlenenlerin 4,5 katı olduğu varsayımıyla: kaybolan kayıtların gerçek ortalamasında (7.726,93 TL) gördüğümüz oran. Eksikler dosyanın yalnızca %2’si olduğu için ortalamayı ancak çok büyük olurlarsa taşıyabilirler.
Bu oranı biliyoruz, çünkü tutarları biz sildik. Gerçek bir dosyada \(\delta\) veriden bilinemez: “eksik hasarlar gözlenen ortalamanın dört buçuk katıdır” cümlesi ancak hasar biriminden gelebilir. Duyarlılık analizi bu yüzden tek bir düzeltilmiş sayı değil, varsayıma bağlı bir aralık raporlar: \(\delta\) 0 ile 1 arasındaysa ortalama 1.733,67 ile 1.767,69 TL arasındadır.
Her eksik hücreye tek bir değer yazılmış bir tablo istemek yanlış değildir; yanlış olan, o tablonun kendi standart hatasına güvenmektir. Literatür hücre ortalamasını açıkça reddeder: mice’ın yazarı van Buuren (2018, §5.1.2) beş seti ortalayıp tek tablo gibi analiz etmenin standart hatayı, güven aralığını ve p değerini yanlış verdiğini yazar; beş seti alt alta yığmayı da (§5.1.3) yalnızca nokta tahmini için kabul eder. Tek bir dosyayla doğru belirsizlik veren yöntemler vardır; örneğin kesirli atama (Kim ve Fuller 2004) her eksik hücreye ağırlıklı birkaç değer koyar. Amaç çıkarsama değil tahminse, örneğin bir fiyatlama modelini yeni bir poliçeye uygulamaksa, tek atama tek başına yeterli olabilir (Josse vd. 2024).
Hücre başına tek değeri koruyan en basit yol önce bootstrap, sonra tek atamadır (Efron 1994; Shao ve Sitter 1996). Tablo bir kez doldurulur ve sonuç o tablodan hesaplanır. Standart hata ise eksik veriden çekilen bootstrap örneklerinin her biri yeniden doldurularak bulunur; atamanın belirsizliği böyle hesaba girer. Brand vd. (2019), karşılaştırdıkları on yöntem arasında, bootstrap içinde rastgele değer yazan tek atamayı en iyi yöntem buldu; pmm de her hücreye rastgele bir bağışçının değerini yazar.
Önce tabloyu bir kez doldurun. Ayarlar Çoklu atama bölümündekiyle aynı, yalnızca m = 1:
tek_tablo <- mice::complete(mice::mice(atama_verisi, m = 1, maxit = 5, method = "pmm",
                                       predictorMatrix = kalip, seed = 5124, printFlag = FALSE))

head(tek_tablo$age[is.na(atama_verisi$age)], 10)
#> [1] 78 82 78 73 81 74 86 73 75 52Yaşı eksik ilk on satıra şimdi birer yaş yazılı. Dördüncü satıra 73 yazılmış: beş setin o hücreye yazdığı 51–81 aralığından tek bir çekiliş. Yazılan yaşların hepsi dosyada gözlenmiş tam sayılardır; hücre ortalamasından farkı budur.
m = 1 — mice() tek bir tamamlanmış tablo üretir; complete() onu veri çerçevesi olarak döndürür.Ortalama yaşı, tablonun kendi standart hatasıyla birlikte, havuzlama bölümündeki yas_ozeti() ile hesaplayalım:
tek_ozet <- yas_ozeti(tek_tablo$age)
round(tek_ozet, 4)
#> ortalama std_hata pay_90_ustu
#> 63.9138 0.1308 0.7969Ortalama yaş 63,9138, tablonun kendi standart hatası 0,1308. 90 yaş ve üstünün payı %0,80: setlerin %0,66–1,05 aralığında, hücre ortalamasındaki gibi %0,56’ya düşmüyor, çünkü tek atama dağılımı daraltmaz.
Bu standart hata yalnızca tablonun içindeki belirsizliği taşır; tablonun başka bir çekilişle farklı doldurulabileceğini bilmez. Bunu bootstrap ölçer. Eksik veriden 100 bootstrap örneği çekin, her birini aynı ayarlarla bir kez doldurun ve ortalama yaşı alın:
set.seed(5125)
bootstrap_ortalamalar <- sapply(1:100, function(b) {
  ornek <- atama_verisi[sample(nrow(atama_verisi), replace = TRUE), ]
  doldurulmus <- mice::complete(mice::mice(ornek, m = 1, maxit = 5, method = "pmm",
                                           predictorMatrix = kalip, printFlag = FALSE))
  mean(doldurulmus$age)
})

round(head(bootstrap_ortalamalar, 10), 4)
#> [1] 63.7779 64.0117 63.9188 63.8506 63.8642 64.0335 63.8443 63.5698 63.6569
#> [10] 63.7726Her bootstrap örneği 6.776 satırdır ve yeniden doldurulmuştur. İlk on ortalama 63,57 ile 64,03 arasında oynuyor.
sample(nrow(atama_verisi), replace = TRUE) — satır numaralarından iadeli bir örnek çeker: bazı satırlar iki kez gelir, bazıları hiç gelmez. Bootstrap örneği budur.sapply(1:100, function(b) ...) — adı olmayan işlevi 100 kez çalıştırır ve dönen 100 ortalamayı bir vektörde toplar.mice()’a tohum verilmez. Verilseydi her tur aynı rastgele sayılarla başlardı; böylece rastgele sayı akışı baştaki set.seed(5125)’ten devam eder ve sonuç yine yeniden üretilebilir.Şimdi üç yolu yan yana koyalım: tek tablonun kendi standart hatası, aynı tablonun bootstrap standart hatası ve mice’ın havuzlanmış sonucu.
tek_deger_karsilastirma <- rbind(
  tek_tablo_kendi_hatasi = c(ortalama = tek_ozet[["ortalama"]], std_hata = tek_ozet[["std_hata"]]),
  tek_tablo_bootstrap    = c(ortalama = tek_ozet[["ortalama"]], std_hata = sd(bootstrap_ortalamalar)),
  mice_havuzlama         = c(ortalama = havuz_yas$pooled$estimate, std_hata = sqrt(havuz_yas$pooled$t))
)
round(tek_deger_karsilastirma, 4)
#> ortalama std_hata
#> tek_tablo_kendi_hatasi 63.9138 0.1308
#> tek_tablo_bootstrap 63.9138 0.1447
#> mice_havuzlama 63.8934 0.1364Bootstrap standart hatası 0,1447: tablonun kendi hatasından (0,1308) büyük ve mice’ın havuzlanmış hatasıyla (0,1364) aynı büyüklükte. Tek değerli tablo doğru cevaba varır, yeter ki standart hata o tablodan değil bootstrap’tan alınsın.
İki çekince var. Bootstrap 100 tekrarla hesaplandı, standart hatanın kendisi de birkaç yüzde oynar. Tek atamanın ortalaması (63,91) da tek bir çekilişe bağlıdır ve başka bir tohumla biraz farklı çıkar; bootstrap her örneği yeniden doldurduğu için standart hatası bu oynaklığı da içerir.
Bu noktadan sonra sayfa bu yolu izler. Kararları uygulamak bölümü analiz tablosunu mice ile bir kez doldurur (m = 1); rapora giden her sayı o tablodan hesaplanır, standart hatası bootstrap’tan gelir.
Bu dosyada sekiz tür sorun arıyoruz. Önceki bölümler eksik değerler için yöntemleri karşılaştırdı, sonraki bölüm yinelenen kayıtları ele alıyor. Aşağıdaki tablo sekizini bir arada gösterir: her sorun için verilen kararı ve kararın nerede uygulandığını. Hiçbir karar bu bölümde uygulanmıyor: bu bölüm sorunları sayar, Kararları uygulamak bölümü kararları sırayla uygular.
| Sorun | Karar | Nerede uygulanır |
|---|---|---|
| Eksik tutar | \(\delta\) ile doldurulur (MNAR): pmm benzer bir kaydın tutarını seçer, üstüne \(\delta\) × gözlenen ortalama eklenir |
Kararları uygulamak bölümü |
| Negatif tutar | Silinir: ödenen bir tutar negatif olamaz, doğru değeri de bilinmiyor | Kararları uygulamak bölümü |
| Eksik yaş | mice ile bir kez doldurulur (MAR): ortalamayı düzeltir; belirsizliği bootstrap ölçer |
Kararları uygulamak bölümü |
| Eksik cinsiyet | Satırlar silinir (MCAR): kalan satırlar azalır ama dengeli kalır | Kararları uygulamak bölümü |
| Sıfır tutar | Bırakılır; sözlük sıfırın ne demek olduğunu söylemiyor | — |
| Yinelenen satır | Tam kopyalar silinir | Kararları uygulamak bölümü |
| Yinelenen kimlik | Alanı çelişen kayıt silinmeden işaretlenir | Kararları uygulamak bölümü |
| Yinelenen profil | Profil üzerinden silinmez: aynı profil ayrı hasarlar olabilir | — |
Eksik tutarları silmiyoruz. Silmek ortalama hasarı gerçeğin %6,4 altına çekerdi, çünkü eksikler büyük hasarlardan geliyor (MNAR). Gözlenen veriye dayanan yöntemler de bu açığı kapatmadı: ortalama ataması silmeyle aynı sayıyı verdi, sınıf ya da eyalet içi ortalama ve mice ortalamayı gerçeğe 1 TL bile yaklaştırmadı, medyan ataması daha da aşağı çekti. Hepsi boşluklara sıradan büyüklükte tutarlar yazdı, çünkü hepsi “eksikler gözlenenlere benzer” varsayımına dayanıyordu.
MNAR’da eksiklerin ne kadar büyük olduğunu veri söylemez, bir varsayım söyler. MNAR bölümündeki duyarlılık analizi bu varsayımı \(\delta\) ile yazdı: eksik tutarlar ortalamada gözlenenlerin \((1+\delta)\) katıdır. \(\delta=0\)’da ortalama 1.733,67 TL, \(\delta=1\)’de 1.767,69 TL çıkıyordu; gerçek ortalamaya, 1.853,03 TL’ye, eksiklerin gözlenenlerin 4,5 katı olduğu varsayımıyla ulaşılıyordu.
Bu örnekte \(\delta\)’yı seçebiliyoruz, çünkü kaybolan tutarların gerçeğini biliyoruz: eksiklerin gerçek ortalaması gözlenen ortalamanın 4,46 katı. Kararımız bu yüzden \(\delta=3{,}5\). Gerçek bir dosyada bu bilgi olmaz; \(\delta\)’ya geçmiş veriye bakarak karar verilir: önceki dönemlerde tutarı başta eksik olup sonradan kesinleşen hasarların, tutarı baştan bilinenlerden ne kadar büyük çıktığına. Böyle bir veri yoksa tek bir \(\delta\) seçilmez; sonuç \(\delta\)’nın savunulabilir bir aralığı için raporlanır.
Eksik tutarlar Kararları uygulamak bölümünde, yaşla aynı mice çağrısında doldurulacak: pmm her eksik hücreye benzer bir kaydın gözlenmiş tutarını seçer, üstüne \(\delta\) × (gözlenen ortalama), yani yaklaşık 6.068 TL eklenir.
Bir kararın işini yapıp yapmadığını, tablodan kaç satırın gittiğine bakarak anlayamayız. Satır sayısı yalnızca bir toplamdır: kaç kaydın gittiğini söyler, ama gidenin tam da hedeflenen kayıt olduğunu ve geride hangi sorunların kaldığını söylemez. Bu yüzden sekiz sorunu tek seferde sayan bir denetim() fonksiyonu yazıp ham veride çalıştırıyoruz. Kararları uygulamak bölümü her silme adımından sonra aynı denetimi yeniden çalıştıracak: her adımın hedeflediği sayaç sıfıra inmeli, öbürleri yerinde kalmalıdır. Fonksiyonu yazıp ham veride çalıştıralım:
denetim <- function(veri) {
  c(
    satir = nrow(veri),
    eksik_tutar = sum(is.na(veri$claim_amount)),
    eksik_yas = sum(is.na(veri$age)),
    eksik_cinsiyet = sum(is.na(veri$gender)),
    negatif = sum(veri$claim_amount < 0, na.rm = TRUE),
    sifir = sum(veri$claim_amount == 0, na.rm = TRUE),
    yinelenen_satir = sum(duplicated(veri)),
    yinelenen_kimlik = sum(duplicated(veri$claim_no)),
    yinelenen_profil = sum(duplicated(veri[setdiff(names(veri), "claim_no")]))
  )
}

denetim(ham)
#> satir eksik_tutar eksik_yas eksik_cinsiyet
#> 6776 133 599 297
#> negatif sifir yinelenen_satir yinelenen_kimlik
#> 1 1 2 3
#> yinelenen_profil
#> 11Yukarıdaki denetim fonksiyonunun son üç sayacı iki yeni işlev kullanıyor:
duplicated(x) — x’in öğelerini (veri çerçevesi verildiğinde: satırları) baştan sona tarar ve her biri için aynısının daha önce görülüp görülmediğini söyleyen bir TRUE/FALSE vektörü döndürür. İlk karşılaşılan öğe FALSE, ondan sonraki kopyaları TRUE olur; bu yüzden sum(duplicated(...)) kaç fazlalık kayıt olduğunu verir, kaç çift olduğunu değil.setdiff(a, b) — a’da olup b’de olmayan öğeleri döndürür. Buradaki setdiff(names(veri), "claim_no") kimlik dışındaki sütun adlarının listesidir; veri[...] tabloyu o sütunlara indirgeyince duplicated() satırları kimliğe bakmadan karşılaştırır. Kimlik çıkarılmasaydı: bu sayaç yinelenen_satir ile birebir aynı şeyi ölçerdi — profil sayacını ayrı bir soru yapan tek şey o çıkarmadır.Ham veride sekiz sayacın hepsi sıfırdan büyük. Eksik değerler: 133 tutar, 599 yaş, 297 cinsiyet. Tutarda bir negatif, bir de sıfır kayıt var. Yinelenme sayaçları 2, 3 ve 11 diyor.
Yinelenme sayaçlarından biri dikkat ister. yinelenen_profil 11 diyor, ama o 11’in yalnızca 4’ü eksiksiz satırlar arasındadır (bir teknik kopya ve kaynağın kendi üç çifti). Kalan yedisinden biri, yaşı eksik olan öbür teknik kopyadır (H00002); altısı ise eksik değerin ürettiği sahte benzerliktir: iki satır yalnızca yaşta farklıyken ikisinin de yaşı eksilince profilde aynı görünürler.
Buradan çıkan kural sert: profil üzerinden distinct() çalıştırmayın. Bu dosyada öyle yapmak 11 satır siler: ikisi gerçekten fazlalık olan teknik kopyalardır, kalan dokuzu ise birbirinden gerçekte farklı kayıtlardır — altısı eksik değerin aynı gösterdiği kayıtlar, üçü kaynağın kendi ayrı hasarları. Hepsi yalnızca farkı göremediğiniz için silinirdi.
Üç yinelenme sayacının birbirinden farklı olması bir hata değil, haftanın en öğretici sayısıdır: kimlikte 3 ama satırda 2 olması, kimliği aynı olup bir alanı çelişen bir kopya bulunduğunu söyler; profilde 11 ama kimlikte 3 olması, farklı kimlikli ama aynı profilli çiftlerin varlığını — kaynaktan gelenlerin yanında, öğretim için eklenen eksik değerlerin kendi ürettiklerini de. Tek bir yinelenen sayacı bu ayrımı gizlerdi — ve gizlediği ayrım, hangi kaydın silinebileceğine dair kararın tamamıdır.
Ham veride tutarı, yaşı ya da cinsiyeti eksik 993 satır var. Bu satırlar, negatif tutar ve yinelenen kayıt kararlarıyla birlikte, Kararları uygulamak bölümünde ele alınır.
Bu bölümün sorusu şu: aynı hasar dosyada birden çok satırda geçiyor mu, geçiyorsa hangi satır silinmeli? Veri denetimi bölümündeki üç yinelenme sayacı üç ayrı durumu sayıyordu. yinelenen_satir her sütunu aynı olan satırları sayar ve 2 der; yinelenen_kimlik iki kez geçen kimlikleri sayar ve 3 der; yinelenen_profil kimlik dışındaki bütün sütunları aynı olan satırları sayar ve 11 der. Her durumun kararı başkadır.
Hangi satırların bu durumlara girdiğini kimlikleri tek tek yazarak değil, kodla buluyoruz: gerçek bir dosyada onları önceden bilmeyiz. Her satıra bir durum yazıp yinelenme sorunu olan bütün satırları basalım:
yinelenen_satirlar <- ham |>
  mutate(durum = case_when(
    duplicated(pick(everything())) | duplicated(pick(everything()), fromLast = TRUE) ~ "tam kopya",
    duplicated(claim_no) | duplicated(claim_no, fromLast = TRUE) ~ "kimlik çakışması",
    duplicated(pick(-claim_no)) | duplicated(pick(-claim_no), fromLast = TRUE) ~ "aynı profil"
  )) |>
  filter(!is.na(durum)) |>
  arrange(state, class, gender, age, claim_amount, claim_no)

print(yinelenen_satirlar, n = Inf)
#> # A tibble: 22 × 7
#> claim_no state class gender age claim_amount durum
#> <chr> <chr> <chr> <chr> <dbl> <dbl> <chr>
#> 1 H02217 STATE 03 C7 M 69 400 aynı profil
#> 2 H02218 STATE 03 C7 M 69 400 aynı profil
#> 3 H00001 STATE 14 C6 M 97 1134. tam kopya
#> 4 H00001 STATE 14 C6 M 97 1134. tam kopya
#> 5 H00414 STATE 15 C1 F NA NA aynı profil
#> 6 H00698 STATE 15 C1 F NA NA aynı profil
#> 7 H01253 STATE 15 C11 M 75 648. aynı profil
#> 8 H01254 STATE 15 C11 M 75 648. aynı profil
#> 9 H00899 STATE 15 C6 M 78 475 aynı profil
#> 10 H00900 STATE 15 C6 M 78 475 aynı profil
#> 11 H01550 STATE 15 C6 M NA 500 aynı profil
#> 12 H01894 STATE 15 C6 M NA 500 aynı profil
#> 13 H00002 STATE 15 C6 M NA 3761. tam kopya
#> 14 H00002 STATE 15 C6 M NA 3761. tam kopya
#> 15 H00255 STATE 15 C6 M NA NA aynı profil
#> 16 H00406 STATE 15 C6 M NA NA aynı profil
#> 17 H00601 STATE 15 C6 M NA NA aynı profil
#> 18 H00704 STATE 15 C6 M NA NA aynı profil
#> 19 H03641 STATE 15 C71 F 60 NA aynı profil
#> 20 H03647 STATE 15 C71 F 60 NA aynı profil
#> 21 H00005 STATE 15 F6 M 59 650 kimlik çakışması
#> 22 H00005 STATE 15 F6 M 95 650 kimlik çakışması22 satır var. Aynı profildeki satırlar alt alta duruyor, ve üç durum şöyle dağılıyor:
H00001 ve H00002 ikişer kez geçiyor ve iki satır her sütunda aynı. İkinci satırları öğretim için biz ekledik. H00005 iki kez geçiyor; eyaleti, sınıfı, cinsiyeti ve tutarı aynı, ama yaşı bir satırda 59, öbüründe 95. İkinci satırı da öğretim için biz ekledik; gerçek bir dosyada bunu bilmezdiniz. H02217–H02218, H00899–H00900 ve H01253–H01254. Bunlar kaynakta vardı. Aynı profildeki öbür on satırda ortak profil bir eksik değerden geliyor: iki satır yalnızca yaşta ya da tutarda farklıyken o değer ikisinde de eksilince aynı görünürler (Veri denetimi bölümü). En büyüğü dört satırlık bir grup: H00255, H00406, H00601 ve H00704’ün yaşı da tutarı da eksik, eyaleti, sınıfı ve cinsiyeti aynı.
pick(everything()) — mutate() içinde satırın bütün sütunlarını bir tablo olarak verir; pick(-claim_no) kimlik dışındakileri. duplicated() böylece bir satırı sütunlarının tamamıyla karşılaştırır.duplicated(x, fromLast = TRUE) — aramayı sondan başlatır, bu yüzden bir grubun ilk satırını da işaretler; duplicated(x) ile “veya”sı grubun bütün satırlarını işaretler. Verilmezse: her grubun ilk satırı tabloya girmez ve 22 yerine 12 satır görünür; tam kopyanın bir satırı yalnız kalır. case_when() — koşulları sırayla dener ve ilk tutanın değerini yazar; hiçbiri tutmazsa NA yazar. Sıra bir karardır: tam kopyanın iki satırı aynı kimliği ve aynı profili de taşır, bu yüzden önce o sorulur.filter(!is.na(durum)) — hiçbir durumun tutmadığı satırları atar.arrange(...) — aynı profildeki satırları alt alta getirir; eksik değerler sona dizilir.print(..., n = Inf) — bir tibble 20 satırdan uzunsa yalnızca ilk onunu basar; n = Inf hepsini basar.İki satır her sütunda aynıysa ayırt edilemezler; hangisinin kalacağı sorusunun cevabı yoktur, çünkü soru anlamsızdır. distinct() her tam kopyanın fazlasını siler. Etkisini denetimin yinelenme sayaçlarıyla görelim:
sayaclar <- c("satir", "yinelenen_satir", "yinelenen_kimlik", "yinelenen_profil")

rbind(ham      = denetim(ham)[sayaclar],
      distinct = denetim(distinct(ham))[sayaclar])
#> satir yinelenen_satir yinelenen_kimlik yinelenen_profil
#> ham 6776 2 3 11
#> distinct 6774 0 1 9distinct() iki satır sildi, H00001 ile H00002’nin ikinci satırlarını, ve yinelenen_satir sıfıra indi. Öbür iki sayaç da ikişer düştü, çünkü silinen iki satır onlarda da sayılıyordu. Kimlikte bir yinelenme kalıyor, H00005: iki satırı aynı olmadığı için distinct() ona dokunmaz.
distinct(ham) — her sütunu aynı olan satırlardan yalnızca ilkini bırakır.denetim(...)[sayaclar] — denetimin dokuz sayacından yalnızca adı verilen dördünü alır.H00005’in iki satırından hangisi doğru? 59 ile 95 rakam devriği olabilir, ama hangisinin devrik olduğunu veri söylemez: ikisi de olağan bir yaş. Kimlik başına tek satır bırakmak çekici gelir; distinct(claim_no, .keep_all = TRUE) bunu yapar. Hangi satırı tuttuğuna bakalım:
kimlige_gore <- distinct(ham, claim_no, .keep_all = TRUE)

kimlige_gore |>
  filter(claim_no == "H00005")
#> # A tibble: 1 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00005 STATE 15 F6 M 95 650Tuttuğu satırda yaş 95: yalnızca dosyada önce geldiği için. Bu çağrı üç satır siler, iki tam kopyanın fazlasını ve H00005’in ikinci satırını. Bilmediğimiz bir soruyu, hangi yaşın doğru olduğunu, uyarı vermeden “ilk satır” diye yanıtlamış olur.
distinct(claim_no, .keep_all = TRUE) — yalnızca kimliğe bakar ve her kimlik için ilk satırı bırakır; .keep_all = TRUE o satırın öbür sütunlarını da tutar. Verilmezse: sonuç yalnızca claim_no sütunundan oluşur. Bu çağrı ancak hangi satırın tutulacağını söyleyen bir kural varsa doğrudur, ve kural veriden gelmelidir. Bir kayıt tarihi olsaydı en yeni satırı, bir kaynak sistem sütunu olsaydı güvenilir sistemin satırını seçerdik; buna uzlaştırma denir. Bu dosyada ikisi de yok. O zaman satır silinmez: çakışma bir sütunla işaretlenir ve kaynak sisteme sorulur. Bayrağı tam kopyalar silindikten sonra koyuyoruz, ki yalnızca gerçek çakışmayı işaretlesin:
isaretli <- distinct(ham) |>
  group_by(claim_no) |>
  mutate(kimlik_cakismasi = n() > 1) |>
  ungroup()

isaretli |>
  filter(kimlik_cakismasi)
#> # A tibble: 2 × 7
#> claim_no state class gender age claim_amount kimlik_cakismasi
#> <chr> <chr> <chr> <chr> <dbl> <dbl> <lgl>
#> 1 H00005 STATE 15 F6 M 95 650 TRUE
#> 2 H00005 STATE 15 F6 M 59 650 TRUEİki satır işaretlendi, ikisi de H00005. Bayrak satırı silmez; sonraki her analiz onu okuyabilir, örneğin yaşa göre bir kırılımda bu iki satırı ayrı göstermek için. Kaynak sistem hangi yaşın doğru olduğunu söylediğinde yanlış satır düzeltilir ve bayrak kalkar.
group_by(claim_no) + n() > 1 — bu kalıp “bu kimlik birden fazla satırda geçiyor mu?” sorusunun tamamıdır.ungroup() — gruplamayı kaldırır. Verilmezse: tablo gruplu kalır ve sonraki bir özet ya da mutate() sessizce kimlik grupları içinde çalışır.H01253 ile H01254 farklı kimlik taşıyor; öbür bütün sütunları aynı: STATE 15, C11, erkek, 75 yaş, 648,06 TL. Aynı eyalette, aynı sınıfta, aynı yaştaki iki sigortalının aynı tutarda hasar bildirmesi olağandır. Bunlar iki ayrı hasardır ve ikisi de kalır. Kimliğin çözdüğü şey tam olarak budur: kimlik sütunu olmasaydı bu çift tam kopyadan ayırt edilemezdi.
Kaynağın öbür iki çifti için de aynısı geçerli. Ortak profili bir eksik değerden gelen on satır da ayrı kayıtlardır: aradaki fark eksik hücrededir.
Bu yüzden profil üzerinden, yani kimliği dışarıda bırakarak distinct() çalıştırılmaz. Veri denetimi bölümünde gördüğümüz gibi bu dosyada 11 satır silerdi: ikisi tam kopyanın fazlası, dokuzu gerçekten ayrı kayıtlar.
| Durum | Bu dosyada | Karar | Nasıl |
|---|---|---|---|
| Tam kopya | H00001, H00002 |
sil | distinct() |
| Kimlik çakışması | H00005 (yaş 95 / 59) |
silmeden işaretle, kaynağa sor | group_by(claim_no) + n() > 1 |
| Aynı profil | 16 satır: kaynağın üç çifti, eksik değerin aynı gösterdiği on satır | dokunma | — |
Kararlar Kararları uygulamak bölümünde analiz tablosuna uygulanır. Temizleme günlüğüne yazılacak satır şudur: iki tam kopya silindi; bir kimlik çakışması işaretlendi ve kaynak sisteme soruldu; farklı kimlikli profil çiftlerine dokunulmadı. Üç farklı işlem, üç farklı gerekçe — ve hiçbiri “yinelenenleri temizledim” cümlesiyle özetlenemez.
Veri denetimi bölümü sekiz sorunu saydı ve her birine bir karar verdi. Bu bölüm kararları sırayla uygular ve sonraki bölümün kullanacağı analiz tablosunu kurar. Sıra şöyle: önce negatif tutar silinir, sonra tam kopyalar, sonra cinsiyeti eksik satırlar; eksik yaşlar ve tutarlar en sonda aynı mice çağrısıyla doldurulur. Her silme adımı yalnızca kendi sorununu gidermelidir; üç adımdan sonra bunu denetimle sınayacağız.
Atamanın sona kalmasının bir nedeni var. mice her eksik hücreyi ayrı doldurur: atama kopyalar silinmeden yapılsaydı H00002’nin iki kopyası iki farklı yaş alabilir ve distinct() onları artık kopya olarak tanımazdı. Çoklu atama bölümündeki atamada, bütün satırlar üzerinde, tam olarak bu oldu: beş setin dördünde iki kopya farklı yaşlar aldı.
İlk karar negatif tutarı silmek: ödenen bir tutar negatif olamaz, doğru değeri de bilinmiyor. Koşulu yazarken eksik tutarları korumak gerekiyor, çünkü onları sonra \(\delta\) ile dolduracağız.
negatifsiz <- ham |>
  filter(is.na(claim_amount) | claim_amount >= 0)

negatifsiz
#> # A tibble: 6,775 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842.
#> 4 H00004 STATE 15 F6 F NA 2385.
#> 5 H00005 STATE 15 F6 M 95 650
#> 6 H00006 STATE 15 F6 M NA 391.
#> 7 H00007 STATE 15 C11 M 94 3776.
#> 8 H00008 STATE 10 C6 M 94 415.
#> 9 H00009 STATE 14 C11 M NA 2284.
#> 10 H00010 STATE 03 C11 M 93 665.
#> # ℹ 6,765 more rowsBaşlığa göre negatifsiz 6.775 satırdır: tek bir kayıt, negatif tutarlı olan, elendi. Koşul iki parçadır ve | (veya) ile birleşir: bir satır ikisinden birini sağlarsa kalır.
claim_amount >= 0 — negatif tutarlı kaydı eler: H03853, −250 TL. Eşiğin >= 0 olması bir karardır: > 0 yazsaydık sıfır tutarlı kayıt da elenirdi. Sıfır tutar tazminatsız kapanmış bir dosya olabilir, ama veri sözlüğü sıfırın “ödeme yok” mu “bilinmiyor” mu demek olduğunu söylemiyor; onu silmek dayanaksız olurdu. is.na(claim_amount) | — tutarı eksik 133 kaydı tutar. Yazılmazsa: claim_amount >= 0 eksik tutarda NA verir, filter() de koşulu NA olan satırı atar; kural uyarı vermeden 133 eksik tutarı da siler ve negatifsiz 6.642 satır kalır. Sonra tam kopyaların fazlasını silelim:
kopyasiz <- distinct(negatifsiz)

kopyasiz
#> # A tibble: 6,773 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00003 STATE 15 C11 <NA> 95 7842.
#> 4 H00004 STATE 15 F6 F NA 2385.
#> 5 H00005 STATE 15 F6 M 95 650
#> 6 H00006 STATE 15 F6 M NA 391.
#> 7 H00007 STATE 15 C11 M 94 3776.
#> 8 H00008 STATE 10 C6 M 94 415.
#> 9 H00009 STATE 14 C11 M NA 2284.
#> 10 H00010 STATE 03 C11 M 93 665.
#> # ℹ 6,763 more rowskopyasiz 6.773 satırdır: H00001 ile H00002’nin ikinci satırları gitti. H00002’nin iki kopyasında da yaş eksik olduğu için eksik yaş 599’dan 598’e indi.
Sonra cinsiyeti eksik satırları silelim. Karar cinsiyet bölümünden geliyor: eksiklik MCAR olduğu için kalan satırlar küçülmüş ama dengeli bir örneklemdir. Aynı gerekçe tutar için de geçerlidir: eksiklik hiçbir değere bağlı olmadığı için silinen satırlar tutar bakımından da kalanlarla aynı dağılımdan gelir. Silmenin bedeli yanlılık değil, kesinliktir.
cinsiyetli <- kopyasiz |>
  filter(!is.na(gender))

cinsiyetli
#> # A tibble: 6,476 × 6
#> claim_no state class gender age claim_amount
#> <chr> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00004 STATE 15 F6 F NA 2385.
#> 4 H00005 STATE 15 F6 M 95 650
#> 5 H00006 STATE 15 F6 M NA 391.
#> 6 H00007 STATE 15 C11 M 94 3776.
#> 7 H00008 STATE 10 C6 M 94 415.
#> 8 H00009 STATE 14 C11 M NA 2284.
#> 9 H00010 STATE 03 C11 M 93 665.
#> 10 H00011 STATE 02 C6 M 93 414
#> # ℹ 6,466 more rows6.476 satır kaldı, 297 satır gitti. Gidenlerin 19’unda yaş, 5’inde tutar da eksikti; eksik yaş 598’den 579’a, eksik tutar 133’ten 128’e indi. Tabloda eksik değer olarak yalnızca bu 579 yaş ve 128 tutar kaldı.
Üç silme adımının her birinin hangi sayacı düşürdüğünü denetimle görelim:
silme_denetimi <- cbind(
  ham        = denetim(ham),
  negatifsiz = denetim(negatifsiz),
  kopyasiz   = denetim(kopyasiz),
  cinsiyetli = denetim(cinsiyetli)
)
silme_denetimi
#> ham negatifsiz kopyasiz cinsiyetli
#> satir 6776 6775 6773 6476
#> eksik_tutar 133 133 133 128
#> eksik_yas 599 599 598 579
#> eksik_cinsiyet 297 297 297 0
#> negatif 1 0 0 0
#> sifir 1 1 1 1
#> yinelenen_satir 2 2 0 0
#> yinelenen_kimlik 3 3 1 1
#> yinelenen_profil 11 11 9 9Her sütun bir adımdan sonraki tablodur. Her adım hedeflediği sayacı sıfıra indirdi: negatif ilk adımda 1’den 0’a, yinelenen_satir ikincide 2’den 0’a, eksik_cinsiyet üçüncüde 297’den 0’a.
Öbür sayaçlar ya yerinde kaldı ya da silinen satırlar onlarda da sayıldığı için azaldı. Üçü bilerek kaldı. eksik_tutar ilk adımda 133’te kaldı, çünkü koşul eksik tutarı koruyor. sifir her adımda 1, çünkü eşik >= 0. yinelenen_kimlik ikinci adımdan sonra 1, çünkü H00005’in iki satırı tam kopya değil.
Bir silme kuralı “veriyi temizlemez”; yalnızca kendi tarif ettiği sorunu giderir, gerisini olduğu yerde bırakır. Geride kalan 579 eksik yaş ve 128 eksik tutar sonraki adımın işidir.
cbind(...) — vektörleri sütun olarak yan yana dizer; rbind()’ın sütundaki karşılığıdır. Burada her sütun bir adımdan sonraki denetimdir.mice ile doldurmakGeriye yaş ve tutar kaldı. Yaşta eksiklik sınıfa bağlıydı (MAR) ve Çoklu atama bölümünde mice yanlılığı giderip belirsizliği taşıdı. Tutarda mice tek başına yetmez (MNAR); veri denetimi bölümünde kararlaştırdığımız \(\delta\) kaydırması gerekir. İkisini tek bir mice çağrısında yapıyoruz ve, Tek değerle çalışmak bölümündeki kararla, tabloyu bir kez dolduruyoruz; belirsizliği bootstrap ölçecek. mice yordayıcıları metin olarak kullanamadığı için önce sütunları, o bölümde olduğu gibi, faktöre çevirelim:
analiz_atama_verisi <- cinsiyetli |>
  mutate(
    state = factor(state),
    class = factor(trimws(class)),
    gender = factor(gender)
  )

analiz_atama_verisi
#> # A tibble: 6,476 × 6
#> claim_no state class gender age claim_amount
#> <chr> <fct> <fct> <fct> <dbl> <dbl>
#> 1 H00001 STATE 14 C6 M 97 1134.
#> 2 H00002 STATE 15 C6 M NA 3761.
#> 3 H00004 STATE 15 F6 F NA 2385.
#> 4 H00005 STATE 15 F6 M 95 650
#> 5 H00006 STATE 15 F6 M NA 391.
#> 6 H00007 STATE 15 C11 M 94 3776.
#> 7 H00008 STATE 10 C6 M 94 415.
#> 8 H00009 STATE 14 C11 M NA 2284.
#> 9 H00010 STATE 03 C11 M 93 665.
#> 10 H00011 STATE 02 C6 M 93 414
#> # ℹ 6,466 more rowsSütunlar atama_verisi’ndekilerle aynı adda ve aynı sıradadır. Bu yüzden Çoklu atama bölümünde kurduğumuz kalip matrisini, kimliği modelin dışında tutan yordayıcı matrisini, olduğu gibi kullanabiliriz.
Yeni olan, atanan tutara eklenecek kaydırma: \(\delta\) × gözlenen ortalama. Gözlenen ortalama MNAR bölümünde kurduğumuz tam_vaka’dır.
tutar_kaydirma <- 3.5 * tam_vaka

tutar_kaydirma
#> [1] 6067.829Her atanan tutara 6.067,83 TL eklenecek: \(\delta=3{,}5\) ile gözlenen ortalamanın, tam_vaka’nın, çarpımı. mice’a bunu post argümanıyla söylüyoruz:
analiz_post <- mice::make.post(analiz_atama_verisi)
analiz_post["claim_amount"] <- paste0("imp[[j]][, i] <- imp[[j]][, i] + ", tutar_kaydirma)

analiz_post
#> claim_no
#> ""
#> state
#> ""
#> class
#> ""
#> gender
#> ""
#> age
#> ""
#> claim_amount
#> "imp[[j]][, i] <- imp[[j]][, i] + 6067.82868809273"mice::make.post(analiz_atama_verisi) — her sütun için boş bir komut kurar. mice bir sütunu doldurduktan hemen sonra o sütunun komutunu çalıştırır; komutu boş olan sütuna dokunmaz.imp[[j]][, i] — mice’ın kendi içinde atanan değerlere verdiği ad: j sütun, i set. Komut her atanan tutara 6.067,83 TL ekler; gözlenen tutarlar imp’te olmadığı için değişmez. Yalnızca claim_amount’ın komutu dolu, yaş pmm’in seçtiği gibi kalır. Ayarlar Çoklu atama bölümündeki gibi; farklı olanlar post, tohum ve m = 1: tabloyu bir kez dolduruyoruz.
analiz_atama <- mice::mice(
  analiz_atama_verisi,
  m = 1, maxit = 5, method = "pmm",
  predictorMatrix = kalip, post = analiz_post,
  seed = 5120, printFlag = FALSE
)

analiz_atama$method
#> claim_no state class gender age claim_amount
#> "" "" "" "" "pmm" "pmm"Bu kez age ve claim_amount için pmm çalışır; cinsiyet artık eksiksizdir. analiz_atama tek bir tamamlanmış tablo taşır.
Önce yaşın doldurulmuş hâline bakalım. analiz_yas_dolu, cinsiyetli’nin yanına atanan yaşı koyar; ekrana yaşı eksik satırlar gelir.
analiz_yas_dolu <- cinsiyetli |>
  mutate(atanan_yas = mice::complete(analiz_atama)$age)

analiz_yas_dolu |>
  filter(is.na(age)) |>
  select(claim_no, class, gender, age, atanan_yas)
#> # A tibble: 579 × 5
#> claim_no class gender age atanan_yas
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 H00002 C6 M NA 77
#> 2 H00004 F6 F NA 78
#> 3 H00006 F6 M NA 85
#> 4 H00009 C11 M NA 67
#> 5 H00013 F6 M NA 72
#> 6 H00022 C6 M NA 73
#> 7 H00030 C6 F NA 82
#> 8 H00033 C6 F NA 75
#> 9 H00039 C6 M NA 82
#> 10 H00043 C11 M NA 52
#> # ℹ 569 more rowsYaşı eksik 579 satırın ilk onu. age sütunu boş kalır, çünkü cinsiyetli’nin kendisi değişmez; atanan_yas her satıra bir yaş yazar. İlk satır C6 sınıfındaki H00002’dir ve ona 77 yazılmış. Yazılanların hepsi dosyada gözlenmiş yaşlardır.
Sonra tutarın doldurulmuş hâli. analiz_tutar_dolu doğruluk dosyasındaki gerçek tutarı da getirir, ki atamanın gerçeğin neresine düştüğü görünsün; ekrana tutarı eksik satırlar gelir.
analiz_tutar_dolu <- cinsiyetli |>
  left_join(dogruluk, by = "claim_no") |>
  mutate(atanan_tutar = mice::complete(analiz_atama)$claim_amount)

analiz_tutar_dolu |>
  filter(is.na(claim_amount)) |>
  select(claim_no, claim_amount_true, atanan_tutar)
#> # A tibble: 128 × 3
#> claim_no claim_amount_true atanan_tutar
#> <chr> <dbl> <dbl>
#> 1 H00138 4624. 6450.
#> 2 H00185 7238. 8269.
#> 3 H00188 6710. 6793.
#> 4 H00190 4338. 6907.
#> 5 H00191 4277. 6311.
#> 6 H00249 9438. 9394.
#> 7 H00254 6987. 6561.
#> 8 H00255 6747. 6566.
#> 9 H00401 9378. 6189.
#> 10 H00402 7487. 8441.
#> # ℹ 118 more rowsTutarı eksik 128 satırın ilk onu. Her atanan tutar, pmm’in seçtiği gözlenmiş bir tutara 6.067,83 TL eklenerek elde edildi; bu yüzden en küçüğü 6.159,62 TL.
İlk satırda (H00138) gerçek tutar 4.624 TL, atanan 6.450 TL: bu küçük hasar büyütülmüş. Dokuzuncu satırda (H00401) ise gerçek tutar 9.378 TL, atanan 6.189 TL.
128 atanan tutarın 43’ü gerçeğin altında kalıyor. Tek tek hücreleri tutturmak amaç değildir: amaç ortalamayı ve toplamı doğru taşımaktır, bunu da aşağıdaki karşılaştırma ölçüyor.
left_join(dogruluk, by = "claim_no") — her satırın yanına doğruluk dosyasındaki gerçek tutarı getirir. Bu sütun gerçek hayatta yoktur; karşılaştırmayı yalnızca eksikliği biz ürettiğimiz için yapabiliyoruz.Eksik kalıp kalmadığını denetimle sınayalım:
denetim(mice::complete(analiz_atama))#> satir eksik_tutar eksik_yas eksik_cinsiyet
#> 6476 0 0 0
#> negatif sifir yinelenen_satir yinelenen_kimlik
#> 0 1 0 1
#> yinelenen_profil
#> 4Eksik tutar, yaş ve cinsiyet sıfırdır; negatif tutar ve tam kopya da kalmamıştır.
mice::complete(analiz_atama) — tamamlanmış tabloyu döndürür; tek atamada bir tane vardır.Eksik kalmadı. Peki \(\delta\) ile atanan tutarlar ortalamayı nereye taşıdı? Tam vakayla ve gerçek ortalamayla karşılaştıralım; gerçek, bu 6.476 kaydın doğruluk dosyasındaki tutarlarıdır.
analiz_tutar <- c(
  tam_vaka = mean(cinsiyetli$claim_amount, na.rm = TRUE),
  delta_ile_atama = mean(mice::complete(analiz_atama)$claim_amount),
  gercek = mean(analiz_tutar_dolu$claim_amount_true)
)
round(analiz_tutar, 2)
#> tam_vaka delta_ile_atama gercek
#> 1737.36 1855.31 1857.23Tam vaka 1.737,36 TL, \(\delta\) ile atama 1.855,31 TL, gerçek 1.857,23 TL. Silme gerçeğin 119,87 TL altında kalırdı; atama 1,92 TL altında kalıyor.
Bu kadar yaklaşmasının iki nedeni var: \(\delta\)’yı gerçeği bildiğimiz bir orandan seçtik, ve tek bir çekiliş şanslı da olabilir. Bootstrap aşağıda bu sayının ne kadar oynayabileceğini ölçüyor. Gerçek bir dosyada geçmiş veriden seçilen bir \(\delta\), o geçmiş bugüne ne kadar benziyorsa o kadar iyidir; bu yüzden ortalama hasar, MNAR bölümündeki duyarlılık analizinde olduğu gibi, \(\delta\)’nın bir aralığı için de raporlanır.
Denetimin sıfır olmayan üç sayacı verdiğimiz kararların kendisidir:
| Sayaç | Değer | Neden |
|---|---|---|
sifir |
1 | tutarı sıfır olan kayıt bilerek tutuldu: sözlük sıfırın ne demek olduğunu söylemiyor |
yinelenen_kimlik |
1 | H00005’in iki satırı yaşta çelişiyor ve silinmedi |
yinelenen_profil |
4 | kaynağın kendi üç çifti ayrı hasarlardır, dokunulmadı; dördüncüsü atamanın ürettiği sahte bir çifttir, aşağıda |
Dördüncü çifti atama üretiyor. H01550 ile H01894 aynı eyalet, sınıf ve cinsiyette iki ayrı 500 TL’lik hasardır; ikisinin de yaşı öğretim için silinmişti (gerçekte 73 ve 71). pmm ikisine de 79 yazınca profilde aynı göründüler.
Profil üzerinden distinct() çalıştırmama kuralı bu yüzden atamadan sonra da geçerlidir: bu tabloda gerçekten ayrı iki kaydı silerdi.
Atama yalnızca 579 yaşı ve 128 tutarı doldurdu; cinsiyet, sınıf ve eyalet değişmedi. Son kararı da ekliyoruz: H00005’in iki satırı silinmeden işaretlenir.
analiz <- mice::complete(analiz_atama) |>
  group_by(claim_no) |>
  mutate(kimlik_cakismasi = n() > 1) |>
  ungroup()

analiz |>
  filter(kimlik_cakismasi)
#> # A tibble: 2 × 7
#> claim_no state class gender age claim_amount kimlik_cakismasi
#> <chr> <fct> <fct> <fct> <dbl> <dbl> <lgl>
#> 1 H00005 STATE 15 F6 M 95 650 TRUE
#> 2 H00005 STATE 15 F6 M 59 650 TRUEanaliz 6.476 satır ve yedi sütundur. Sonraki bölüm dağılımı bu tabloyla çizer ve sayılarını bu tablodan hesaplar; rapora girecek sayıların standart hatası ise bir sonraki alt bölümde bootstrap’tan gelir.
Analiz tablosu tek atamadır. Rapora girecek her sayı bu tablodan hesaplanır, standart hatası ise Tek değerle çalışmak bölümündeki gibi bootstrap’tan gelir. Bir sayı yerine raporlanacak bütün sayıları aynı döngüde hesaplayalım. Önce bir tablodan bu sayıları çıkaran işlevi yazıp analiz tablosunda çalıştırın:
analiz_istatistikleri <- function(tablo) {
  esik <- quantile(tablo$claim_amount, 0.99)
  c(ort_tutar      = mean(tablo$claim_amount),
    ort_yas        = mean(tablo$age),
    yas_katsayisi  = coef(lm(claim_amount ~ age + gender, data = tablo))[["age"]],
    esik_99        = unname(esik),
    kuyruk_payi    = 100 * sum(tablo$claim_amount[tablo$claim_amount >= esik]) / sum(tablo$claim_amount),
    pay_10000_ustu = 100 * mean(tablo$claim_amount > 10000))
}

analiz_tahmin <- analiz_istatistikleri(analiz)
round(analiz_tahmin, 4)
#> ort_tutar ort_yas yas_katsayisi esik_99 kuyruk_payi
#> 1855.3069 63.8675 1.2963 11378.3840 9.1647
#> pay_10000_ustu
#> 1.6677Altı sayı: ortalama tutar ve yaş; tutarı yaşa ve cinsiyete bağlayan regresyonda yaşın katsayısı; en büyük %1’lik dilimin eşiği ve toplam tutardaki payı; 10.000 TL’yi aşan hasarların payı.
coef(lm(...))[["age"]] — coef() uydurulan modelin katsayılarını adlı bir vektör olarak verir: (Intercept), age ve genderM. [["age"]] bu vektörden yaşınkini adı olmadan alır.unname(esik) — quantile() eşiği 99% adıyla döndürür; unname() bu adı siler. Ad kalsaydı c() onu bizim verdiğimiz adla birleştirir ve eşik esik_99 yerine esik_99.99% adını alırdı; yaşın katsayısında [["age"]]’in tek köşeli ["age"] yerine yazılmasının nedeni de bu.Şimdi bootstrap. cinsiyetli’den, yani analiz tablosunun atanmadan önceki hâlinden, 100 örnek çekin; her örneği analiz tablosu gibi doldurun ve altı sayıyı yeniden hesaplayın. \(\delta\) kaydırması her örnekte o örneğin gözlenen ortalamasıyla kurulur:
set.seed(5128)
analiz_bootstrap <- t(sapply(1:100, function(b) {
  ornek <- cinsiyetli[sample(nrow(cinsiyetli), replace = TRUE), ]
  veri <- ornek |>
    mutate(state = factor(state), class = factor(trimws(class)), gender = factor(gender))
  post <- mice::make.post(veri)
  post["claim_amount"] <- paste0("imp[[j]][, i] <- imp[[j]][, i] + ",
                                 3.5 * mean(veri$claim_amount, na.rm = TRUE))
  doldurulmus <- mice::complete(mice::mice(veri, m = 1, maxit = 5, method = "pmm",
                                           predictorMatrix = kalip, post = post, printFlag = FALSE))
  analiz_istatistikleri(doldurulmus)
}))

round(head(analiz_bootstrap), 2)
#> ort_tutar ort_yas yas_katsayisi esik_99 kuyruk_payi pay_10000_ustu
#> [1,] 1819.91 64.00 -3.98 11422.37 9.19 1.65
#> [2,] 1846.01 63.89 1.44 11511.74 9.20 1.51
#> [3,] 1846.79 63.87 -1.12 11916.58 9.62 1.78
#> [4,] 1846.05 64.00 3.03 11890.70 9.24 1.59
#> [5,] 1815.04 64.00 6.16 10980.91 9.07 1.36
#> [6,] 1842.32 63.87 -2.15 11109.31 8.16 1.67Her satır bir bootstrap örneğidir; 100 satır, altı sütun.
t(...) — sapply() her turun altı sayısını bir sütuna yazar; t() tabloyu çevirir, her tur bir satır olur.Tahmini, bootstrap standart hatasını ve %95’lik yüzdelik aralığı yan yana koyun:
analiz_rapor <- cbind(
  tahmin     = analiz_tahmin,
  std_hata   = apply(analiz_bootstrap, 2, sd),
  yuzde_2_5  = apply(analiz_bootstrap, 2, quantile, 0.025),
  yuzde_97_5 = apply(analiz_bootstrap, 2, quantile, 0.975)
)
round(analiz_rapor, 4)
#> tahmin std_hata yuzde_2_5 yuzde_97_5
#> ort_tutar 1855.3069 32.4610 1793.1950 1922.1721
#> ort_yas 63.8675 0.1477 63.5930 64.1047
#> yas_katsayisi 1.2963 3.7392 -5.3507 9.8577
#> esik_99 11378.3840 418.0885 10705.5775 12426.2507
#> kuyruk_payi 9.1647 0.6558 8.1705 10.5980
#> pay_10000_ustu 1.6677 0.1726 1.3345 2.0001Ortalama tutar 1.855,31 TL, standart hatası 32,46 TL; %95’lik aralık 1.793,19 ile 1.922,17 TL arasında ve gerçek ortalamayı (1.857,23 TL) içeriyor. Ortalama yaş 63,87, standart hatası 0,1477.
Yaşın katsayısı 1,30, standart hatası 3,74; aralığı −5,35 ile 9,86 arasında, yani yaşla tutar arasında bir ilişki görünmüyor. Kuyruğun eşiği 11.378 TL (standart hata 418), 10.000 TL’yi aşan hasarların payı %1,67 (standart hata 0,17).
apply(analiz_bootstrap, 2, sd) — tablonun her sütununa (2) sd()’yi uygular: her sayının 100 bootstrap değerinin standart sapması, yani bootstrap standart hatası. quantile ile aynı çağrı %2,5’lik ve %97,5’lik yüzdelikleri verir.Tablonun kendi standart hatası yine küçük kalır. Regresyonun kendi çıktısına bakın:
round(summary(lm(claim_amount ~ age + gender, data = analiz))$coefficients, 4)#> Estimate Std. Error t value Pr(>|t|)
#> (Intercept) 1789.8180 200.0716 8.9459 0.0000
#> age 1.2963 3.0091 0.4308 0.6666
#> genderM -27.9965 66.3170 -0.4222 0.6729lm() yaşın katsayısı için 3,01 diyor, bootstrap 3,74: tablonun kendi hatası yaklaşık beşte bir küçük, çünkü atanan 579 yaşı ve 128 tutarı gözlenmiş gibi sayar. Burada sonuç değişmiyor, yaşın katsayısı iki hatayla da sıfırdan ayırt edilemiyor; laboratuvarın Görev G’sinde değişiyor.
İki not. Bootstrap atamanın ve örneklemenin belirsizliğini taşır, \(\delta\)’nın kendisininkini taşımaz: 3,5 her örnekte aynıdır; \(\delta\)’nın belirsizliği MNAR bölümündeki duyarlılık analizinin işidir. Ve her bootstrap ataması, analizdeki değişkenleri yordayıcı olarak kullanmalıdır, yoksa atanan değerler o ilişkiyi taşımaz: kalip’ta yaş tutardan ve cinsiyetten, tutar da yaştan ve cinsiyetten yordanıyor.
Grafik bir süs değil, belirli bir sorunun yanıtıdır.
ggplot(analiz, aes(x = claim_amount)) +
  geom_histogram(bins = 25, fill = "#F28E2B", color = "white") +
  scale_x_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
  scale_y_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
  labs(
    title = "Hasar tutarlarının dağılımı",
    x = "Hasar tutarı (TL)",
    y = "Kayıt sayısı"
  ) +
  theme_minimal()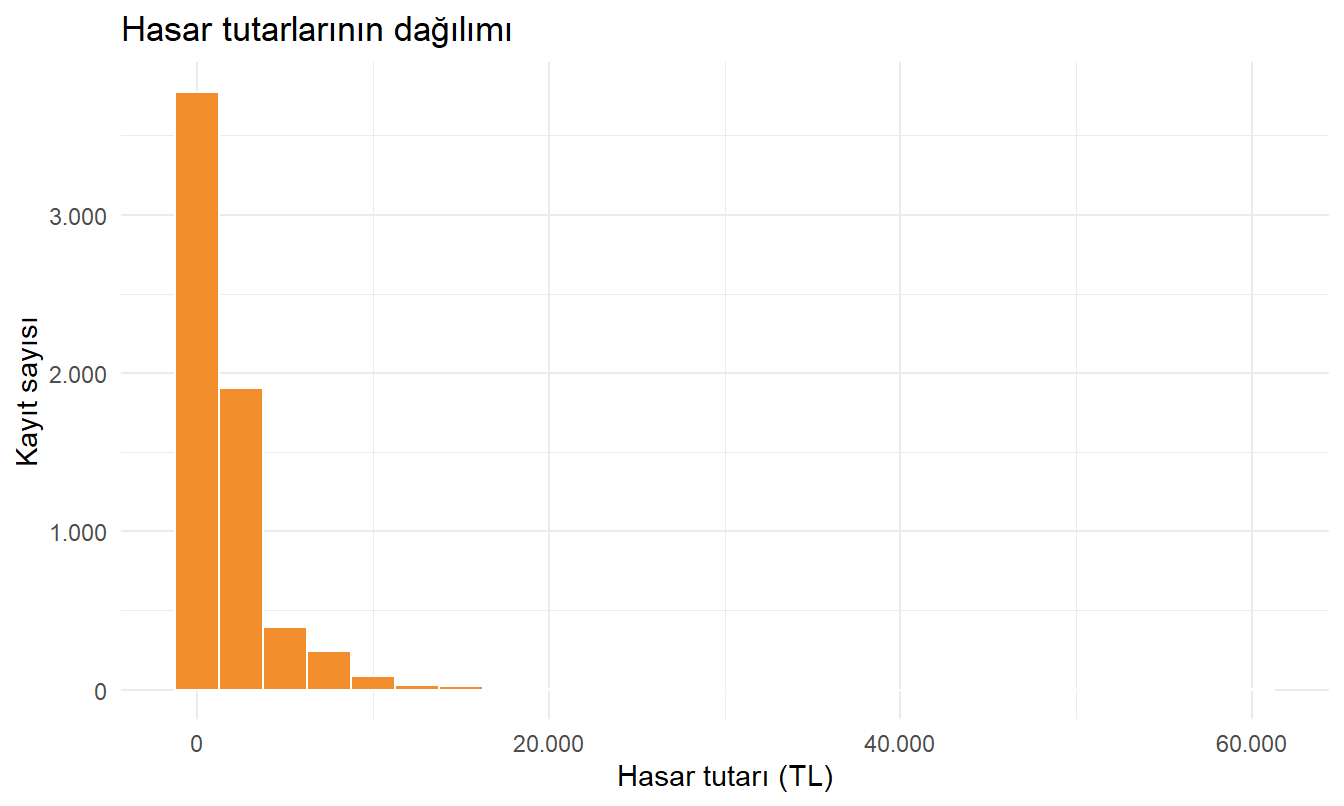
Mekanizma bölümünde genel bakış panelini kurarken katman mantığını gördük; burada aynı mantığı en yalın grafik üzerinde bir kez daha kuruyoruz. Grafiği dört aşamada kuralım; her aşama bir öncekine yeni katmanlar ekler ve sonuncusu yukarıdaki asıl bloğun tamamıdır — çıktısını yukarıdakiyle karşılaştırıp zincirin eksiksiz olduğunu kendiniz görebilirsiniz.
Aşama 1 — veri ve eşleme. ggplot2’de veriyi bildirmek ile bir şey çizmek ayrı işlerdir. ggplot() tek başına yalnızca hangi veriyi kullanacağımızı ve hangi sütunun hangi eksene karşılık geldiğini (aes()) söyler; çalıştırıldığında panel kurulur ama hiçbir şey çizilmez:
ggplot(analiz, aes(x = claim_amount))
Boş panelin yatay ekseni yine de claim_amount’un aralığına göre kurulmuştur: eşleme, hiçbir şey çizilmeden de veriyi tanır. Düşey eksende ise anlamlı bir ölçek yoktur, çünkü “kaç kayıt” sorusunu soran geometri henüz eklenmemiştir.
Aşama 2 — geometri. geom_histogram() veriyi kutucuklara ayırır, her kutucuğa düşen kayıt sayısını sayar ve çubukları çizer; düşey eksen ancak bu aşamada anlam kazanır.
ggplot(analiz, aes(x = claim_amount)) +
  geom_histogram(bins = 25, fill = "#F28E2B", color = "white")
geom_histogram()’in üç argümanı da görünümü doğrudan etkiler:
bins = 25 — veri aralığını 25 eşit kutucuğa böler. Bu sayı bir bulgu değil bir seçimdir: 5 verseydiniz dağılım tek tepe gibi, 200 verseydiniz gürültülü görünürdü. Bu yüzden birkaç değer denemek gerekir.fill = "#F28E2B" — çubukların iç rengi (dersin turuncu tonu).color = "white" — çubuk kenarlarının rengi. Beyaz kenar bitişik çubukları birbirinden ayırır; verilmezse yoğun bölgede tek bir blok görünür.Aşama 3 — etiketler ve sayı biçimi. Yukarıdaki grafiğin ekseni claim_amount gibi ham sütun adını taşıyor, sayıları da 20000 diye ayraçsız yazıyordu. labs() adları okunur Türkçe adlarla, scale_x_continuous() ile scale_y_continuous() katmanları da iki eksenin sayılarını Türkçe biçimle değiştirir:
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 25, fill = "#F28E2B", color = "white") +
scale_x_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
scale_y_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
labs(
title = "Hasar tutarlarının dağılımı",
x = "Hasar tutarı (TL)",
y = "Kayıt sayısı"
)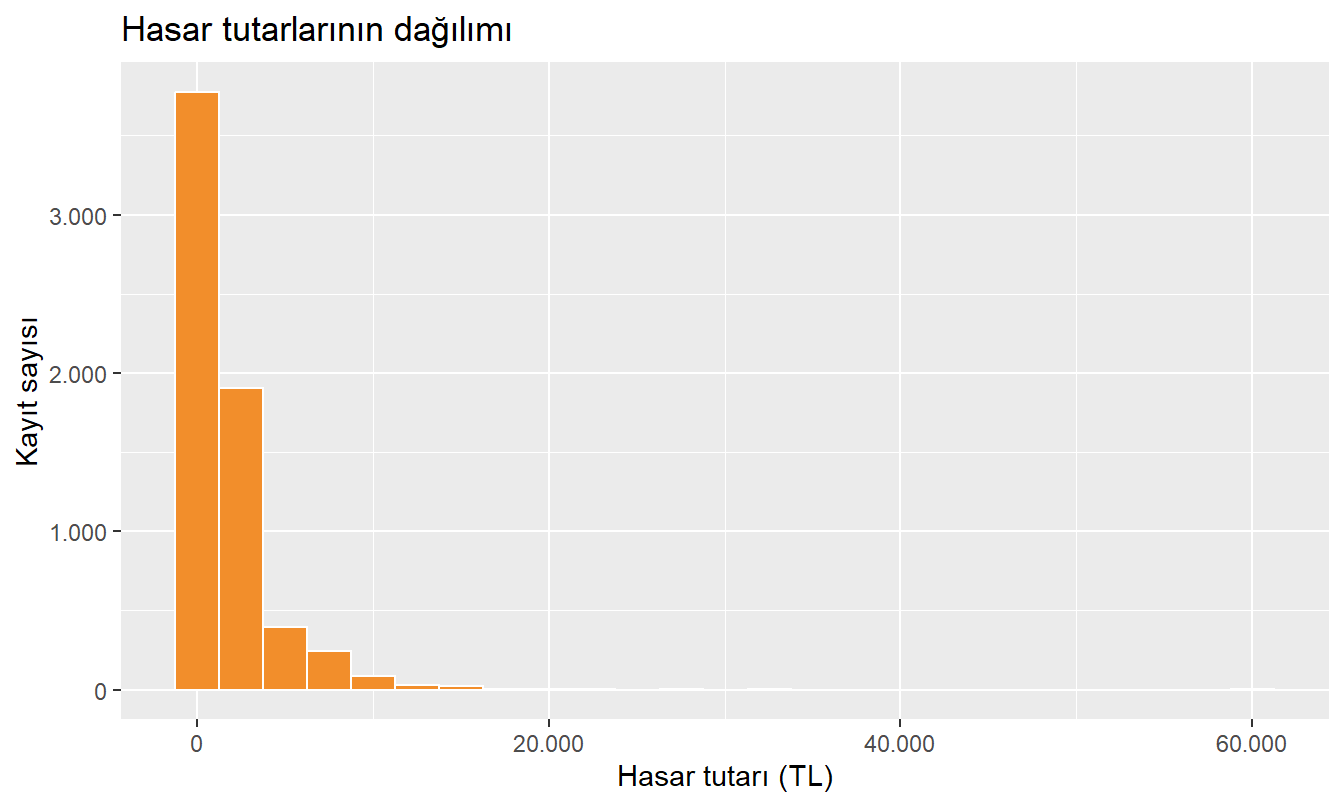
Bu aşamanın argümanları:
labels = label_number(big.mark = ".", decimal.mark = ",") — eksen sayılarının nasıl yazılacağı: binler ayracı nokta, ondalık ayracı virgül; eksen 20000 yerine 20.000, 3000 yerine 3.000 okunur. Verilmezse: sayılar ayraçsız kalır.x = "Hasar tutarı (TL)" — eksen adına birimi de yazar; title grafiğin başlığıdır.Aşama 4 — tema. Son katman theme_minimal(). Tema yalnızca görünümü değiştirir, veriyi değil: gri panel zemini kalkar, ızgara çizgileri incelir.
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 25, fill = "#F28E2B", color = "white") +
scale_x_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
scale_y_continuous(labels = label_number(big.mark = ".", decimal.mark = ",")) +
labs(
title = "Hasar tutarlarının dağılımı",
x = "Hasar tutarı (TL)",
y = "Kayıt sayısı"
) +
theme_minimal()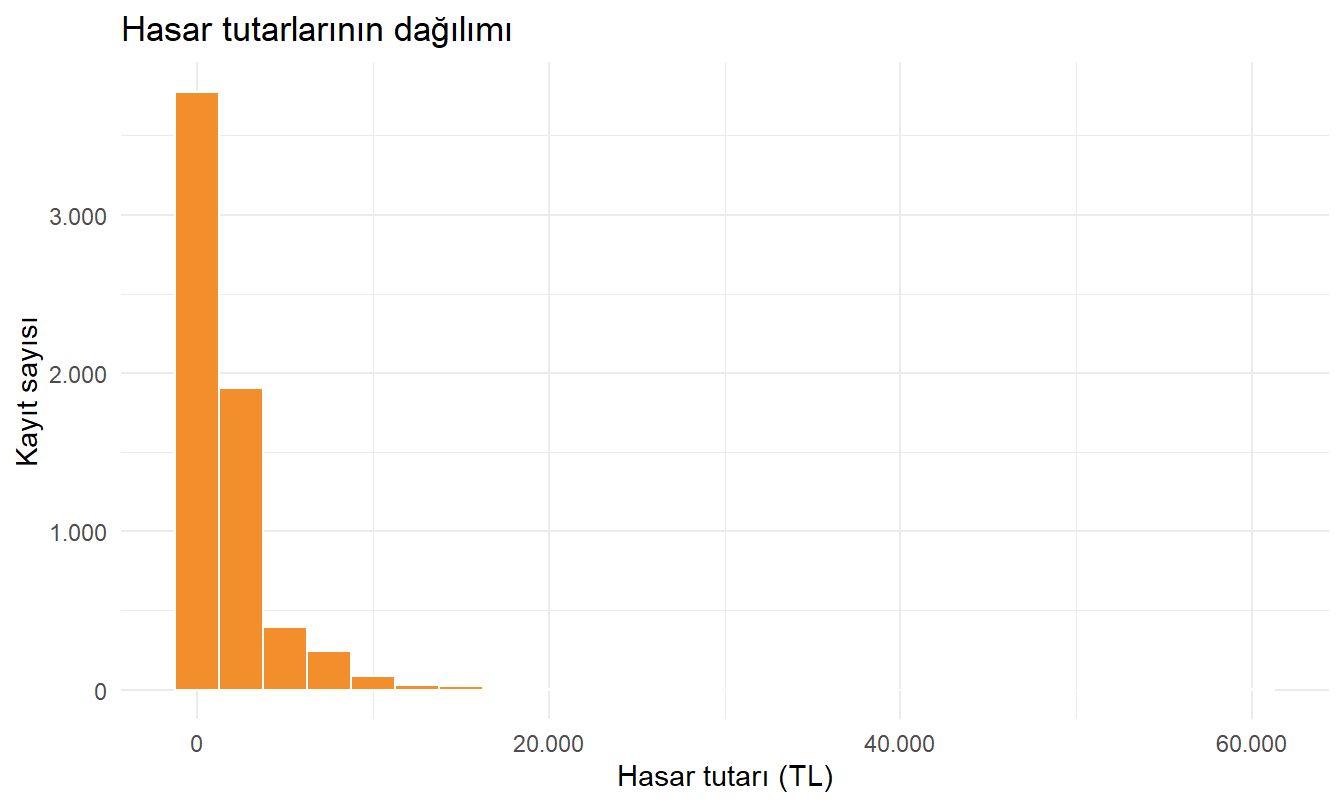
Ders standardı theme_minimal()’dır. theme_bw() ya da theme_classic() de aynı işi başka bir görünümle yapar, ama notlar arasında tutarlılık için tek bir tema kullanılır.
İki not:
bins değeri görünümü etkiler. Birkaç farklı değer deneyin; sonucu yalnızca bir histogram bölümlendirmesine dayandırmayın. Büyük hasarlar nedeniyle sağ kuyruk uzunsa logaritmik eksen yardımcı olabilir, ancak eksen dönüşümü açıkça belirtilmelidir.
Bir şeyi de unutmayın: bu histogramlar 6.348 gözlenen tutarla birlikte \(\delta\) ile atanan 128 tutarı da gösterir. Atanan tutarlar gerçek değil, varsayımımızın ürünüdür; bu tabloda 6.160 TL ile 15.973 TL arasındalar. Gerçekte kaybolan tutarların hepsi en büyük %10’luk dilimdendi.
Aşağıdaki log histogramda bunun izi görünür: 5.431 ile 7.344 TL arasındaki çubuk solundakinden yüksektir, çünkü 224 kaydının 72’si atanan tutardır. Kaydırma her atanan tutarı en az 6.068 TL’ye taşıdığı için atananların çoğu bu aralıkta toplanır; gerçek eksik tutarlar 4.174 TL’den başlıyordu. Çıkıntı verinin değil, varsayımımızın izidir.
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 30, fill = "#2E75B6", colour = "white") +
scale_x_log10(
breaks = c(10, 100, 1000, 10000, 50000),
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
scale_y_continuous(
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
labs(
x = "Hasar tutarı (TL, log10 ölçeği)",
y = "Kayıt sayısı"
) +
theme_minimal(base_size = 12)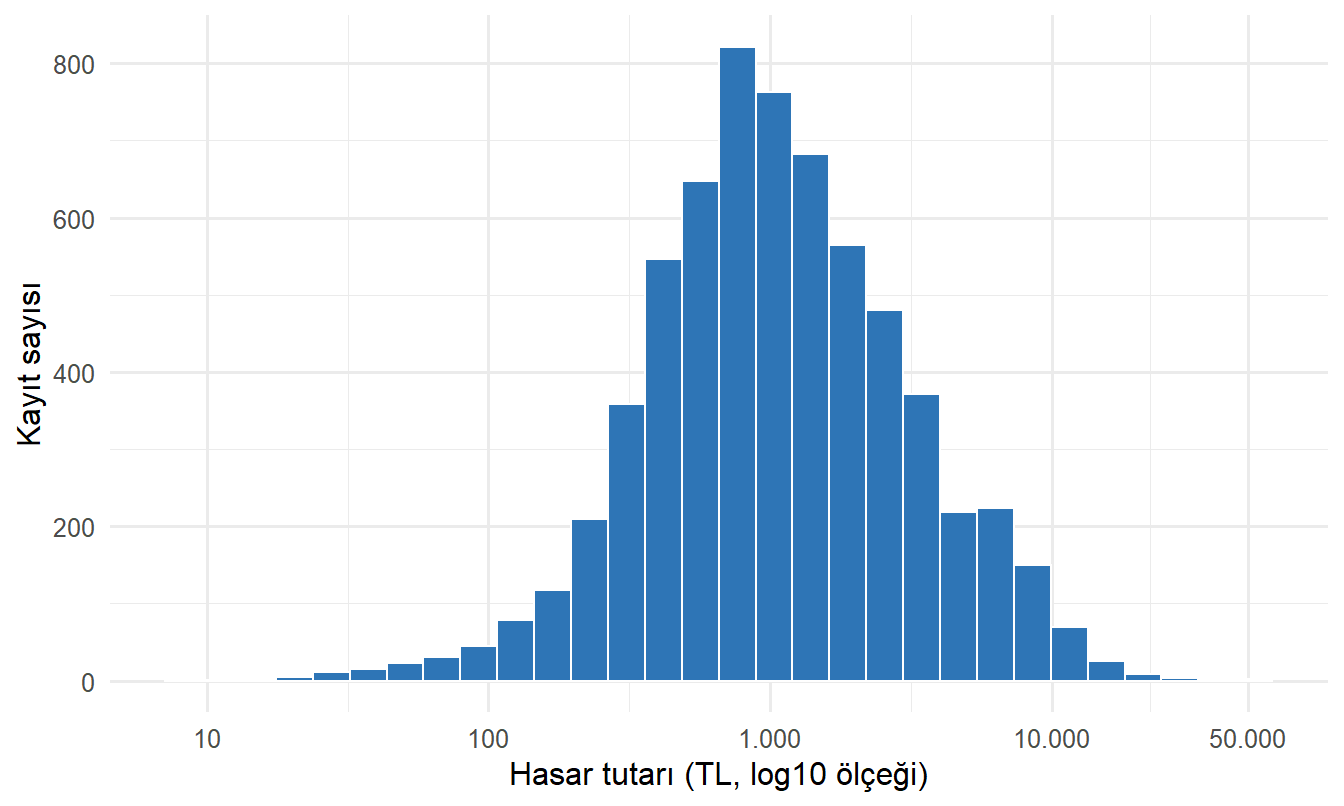
Bu grafiği dört aşamada kuralım; asıl kazanç ikinci aşamadadır, sonuncusu ise yukarıdaki asıl bloğun tamamıdır.
Aşama 1 — doğrusal eksen. Kayıtların %98,3’ü 10.000 TL’nin altında olduğu için neredeyse her şey soldaki birkaç çubukta yığılır ve kuyruk okunamaz:
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 30, fill = "#2E75B6", colour = "white") +
theme_minimal(base_size = 12)
Bu bloğun argümanları:
bins = 30 — aralığı 30 kutucuğa böler.fill — çubuk içinin rengi; colour — çubuk kenarının rengi.base_size = 12 — temanın taban punto boyutu, yani bütün yazılar birden. Büyütülürse eksen adları ve sayılar birlikte büyür; tek tek ayarlanmaları gerekmez.Aşama 2 — log ekseni. Yalnızca scale_x_log10() katmanını ekliyoruz; başka hiçbir şey değişmiyor. Dağılım 1.000 TL dolayında tepe yapan tek tepeli bir yapıya dönüşür ve kuyruk görünür hâle gelir:
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 30, fill = "#2E75B6", colour = "white") +
scale_x_log10(
breaks = c(10, 100, 1000, 10000, 50000),
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
theme_minimal(base_size = 12)
Bu katmanın iki argümanı vardır ve ikisi de eksenin yazısını ayarlar, verisini değil:
breaks = c(10, 100, 1000, 10000, 50000) — eksende hangi değerlerde işaret olacağını söyler. Verilmezse: ggplot2 onluk basamakları kendi seçer ve 10 | 100 | 1000 | 10000 üretir. Okunmaz değildir, ama 50.000 işareti düşer ve eksenin sağ ucu işaretsiz kalır — oysa kuyruğun nereye kadar uzandığı bu haftanın asıl sorusudur.labels = label_number(big.mark = ".", decimal.mark = ",") — o işaretlerin nasıl yazılacağını belirler: big.mark = "." binler basamağını noktayla ayırır, decimal.mark = "," ondalık ayracını virgül yapar. Yani 10000 değil 10.000; dersin Türkçe sayı biçimi kuralının grafikteki karşılığıdır. Verilmezse: sayılar ayraçsız, 10000 biçiminde yazılır.Aşama 3 — eksen adları. Grafiğin eksenleri hâlâ ham sütun adlarını (claim_amount, count) taşıyor. labs() bunları birimleriyle birlikte okunur Türkçe adlara çevirir:
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 30, fill = "#2E75B6", colour = "white") +
scale_x_log10(
breaks = c(10, 100, 1000, 10000, 50000),
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
labs(
x = "Hasar tutarı (TL, log10 ölçeği)",
y = "Kayıt sayısı"
) +
theme_minimal(base_size = 12)
Eksen adında log10 ölçeğinin açıkça anılması bir üslup tercihi değil, bu kutunun sonundaki uyarının gereğidir: dönüşümü görmeyen okur grafiği yanlış okur.
Aşama 4 — düşey eksen biçimi. Son katman scale_y_continuous(), aynı label_number(big.mark = ".", decimal.mark = ",") biçimini düşey eksene de uygular:
ggplot(analiz, aes(x = claim_amount)) +
geom_histogram(bins = 30, fill = "#2E75B6", colour = "white") +
scale_x_log10(
breaks = c(10, 100, 1000, 10000, 50000),
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
scale_y_continuous(
labels = label_number(big.mark = ".", decimal.mark = ",")
) +
labs(
x = "Hasar tutarı (TL, log10 ölçeği)",
y = "Kayıt sayısı"
) +
theme_minimal(base_size = 12)
Bu aşamanın çıktısını bir öncekiyle karşılaştırın: hiçbir fark göremezsiniz.
Görünür bir etkisinin olmaması, aşamayı atlamanın gerekçesi değildir: bu son blok kutunun yukarısındaki kodun birebir aynısıdır ve parçalamanın tamam olduğunu ancak bu karşılaştırma gösterir.
Log ekseninde eşit uzaklıklar eşit oranlara karşılık geldiği için 1.000’den 10.000 TL’ye sıçrama ile 10.000’den 100.000 TL’ye sıçrama aynı genişlikte görünür ve büyük hasarların parasal ağırlığı göz için küçülür. Bu nedenle eksen dönüşümü grafik üzerinde açıkça belirtilmeli ve kuyruğun maliyet payı grafikle değil sayıyla raporlanmalıdır; o sayıyı kutunun hemen altında hesaplıyoruz.
Bir şeyi daha gizler. Sıfırın logaritması tanımsız olduğu için, analiz içinde tuttuğumuz sıfır tutarlı kayıt bu grafikte hiç çizilmez: histogram 6.476 kaydın 6.475’ini gösterir. ggplot2 bunu bir uyarıyla söyler, ama ders sayfasında uyarılar bastırıldığı için ekranda görünmez. Log eksenli her grafikte “kaç kayıt çizildi” sorusunu ayrıca sormak gerekir; sıfırlar ve negatifler sessizce düşer.
Log ekseni büyük hasarların parasal ağırlığını göz için küçültür; kuyruğun toplam tutardaki payını bu yüzden grafikten değil sayıdan okuyoruz. Hesabı analiz tablosunda adım adım yapıyoruz. En büyük %1’lik dilimin eşiği, tutarların %99’unun altında kaldığı değerdir.
esik_99 <- quantile(analiz$claim_amount, 0.99)
esik_99#> 99%
#> 11378.38Eşik 11.378,38 TL. Şimdi bu eşiği aşan kayıtları sayıp toplam tutardaki paylarını hesaplıyoruz.
kuyruk_payi <- c(
kayit = sum(analiz$claim_amount >= esik_99),
toplamdaki_pay = 100 * sum(analiz$claim_amount[analiz$claim_amount >= esik_99]) /
sum(analiz$claim_amount)
)
round(kuyruk_payi, 1)#> kayit toplamdaki_pay
#> 65.0 9.26.476 kaydın 65’i, yani %1’i, toplam tutarın %9,2’sini taşıyor; bu 65 kaydın 3’ü \(\delta\) ile atanmış tutardır.
Log eksende bu kayıtlar 10.000 TL’nin sağında kalan alçak çubuklardadır; çubuğun yüksekliği kayıt sayısını gösterir, tutarı değil.
Bu iki sayının belirsizliği bir önceki bölümün bootstrap’ından gelir, analiz_rapor’un esik_99 ve kuyruk_payi satırlarından: eşiğin standart hatası 418 TL, payınki 0,66 puan; %95’lik aralıklar 10.706–12.426 TL ve %8,2–10,6.
Rapora girecek cümle şudur: en büyük %1’lik dilim, yani en büyük 65 hasar, toplam tutarın yaklaşık %9,2’sini taşır (%95 aralığı %8,2–10,6); bu dilimin eşiği yaklaşık 11.378 TL’dir.
Buraya kadar her şeyi kusurlarını bizim koyduğumuz bir dosyada yaptık: doğru cevabı biliyorduk, çünkü kaybı biz üretmiştik. Laboratuvar bunu tersine çeviriyor.
Burada başka bir dosya var: auto_bi.csv, bedeni zarar sorumluluk hasarları. Eksik değerleri gerçek — kimse bilerek eklemedi, kimse doğrusunu bilmiyor. Yani mekanizmayı bir doğruluk dosyasına bakarak değil, kanıttan tartışacaksınız. Asıl çalışma durumu budur.
Analiz etmeden önce sözlük. AutoBi sütunları tamsayı kodludur ve kodlamayı bilmeden tablo okumak, kendinden emin ve tersine çevrilmiş bir sonuç üretmenin en kısa yoludur.
Kaynak. insuranceData::AutoBi — Insurance Research Council’in 2002 çalışmasındaki kapanmış bedeni zarar hasarlarından, tek bir eyalete ait 1.340 kayıt; insuranceData 1.0 paketi, GPL-2 lisanslı; kopyanın alındığı tarih 1 Eylül 2026. Bir satır bir hasar dosyasıdır. Neyi yanıtlayamaz: dosyada maruziyet de hasarsız poliçe de yoktur; hasar sıklığı ve olasılığı bu dosyadan da hesaplanamaz.
| Sütun | Anlamı | Kodlama |
|---|---|---|
casenum |
Dosya numarası | Tam sayı, benzersiz |
attorney |
Hasarda avukat tutulmuş mu | 1 = evet, 2 = hayır |
clmsex |
Hasar sahibinin cinsiyeti | 1 = erkek, 2 = kadın |
marital |
Medeni durum | 1 = evli, 2 = bekâr, 3 = dul, 4 = boşanmış ya da ayrı yaşıyor |
clminsur |
Hasar sahibinin bulunduğu aracın sürücüsü sigortasız mıydı | 1 = evet (sigortasız), 2 = hayır |
seatbelt |
Emniyet kemeri takılı mıydı | 1 = evet, 2 = hayır |
clmage |
Hasar sahibinin yaşı | Tam yıl |
loss |
Toplam ekonomik kayıp | Bin ABD doları |
1/2 kodlamasında 1’in “evet” olduğuna dikkat edin: çoğu kişi tersini varsayar ve tablo yine de makul görünür.
Dosyayı okuyup yapısına bakın. Yukarıdaki sözlükte sekiz sütun bekliyoruz; glimpse() çıktısında sekizinin de geldiğini doğrulayın.
bi <- read_csv(bi_yolu, show_col_types = FALSE)
glimpse(bi)#> Rows: 1,340
#> Columns: 8
#> $ casenum <dbl> 5, 13, 66, 71, 96, 97, 120, 136, 152, 155, 162, 248, 250, 251…
#> $ attorney <dbl> 1, 2, 2, 1, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1, 2, 2, 2, 1, 2, 1, 1…
#> $ clmsex <dbl> 1, 2, 1, 1, 1, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 2, 2, 1, 1, 2, 1…
#> $ marital <dbl> NA, 2, 2, 1, 4, 1, 2, 2, 2, 2, 1, 1, 2, 1, 1, 2, 1, 1, 2, 4, …
#> $ clminsur <dbl> 2, 1, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 2, 1, 2, 2, 2, 2, N…
#> $ seatbelt <dbl> 1, 1, 1, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
#> $ clmage <dbl> 50, 28, 5, 32, 30, 35, 19, 34, 61, NA, 37, 42, 17, 40, 37, 19…
#> $ loss <dbl> 34.940, 10.892, 0.330, 11.037, 0.138, 0.309, 3.538, 4.882, 0.…Eksiklik profilini çıkarın:
bi_eksiklik <- bi |>
summarise(across(everything(), ~ sum(is.na(.x)))) |>
pivot_longer(cols = everything(), names_to = "degisken", values_to = "eksik_sayi") |>
mutate(oran = round(100 * eksik_sayi / nrow(bi), 2)) |>
arrange(desc(eksik_sayi))
bi_eksiklik#> # A tibble: 8 × 3
#> degisken eksik_sayi oran
#> <chr> <int> <dbl>
#> 1 clmage 189 14.1
#> 2 seatbelt 48 3.58
#> 3 clminsur 41 3.06
#> 4 marital 16 1.19
#> 5 clmsex 12 0.9
#> 6 casenum 0 0
#> 7 attorney 0 0
#> 8 loss 0 0Sonra asıl soruyu sorun — kaç satır tam?
bi_tamlik <- c(
satir = nrow(bi),
tam_vaka = sum(complete.cases(bi)),
eksik_tasiyan = sum(!complete.cases(bi)),
yuzde = round(100 * mean(!complete.cases(bi)), 1)
)
bi_tamlik#> satir tam_vaka eksik_tasiyan yuzde
#> 1340.0 1091.0 249.0 18.6clmage 189 (%14,1), seatbelt 48, clminsur 41, marital 16, clmsex 12 eksik çıkmalı — ama satırların %18,6’sı (1.340’ın 249’u) en az bir eksik taşımalı. Sütun sütun bakan göz dosyayı “çoğunlukla tam” sanır; tam vaka analizi beşte birine yakınını atar.
Notta aynı sınamayı yaptık, ama sonunda cevabı öğrendik, çünkü eksikleri biz oluşturmuştuk. Burada cevabı kimse bilmiyor; yalnızca kanıt toplayabilirsiniz. clmage eksikliğini önce üç değişkenle çaprazlayın, sonra notta olduğu gibi ki-kare testiyle sınayın.
Önce avukat tutulup tutulmadığına göre:
eksik_yas_avukat <- bi |>
group_by(attorney) |>
summarise(kayit = n(), eksik_yas_orani = round(100 * mean(is.na(clmage)), 1),
.groups = "drop")
eksik_yas_avukat#> # A tibble: 2 × 3
#> attorney kayit eksik_yas_orani
#> <dbl> <int> <dbl>
#> 1 1 685 11.4
#> 2 2 655 16.9Sonra cinsiyetin kendisinin eksik olup olmadığına göre:
eksik_yas_cinsiyet <- bi |>
mutate(cinsiyet_eksik = is.na(clmsex)) |>
group_by(cinsiyet_eksik) |>
summarise(kayit = n(), eksik_yas_orani = round(100 * mean(is.na(clmage)), 1),
.groups = "drop")
eksik_yas_cinsiyet#> # A tibble: 2 × 3
#> cinsiyet_eksik kayit eksik_yas_orani
#> <lgl> <int> <dbl>
#> 1 FALSE 1328 13.9
#> 2 TRUE 12 41.7Son olarak kayıp büyüklüğü çeyreğine göre. ntile(loss, 4) kayıp tutarlarının kendisini değil sıralarını böler: satırlar loss’a göre küçükten büyüğe dizilir ve her satır 1 (en küçük kayıplar) ile 4 (en büyükler) arasında bir grup numarası alır. Çıktıdaki kayit sütununa bakın: dört satırda da aynı çıkar. Eşit olan kayıt sayısıdır, tutar aralığı değil:
eksik_yas_ceyrek <- bi |>
mutate(kayip_ceyregi = ntile(loss, 4)) |>
group_by(kayip_ceyregi) |>
summarise(kayit = n(), eksik_yas_orani = round(100 * mean(is.na(clmage)), 1),
.groups = "drop")
eksik_yas_ceyrek#> # A tibble: 4 × 3
#> kayip_ceyregi kayit eksik_yas_orani
#> <int> <int> <dbl>
#> 1 1 335 20
#> 2 2 335 12.8
#> 3 3 335 14
#> 4 4 335 9.6Üç tablo üç ayrı şey söylüyor ve üçünü birlikte yorumlamanız gerekiyor:
Tablolardaki farklar gerçek mi, yoksa şans eseri mi? Notta bu soruyu ki-kare testiyle sorduk; aynı testi burada yapın. Önce sınanacak değişkenleri tek tabloda toplayın: clmage ve kimlik numarası casenum dışında dosyanın bütün değişkenleri, bir de ikinci tablonun eksiklik göstergesi.
bi_gozlenen <- bi |>
transmute(
avukat = attorney,
cinsiyet = clmsex,
medeni_durum = marital,
sigortasiz = clminsur,
kemer = seatbelt,
kayip_ceyregi = ntile(loss, 4),
cinsiyet_eksik = is.na(clmsex)
)
head(bi_gozlenen)#> # A tibble: 6 × 7
#> avukat cinsiyet medeni_durum sigortasiz kemer kayip_ceyregi cinsiyet_eksik
#> <dbl> <dbl> <dbl> <dbl> <dbl> <int> <lgl>
#> 1 1 1 NA 2 1 4 FALSE
#> 2 2 2 2 1 1 4 FALSE
#> 3 2 1 2 2 1 1 FALSE
#> 4 1 1 1 2 2 4 FALSE
#> 5 2 1 4 2 1 1 FALSE
#> 6 1 2 1 2 1 1 FALSEcinsiyet_eksik öbürlerinden farklı türden bir sütun: bir değer değil, bir eksiklik göstergesi. Neden ayrı okunması gerektiğini testlerden sonra göreceğiz.Testi yapan işlev notunkinin aynısıdır; yalnızca bi ve bi_gozlenen üzerinde çalışır. Önce clmage’in eksikliğini sınayalım:
bi_bagimsizlik_testi <- function(eksik_sutun, gozlenen_sutun) {
tablo <- table(bi_gozlenen[[gozlenen_sutun]], is.na(bi[[eksik_sutun]]))
test <- chisq.test(tablo, simulate.p.value = TRUE, B = 10000)
tibble(
eksik = eksik_sutun,
gozlenen = gozlenen_sutun,
kayit = sum(tablo),
ki_kare = test$statistic,
p = test$p.value,
cramer_v = sqrt(test$statistic / sum(tablo))
)
}
set.seed(5115)
bi_bagimsizlik <- bind_rows(
bi_bagimsizlik_testi("clmage", "avukat"),
bi_bagimsizlik_testi("clmage", "cinsiyet"),
bi_bagimsizlik_testi("clmage", "medeni_durum"),
bi_bagimsizlik_testi("clmage", "sigortasiz"),
bi_bagimsizlik_testi("clmage", "kemer"),
bi_bagimsizlik_testi("clmage", "kayip_ceyregi"),
bi_bagimsizlik_testi("clmage", "cinsiyet_eksik")
)
bi_bagimsizlik#> # A tibble: 7 × 6
#> eksik gozlenen kayit ki_kare p cramer_v
#> <chr> <chr> <int> <dbl> <dbl> <dbl>
#> 1 clmage avukat 1340 8.54 0.00420 0.0798
#> 2 clmage cinsiyet 1328 1.19 0.312 0.0299
#> 3 clmage medeni_durum 1324 0.763 0.874 0.0240
#> 4 clmage sigortasiz 1299 1.48 0.263 0.0337
#> 5 clmage kemer 1292 0.414 0.579 0.0179
#> 6 clmage kayip_ceyregi 1340 15.8 0.00110 0.109
#> 7 clmage cinsiyet_eksik 1340 7.59 0.0176 0.0753set.seed(5115) — p değerleri yine benzetimle hesaplanıyor; tohum, aynı kodu çalıştıran herkesin aynı p değerlerini görmesini sağlar.kayit — table() eksik değerleri saymaz. Gözlenen değişkenin kendisi eksik olan dosyalar o testte yer almaz; bu yüzden kayit 1.292 (emniyet kemeri) ile 1.340 arasında değişiyor. Yedi satırı iki grupta okuyun. İlk altı satır yaş eksikliğini gözlenen bir değerle sınıyor ve ikisi bağımsızlığı reddediyor: avukat (p = 0,0042, V = 0,080) ve kayıp çeyreği (p = 0,0011, V = 0,109). İki ilişki de zayıf: notta yaşın sınıfla ilişkisinde V 0,390’dı. Öbür dört değişkenle, yani cinsiyet, medeni durum, sigortasızlık ve emniyet kemeriyle bir ilişki bulunmuyor: p değerleri 0,263 ile 0,874 arasında.
Altı test yaptık; eksiklik hiçbir şeye bağlı olmasa bile birinin şans eseri 0,05’in altına düşmesi şaşırtıcı olmazdı. Ama buradaki iki p değeri 0,005’in de altında. Eksiklik bu altı değişkenin hiçbirine bağlı olmasaydı, altı testten herhangi birinin 0,005’in altına düşme olasılığı en fazla 6 × 0,005 = 0,03 olurdu. İki reddi şansla açıklamak bu yüzden zor: yaş eksikliği MCAR değil.
Yedinci satır başka türden bir soru soruyor. Test burada da bağımsızlığı reddediyor (p = 0,0176): ikinci tablodaki kümelenmeyi de şansla açıklamak zor. Ama bu sonuç MCAR’ı çürütmez. MCAR’ın koşulu, eksikliğin verideki değerlere bağlı olmamasıdır: ne eksik değerin kendisine ne de başka bir sütunun değerine. Hangi alanların birlikte boş kaldığı hakkında bir şey söylemez. Notun MCAR örneğindeki aktarım hatası her seferinde birkaç alanı birden boşaltsaydı, eksiklik kümelenirdi ve yine de MCAR olurdu. Kümelenme bir veri toplama bulgusudur: bazı dosyalarda birçok alan birden boş kalıyor.
MCAR’ı çürüten kanıt, ilk altı satırdaki iki reddir. MAR ile MNAR arasında ise karar veremezsiniz — kayıp çeyreği testi yaşın eksikliğini kayıpla ilişkilendiriyor, oysa yaşın kendisiyle ilişkisini göremiyoruz. Raporunuzda yazmanız gereken cümle şudur: “MCAR değil; MAR varsayımıyla ilerliyoruz ve bu varsayım veriden sınanamaz.”
Dört kategorik sütun. clmsex, marital, clminsur ve seatbelt’in eksikleri az, 12 ile 48 arasında; ama 81 satıra dağılıyorlar. Onların eksikliğini de aynı işlevle sınayalım. Gözlenen tarafta her satırda bilinen iki değişkeni kullanıyoruz, avukatı ve kayıp çeyreğini; yaşın eksikliği tam bu ikisine bağlıydı:
set.seed(5121)
bi_kategorik_bagimsizlik <- bind_rows(
bi_bagimsizlik_testi("clmsex", "avukat"),
bi_bagimsizlik_testi("clmsex", "kayip_ceyregi"),
bi_bagimsizlik_testi("marital", "avukat"),
bi_bagimsizlik_testi("marital", "kayip_ceyregi"),
bi_bagimsizlik_testi("clminsur", "avukat"),
bi_bagimsizlik_testi("clminsur", "kayip_ceyregi"),
bi_bagimsizlik_testi("seatbelt", "avukat"),
bi_bagimsizlik_testi("seatbelt", "kayip_ceyregi")
)
bi_kategorik_bagimsizlik#> # A tibble: 8 × 6
#> eksik gozlenen kayit ki_kare p cramer_v
#> <chr> <chr> <int> <dbl> <dbl> <dbl>
#> 1 clmsex avukat 1340 1.17 0.387 0.0296
#> 2 clmsex kayip_ceyregi 1340 0 1 0
#> 3 marital avukat 1340 0.839 0.451 0.0250
#> 4 marital kayip_ceyregi 1340 7.59 0.0587 0.0753
#> 5 clminsur avukat 1340 0.931 0.343 0.0264
#> 6 clminsur kayip_ceyregi 1340 2.09 0.586 0.0395
#> 7 seatbelt avukat 1340 0.185 0.771 0.0118
#> 8 seatbelt kayip_ceyregi 1340 3.28 0.373 0.0495Sekiz testin hiçbiri bağımsızlığı 0,05 düzeyinde reddetmiyor: p değerleri 0,059 ile 1 arasında, Cramér V en çok 0,075. En küçük p değeri medeni durumla kayıp çeyreği arasında çıkıyor. clmsex ile kayıp çeyreğinin testi tam 0 veriyor: eksik 12 cinsiyet dört çeyreğe üçer üçer dağılmış.
Cümleyi notta olduğu gibi dikkatli kuruyoruz: testler bir desen bulmadı; bu, desen olmadığının kanıtı değildir. Bu dört sütun için veri MCAR ile çelişmiyor. MCAR makul bir çalışma varsayımıdır ve Görev F eksik satırlarını bu varsayımla siler.
clmage üzerinde dört yöntemi karşılaştırın. Notta olduğu gibi standart sapma ve standart hatayı da yazın:
bi_dolu <- bi |>
group_by(attorney) |>
mutate(grup_ici_ortalama = ifelse(is.na(clmage),
mean(clmage, na.rm = TRUE), clmage),
.after = clmage) |>
ungroup() |>
mutate(
silme = clmage,
ortalama_atamasi = ifelse(is.na(clmage), mean(clmage, na.rm = TRUE), clmage),
medyan_atamasi = ifelse(is.na(clmage), median(clmage, na.rm = TRUE), clmage)
)
bi_dolu |>
select(attorney, clmage, silme,
ortalama_atamasi, medyan_atamasi, grup_ici_ortalama)#> # A tibble: 1,340 × 6
#> attorney clmage silme ortalama_atamasi medyan_atamasi grup_ici_ortalama
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 1 50 50 50 50 50
#> 2 2 28 28 28 28 28
#> 3 2 5 5 5 5 5
#> 4 1 32 32 32 32 32
#> 5 2 30 30 30 30 30
#> 6 1 35 35 35 35 35
#> 7 1 19 19 19 19 19
#> 8 1 34 34 34 34 34
#> 9 2 61 61 61 61 61
#> 10 2 NA NA 32.5 31 32.8
#> # ℹ 1,330 more rowsbi_dolu 1.340 satır ve 12 sütun; ekrana sığsın diye yalnızca avukat, yaş ve dört yöntem sütununu basıyoruz. İlk on satırdan yalnızca onuncusunda yaş eksik ve dört yöntem orada ayrışıyor: silme NA bırakıyor, ortalama ataması 32,53, medyan ataması 31, grup içi ortalama ise avukat tutulmayan grubun ortalaması olan 32,82 yazıyor.
Yukarıdaki blok tek bir zincirdir: bi’yi gruplayıp koşullu atamayı kuran, sonra gruplamayı kaldırıp üç yöntem sütununu daha ekleyen boru zinciri. Zincirin her adımını ayrı bir nesneye alıp yazdırdığımızda hangi adımın veriye ne yaptığı görünür.
group_by() hiçbir değeri değiştirmez; tabloya yalnızca bir gruplama başlığı ekler. Çıktının ikinci satırındaki # Groups: attorney [2] tam olarak budur: satır sayısı 1.340’ta, sütun sayısı 8’de kalır, ama tablo artık iki alt gruba bölünmüş sayılır. O tek satır, bir sonraki adımdaki mean() çağrısının neden grubun kendi ortalamasını hesaplayacağının tamamıdır.
bi_gruplu <- bi |>
group_by(attorney)
bi_gruplu#> # A tibble: 1,340 × 8
#> # Groups: attorney [2]
#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 5 1 1 NA 2 1 50 34.9
#> 2 13 2 2 2 1 1 28 10.9
#> 3 66 2 1 2 2 1 5 0.33
#> 4 71 1 1 1 2 2 32 11.0
#> 5 96 2 1 4 2 1 30 0.138
#> 6 97 1 2 1 2 1 35 0.309
#> 7 120 1 1 2 2 1 19 3.54
#> 8 136 1 2 2 2 1 34 4.88
#> 9 152 2 2 2 2 1 61 0.874
#> 10 155 2 1 2 2 1 NA 1.35
#> # ℹ 1,330 more rowsİkinci adım asıl atamayı yapar. ifelse() yalnızca eksik hücreleri değiştirir, gözlenen yaşlara dokunmaz. mean() gruplu tabloda çağrıldığı için avukat tutulan dosyalarda 32,27, tutulmayanlarda 32,82 üretir — yani 189 eksik hücreye tek bir sayı değil, iki sayı yazılır.
Bu adımın iki argümanı var:
na.rm = TRUE — ortalamayı almadan önce eksik hücreleri dışarıda bırakır. Verilmezse: mean() NA döndürür, ifelse() de her eksik hücreye NA yazar; sütun doldurulmuş görünür ama tek bir hücre bile dolmaz — üstelik hata da alınmaz..after = clmage — yeni sütunu clmage’in hemen arkasına koyar. Hesabı değil, yalnızca sütunun yerini değiştirir: sona eklenseydi bu genişlikte ekrana sığmaz, tibble altta yalnızca adını yazardı.bi_atanmis <- bi_gruplu |>
mutate(grup_ici_ortalama = ifelse(is.na(clmage),
mean(clmage, na.rm = TRUE), clmage),
.after = clmage)
bi_atanmis#> # A tibble: 1,340 × 9
#> # Groups: attorney [2]
#> casenum attorney clmsex marital clminsur seatbelt clmage grup_ici_ortalama
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 5 1 1 NA 2 1 50 50
#> 2 13 2 2 2 1 1 28 28
#> 3 66 2 1 2 2 1 5 5
#> 4 71 1 1 1 2 2 32 32
#> 5 96 2 1 4 2 1 30 30
#> 6 97 1 2 1 2 1 35 35
#> 7 120 1 1 2 2 1 19 19
#> 8 136 1 2 2 2 1 34 34
#> 9 152 2 2 2 2 1 61 61
#> 10 155 2 1 2 2 1 NA 32.8
#> # ℹ 1,330 more rows
#> # ℹ 1 more variable: loss <dbl>Çıktıda sütun sayısı 8’den 9’a çıktı; satır sayısı 1.340’ta kaldı — atama satır eklemez, sütun ekler. Yeni sütun clmage’in hemen yanında. Onuncu satıra bakın: yaş eksik ve yeni sütun 32,82 yazıyor, avukat tutulmayan grubun ortalamasını; yaşı gözlenen satırlarda yeni sütun yaşın aynısıdır. Sütuna yazılan iki sayının birbirine ne kadar yakın olduğunu şimdiden not edin — aralarındaki fark yalnızca 0,55 yıl.
Üçüncü adım tek bir şey yapar: gruplama başlığını kaldırır. Çıktıyı bir öncekiyle karşılaştırın — # Groups: satırı dışında hiçbir fark göremezsiniz; ne satırlar ne sütunlar değişir.
bi_gruplamasiz <- bi_atanmis |>
ungroup()
bi_gruplamasiz#> # A tibble: 1,340 × 9
#> casenum attorney clmsex marital clminsur seatbelt clmage grup_ici_ortalama
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 5 1 1 NA 2 1 50 50
#> 2 13 2 2 2 1 1 28 28
#> 3 66 2 1 2 2 1 5 5
#> 4 71 1 1 1 2 2 32 32
#> 5 96 2 1 4 2 1 30 30
#> 6 97 1 2 1 2 1 35 35
#> 7 120 1 1 2 2 1 19 19
#> 8 136 1 2 2 2 1 34 34
#> 9 152 2 2 2 2 1 61 61
#> 10 155 2 1 2 2 1 NA 32.8
#> # ℹ 1,330 more rows
#> # ℹ 1 more variable: loss <dbl>Çıktıdaki etkisi tek bir satır olsa da bu adım atlanamaz: ungroup() yazılmazsa dördüncü adımdaki mean() ve median() çağrıları da grup içinde hesaplanır. ortalama_atamasi sütunu grup_ici_ortalama ile birebir aynı olur (ikisi de 32,5398), medyan_atamasi da 32,3149 yerine 32,3978 yazar. Sondaki tablo o zaman iki yöntemi değil, aynı yöntemi kendisiyle karşılaştırır ve haftanın dersi tek bir eksik satırda kaybolur.
Son adım üç sütun daha ekler: silme, clmage’in kopyasıdır ve eksiklerini korur — 189 NA yerinde durur; ortalama_atamasi ile medyan_atamasi ise gruplama kalktığı için tek bir genel değerle doldurur, sırasıyla 32,53 ve 31.
bi_dolu <- bi_gruplamasiz |>
mutate(
silme = clmage,
ortalama_atamasi = ifelse(is.na(clmage), mean(clmage, na.rm = TRUE), clmage),
medyan_atamasi = ifelse(is.na(clmage), median(clmage, na.rm = TRUE), clmage)
)
bi_dolu |>
select(attorney, clmage, silme,
ortalama_atamasi, medyan_atamasi, grup_ici_ortalama)#> # A tibble: 1,340 × 6
#> attorney clmage silme ortalama_atamasi medyan_atamasi grup_ici_ortalama
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 1 50 50 50 50 50
#> 2 2 28 28 28 28 28
#> 3 2 5 5 5 5 5
#> 4 1 32 32 32 32 32
#> 5 2 30 30 30 30 30
#> 6 1 35 35 35 35 35
#> 7 1 19 19 19 19 19
#> 8 1 34 34 34 34 34
#> 9 2 61 61 61 61 61
#> 10 2 NA NA 32.5 31 32.8
#> # ℹ 1,330 more rowsBu son adımın çıktısı kutunun yukarısındaki bloğun çıktısıyla birebir aynıdır; parçalamanın eksiksiz olduğunu bu karşılaştırma gösterir. İkisi de 12 sütunun ekrana sığan altısını basar: avukatı, yaşı ve dört yöntem sütununu.
Geriye karşılaştırma tablosu kalıyor: her sütunu dört sayıya indiren bi_ozet() ve dördünü tek tabloda toplayan rbind().
bi_ozet <- function(x) {
x <- x[!is.na(x)]
c(n = length(x), ortalama = mean(x), std_sapma = sd(x), std_hata = sd(x) / sqrt(length(x)))
}
bi_karsilastirma <- rbind(
silme = bi_ozet(bi_dolu$silme),
ortalama_atamasi = bi_ozet(bi_dolu$ortalama_atamasi),
medyan_atamasi = bi_ozet(bi_dolu$medyan_atamasi),
grup_ici_ortalama = bi_ozet(bi_dolu$grup_ici_ortalama)
)
round(bi_karsilastirma, 4)#> n ortalama std_sapma std_hata
#> silme 1151 32.5308 17.0885 0.5037
#> ortalama_atamasi 1340 32.5308 15.8367 0.4326
#> medyan_atamasi 1340 32.3149 15.8456 0.4329
#> grup_ici_ortalama 1340 32.5398 15.8370 0.4326Silme yöntemini fiilen uygulayan satır, gözden kaçması en kolay satırdır: bi_ozet() içindeki x <- x[!is.na(x)]. Silme ayrı bir işlem değildir; eksiklerini taşımaya devam eden bir sütunu özetlerken onların düşmesidir. n sütununun ilk satırda 1.151, diğer üçünde 1.340 olmasının nedeni budur — ve std_hata = sd(x) / sqrt(length(x)) bu n’yi kullandığı için, atama yaptığınız anda standart hata hiçbir yeni bilgi girmeden küçülür.
Tablonun okunabilirliğini belirleyen argüman ise sondaki yuvarlamadır:
4 (round()’ın ikinci argümanı) — özet tablosunu dört ondalık basamağa yuvarlar. Verilmezse: round() sıfır basamağa yuvarlar; ortalama_atamasi ile grup_ici_ortalama satırlarının ikisi de 33 olur ve tablonun göstermek için var olduğu fark — binde dokuzluk fark — tamamen kaybolur. Burada notunkinden farklı bir sonuç çıkıyor ve fark öğreticidir. Notta grup içi atama yanlılığı tamamen gidermişti; burada ortalamayı neredeyse hiç oynatmıyor (32,53 → 32,54), çünkü attorney yaşla zayıf ilişkili. Atamada kullanılan değişken yaşla zayıf ilişkiliyse grup içi atama da neredeyse hiçbir şey değiştirmez — teknik aynı, sonuç değil.
Şimdi kategorik sütunlarda modu deneyin — ikisini birden.
mod_etkisi <- function(x) {
sayim <- table(x)
mod <- as.integer(names(sayim)[which.max(sayim)])
c(eksik = sum(is.na(x)),
mod = mod,
once = 100 * max(sayim) / sum(sayim),
sonra = 100 * max(table(ifelse(is.na(x), mod, x))) / length(x))
}
mod_karsilastirma <- round(rbind(seatbelt = mod_etkisi(bi$seatbelt),
marital = mod_etkisi(bi$marital)), 2)
mod_karsilastirma#> eksik mod once sonra
#> seatbelt 48 1 98.30 98.36
#> marital 16 2 49.09 49.70Modu bulan satırda dikkat edilecek çağrı as.integer():
names(sayim)[which.max(sayim)] — en sık düzeyin adını metin olarak verir.as.integer(...) — o metni tamsayıya çevirir. Yazılmasaydı c() içindeki bütün değerler metne dönüşür ve ardından gelen round() çağrısı non-numeric argument to mathematical function hatasıyla dururdu.Mod atamasında da öyle: seatbelt zaten %98,3 tek düzey, doldurmak payı 0,1 puan oynatıyor; marital %49,1’den %49,7’ye çıkıyor. İkisi de küçük, çünkü eksik sayısı az. “Fark etmez” bir tahmin değil, bir ölçümdür — ve ancak ölçerek bilinir.
mice ile çoklu atamaAynı çoklu atamayı bu dosyaya uygulayın. Kimlik sütununu yordayıcı matristen çıkarmayı unutmayın:
bi_atama_verisi <- bi |>
mutate(across(c("attorney", "clmsex", "marital", "clminsur", "seatbelt"), factor))
bi_atama_verisi#> # A tibble: 1,340 × 8
#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> <dbl> <fct> <fct> <fct> <fct> <fct> <dbl> <dbl>
#> 1 5 1 1 <NA> 2 1 50 34.9
#> 2 13 2 2 2 1 1 28 10.9
#> 3 66 2 1 2 2 1 5 0.33
#> 4 71 1 1 1 2 2 32 11.0
#> 5 96 2 1 4 2 1 30 0.138
#> 6 97 1 2 1 2 1 35 0.309
#> 7 120 1 1 2 2 1 19 3.54
#> 8 136 1 2 2 2 1 34 4.88
#> 9 152 2 2 2 2 1 61 0.874
#> 10 155 2 1 2 2 1 NA 1.35
#> # ℹ 1,330 more rowsBu adım bi’ye satır ya da sütun eklemez; yalnızca tamsayı kodlu risk sütunlarını factor’a çevirir. Çıktıda başlıkların altındaki tip satırına bakın: çevrilen sütunlar artık <fct> görünüyor, casenum, clmage ve loss ise sayısal kalıyor. Bu çevirme bir karardır — Görev A’daki sözlükte yalnızca etiket olan kodların atama modelinde büyüklük gibi okunmasını engeller.
Sırada yordayıcı matris var: hangi sütunun hangi sütunu yordamakta kullanılacağını taşıyan tablo.
bi_kalip <- mice::make.predictorMatrix(bi_atama_verisi)
bi_kalip[, "casenum"] <- 0
bi_kalip["casenum", ] <- 0
bi_kalip#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> casenum 0 0 0 0 0 0 0 0
#> attorney 0 0 1 1 1 1 1 1
#> clmsex 0 1 0 1 1 1 1 1
#> marital 0 1 1 0 1 1 1 1
#> clminsur 0 1 1 1 0 1 1 1
#> seatbelt 0 1 1 1 1 0 1 1
#> clmage 0 1 1 1 1 1 0 1
#> loss 0 1 1 1 1 1 1 0Matris kurulduktan sonraki iki satır onu değiştirir; çıktıda ikisinin etkisi birlikte görünür: casenum’un hem satırı hem sütunu baştan sona sıfırlanmış, diğer sütunlar ise birbirini yordamayı sürdürüyor. Hangi indisin neyi kapattığını notun Kimlik sütunu yordayıcı olamaz kutusunda ayrıntılandırmıştık.
Son nesne atamanın kendisi. mice() argümanlarının gerekçeleri notta tek tek verilmişti; burada değişen yalnızca veri ile yordayıcı matris. bi_imp$method çıktısında bakılacak şey, yöntem atanan sütunların Görev A’da eksik bulduğumuz sütunlarla örtüşüp örtüşmediğidir.
bi_imp <- mice::mice(bi_atama_verisi, m = 5, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip, seed = 5109, printFlag = FALSE)
bi_imp$method#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> "" "" "pmm" "pmm" "pmm" "pmm" "pmm" ""Önce havuzlayın:
bi_havuz <- summary(mice::pool(with(bi_imp, lm(clmage ~ 1))))
bi_havuz#> term estimate std.error statistic df p.value
#> 1 (Intercept) 32.55851 0.5235385 62.18933 87.6132 2.832528e-74bi_havuz, havuzlanmış sonuçların özet tablosudur. lm(clmage ~ 1) yalnızca sabit terim içerdiğinden okunacak satır o terimin satırıdır: estimate sütunu havuzlanmış ortalamayı, std.error sütunu Rubin kurallarıyla birleştirilmiş standart hatayı taşır; tablodaki diğer sütunlar bu haftanın sorusuna yanıt vermez.
Aynı iki değeri tam vaka standart hatasıyla birlikte adlandırılmış tek bir vektörde toplayın. Çıktıda mice_std_hata ile tam_vaka_std_hata öğelerini yan yana okuyoruz.
bi_havuz_ozeti <- round(c(
mice_ortalama = bi_havuz$estimate[1],
mice_std_hata = bi_havuz$std.error[1],
tam_vaka_std_hata = sd(bi$clmage, na.rm = TRUE) / sqrt(sum(!is.na(bi$clmage)))
), 4)
bi_havuz_ozeti#> mice_ortalama mice_std_hata tam_vaka_std_hata
#> 32.5585 0.5235 0.5037mice 32,5585 veriyor, standart hatası 0,5235; tam vakanınki 0,5037. Havuzlanmış hata yine tam vakanınkinden büyük: attorney gibi zayıf yordayıcılar eksik yaşlar hakkında neredeyse hiç bilgi taşımadığı için çoklu atama tam vakadan daha kesin olamıyor, havuzlama da bu bilgisizliği gizlemiyor. 189 yaşı bilmiyoruz.
mice_ortalama ile mice_std_hata sayfanın çalıştığı mice sürümüne bağlıdır. Betiği kendi bilgisayarınızda çalıştırdıysanız sizinkine bakın:
packageVersion("mice")#> [1] '3.17.0'Sayfa 3.17.0 ile çalıştı. Sürümünüz farklıysa bu iki değer buradakilerden ayrılabilir: notta gördüğümüz gibi mice faktör sütunlarının pmm ile atanma yolunu 3.17.0’da değiştirdi, ve bu dosyada eksiği olan dört sütun (clmsex, marital, clminsur, seatbelt) faktör. tam_vaka_std_hata ise mice’tan geçmez; herkeste 0,5037 çıkar.
Notta yaptığımız gibi mice’ın eksik yaşlara ne yazdığını Görev C’nin yöntemleriyle yan yana koyun:
bi_dolu_mice <- bi_dolu |>
mutate(
mice_1 = mice::complete(bi_imp, 1)$clmage,
mice_2 = mice::complete(bi_imp, 2)$clmage,
mice_3 = mice::complete(bi_imp, 3)$clmage,
mice_4 = mice::complete(bi_imp, 4)$clmage,
mice_5 = mice::complete(bi_imp, 5)$clmage
)
bi_dolu_mice |>
filter(is.na(clmage)) |>
select(attorney, grup_ici_ortalama, mice_1:mice_5)#> # A tibble: 189 × 7
#> attorney grup_ici_ortalama mice_1 mice_2 mice_3 mice_4 mice_5
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 2 32.8 18 18 19 27 18
#> 2 1 32.3 18 25 5 5 17
#> 3 2 32.8 29 17 19 3 18
#> 4 2 32.8 26 37 23 23 29
#> 5 1 32.3 17 28 5 10 5
#> 6 2 32.8 32 48 27 41 0
#> 7 2 32.8 1 10 32 36 16
#> 8 2 32.8 49 48 18 41 50
#> 9 2 32.8 50 27 53 50 37
#> 10 2 32.8 36 40 39 36 63
#> # ℹ 179 more rowsEkrana yaşı eksik 189 satırın ilk onu geliyor. Grup içi ortalama avukat tutulan satırlara 32,3, tutulmayanlara 32,8 yazıyor. mice aynı satıra her sette başka bir yaş yazıyor; ilk satıra 18, 18, 19, 27 ve 18. Yazılanlar dosyada gözlenmiş yaşlardır: ilk on satırda 0 ile 63 arasında.
Her yöntemin eksik hücrelere kaç farklı değer yazdığını sayın:
bi_farkli_deger <- bi_dolu_mice |>
filter(is.na(clmage)) |>
summarise(across(c(ortalama_atamasi, medyan_atamasi, grup_ici_ortalama, mice_1:mice_5),
n_distinct)) |>
pivot_longer(everything(), names_to = "yontem", values_to = "farkli_deger")
bi_farkli_deger#> # A tibble: 8 × 2
#> yontem farkli_deger
#> <chr> <int>
#> 1 ortalama_atamasi 1
#> 2 medyan_atamasi 1
#> 3 grup_ici_ortalama 2
#> 4 mice_1 35
#> 5 mice_2 41
#> 6 mice_3 54
#> 7 mice_4 49
#> 8 mice_5 52Ortalama ve medyan ataması 189 hücreye tek bir değer, grup içi ortalama iki değer yazıyor: avukat değişkeninin iki düzeyi var ve iki ortalama arasında yalnızca 0,55 yaş var. mice’ın setleri 35 ile 54 arasında farklı yaş yazıyor.
Notta grup içi ortalama 18 değer yazıyordu ve yaşın eksikliğini yaratan sınıfı taşıyordu; burada yalnızca iki ve birbirine çok yakın değer var. Görev C’de grup içi atamanın ortalamayı neden neredeyse hiç oynatmadığı bu tabloda görünüyor.
Raporda bu beş sütundan biri seçilmez, ortalaması da alınmaz. Notta yaş için yaptığımız karşılaştırmayı burada yapın: havuzlamayı hücre ortalamasıyla karşılaştırın.
bi_tek_sonuc <- rbind(
havuzlama = c(ortalama = bi_havuz$estimate[1], std_hata = bi_havuz$std.error[1]),
hucre_ortalamasi = bi_ozet(rowMeans(bi_dolu_mice[paste0("mice_", 1:5)]))[c("ortalama", "std_hata")]
)
round(bi_tek_sonuc, 4)#> ortalama std_hata
#> havuzlama 32.5585 0.5235
#> hucre_ortalamasi 32.5585 0.4497Ortalama ikisinde de 32,5585; standart hata havuzlamada 0,5235, hücre ortalamasında 0,4497, yani %14 küçük. Hücre ortalaması tek atamadır ve bilmediğimiz 189 yaşı biliyormuş gibi davranır.
Görev B’de yaşın eksikliği iki gözlenen sütunla ilişkili çıktı: avukat ve kayıp. bi_kalip ise yaşı öbür bütün sütunlarla yordatıyor. Atamayı yalnızca bu iki sütunla yapsaydık sonuç değişir miydi? bi_kalip’in yaş satırını değiştirin:
bi_kalip_iki <- bi_kalip
bi_kalip_iki["clmage", ] <- 0
bi_kalip_iki["clmage", c("attorney", "loss")] <- 1
bi_kalip_iki#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> casenum 0 0 0 0 0 0 0 0
#> attorney 0 0 1 1 1 1 1 1
#> clmsex 0 1 0 1 1 1 1 1
#> marital 0 1 1 0 1 1 1 1
#> clminsur 0 1 1 1 0 1 1 1
#> seatbelt 0 1 1 1 1 0 1 1
#> clmage 0 1 0 0 0 0 0 1
#> loss 0 1 1 1 1 1 1 0Sonra aynı atamayı aynı tohumla yeniden yapın; böylece iki atama arasında değişen tek şey yordayıcı matrisi olur:
bi_imp_iki <- mice::mice(bi_atama_verisi, m = 5, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip_iki, seed = 5109, printFlag = FALSE)
bi_imp_iki$predictorMatrix["clmage", ]#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> 0 1 0 0 0 0 0 1Çıktı, yaşın artık yalnızca attorney ve loss ile yordandığını gösterir. Kayıp çok çarpık bir sütundur: medyanı 2,3, en büyüğü 1.067,7. Doğrusal bir modelde birkaç büyük kayıp tahmini sürükleyebilir; bunu sınamak için kaybın logunu kullanan bir atama daha kurun. bi_atama_verisi_log’da loss’un yerini log_kayip alıyor:
bi_atama_verisi_log <- bi_atama_verisi |>
mutate(log_kayip = log(loss)) |>
select(-loss)
bi_atama_verisi_log#> # A tibble: 1,340 × 8
#> casenum attorney clmsex marital clminsur seatbelt clmage log_kayip
#> <dbl> <fct> <fct> <fct> <fct> <fct> <dbl> <dbl>
#> 1 5 1 1 <NA> 2 1 50 3.55
#> 2 13 2 2 2 1 1 28 2.39
#> 3 66 2 1 2 2 1 5 -1.11
#> 4 71 1 1 1 2 2 32 2.40
#> 5 96 2 1 4 2 1 30 -1.98
#> 6 97 1 2 1 2 1 35 -1.17
#> 7 120 1 1 2 2 1 19 1.26
#> 8 136 1 2 2 2 1 34 1.59
#> 9 152 2 2 2 2 1 61 -0.135
#> 10 155 2 1 2 2 1 NA 0.301
#> # ℹ 1,330 more rowsselect(-loss) — sütun adının önündeki eksi o sütunu tablodan çıkarır; veride kaybın tek bir biçimi, logu kalır.Yordayıcı matrisi bu veriye göre kurun; yaş satırında yalnızca attorney ve log_kayip kalsın:
bi_kalip_log <- mice::make.predictorMatrix(bi_atama_verisi_log)
bi_kalip_log[, "casenum"] <- 0
bi_kalip_log["casenum", ] <- 0
bi_kalip_log["clmage", ] <- 0
bi_kalip_log["clmage", c("attorney", "log_kayip")] <- 1
bi_kalip_log#> casenum attorney clmsex marital clminsur seatbelt clmage log_kayip
#> casenum 0 0 0 0 0 0 0 0
#> attorney 0 0 1 1 1 1 1 1
#> clmsex 0 1 0 1 1 1 1 1
#> marital 0 1 1 0 1 1 1 1
#> clminsur 0 1 1 1 0 1 1 1
#> seatbelt 0 1 1 1 1 0 1 1
#> clmage 0 1 0 0 0 0 0 1
#> log_kayip 0 1 1 1 1 1 1 0Atamayı yine aynı tohumla yapın:
bi_imp_log <- mice::mice(bi_atama_verisi_log, m = 5, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip_log, seed = 5109, printFlag = FALSE)
bi_imp_log$predictorMatrix["clmage", ]#> casenum attorney clmsex marital clminsur seatbelt clmage log_kayip
#> 0 1 0 0 0 0 0 1Üç atamayı havuzlayıp yan yana koyun:
bi_havuzla <- function(imp) {
h <- mice::pool(with(imp, lm(clmage ~ 1)))$pooled
c(ortalama = h$estimate, std_hata = sqrt(h$t), b = h$b)
}
bi_yordayici_karsilastirma <- rbind(
butun_sutunlar = bi_havuzla(bi_imp),
avukat_kayip = bi_havuzla(bi_imp_iki),
avukat_log_kayip = bi_havuzla(bi_imp_log)
)
round(bi_yordayici_karsilastirma, 4)#> ortalama std_hata b
#> butun_sutunlar 32.5585 0.5235 0.0468
#> avukat_kayip 32.3479 0.9119 0.5086
#> avukat_log_kayip 32.3434 0.6957 0.2196Yalnızca avukat ve kayıpla atama ortalamayı 32,56’dan 32,35’e çekiyor ve standart hatayı 0,52’den 0,91’e çıkarıyor; setler arası fark \(B\) on katından fazla büyüyor.
Kaybın logu \(B\)’yi yarıdan fazla düşürüyor ve standart hatayı 0,70’e indiriyor, ama ortalamayı değiştirmiyor: 32,34. Çarpıklık standart hatanın bir kısmını açıklıyor, ortalamadaki kaymayı açıklamıyor.
bi_havuzla() — notun yas_havuzla()’sının buradaki eşi: bir atamanın havuzlanmış ortalamasını, standart hatasını ve \(B\)’sini verir.Dışarıda kalan sütunların yaş hakkında ne taşıdığına bakın:
bi_r2 <- c(
avukat_kayip = summary(lm(clmage ~ attorney + loss, data = bi_atama_verisi))$r.squared,
avukat_log_kayip = summary(lm(clmage ~ attorney + log_kayip, data = bi_atama_verisi_log))$r.squared,
butun_sutunlar = summary(lm(clmage ~ attorney + clmsex + marital + clminsur + seatbelt + loss,
data = bi_atama_verisi))$r.squared
)
round(bi_r2, 4)#> avukat_kayip avukat_log_kayip butun_sutunlar
#> 0.0053 0.0472 0.3408Avukat ve kayıp yaşın varyansının yalnızca %0,5’ini, kaybın loguyla %4,7’sini açıklıyor; bütün sütunlar %34,1’ini. Kalan dört sütunu — cinsiyet, medeni durum, sigortasızlık ve emniyet kemeri — Görev B de sınamıştı ve yaşın eksikliğiyle ilişkili bulmamıştı: p değerleri 0,263 ile 0,874 arasındaydı. Onlar yaşın eksik olup olmamasıyla değil, değeriyle ilişkili.
Atama modeli iki türden sütunu da ister. Eksikliği açıklayanlar yanlılığı önlemek için gerekir: ki-kare onları bulur. Değeri açıklayanlar eksik hücreye doğru komşuyu bulmak için gerekir: ki-kare onları göremez. Hangi ortalamanın doğru olduğunu burada bilemeyiz, çünkü gerçek yaşlar elimizde değil; notta gerçeği bildiğimiz için ölçebilmiştik.
Karar: tek atama ve bootstrap. Notun Tek değerle çalışmak bölümündeki kararı burada da uygulayın: Görev F ve G tabloyu bir kez doldurur, standart hatayı bootstrap’tan alır. Önce ortalama yaş üzerinde deneyin. Tabloyu bir kez doldurun:
bi_tek_tablo <- mice::complete(mice::mice(bi_atama_verisi, m = 1, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip, seed = 5126, printFlag = FALSE))
round(bi_ozet(bi_tek_tablo$clmage), 4)#> n ortalama std_sapma std_hata
#> 1340.0000 32.6134 17.0025 0.4645Ortalama yaş 32,6134, tablonun kendi standart hatası 0,4645. Şimdi standart hatayı bootstrap’tan alın: 100 örnek çekin, her birini yeniden doldurun ve ortalama yaşı kaydedin.
set.seed(5127)
bi_bootstrap_ortalamalar <- sapply(1:100, function(b) {
ornek <- bi_atama_verisi[sample(nrow(bi_atama_verisi), replace = TRUE), ]
doldurulmus <- mice::complete(mice::mice(ornek, m = 1, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip, printFlag = FALSE))
mean(doldurulmus$clmage)
})
round(head(bi_bootstrap_ortalamalar, 10), 3)#> [1] 33.506 32.606 32.587 32.264 33.053 32.667 33.207 32.951 32.555 33.197Üç yolu yan yana koyun:
bi_tek_deger <- rbind(
tek_tablo_kendi_hatasi = c(ortalama = mean(bi_tek_tablo$clmage),
std_hata = bi_ozet(bi_tek_tablo$clmage)[["std_hata"]]),
tek_tablo_bootstrap = c(ortalama = mean(bi_tek_tablo$clmage),
std_hata = sd(bi_bootstrap_ortalamalar)),
mice_havuzlama = c(ortalama = bi_havuz$estimate[1], std_hata = bi_havuz$std.error[1])
)
round(bi_tek_deger, 4)#> ortalama std_hata
#> tek_tablo_kendi_hatasi 32.6134 0.4645
#> tek_tablo_bootstrap 32.6134 0.6469
#> mice_havuzlama 32.5585 0.5235Bootstrap standart hatası 0,6469: tablonun kendi hatasından (0,4645) de, mice’ın havuzlanmış hatasından (0,5235) da büyük. Notta bootstrap ile havuzlama aynı büyüklükteydi; burada fark belirgin. Tek atama tek bir çekilişe dayandığı için beş atamadan daha az kesindir ve bu kayıp standart hataya girer. Bedeli budur; karşılığında her hücrede tek bir değer vardır. Görev F ve G bu yolu izler.
Bu dosyada kimlik hazır geliyor: casenum. Önce profili, sonra sayaçları kurun:
bi_profil <- setdiff(names(bi), "casenum")
bi_profil#> [1] "attorney" "clmsex" "marital" "clminsur" "seatbelt" "clmage" "loss"bi_profil, kimlik sütunu dışarıda bırakıldığında geriye kalan sütun adlarını tutar; çıktıda casenum adının bu listede yer almadığını görürüz. Sayaçların sonuncusu satırları yalnızca bu adlar üzerinden karşılaştıracak.
bi_yinelenme <- c(
satir = nrow(bi),
benzersiz_kimlik = length(unique(bi$casenum)),
yinelenen_satir = sum(duplicated(bi)),
yinelenen_kimlik = sum(duplicated(bi$casenum)),
yinelenen_profil = sum(duplicated(bi[bi_profil]))
)
bi_yinelenme#> satir benzersiz_kimlik yinelenen_satir yinelenen_kimlik
#> 1340 1340 0 0
#> yinelenen_profil
#> 13casenum 1.340 kayıt için 1.340 farklı değer taşıyor, tam yinelenen satır yok, ama anahtar dışında birebir aynı 13 satır var. Bu, notta öğrendiğiniz üçüncü durumun ta kendisidir — bu kez öğretim için eklenmiş değil, gerçek veride kendiliğinden.
Temizleme günlüğünüze şu dört satırı yazın: Sorun (13 kayıt profilde aynı, kimlikte farklı), Kanıt (yukarıdaki üç sayaç), Uygulanan işlem (korundu), Gerekçe (farklı casenum, dolayısıyla farklı dosya). Ve profil üzerinden distinct() çalıştırmayın: burada da eksik değerler sahte benzerlik üretir.
Notta olduğu gibi son iş kararları uygulamak. Bu dosyada kayıpla ilgili bir karar gerekmiyor: kayıpların hepsi pozitif ve hiçbiri eksik değil. Kimlik ve tam satır yinelenmesi de yok; profilde aynı 13 satır ayrı dosyalardır ve Görev E’de korundu. Geriye eksiklerle ilgili iki karar kalıyor: dört kategorik sütundan biri eksik olan satırlar silinir (Görev B, MCAR varsayımı), yaşlar en sonda mice ile doldurulur (Görev B ve D, MAR varsayımı).
Önce kategorik sütunlardan biri eksik olan satırları silin:
bi_kategorik_tam <- bi |>
filter(!is.na(clmsex), !is.na(marital), !is.na(clminsur), !is.na(seatbelt))
bi_kategorik_tam#> # A tibble: 1,259 × 8
#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 13 2 2 2 1 1 28 10.9
#> 2 66 2 1 2 2 1 5 0.33
#> 3 71 1 1 1 2 2 32 11.0
#> 4 96 2 1 4 2 1 30 0.138
#> 5 97 1 2 1 2 1 35 0.309
#> 6 120 1 1 2 2 1 19 3.54
#> 7 136 1 2 2 2 1 34 4.88
#> 8 152 2 2 2 2 1 61 0.874
#> 9 155 2 1 2 2 1 NA 1.35
#> 10 162 1 2 1 2 1 37 6.29
#> # ℹ 1,249 more rowsbi_kategorik_tam 1.259 satırdır; 81 satır gitti. Gidenlerin 21’inde yaş da eksikti, bu yüzden eksik yaş 189’dan 168’e indi. Tabloda eksik değer olarak yalnızca bu 168 yaş kaldı.
Yaşı Görev D’deki karara göre, bir kez dolduruyoruz. Önce aynı sütunları faktöre çevirin:
bi_analiz_atama_verisi <- bi_kategorik_tam |>
mutate(across(c("attorney", "clmsex", "marital", "clminsur", "seatbelt"), factor))
bi_analiz_atama_verisi#> # A tibble: 1,259 × 8
#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> <dbl> <fct> <fct> <fct> <fct> <fct> <dbl> <dbl>
#> 1 13 2 2 2 1 1 28 10.9
#> 2 66 2 1 2 2 1 5 0.33
#> 3 71 1 1 1 2 2 32 11.0
#> 4 96 2 1 4 2 1 30 0.138
#> 5 97 1 2 1 2 1 35 0.309
#> 6 120 1 1 2 2 1 19 3.54
#> 7 136 1 2 2 2 1 34 4.88
#> 8 152 2 2 2 2 1 61 0.874
#> 9 155 2 1 2 2 1 NA 1.35
#> 10 162 1 2 1 2 1 37 6.29
#> # ℹ 1,249 more rowsSütunlar bi_atama_verisi’ndekilerle aynı adda ve aynı sıradadır; bu yüzden Görev D’nin bi_kalip matrisini olduğu gibi kullanabiliriz. Ayarlar da aynı, yalnızca m = 1 ve tohum yeni:
bi_analiz_atama <- mice::mice(bi_analiz_atama_verisi, m = 1, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip, seed = 5122, printFlag = FALSE)
bi_analiz_atama$method#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> "" "" "" "" "" "" "pmm" ""Bu kez yalnızca clmage için pmm çalışır; öbür sütunlar eksiksizdir. bi_analiz_atama tek bir tamamlanmış tablo taşır.
Notta olduğu gibi önce doldurulmuş yaşlara bakın. bi_analiz_yas_dolu, bi_kategorik_tam’ın yanına atanan yaşı koyar; ekrana yaşı eksik satırlar gelir.
bi_analiz_yas_dolu <- bi_kategorik_tam |>
mutate(atanan_yas = mice::complete(bi_analiz_atama)$clmage)
bi_analiz_yas_dolu |>
filter(is.na(clmage)) |>
select(casenum, attorney, clmage, atanan_yas)#> # A tibble: 168 × 4
#> casenum attorney clmage atanan_yas
#> <dbl> <dbl> <dbl> <dbl>
#> 1 155 2 NA 27
#> 2 631 1 NA 20
#> 3 641 2 NA 2
#> 4 1062 2 NA 37
#> 5 1092 1 NA 10
#> 6 1170 2 NA 49
#> 7 1186 2 NA 16
#> 8 1312 2 NA 18
#> 9 1354 2 NA 43
#> 10 1359 2 NA 42
#> # ℹ 158 more rowsYaşı eksik 168 satırın ilk onu. clmage boş kalır; atanan_yas her satıra bir yaş yazar. İlk satır, avukat tutmamış (attorney 2) 155 numaralı dosya: ona 27 yazılmış.
İlk on satırda yazılan yaşlar 2 ile 49 arasında; hepsi dosyada gözlenmiş yaşlardır.
Notun aksine burada gerçek yaşları bilmiyoruz: hangi değerin yazıldığını görürsünüz, doğru olup olmadığını göremezsiniz. Gerçek bir dosyada durum her zaman budur. Yaşı kullanan bir sonucun standart hatası bu tablodan değil, bootstrap’tan gelir (Görev G).
Sonra tabloyu denetleyen küçük bir işlev yazıp çalıştırın:
bi_denetim <- function(veri) {
c(satir = nrow(veri),
eksik = sum(is.na(veri)),
gecersiz_kayip = sum(veri$loss <= 0),
yinelenen_satir = sum(duplicated(veri)),
yinelenen_kimlik = sum(duplicated(veri$casenum)),
yinelenen_profil = sum(duplicated(veri[bi_profil])))
}
bi_denetim(mice::complete(bi_analiz_atama))#> satir eksik gecersiz_kayip yinelenen_satir
#> 1259 0 0 0
#> yinelenen_kimlik yinelenen_profil
#> 0 4Tabloda 1.259 satır var; eksik değer, sıfır ya da negatif kayıp, tam satır ve kimlik yinelenmesi yok. Profildeki yinelenme 4.
Atamadan önce 13’tü: 4’ü eksiksiz satırlar arasındaki çiftlerdi, kalanlarda iki dosya yalnızca yaşları eksik olduğu için aynı görünüyordu. pmm bu dosyalara farklı yaşlar yazdığı için yalnızca eksiksiz satırlar arasındaki dört çift kalıyor. Hiçbiri silinmez, çünkü kimlikleri farklıdır.
Laboratuvarın analiz tablosu bu tablodur:
bi_analiz <- mice::complete(bi_analiz_atama)
head(bi_analiz)#> casenum attorney clmsex marital clminsur seatbelt clmage loss
#> 1 13 2 2 2 1 1 28 10.892
#> 2 66 2 1 2 2 1 5 0.330
#> 3 71 1 1 1 2 2 32 11.037
#> 4 96 2 1 4 2 1 30 0.138
#> 5 97 1 2 1 2 1 35 0.309
#> 6 120 1 1 2 2 1 19 3.538Yaşı kullanmayan bir analiz, örneğin kaybın avukata göre özeti, atamadan etkilenmez; yaşı kullanan bir analizin standart hatası bootstrap’tan gelir (Görev G). Temizleme günlüğünüze şunu yazın: dört kategorik sütundan biri eksik olan 81 satır silindi (MCAR varsayımı); 168 eksik yaş mice ile bir kez dolduruldu (MAR varsayımı), belirsizliği bootstrap’la ölçüldü; profilde aynı dosyalar korundu.
Bu dosyanın sorusu: avukat tutulan dosyalarda kayıp ne kadar büyük, yaşı da hesaba katınca? Kaybı yaşa ve avukata bağlayan regresyonu analiz tablosunda kurun:
bi_model <- lm(loss ~ clmage + attorney, data = bi_analiz)
round(summary(bi_model)$coefficients, 4)#> Estimate Std. Error t value Pr(>|t|)
#> (Intercept) 4.6559 2.2432 2.0755 0.0381
#> clmage 0.1715 0.0556 3.0869 0.0021
#> attorney2 -8.4886 1.9060 -4.4537 0.0000attorney2 satırı avukat tutulmayan dosyaları avukat tutulanlarla karşılaştırır: aynı yaşta, avukatsız dosyalarda kayıp ortalama 8,49 bin dolar küçük. Bu betimseldir: ağır bir hasar avukat tutmaya da yol açar; katsayı avukatın kaybı büyüttüğünü söylemez.
Yaşın katsayısı 0,1715, standart hatası 0,0556, p değeri 0,0021: bu çıktıya bakan biri yaşın kayıpla ilişkili olduğunu raporlardı. Ama bu standart hata atanan 168 yaşı gözlenmiş gibi sayar.
Rapora girecek sayıları bir işlevle hesaplayın: yaşın ve avukatın katsayısı ve 18 yaşından küçük davacıların payı.
bi_istatistikleri <- function(tablo) {
model <- lm(loss ~ clmage + attorney, data = tablo)
c(yas_katsayisi = coef(model)[["clmage"]],
avukat_katsayisi = coef(model)[["attorney2"]],
pay_18_alti = 100 * mean(tablo$clmage < 18))
}
bi_tahmin <- bi_istatistikleri(bi_analiz)
round(bi_tahmin, 4)#> yas_katsayisi avukat_katsayisi pay_18_alti
#> 0.1715 -8.4886 18.5068Şimdi bootstrap: bi_kategorik_tam’dan 100 örnek çekin, her birini Görev F’deki gibi doldurun ve üç sayıyı yeniden hesaplayın.
set.seed(5129)
bi_bootstrap <- t(sapply(1:100, function(b) {
ornek <- bi_kategorik_tam[sample(nrow(bi_kategorik_tam), replace = TRUE), ]
veri <- ornek |>
mutate(across(c("attorney", "clmsex", "marital", "clminsur", "seatbelt"), factor))
doldurulmus <- mice::complete(mice::mice(veri, m = 1, maxit = 5, method = "pmm",
predictorMatrix = bi_kalip, printFlag = FALSE))
bi_istatistikleri(doldurulmus)
}))
round(head(bi_bootstrap), 4)#> yas_katsayisi avukat_katsayisi pay_18_alti
#> [1,] 0.1040 -6.2887 19.3010
#> [2,] 0.0746 -6.9777 18.8245
#> [3,] 0.0692 -7.4106 16.8388
#> [4,] 0.1644 -8.0957 19.1422
#> [5,] 0.0722 -5.4098 19.3010
#> [6,] 0.3763 -10.2384 17.7919Tahmini, bootstrap standart hatasını ve %95’lik yüzdelik aralığı yan yana koyun:
bi_rapor <- cbind(
tahmin = bi_tahmin,
std_hata = apply(bi_bootstrap, 2, sd),
yuzde_2_5 = apply(bi_bootstrap, 2, quantile, 0.025),
yuzde_97_5 = apply(bi_bootstrap, 2, quantile, 0.975)
)
round(bi_rapor, 4)#> tahmin std_hata yuzde_2_5 yuzde_97_5
#> yas_katsayisi 0.1715 0.1242 -0.0127 0.4091
#> avukat_katsayisi -8.4886 1.8984 -11.9045 -5.2432
#> pay_18_alti 18.5068 1.4815 15.7943 21.8090Yaşın katsayısının bootstrap standart hatası 0,1242, tablonunkinin iki katından büyük; %95’lik aralık −0,0127 ile 0,4091 arasında ve sıfırı içeriyor. Tablonun kendi standart hatası sonucu tersine çeviriyordu; bootstrap’la yaşın etkisi sıfırdan ayırt edilemiyor.
Avukatın katsayısı −8,49, standart hatası 1,90; aralığı −11,90 ile −5,24: atama onu oynatmıyor. 18 yaşından küçük davacıların payı %18,5 (standart hata 1,48; aralık %15,8–21,8).
Bu modeli bu atamayla kurabiliyoruz, çünkü Görev D’nin bi_kalip matrisinde yaş, kayıptan ve avukattan yordanıyor; ikisi de modelin içinde. Modele atamada yordayıcı olmayan bir sütun girecek olsaydı atama o sütun eklenerek yeniden koşulurdu.
Aşağıdaki alıştırmalar bu haftanın temizleme ve keşifsel analiz becerilerini pekiştirmek içindir. Önce kendi çözümünüzü oluşturun, ardından her kutudaki Çözümü göster düğmesiyle yaklaşımınızı karşılaştırın. Gerçek veriye dayanan sayılar dersin değişmeyen auto_claims.csv kopyasından — laboratuvara ait olanlar ise auto_bi.csv kopyasından — alınmıştır; kendiniz de aynı sonuçları üretebilirsiniz. Bir alıştırma gövdedeki ya da laboratuvardaki bir tabloya veya teste dayanıyorsa, o tablo ve test sonuçları alıştırmanın içinde yeniden verilmiştir; geri dönüp aramanız gerekmez. Yıldızlı (★) alıştırmalar daha fazla yorum gerektirir.
Alıştırma 1 (Eksik değer kararının özete etkisi). Bir hasar dosyasından altı kayıt alınmıştır. claim_amount sütunundaki değerler sırasıyla 480, 1.250, NA, 0, 3.600 ve 2.170 TL’dir.
mean(..., na.rm = TRUE) sonucunu hesaplayın.NA’yı hem de 0’ı dışarıda bırakan üçüncü bir ortalama daha hesaplayın ve her sayının hangi varsayımı temsil ettiğini yazın.(a) sum(is.na(...)) sonucu 1’dir; gözlenen beş değer kalır.
\[ 480+1.250+0+3.600+2.170=7.500, \qquad \bar{x}=\frac{7.500}{5}=1.500\ \text{TL}. \]
(b) Eksik değeri 0 sayarsak pay değişmez, payda 6 olur:
\[ \frac{7.500}{6}=1.250\ \text{TL}. \]
Bu, “eksik” ile “ödeme sıfır”ın aynı şey olduğu varsayımıdır. na.rm = TRUE (1.500 TL) ise eksik kaydın gözlenenlere benzediğini varsayar. Sıfırın “henüz ödeme yapılmadı” anlamına geldiğini düşünürsek her ikisini de dışarıda bırakırız:
\[ \frac{7.500}{4}=1.875\ \text{TL}. \]
Aynı altı kayıttan 1.250, 1.500 ve 1.875 TL çıkar. Hangisinin doğru olduğunu veri değil, veri sözlüğü ve analiz amacı belirler; bu yüzden temizleme günlüğü tutuyoruz.
(c) na.rm = TRUE ile sıralı değerler 0, 480, 1.250, 2.170, 3.600 olduğundan medyan 1.250 TL’dir. Eksiği 0 sayarsak sıralama 0, 0, 480, 1.250, 2.170, 3.600 olur ve medyan ortadaki iki değerin ortalamasıdır:
\[ \frac{480+1.250}{2}=865\ \text{TL}. \]
Ortalama 250 TL, medyan ise 385 TL kaymıştır. Yani “medyan her zaman daha dayanıklıdır” genellemesi eksik değer kararı için geçerli değildir; medyan büyük aykırı değerlere karşı dayanıklıdır, yeni eklenen bir değere (burada 0) karşı değil.
Alıştırma 2 (Sütun adı ve tür denetimi). Bir CSV’nin başlık satırı aşağıdaki gibidir ve tutar sütunu metin olarak okunmuştur:
adlar <- c("Claim Amount", "STATE", "class ", "Gender%", "age")
tutar_metni <- c("1200", "1.250", "2,400", "3 600 TL", "")janitor::make_clean_names(adlar) hangi beş adı üretir?as.numeric(tutar_metni) her öğe için ne döndürür? Kaç NA oluşur?NA üretenlerden daha tehlikelidir?(a) Sonuç "claim_amount", "state", "class", "gender_percent", "age" olur. Boşluk alt çizgiye döner, büyük harfler küçültülür, sondaki boşluk atılır ve % işareti percent sözcüğüne çevrilir. Bu işlem yalnızca adı standartlaştırır; hücre değerlerine dokunmaz.
(b) Sırasıyla 1200.00, 1.25, NA, NA, NA elde edilir; üç NA oluşur ve R “NAs introduced by coercion” uyarısı verir.
(c) Tehlikeli olan "1.250" değeridir: hiçbir uyarı vermeden 1,25 olur. Kaynak noktayı binlik ayırıcı olarak kullanıyorsa 1.250 TL’lik bir hasar 1,25 TL’ye, yani bin kat küçüğe döner. sum(is.na(...)) bu hatayı yakalayamaz, çünkü ortada eksik değer yoktur; toplam ve ortalama sessizce yanlış hesaplanır. NA üretenler ise hem uyarı hem de görünür bir boşluk bırakır. Doğru yol, ayırıcı geleneğini veri sözlüğünden öğrenip dönüşümü açıkça yazmaktır:
as.numeric(gsub(".", "", "1.250", fixed = TRUE)) # 1250Dersin auto_claims.csv kopyasında claim_amount zaten sayısal okunur — yani bu haftanın verisinde sessiz dönüşüm hatası yoktur. Eksik değer ise vardır ve görünürdür: öğretim amacıyla 133 eksik tutar, 599 eksik yaş ve 297 eksik cinsiyet konulmuştur. İkisinin farkı bu alıştırmanın konusudur — eksik değer sayılabilir, sessizce yanlış okunmuş bir sayı sayılamaz. glimpse() ile türleri denetlememizin nedeni tam olarak ikincisini, sonuçlara bakmadan önce görmektir.
Alıştırma 3 (Grup özetinde pay ve payda). negatifsiz tablosunun tutarı gözlenen 6.642 kaydında class sütunu trimws() ile kırpıldıktan sonra dört tarife sınıfı için gerçek özetler şöyledir:
| Sınıf | Kayıt sayısı | Toplam hasar (TL) |
|---|---|---|
| C7C | 79 | 166.447,67 |
| C7B | 670 | 1.321.077,76 |
| C11 | 1.129 | 1.925.528,99 |
| F7 | 59 | 61.135,00 |
(a) Her sınıfta toplam tutarı kayıt sayısına böleriz:
\[ \begin{aligned} \text{C7C} &: \frac{166.447{,}67}{79}=2.106{,}93\ \text{TL},\\[4pt] \text{C7B} &: \frac{1.321.077{,}76}{670}=1.971{,}76\ \text{TL},\\[4pt] \text{C11} &: \frac{1.925.528{,}99}{1.129}=1.705{,}52\ \text{TL},\\[4pt] \text{F7} &: \frac{61.135{,}00}{59}=1.036{,}19\ \text{TL}. \end{aligned} \]
(b) Payları ve paydaları ayrı ayrı toplarız:
\[\begin{aligned} &\frac{166.447{,}67+1.321.077{,}76+1.925.528{,}99+61.135{,}00}{79+670+1.129+59}\\[3pt] &=\frac{3.474.189{,}42}{1.937}=1.793{,}59\ \text{TL}. \end{aligned}\]
(c) Dört ortalamanın basit ortalaması
\[ \frac{2.106{,}93+1.971{,}76+1.705{,}52+1.036{,}19}{4}=1.705{,}10\ \text{TL} \]
olur; aradaki fark 88,49 TL’dir. Basit ortalama, 59 kayıtlık F7 sınıfına 1.129 kayıtlık C11 sınıfıyla aynı ağırlığı verir. Sorulan soru “bu 1.937 hasarın ortalaması” ise (b) doğrudur; bu, kayıt düzeyindeki veriden doğrudan summarise(mean(claim_amount)) ile elde edilir. Grup özeti tablosu üzerinde mean(mean_claim) yazmak ise (c)’yi üretir ve farklı bir soruyu yanıtlar.
Alıştırma 4 (Yinelenen kayıt: kimlik neyi çözer, neyi çözmez). Ders dosyasında 6.776 satır vardır ve üç yinelenme sayacı farklı değerler verir: yinelenen_satir 2, yinelenen_kimlik 3, yinelenen_profil 11. Aşağıdaki sekiz satır üç durumun her birini örnekler:
claim_no |
state |
class |
gender |
age |
claim_amount |
|
|---|---|---|---|---|---|---|
| H00001 | STATE 14 | C6 | M | 97 | 1.134,44 | kaynakta vardı |
| H00001 | STATE 14 | C6 | M | 97 | 1.134,44 | öğretim için eklendi |
| H00002 | STATE 15 | C6 | M | NA |
3.761,24 | kaynakta vardı; yaşı öğretim için silindi |
| H00002 | STATE 15 | C6 | M | NA |
3.761,24 | öğretim için eklendi |
| H00005 | STATE 15 | F6 | M | 95 | 650,00 | kaynakta vardı |
| H00005 | STATE 15 | F6 | M | 59 | 650,00 | öğretim için eklendi |
| H01253 | STATE 15 | C11 | M | 75 | 648,06 | kaynakta vardı |
| H01254 | STATE 15 | C11 | M | 75 | 648,06 | kaynakta vardı |
Ham CSV metninde iki karakterli sınıf kodları boşlukla doldurulmuştur ("C6 "), ama read_csv() varsayılan trim_ws = TRUE ayarıyla bu boşluğu okurken kırpar: ham içinde nchar(ham$class[1]) 2, ham$class[1] == "C6" karşılaştırması ise TRUE döner.
distinct() ile silinebilir, hangisi silinemez ve neden? Silinemeyen için temizleme günlüğüne ne yazarsınız?class sütununa trimws() uygulamak sınıf sayısını değiştirir mi? Değiştirmiyorsa neden yine de uygulanmalıdır?(a) Her çift farklı bir sayaç kümesinde görünür, ve ayrım tam da bu:
| Çift | yinelenen_satir |
yinelenen_kimlik |
yinelenen_profil |
Adı |
|---|---|---|---|---|
| H00001 / H00001 | ✓ | ✓ | ✓ | teknik kopya |
| H00002 / H00002 | ✓ | ✓ | ✓ | teknik kopya |
| H00005 / H00005 | — | ✓ | — | kimlik çakışması |
| H01253 / H01254 | — | — | ✓ | aynı profilli iki ayrı hasar |
Aritmetiği de tutar: yinelenen_kimlik − yinelenen_satir = 3 − 2 = 1, yani bir kimlik çakışması. İkinci fark ise daha öğretici: yinelenen_profil − yinelenen_satir = 11 − 2 = 9, yani teknik kopyaların dışında dokuz profil çifti var — oysa kaynakta yalnızca üç tane vardı.
Kalan altısını biz ürettik. Bir alanı boşaltmak, yalnızca o alanda farklı olan iki satırı birbirinin aynı yapar. Dosyadaki en büyük profil grubu bunun saf örneğidir: STATE 15 / C6 / M / NA / NA profilini dört kayıt paylaşıyor (H00255, H00406, H00601, H00704) — dördü de gerçekte farklı yaşlara ve farklı tutarlara sahipti, ta ki ikisi birden silinene kadar.
Buradan çıkan kural: eksik değer içeren bir sütunu kapsayan profil üzerinde distinct() çalıştırılmaz, ve her yinelenme sayacı veri her değiştiğinde yeniden ölçülür — eskisi taşınmaz.
(b) Yalnızca teknik kopya silinebilir. Kimlik aynı, bütün alanlar aynı: hangi satırın kalacağı sorusunun cevabı yoktur çünkü iki satır ayırt edilemez. distinct() burada güvenlidir.
Kimlik çakışması silinemez. H00005 iki kez geçiyor ve yaş 95 ile 59 olarak çelişiyor. distinct() bu satırları silmez (birebir aynı değiller), ama distinct(claim_no, .keep_all = TRUE) yazarsanız sessizce ilk satırı seçer — ve hangisinin doğru olduğuna dair hiçbir bilginiz yokken bir karar vermiş olursunuz. Bu, dosyadaki en tehlikeli varsayılandır. 59 ile 95 arasındaki ilişki rakam devriğidir; hangisinin devrik olduğu veriden anlaşılmaz, çünkü ikisi de olağan bir yaştır. Günlük satırı şöyle olur — Sorun: claim_no H00005 iki satırda, age çelişiyor (95 / 59); Kanıt: sum(duplicated(ham$claim_no)) - sum(duplicated(ham)) == 1; Uygulanan işlem: kayıt silinmedi, işaretlendi ve kaynak sisteme soruldu; Olası etkisi: yaşa göre kırılımda bir kayıt yanlış grupta.
Aynı profilli iki ayrı hasar korunur. H01253 ve H01254 farklı hasar numaraları taşıyor; aynı eyalette, aynı sınıfta, aynı yaştaki iki sigortalının 648,06 TL’lik hasar bildirmesi mümkündür. Kimlik olmasaydı bu çift ile teknik kopya ayırt edilemezdi — kimliğin çözdüğü şey tam olarak budur.
Teknik kopyayı silmenin etkisi küçüktür: tutarı gözlenen kayıt sayısı 6.642’den 6.640’a (%0,03), ortalama 1.733,96 TL’den 1.733,75 TL’ye, medyan 983,355 TL’den 983,145 TL’ye iner. Etkinin küçük olması kararı gereksiz kılmaz: yinelenen kayıt 60.000 TL’lik en büyük hasar olsaydı etki de büyük olurdu.
(c) Değiştirmez — ama beklediğiniz nedenle değil. read_csv() boşlukları okuma anında zaten kırptığı için ham içindeki 18 düzeyin hiçbirinde dolgu kalmamıştır; trimws() burada gerçekten hiçbir şey yapmaz. Yine de yazılır, çünkü aynı dosya read.csv() ile, trim_ws = FALSE ile ya da bir Excel kopyasından okunduğunda boşluklar yerinde kalır. O durumda "C6 " == "C6" karşılaştırması FALSE döner: başka bir tarife tablosuyla birleştirme sessizce eşleşmez, grafik ve rapor etiketlerinde kodun sonunda boşluk görünür ve boşluklu/boşluksuz kayıtlar karışırsa aynı sınıf iki ayrı düzeye bölünür. trimws() bu yüzden bir düzeltme değil, okuma biçimine bağlı kalmayı önleyen bir savunmadır.
Alıştırma 5 (★ Yorum: gözlenen fark mı, oynaklık mı?). negatifsiz tablosunun tutarı gözlenen 6.642 kaydında gender alanına göre gerçek özet şöyledir:
gender |
Kayıt sayısı | Ortalama hasar (TL) | Medyan hasar (TL) | Standart sapma (TL) |
|---|---|---|---|---|
| F | 2.427 | 1.762,47 | 941,51 | 2.638,09 |
| M | 3.923 | 1.722,19 | 1.002,85 | 2.357,08 |
İki satırın toplamı 6.350’dir; kalan 292 kayıtta gender eksik olduğu için tabloda görünmez.
Bir yönetici tabloya bakıp “F grubunun hasarları daha pahalı, prim farkı koyalım” diyor.
(a) Fark
\[ 1.762{,}47-1.722{,}19=40{,}28\ \text{TL} \]
kadardır. Ortalama düzey yaklaşık 1.742 TL olduğuna göre bu %2,3’tür; standart sapmaya oranı ise
\[ \frac{40{,}28}{2.638{,}09}\approx0{,}015, \]
yani tipik bir hasarın oynaklığının yüzde 1,5’i. Rastlantıyla karşılaştırmanın doğru ölçütü ise farkın standart hatasıdır: bu örneklem büyüklüklerinde yaklaşık 65 TL. 40 TL’lik bir fark iki grubun rastgele bölünmesinden de kolayca doğabilir; tek başına bir tarife farkını gerekçelendirmez.
(b) Medyanlarda sıralama terstir: F grubunda 941,51 TL, M grubunda 1.002,85 TL. Ortalama ile medyanın ters yönde sıralanması, farkın dağılımın merkezinden değil sağ kuyruğundan geldiğini gösterir. F grubunda birkaç büyük hasar (standart sapması da daha yüksektir) ortalamayı yukarı çekmiş, ama tipik hasar M grubunda daha yüksektir. Yalnızca tek bir özet ölçüye dayanan karar, hangi ölçünün seçildiğine göre yön değiştirir.
(c) Hayır. Bu dosyada yalnızca gerçekleşmiş hasar kayıtları vardır; hasarsız poliçeler ve maruziyet bilgisi yoktur. Olasılık hesabının paydasında risk altındaki bütün poliçeler bulunmalıdır; elimizde yalnızca pay vardır. Ayrıca tablo tamamen betimsel (descriptive) bir özettir: yaş, eyalet ve tarife sınıfı dağılımları iki grup arasında farklı olabilir. Bu farklar kontrol edilmeden gözlenen bir ortalama farkı nedensel biçimde yorumlanamaz.
(d) Bu dosyada hayır — ama gerekçe tablodan değil, mekanizmadan gelir. gender eksikliği bu haftanın verisinde MCAR’dır: hangi kaydın cinsiyetinin kaybolacağı ne yaşa, ne sınıfa, ne de tutara bağlıydı. MCAR altında tam vaka analizi yansızdır; ödenen bedel yanlılık değil kesinliktir, çünkü örneklem 292 kayıt küçülür. Dışarıda kalan kayıtların ortalama tutarı 1.655,16 TL, tutarı gözlenen bütün kayıtların ortalaması olan 1.733,96 TL’den yalnızca biraz düşüktür — bu büyüklükteki bir sapma 292 kayıtlık bir alt kümede oynaklıkla açıklanır.
Gövdenin cinsiyet bölümündeki dört test de cinsiyet eksikliğiyle bir ilişki bulmamıştı (p değerleri 10.000 rastgele tabloyla benzetimle hesaplandı):
| Gözlenen değişken | Kayıt | Ki-kare | p | Cramér V |
|---|---|---|---|---|
| sınıf | 6.776 | 14,71 | 0,608 | 0,047 |
| eyalet | 6.776 | 11,74 | 0,465 | 0,042 |
| yaş bandı | 6.177 | 0,84 | 0,835 | 0,012 |
| tutar çeyreği | 6.643 | 0,97 | 0,806 | 0,012 |
Dikkat edilecek nokta şudur: bunu biliyoruz, çünkü eksikliği biz koyduk. Gerçek bir dosyada MCAR bir varsayımdır ve savunulması gerekir: eksikliği gözlenen değişkenlerle çaprazlamak MCAR’ı kanıtlamaz — desen çıkarsa onu çürütür, çıkmazsa yalnızca çürütemez.
Alıştırma 6 (Tek bir büyük hasar ve log eksen). F11 tarife sınıfında 40 hasar kaydı vardır: gözlenen 39 tutarın toplamı 73.848,57 TL, ortalama 1.893,55 TL, medyan 744,20 TL. Bu sınıftaki en büyük tek hasar 23.015,61 TL’dir.
Gövdedeki log10 eksenli histogram, analiz tablosunun tutarı sıfır olmayan 6.475 kaydını 30 çubukla çizer; F11’in bu en büyük hasarı da aralarındadır. 10.000 TL dolayından sonraki çubuklar şunlardır:
| Çubuk (TL) | Kayıt sayısı |
|---|---|
| 9.931–13.429 | 70 |
| 13.429–18.159 | 26 |
| 18.159–24.556 | 9 |
| 24.556–33.205 | 3 |
| 33.205–44.900 | 0 |
| 44.900–60.715 | 2 |
(a) Pay
\[ \frac{23.015{,}61}{73.848{,}57}\approx0{,}312, \]
yani sınıf toplamının yaklaşık %31,2’si tek bir hasardan gelmektedir.
(b) Gözlenen 39 kayıttan en büyüğü çıkarılınca 38 kayıt kalır ve toplamları \(73.848{,}57-23.015{,}61=50.832{,}96\) TL olur:
\[ \bar{x}_{38}=\frac{50.832{,}96}{38}=1.337{,}71\ \text{TL}. \]
Ortalama 555,84 TL, yani yaklaşık %29 düşer. Medyan ise 744,20 TL’den 711,70 TL’ye, yalnızca 32,50 TL iner. Aykırı büyüklükteki tek bir kaydın ortalamayı medyandan çok daha fazla oynatması, iki ölçüyü birlikte raporlamanın nedenidir.
(c) Log10 eksenli histogramda 23.015,61 TL, 18.159–24.556 TL çubuğundaki dokuz kayıttan biridir: 10.000 TL’nin ötesindeki seyrek çubuklar arasında ayırt edilebilir, dağılımın gövdesi ise 1.000 TL çevresinde toplanır. Doğrusal eksenli histogramda (25 çubuk, her biri 2.500 TL genişliğinde) aynı kayıt 21.250–23.750 TL çubuğundaki beş kayıttan biridir; 6.476 kayıtlık bir grafikte beş kayıtlık bir çubuk neredeyse görünmez.
Dürüst raporlama için kayıt sayısı (40) ile birlikte hem ortalama hem medyan verilir, en büyük kaydın toplam içindeki payı belirtilir, kullanılan eksen dönüşümü açıkça yazılır. Kaydın silinmesi değil, etkisinin gösterilmesi gerekir; “F11 sınıfı pahalıdır” gibi bir tarife sonucu 40 kayda ve tek bir büyük hasara dayandırılmaz.
Alıştırma 7 (Mekanizmayı adlandırma). Aşağıdaki üç senaryoda eksikliğin mekanizmasını adlandırın ve gözlenen veriden sınanıp sınanamayacağını söyleyin.
(a) MCAR. Eksiklik ne gözlenen ne de gözlenmeyen bir değere bağlı; yazıcı hatası veriyle ilişkisiz. Sınanabilir mi: evet, dolaylı olarak — eksikliği gözlenen değişkenlerle çaprazlarsanız desen çıkmamalıdır. Desen çıkmaması MCAR’ı kanıtlamaz, ama çıkması MCAR’ı çürütür.
(b) MAR. Eksiklik yaşa bağlı ve yaş gözleniyor. Sınanabilir mi: kısmen. Meslek eksikliğini yaşa göre çaprazlarsanız desen görünür; bu, eksikliğin MCAR olmadığını kanıtlar. MAR olduğunu ise kanıtlamaz: eksiklik yaşın yanında mesleğin kendisine de bağlı olabilir ve bunu gösterecek bir tablo yoktur — (c)’deki sorunun aynısı. Bu haftanın age sütununda desen açıkça görünüyordu: sınıfa göre eksik yaş oranı %1,6 ile %35,4 arasında değişiyordu.
(c) MNAR. Eksiklik, göremediğimiz tutarın kendisine bağlı. Sınanabilir mi: hayır. Bunu gösterecek bir tablo yoktur, çünkü karşılaştıracağınız değer elinizde değildir. Bu haftanın claim_amount sütunu böyleydi ve sınıfa göre çapraz tablosu sınıflar arasında ayrışma göstermiyordu — teşhis tablosu en yıkıcı mekanizmayı göremez. İki sütunun gövdedeki sınıf testleri yan yana:
| Sütun | Genel eksik oranı | Sınıflara göre eksik oranı | Sınıfla ki-kare testi: p | Cramér V |
|---|---|---|---|---|
age |
%8,8 | %1,6–%35,4 | < 0,001 | 0,390 |
claim_amount |
%2,0 | %0,0–%3,8 | 0,792 | 0,042 |
Yaşta test bağımlılığı açıkça buluyor. Tutarda hiçbir şey bulmuyor, oysa tutarın eksikliği rastgele değildi: büyük tutarlar kayboldu. Eksikliğin kaybolan değerin kendisine bağlı olduğunu hiçbir sınıf tablosu gösteremez.
Genel kural: MCAR ile MAR ayrımı sınanabilir, MAR ile MNAR ayrımı sınanamaz. İkincisi bir araç eksikliği değil, mantıksal bir imkânsızlıktır: her MNAR modelinin, gözlenen veriye tıpatıp aynı uyumu veren bir MAR karşılığı vardır (Molenberghs vd., 2008).
Alıştırma 8 (Ortalama atamasının varyansa bedeli). Altı sigortalının yaşı şöyle olsun: 52, 58, NA, 64, NA, 76.
(a) Gözlenenler 52, 58, 64, 76:
\[ \bar{x}=\frac{52+58+64+76}{4}=\frac{250}{4}=62{,}5 \]
Sapmalar \(-10{,}5,\ -4{,}5,\ 1{,}5,\ 13{,}5\); kareler toplamı \(110{,}25+20{,}25+2{,}25+182{,}25=315\). Örneklem standart sapması \(s=\sqrt{315/3}=\sqrt{105}\approx 10{,}2470\).
(b) İki eksiğe 62,5 koyarız: 52; 58; 62,5; 64; 62,5; 76. Toplam \(375=6\times 62{,}5\), yani ortalama yine 62,5. Kareler toplamı değişmez (eklenen iki sapma sıfırdır) ama payda büyür: \(s=\sqrt{315/5}=\sqrt{63}\approx 7{,}9373\).
(c) Ortalama değişemez: ortalamayı ortalamayla doldurmak toplamı ve sayıyı aynı oranda büyütür. Standart sapma ise %22,5 düşer, çünkü iki yeni gözlem merkeze tam olarak yerleştirildi — hiç sapma katmadan payda büyüdü.
Standart hata iki yönden birden küçülür: pay (\(s\)) düştü, payda (\(\sqrt{n}\)) büyüdü. \(10{,}2470/\sqrt{4}=5{,}12\) iken \(7{,}9373/\sqrt{6}=3{,}24\) olur. Hiçbir yeni bilgi girmeden tahmin yaklaşık 1,6 kat daha kesin görünür. Tek atamanın asıl bedeli budur ve yalnızca ortalamaya bakan bir tablo bunu gizler.
Alıştırma 9 (mode() tuzağı). Bir meslektaşınız kategorik bir sütunu doldurmak için şu satırı yazıyor:
veri$cinsiyet[is.na(veri$cinsiyet)] <- mode(veri$cinsiyet)mode() ne döndürür?(a) İstatistiksel mod değil. mode() R’nin depolama kipini döndürür: bir karakter vektörü için "character", sayısal için "numeric".
(b) Hata vermez. Eksik hücrelerin hepsine "character" dizesi yazılır. Sütun artık F, M ve character olmak üzere üç düzeylidir; sonraki her grup özeti sessizce üçüncü bir kategori raporlar. Bu, haftanın “sessiz hata” temasının tam bir örneğidir — sum(is.na(...)) artık sıfır döner, yani denetiminiz de “temiz” der.
(c) Mod için kendi fonksiyonunuzu yazmak gerekir:
en_sik <- function(x) {
x <- x[!is.na(x)]
names(which.max(table(x)))
}x <- x[!is.na(x)] satırı teknik bir ayrıntı değil, bir karardır: eksikler modun hesabına katılmaz. table() eksikleri zaten saymaz; satır bu kararı koda açıkça yazar. table(x, useNA = "ifany") yazılsaydı ve eksiklik yeterince çok olsaydı “en sık düzey” NA çıkardı. Ayrıca doldurmadan önce durup düşünün: bu haftanın verisinde modla doldurmak F payını %38,18’den %36,51’e çekiyordu, yani var olmayan bir yanlılık yaratıyordu.
Alıştırma 10 (★ Rubin kurallarını elle uygulama). Bir ortalama yaş \(m=10\) tamamlanmış veri setinde tahmin edilmiş; set içi varyans \(\bar{U}=0{,}040\), setler arası varyans \(B=0{,}010\) çıkmış. Rubin kuralları \(m\) setin tahminlerini (\(\widehat{Q}_i\)) ve bu tahminlerin varyanslarını (\(U_i\), standart hatanın karesi) şöyle birleştirir:
\[ \begin{aligned} \bar{U}&=\frac{1}{m}\sum_{i=1}^{m}U_i\\[3pt] B&=\frac{1}{m-1}\sum_{i=1}^{m}\bigl(\widehat{Q}_i-\bar{Q}\bigr)^2\\[3pt] T&=\bar{U}+\Bigl(1+\frac{1}{m}\Bigr)B \end{aligned} \]
Havuzlanmış tahmin \(\bar{Q}\), setlerin tahminlerinin ortalamasıdır; havuzlanmış standart hata \(\sqrt{T}\)’dir.
(a) \(T=0{,}040+(1+1/10)\times0{,}010\) \(=0{,}040+0{,}011\) \(=0{,}051\); standart hata \(\sqrt{0{,}051}\approx0{,}2258\).
(b) \(\sqrt{\bar{U}}=\sqrt{0{,}040}=0{,}2000\). Havuzlanmış hata bundan %12,9 büyüktür; fark eksik değerleri bilmemenin bedelidir ve tek atama onu hiç göstermez.
(c) \(T=0{,}040+(1+1/3)\times0{,}010\approx0{,}0533\); standart hata \(\approx0{,}2309\), on setle bulunandan büyük. Farkı \(B/m\) terimi yaratır: on set \(T\)’ye \(0{,}010/10=0{,}001\), üç set \(0{,}010/3\approx0{,}0033\) ekler. Az sayıda setin ortalaması daha oynak bir tahmindir; \(m\) büyüdükçe bu terim sıfıra iner.
Bu alıştırmalar hesaplamadan çok, kullanılan ölçünün anlamını ve analizin sınırlılıklarını kısa biçimde tartışmak içindir. Önce yanıtınızı oluşturun, ardından ilgili Çözümü göster düğmesiyle karşılaştırın.
Alıştırma 11 (Sıfırla doldurmanın koşulu). Eksik hasar tutarını sıfırla doldurmak hangi durumda savunulabilir?
Karar tek bir şeye bağlıdır: veri sözlüğü boş hücrenin ne demek olduğunu söylüyor mu?
Her iki durumda da sıfırın gerçek mi yoksa doldurulmuş mu olduğunu gösteren bir bayrak sütunu tutulmalı ve işlem temizleme günlüğüne yazılmalıdır.
Dersin auto_claims.csv kopyasında bu soru somut biçimde doğar: 133 kayıtta tutar eksik, bir kayıtta tutar tam olarak 0 TL (pozitif tutarların en küçüğü 9,50 TL) ve bir kayıtta −250 TL’dir. Bu üçü tek bir filter(claim_amount >= 0) kuralıyla ele alınamaz. Analiz tablosunun ilk adımı, filter(is.na(claim_amount) | claim_amount >= 0), negatifi eler; eksik tutarı korur, çünkü onu \(\delta\) ile dolduracağız; sıfırı ise elemez, çünkü veri sözlüğü olmadan o sıfırın gerçek bir tazminatsız kapanış mı yoksa doldurulmuş bir boşluk mu olduğunu bilmiyoruz. Kuralın hangi kusuru düzelttiğini ve hangisine dokunmadığını bilerek yazmak, bu haftanın asıl dersidir.
Alıştırma 12 (Ortalama ve medyan farkı). Ortalama ile medyanın çok farklı olması dağılım hakkında ne söyler?
Ortalamanın medyandan belirgin biçimde büyük olması dağılımın sağa çarpık ve kuyruğunun ağır olduğunu, yani birkaç büyük hasarın ortalamayı yukarı çektiğini gösterir. Analiz tablosunun 6.476 kaydında (\(\delta\) ile atanan 128 tutar dahil):
Bu tamamen betimsel bir gözlemdir: dağılımın biçimini anlatır, büyük hasarların nedenini açıklamaz. Pratik sonucu şudur: tek başına “ortalama hasar” raporlamak tipik bir hasarı olduğundan büyük gösterir, bu yüzden ortalama ile medyan her zaman birlikte verilir.
Alıştırma 13 (Küçük örneklem gürültüsü). Bir kategoride yalnızca iki kayıt varsa yüksek ortalamayı nasıl sunarsınız?
Ortalamayı tek başına değil, her zaman kayıt sayısıyla birlikte ve mümkünse iki tutarı da açıkça yazarak sunarım; iki gözlemde “ortalama” ile “iki sayının ortası” arasında bilgi farkı yoktur.
Ölçek şudur: hasar tutarlarının standart sapması 2.456,29 TL olduğuna göre iki gözlemlik bir ortalamanın standart hatası yaklaşık \(2.456{,}29/\sqrt{2}\approx1.736{,}86\) TL’dir — genel ortalamanın (1.733,96 TL) kendisi kadar büyük. Dolayısıyla iki kayıtlık bir kategori:
n = 2 görünür biçimde yazılmalı ve sıralama yapılmamalı;Bu haftanın verisindeki en küçük tarife sınıfının bile 29 kaydı vardır (F1, ortalama 1.630,22 TL); iki kayıt, gözlenen farkın gerçek bir risk farkı mı yoksa yalnızca gürültü mü olduğunu ayırt etmeye yetmez.
Alıştırma 14 (Yinelenen kayıt ve kanıt). Yinelenen bir kayıt gerçekten hata olmayabilir mi? Örnek verin.
Evet — ve Alıştırma 4’ün H01253 / H01254 çifti tam olarak budur. İki satır eyalet, sınıf, cinsiyet, yaş ve tutar bakımından aynıdır, ama hasar numaraları farklıdır: bunlar birbirinin kopyası değil, aynı profile sahip iki ayrı olaydır. STATE 15 eyaletinde, C11 sınıfında, 75 yaşındaki iki erkek sigortalının 648,06 TL’lik hasar bildirmesi olağan dışı değildir; aynı poliçenin bir yıl içinde iki ayrı küçük hasar üretmesi de mümkündür.
Kimlik sütunu bu soruyu yalnızca bir yönde kapatır. Farklı kimlik gördüğünüzde “iki ayrı hasar” diyebilirsiniz. Aynı kimlik gördüğünüzde ise iş bitmez: H00005 çiftinde kimlik aynıdır ama yaşlar çelişir, yani hangisinin doğru olduğunu kimlik de söylemez. Bu yüzden duplicated() sonucu hâlâ yapısal bir kural ihlali değil, bir inceleme bayrağıdır: hangi sütunlara baktığınız sonucu belirler, ve kimliğin çözemediği durumda kaydı koruyup kararı günlüğe yazmak gerekir.
Alıştırma 15 (Pay ve payda eksikliği). AutoClaims verisi neden poliçe başına hasar olasılığını tek başına vermez?
Çünkü elimizde yalnızca pay vardır, payda yoktur. Dosyadaki 6.776 satırın hepsi gerçekleşmiş hasar kayıtlarıdır; hiç hasar bildirmemiş poliçeler ve bu poliçelerin maruziyet süreleri veride hiç yer almaz. Bir olasılık hesabının paydasında risk altındaki bütün poliçelerin bulunması gerekir, oysa burada risk altındaki portföyün büyüklüğünü gösteren tek bir sütun bile yoktur — poliçe kimliği olmadığı için kaç ayrı poliçenin temsil edildiğini de sayamayız. Bu veriyle yapılabilecek şey hasar büyüklüğü dağılımını incelemektir; sıklık ve olasılık için poliçe kütüğüyle birleştirilmiş, maruziyet içeren ayrı bir veri gerekir.
Alıştırma 16 (Log eksenin yorumu). Logaritmik eksen büyük hasarların yorumunu nasıl değiştirir?
Gövdedeki iki histogram analiz tablosunun 6.476 kaydını çizer. Tutarları üç aralığa bölmek, iki eksenin neyi gösterip neyi gizlediğini sayıyla verir:
| Tutar aralığı | Kayıt | Kayıtların payı | Toplam tutardaki payı |
|---|---|---|---|
| 1.000 TL’nin altı | 3.220 | %49,72 | %14,31 |
| 1.000–10.000 TL | 3.148 | %48,61 | %72,75 |
| 10.000 TL ve üstü | 108 | %1,67 | %12,94 |
Doğrusal eksende kayıtların %98,3’ü 10.000 TL’nin altındadır ve soldaki birkaç çubukta yığılır; 10.000 TL ve üstündeki 108 kayıt sağda neredeyse görünmez çubuklara dağılır, oysa toplam tutarın %12,94’ünü taşırlar. Log10 ekseninde ise dağılım 1.000 TL çevresinde tepe yapan, iki yanı neredeyse eşit uzunlukta tek tepeli bir yapıya dönüşür; 5.431–7.344 TL çubuğundaki küçük çıkıntı \(\delta\) ile atanan tutarlardandır.
Bu nedenle eksen dönüşümü grafik üzerinde açıkça belirtilmeli ve kuyruğun maliyet payı grafikle değil sayıyla raporlanmalıdır.
Alıştırma 17 (★ Laboratuvar verisi: iki katı ortalama, daha düşük medyan). auto_bi.csv dosyasında yaşı eksik olan hasarların ortalama kaybı 10,486 bin dolar, yaşı gözlenen olanların 5,209. Ama medyanlar ters yönde: eksik grupta 1,701, gözlenen grupta 2,415. Bu çift ne söyler, ne söylemez?
Ne söyler. Eksikliğin rastgele olmadığı açık, ama kanıtı ortalama değil medyandır. Ortalama ile medyanın ters yönde olması, ortalamadaki farkın merkezden değil kuyruktan geldiğini söyler: eksik gruptaki tipik hasar daha küçüktür, ama içlerinde birkaç çok büyük hasar ortalamayı ikiye katlamıştır. Birkaç kayda dayanan bu iki kat fark tek başına güvenilir değildir; eksik gruptaki kayıpların tipik olarak küçük olması ise laboratuvarın çeyrek tablosuyla da tutarlıdır — küçük hasarlarda yaş daha çok eksikti. Bu, yaş eksikliğinin kayıp büyüklüğüyle ilişkili olduğunu gösterir ve MCAR’ı çürütür. Laboratuvarın Görev B’sindeki çeyrek tablosu şöyleydi (kayıp bin dolar):
| Kayıp çeyreği | Kayıt | Çeyreğin en büyük kaybı | Eksik yaş oranı |
|---|---|---|---|
| 1 (en küçük kayıplar) | 335 | 0,640 | %20,0 |
| 2 | 335 | 2,328 | %12,8 |
| 3 | 335 | 3,994 | %14,0 |
| 4 (en büyük kayıplar) | 335 | 1.067,697 | %9,6 |
Çeyrekle yapılan ki-kare testi bağımsızlığı reddediyor (p = 0,0011, Cramér V = 0,109).
Ne söylemez. Üç şeyi:
mice yöntemleri de MAR varsayımı altında çalışır ve varsayımın doğruluğunu bu tablo teyit edemez.Ne yapılır. Tabloyu bir bulgu olarak rapora yazın — “yaşı eksik olan 189 dosyanın kayıp dağılımı gözlenenlerden farklıdır” cümlesi, atamayla ilgili her kararın gerekçesidir. Sonra kaynak sisteme sorun: yaş hangi aşamada giriliyor ve neden bazı dosyalarda boş kalıyor? Cevap veri tabanında değil, iş sürecindedir.
Alıştırma 18 (★ Aynı tabloyu tutar için kurmak: MNAR’ı yakaladınız mı?). Yaş için kurduğumuz sınıf tablosunu (mekanizma_yas_egim) bu kez hasar tutarı için kurun: her sınıfın eksik tutar oranı ve gözlenen ortalama tutarı. Yaşın tablosu, eksik oranına göre sıralı, şöyleydi:
| Sınıf | Kayıt | Eksik yaş | Eksik oranı | Gözlenen ortalama yaş |
|---|---|---|---|---|
| F6 | 158 | 56 | %35,4 | 78,9 |
| C6 | 913 | 306 | %33,5 | 77,9 |
| F11 | 40 | 7 | %17,5 | 71,8 |
| F1 | 29 | 4 | %13,8 | 68,4 |
| C11 | 1.151 | 86 | %7,5 | 68,7 |
| F7 | 59 | 4 | %6,8 | 61,3 |
| C1 | 726 | 48 | %6,6 | 63,3 |
| C7A | 113 | 3 | %2,7 | 58,5 |
| C1C | 38 | 1 | %2,6 | 55,7 |
| C7B | 686 | 18 | %2,6 | 56,4 |
| C1A | 77 | 2 | %2,6 | 57,7 |
| C7C | 81 | 2 | %2,5 | 55,1 |
| C7 | 913 | 22 | %2,4 | 59,9 |
| C1B | 424 | 10 | %2,4 | 57,1 |
| C72 | 85 | 2 | %2,4 | 58,4 |
| C71 | 1.129 | 25 | %2,2 | 58,8 |
| F71 | 93 | 2 | %2,2 | 59,9 |
| C2 | 61 | 1 | %1,6 | 59,1 |
(a) Evet, birlikte artıyor: tabloda bir eğim var — ve tam da bu yüzden bu alıştırma var. Sıra korelasyonu 0,51; yaşınki 0,64. İki sayıya bakan biri “ikisi de aynı güçte bir desen” der.
Kurduğunuz tutar tablosu, bu kez tutarın eksik oranına göre sıralı, şöyle olmalı:
| Sınıf | Kayıt | Eksik tutar | Eksik oranı | Gözlenen ortalama tutar (TL) |
|---|---|---|---|---|
| F6 | 158 | 6 | %3,8 | 1.646,09 |
| C1 | 726 | 20 | %2,8 | 1.694,15 |
| C7A | 113 | 3 | %2,7 | 1.728,41 |
| F11 | 40 | 1 | %2,5 | 1.893,55 |
| C7C | 81 | 2 | %2,5 | 2.106,93 |
| C7B | 686 | 16 | %2,3 | 1.971,76 |
| C11 | 1.151 | 22 | %1,9 | 1.705,52 |
| C1B | 424 | 8 | %1,9 | 1.776,08 |
| C6 | 913 | 17 | %1,9 | 1.798,01 |
| C71 | 1.129 | 21 | %1,9 | 1.678,03 |
| C2 | 61 | 1 | %1,6 | 1.272,12 |
| C7 | 913 | 14 | %1,5 | 1.653,47 |
| C1A | 77 | 1 | %1,3 | 1.668,42 |
| C72 | 85 | 1 | %1,2 | 2.157,25 |
| C1C | 38 | 0 | %0,0 | 1.479,38 |
| F1 | 29 | 0 | %0,0 | 1.630,22 |
| F7 | 59 | 0 | %0,0 | 1.036,19 |
| F71 | 93 | 0 | %0,0 | 1.600,81 |
Ama iki korelasyon aynı şeye dayanmıyor. Genel bakış panelinde yaş sütununda 18 aralığın 12’si genel oranı dışarıda bırakıyordu; tutar sütununda bunu yapan aralık hiç yok. Yani yaşta sınıflar gerçekten ayrışıyor, tutarda ayrışmıyor — 18 satırlık bir tablodan hesaplanan korelasyon ise bu farkı görmüyor. İki özet ölçü aynı sayıyı verdiğinde, dayandıkları kanıt yine de farklı olabilir.
Genel bakış panelinin ve gövdedeki sınıf testlerinin sayıları yan yana (panelde her sınıfın eksik oranı bir %95 güven aralığıyla çizilmişti):
| Sütun | Sıra korelasyonu | Genel oranı dışarıda bırakan sınıf aralığı | Sınıfla ki-kare testi: p | Cramér V |
|---|---|---|---|---|
age |
0,64 | 18’de 12 | < 0,001 | 0,390 |
claim_amount |
0,51 | 18’de 0 | 0,792 | 0,042 |
(b) Hayır, bu hâliyle çıkmaz. Çıkarsa bile fazla bir şey söylemez: 18 sınıflık bir örneklemde bir sıra korelasyonu, birkaç sınıfın yer değiştirmesiyle kolayca oynar. Kararı korelasyona değil, aralıklara bakarak verin — ve aralıklar “ayrışma yok” diyor.
(c) Kesinlikle hayır, ve asıl ders budur. Diyelim ki eğim gerçek olsun. Bu durumda bile MAR ile MNAR aynı resmi üretir:
Gözlenen veriden bakarak ikisini ayıramazsınız, çünkü ayırt edici bilgi tam da göremediğiniz değerin içinde. Bölümün altı poliçelik örneği bunu göstermişti: MAR ile MNAR senaryolarının teşhis tablosu birebir aynıydı, sonuçları değil:
| Senaryo | Genç’te eksik | Yaşlı’da eksik | Yaşlı’nın gözlenen ortalaması | Grup içi atamadan sonra ortalama (gerçek 60) |
|---|---|---|---|---|
| MAR | 0 / 3 | 2 / 3 | 80 | 60 |
| MNAR | 0 / 3 | 2 / 3 | 70 | 55 |
Bir eğim görmek “mekanizmayı buldum” demek değildir; “eksiklik rastgele değil” demektir. Sonraki adım tablo değil, kaynak sistemdir: tutar hangi aşamada giriliyor ve neden bazı dosyalarda boş kalıyor?
Alıştırma 19 (★ Ki-kare sonucunu rapora yazmak). Bir meslektaşınız laboratuvarın Görev B’sindeki yedi testi raporunda aşağıdaki beş cümleyle özetlemiş. Her cümlenin doğru mu yanlış mı olduğunu söyleyin; yanlış olanları düzeltin. Testler clmage’in eksikliğini yedi gözlenen değişkenle sınar; p değerleri 10.000 rastgele tabloyla benzetimle hesaplanmıştır:
| Gözlenen değişken | Kayıt | Ki-kare | p | Cramér V |
|---|---|---|---|---|
avukat (attorney) |
1.340 | 8,54 | 0,0042 | 0,080 |
cinsiyet (clmsex) |
1.328 | 1,19 | 0,3122 | 0,030 |
medeni durum (marital) |
1.324 | 0,76 | 0,8742 | 0,024 |
sigortasızlık (clminsur) |
1.299 | 1,48 | 0,2633 | 0,034 |
emniyet kemeri (seatbelt) |
1.292 | 0,41 | 0,5791 | 0,018 |
kayıp çeyreği (ntile(loss, 4)) |
1.340 | 15,79 | 0,0011 | 0,109 |
cinsiyetin eksik olması (is.na(clmsex)) |
1.340 | 7,59 | 0,0176 | 0,075 |
(a) Yanlış. Testler bir ilişki bulmadı; bu, ilişki olmadığının kanıtı değildir. Notta cinsiyet için kurduğumuz cümlenin aynısı: veri bağımsızlıkla çelişmiyor, o kadar. Üstelik küçük gruplarda test zayıftır. Emniyet kemeri takmayan dosyalarda yaş eksikliği %9,1, takanlarda %13,9; bu fark avukattaki farka (%16,9’a karşı %11,4) yakın. Ama avukat testi 685 ve 655 dosyalık iki gruba dayanıyor, kemer testinin küçük grubu ise yalnızca 22 dosya. Benzer büyüklükte bir fark birinde p = 0,0042, öbüründe p = 0,579 veriyor. Doğru cümle: “Bu dört değişkenle bir ilişki bulunmadı.”
(b) Yanlış. p değeri bağımsızlığın doğru olma olasılığı değildir; bağımsızlık doğru varsayılarak hesaplanan bir olasılıktır. Burada benzetimle hesaplandığı için anlamı da somut: satır ve sütun toplamları gözlenen tabloyla aynı olan 10.000 rastgele tablonun yalnızca 10’unda istatistik en az gözlenen kadar büyük çıktı. Doğru cümle: “Yaş eksikliği kayıptan bağımsız olsaydı, bu büyüklükte bir fark çok nadir görülürdü.”
(c) Yanlış. Kayıp gözlenen bir değişkendir. Gözlenen bir değişkene bağlılık MCAR’ı dışlar ve MAR ile uyumludur. MNAR, eksikliğin yaşın kendisine bağlı olması demektir; eksik yaşları görmediğimiz için bu sınanamaz. V’nin büyüklüğü de bu soruyu cevaplamaz: V ilişkinin gücünü ölçer, türünü değil. Doğru cümle: “Eksiklik kayıpla ilişkili; bu MCAR’ı dışlar, ama MAR ile MNAR arasında karar vermez.”
(d) Yanlış. cinsiyet_eksik bir değer değil, bir eksiklik göstergesidir. MCAR eksikliğin verideki değerlere bağlı olmamasını ister; hangi alanların birlikte boş kaldığı hakkında bir şey söylemez. Alıştırma 7’nin (a) şıkkındaki basılmamış sayfa, o sayfadaki bütün soruları birlikte boş bırakır ve eksiklik yine de MCAR’dır. Doğru cümle: “Bazı dosyalarda birçok alan birden boş kalıyor; bu bir veri toplama bulgusudur, mekanizma hakkında kanıt değildir.”
(e) Doğru. İki test de gözlenen bir değerle ilişki buluyor ve iki p değeri de 0,005’in altında. Eksiklik altı değişkenin hiçbirine bağlı olmasaydı, altı testten herhangi birinin bu eşiğin altına düşme olasılığı en fazla 0,03 olurdu. Raporda bu cümleden sonra gelmesi gereken cümle de şudur: “MAR varsayımıyla ilerliyoruz ve bu varsayım veriden sınanamaz.”
Alıştırma 20 (★ Tek tablo isteği). Müdürünüz mice’ın beş setini değil, eksik yaşları doldurulmuş tek bir tablo istiyor; ortalama yaşı ve standart hatasını da o tablodan raporlayacak. Gövdede eksik yaşlar için ölçtüğümüz dört sonuç:
| Yol | Ortalama yaş | Standart hata | 90 yaş ve üstünün payı |
|---|---|---|---|
mice, beş set havuzlanmış |
63,8934 | 0,1364 | %0,85 |
| beş setin hücre ortalaması | 63,8934 | 0,1286 | %0,56 |
| tek atama, tablonun kendi standart hatası | 63,9138 | 0,1308 | %0,80 |
| tek atama, bootstrap standart hatası | 63,9138 | 0,1447 | %0,80 |
(a) Tek atamayla doldurulmuş tabloyu. Hücre ortalaması van Buuren’in (2018, §5.1.2) önermediği yoldur: ortalamayı korur ama dağılımı daraltır. Bu sayfada 90 yaş ve üstünün payı %0,85’ten %0,56’ya düştü ve hücrelere 77,4 gibi dosyada olmayan yaşlar yazıldı. Tek atama her hücreye gözlenmiş bir yaş yazar; payı %0,80, setlerin aralığında.
(b) Hayır. Tablonun kendi standart hatası (0,1308) atamanın belirsizliğini bilmez. Standart hata bootstrap’tan alınır (0,1447): eksik veriden örnekler çekilir, her örnek yeniden doldurulur ve sonuç her birinde hesaplanır. Laboratuvarın Görev G’si farkın sonucu değiştirebildiğini gösterdi: tek tablo yaşın katsayısını p = 0,0021 ile anlamlı buldu, bootstrap aralığı ise sıfırı içerdi.
Görev G’de yaşın katsayısı:
| Katsayı | Standart hata | Sonuç | |
|---|---|---|---|
| tek tablonun kendi regresyonu | 0,1715 | 0,0556 | p = 0,0021 |
| bootstrap, 100 örnek | 0,1715 | 0,1242 | %95 aralığı −0,0127 ile 0,4091 |
(c) Kısmen. Tek bir poliçenin fiyatını tahmin etmek için eksik değeri tek bir değerle doldurmak yeterli olabilir (Josse vd. 2024): orada istenen bir standart hata değil, bir tahmindir. Ama modelin katsayılarının ne kadar kesin olduğu sorulursa yine (b)’deki gibi bootstrap ya da havuzlama gerekir.
janitor, dplyr, tidyr, readr ve ggplot2 paket belgeleri.insuranceData paketindeki AutoClaims ve AutoBi veri açıklamaları. Derste bu paketten değil, yukarıdan indirilebilen değişmeyen ders kopyasından okuyoruz; kopyanın kaynağı ve lisansı data_manifest.csv içinde kayıtlıdır.mice’taki mnar.norm ve mnar.logreg yöntemlerinin dayanağı. doi:10.1002/sim.7643mice paket belgeleri; MNAR ataması için mice.impute.mnar.norm.