Kodu göster / gizle
library(readr)
library(dplyr)
library(tibble)
library(ggplot2)
library(scales)
library(lifecontingencies)Ölüm olasılıkları, hayatta kalanlar ve nüfus tablosundan aktüeryal yoruma
Geçen hafta sağkalım eğrisini bireysel kayıtlardan kendimiz kurduk: risk kümesini yazdık, her olay zamanında tahmini elle güncelledik. Bu hafta tablo hazır geliyor; arkasındaki kayıtlar elimizde olmadığı için onu ancak kendi iç tutarlılığıyla denetleyebiliriz.
Bir hayat tablosu (life table), farklı yaşlardaki ölüm deneyimini birkaç bağlantılı sütunda özetler. Bu hafta formülleri ezberlemek yerine her sütunun hangi soruyu yanıtladığını, sütunların birbirini nasıl doğruladığını ve TÜİK tablosunun hangi amaçlarla kullanılabileceğini öğreneceğiz.
TÜİK tablosu Türkiye nüfusuna ait dönem hayat tablosudur (period life table). Belirli bir dönemin nüfus ölüm deneyimini özetler; sigorta başvurusu kabul edilmiş kişilerin seçilmiş mortalitesini (select mortality) göstermez. Bu nedenle bu dersteki prim sonuçları öğretim amaçlıdır ve ticari tarife olarak kullanılamaz.
Oturum sonunda öğrenci:
lifecontingencies sonucu ile karşılaştırır;| Süre | Etkinlik |
|---|---|
| 0–45 dk | Hayat tablosunun sütunları: olasılıklar, kişi-yıl ve ölüm hızı, kalan yaşam beklentisi, açık yaş aralığı |
| 45–75 dk | Küçük elle hesap, açık R kodu ve lifecontingencies ile karşılaştırma |
| 75–85 dk | Ara |
| 85–155 dk | TÜİK dosyalarının veri sözlüğü (ana tablo ve iki ek dosya) ve R Laboratuvarı |
| 155–175 dk | Cinsiyet, dönem, eğitim ve sağlıklı yaşam karşılaştırmaları |
| 175–180 dk | Haftanın özeti ve açık sorular |
Bir hayat tablosu, aynı yaşta başlayan varsayımsal bir grubun yaşlandıkça nasıl azaldığını izler ve her sütunu bu grup hakkında bir sorunun yanıtıdır. Sütunlar üç kümede toplanır: sayımlar ve olasılıklar (\(l_x\), \(d_x\), \(q_x\), \(p_x\)), kişi-yıl ve ölüm hızı (\(L_x\), \(m_x\)), kalan yaşam beklentisi (\(T_x\), \(e_x\)). Aşağıdaki tablo sekiz sütunu bir arada gösterir; bölümün geri kalanı onları bu sırayla tanımlar.
| Sütun | Yanıtladığı soru | Formül | Birim |
|---|---|---|---|
| \(l_x\) | \(x\) yaşına kaç kişi ulaşır? | Başlangıçta seçilir, örneğin \(l_0=100.000\) | kişi |
| \(d_x\) | \(x\) ile \(x+1\) yaşları arasında kaç kişi ölür? | \(l_x-l_{x+1}\) | kişi |
| \(q_x\) | \(x\) yaşındaki biri \(x+1\) yaşına gelmeden hangi olasılıkla ölür? | \(d_x/l_x\) | olasılık |
| \(p_x\) | \(x\) yaşındaki biri hangi olasılıkla \(x+1\) yaşına ulaşır? | \(l_{x+1}/l_x\) | olasılık |
| \(L_x\) | Grup \(x\) ile \(x+1\) yaşları arasında toplam kaç yıl yaşar? | \(l_{x+1}+a_x\,d_x\) | kişi-yıl |
| \(m_x\) | Yaşanan bir kişi-yıla kaç ölüm düşer? | \(d_x/L_x\) | ölüm / kişi-yıl |
| \(T_x\) | \(x\) yaşına ulaşanlar o yaştan sonra toplam kaç yıl yaşar? | \(L_x+L_{x+1}+\cdots\) | kişi-yıl |
| \(e_x\) | \(x\) yaşındaki biri ortalama kaç yıl daha yaşar? | \(T_x/l_x\) | yıl |
Formül sütunu hesabın sırasını da gösterir: her sütun kendinden öncekilerden hesaplanır. Tek istisna \(L_x\)’teki \(a_x\)’tir, yani ölenlerin öldükleri yıl içinde yaşadığı ortalama kesir; \(l_x\) sütunu onu söylemez ve kendi alt bölümünde ele alınacaktır.
Her sütunu aynı küçük örnek üzerinde hesaplayacağız. 80 yaşına ulaşmış 1.000 kişilik varsayımsal bir grup dört yıl içinde tamamen ölüyor:
| \(x\) | \(l_x\) |
|---|---|
| 80 | 1.000 |
| 81 | 800 |
| 82 | 500 |
| 83 | 200 |
| 84 | 0 |
Sayılar elle hesap kolay olsun diye seçildi ve gerçeğe göre çok yüksek bir ölümlülük taşır: örnekte \(q_{80}=0{,}2\) çıkacak, TÜİK’in 2023–2025 total tablosunda ise \(q_{80}\) yaklaşık 0,058’dir. Her sütun aynı dört adımla anlatılır: yanıtladığı soru, tanımı ve formülü, örnekte hesabı ve sonucun yorumu.
Bu kümenin dört sütunu yalnız \(l_x\)’ten hesaplanır; başka bir bilgi gerekmez.
Soru. Grubun kaç kişisi tam \(x\) yaşına ulaşır?
Tanım. \(l_x\) gerçek bir nüfus sayısı olmak zorunda değildir. Genellikle 100.000 gibi bir başlangıç büyüklüğünden (radix) ilerleyen varsayımsal bir kohorttur (cohort): aynı yaşta başlayıp yaşları boyunca izlenen bir grup. Grup kapalıdır: içine kimse girmez, ölüm dışında kimse ayrılmaz. Bu yüzden \(l_x\) yaşla artamaz; \(x+1\) yaşına ulaşan herkes \(x\) yaşına da ulaşmıştır.
Örnekte. Başlangıç büyüklüğü \(l_{80}=1.000\)’dir. Bu 1.000 kişiden 800’ü 81 yaşına, 500’ü 82 yaşına, 200’ü 83 yaşına ulaşır; 84 yaşına ulaşan yoktur.
Yorum. Başlangıç büyüklüğü yalnızca ölçeği belirler. 1.000 yerine 100.000 kişiyle başlasaydık bütün \(l_x\) değerleri 100 katına çıkardı; aşağıdaki olasılıklar, hız ve beklentiler ise değişmezdi, çünkü her biri aynı ölçekle büyüyen iki sayının oranıdır.
Soru. \(x\) yaşına ulaşanlardan kaçı \(x+1\) yaşına ulaşmadan ölür?
Tanım. Grup kapalı olduğu için \(x\) yaşına ulaşan \(l_x\) kişiden \(x+1\) yaşına ulaşamayanların hepsi o yıl ölmüştür:
\[ d_x=l_x-l_{x+1}. \]
Örnekte. \(d_{80}=1.000-800=200\), \(d_{81}=800-500=300\), \(d_{82}=500-200=300\) ve \(d_{83}=200-0=200\). Toplamları 1.000’dir: gruptaki herkes bu dört aralıktan birinde ölür.
Yorum. \(d_x\) bir sayımdır ve ölümlerin hangi yaşlarda yoğunlaştığını gösterir: örnekte en çok ölüm 81 ve 82 yaşlarındadır. Bu, ölüm riskinin orada en yüksek olduğu anlamına gelmez. 83 yaşında yalnızca 200 kişi ölür, çünkü geriye yalnızca 200 kişi kalmıştır. Riski ölçmek için ölüm sayısını o yaşa ulaşanların sayısına bölmek gerekir; bu bölüm \(q_x\)’tir.
Soru. \(x\) yaşındaki bir kişi \(x+1\) yaşına gelmeden hangi olasılıkla ölür (\(q_x\)), hangi olasılıkla \(x+1\) yaşına ulaşır (\(p_x\))? \(p_x\)’e bir yıllık sağkalım olasılığı (survival probability) denir.
Tanım. Ölenlerin ve yılı tamamlayanların sayısı, yaşa ulaşanların sayısına bölünür:
\[ q_x=\frac{d_x}{l_x},\qquad p_x=\frac{l_{x+1}}{l_x}. \]
İkisinin toplamı 1’dir, çünkü \(x\) yaşına ulaşan her kişi yılı ya tamamlar ya o yıl ölür: \(l_{x+1}+d_x=l_x\), dolayısıyla \(q_x=1-p_x\).
Örnekte.
| \(x\) | \(l_x\) | \(d_x\) | \(q_x\) | \(p_x\) |
|---|---|---|---|---|
| 80 | 1.000 | 200 | 0,200 | 0,800 |
| 81 | 800 | 300 | 0,375 | 0,625 |
| 82 | 500 | 300 | 0,600 | 0,400 |
| 83 | 200 | 200 | 1,000 | 0,000 |
Örneğin 81 yaşında \(q_{81}=300/800=0{,}375\) ve \(p_{81}=500/800=0{,}625\); toplamları 1’dir.
Yorum. 81 ve 82 yaşlarında ölüm sayıları eşitti, ikisi de 300; olasılıklar ise farklıdır, 0,375 ve 0,600. Aynı sayıda ölüm 82 yaşında daha küçük bir gruptan gelir ve daha yüksek bir riski gösterir. 83 yaşında \(q_{83}=1\)’dir: örnekte 83 yaşına ulaşan kimse 84’e ulaşmaz.
Soru. \(x\) yaşındaki bir kişi hangi olasılıkla \(t\) yıl daha yaşar? Bu çok yıllık sağkalım olasılığıdır (multi-year survival probability); tümleyeni \({}_tq_x\), \(t\) yıl içinde ölme olasılığıdır.
Tanım. \(x+t\) yaşına ulaşanlar, \(x\) yaşına ulaşanlara bölünür:
\[ {}_tp_x=\frac{l_{x+t}}{l_x}, \qquad {}_tq_x=1-{}_tp_x. \]
\(t=1\) olduğunda sol alt indis yazılmaz: \({}_1p_x=p_x\) ve \({}_1q_x=q_x\). \(t\) yıl yaşamak, art arda \(t\) yılın her birini tamamlamaktır; bu yüzden aynı olasılık bir yıllık olasılıkların çarpımıdır:
\[ {}_tp_x=p_x\,p_{x+1}\cdots p_{x+t-1}. \]
Türetmeler, varsayılanı kapalı Türetmeyi göster kutularındadır; metin yalnız sonuçları ve ne anlama geldiklerini verir.
\[ \begin{aligned} {}_tp_x&=\frac{l_{x+t}}{l_x}\\ &=\frac{l_{x+1}}{l_x}\cdot\frac{l_{x+2}}{l_{x+1}}\cdots\frac{l_{x+t}}{l_{x+t-1}}\\ &=p_x\,p_{x+1}\cdots p_{x+t-1}. \end{aligned} \]
Eşitlikler sırasıyla:
Örnekte. 80 yaşındaki birinin 82 yaşına ulaşma olasılığı iki yoldan aynı çıkar: \({}_2p_{80}=l_{82}/l_{80}=500/1.000=0{,}5\) ve \(p_{80}\,p_{81}=0{,}8\times0{,}625=0{,}5\). Üç yıl için de öyle: \({}_3p_{80}=200/1.000=0{,}2\) ve \(p_{80}\,p_{81}\,p_{82}=0{,}8\times0{,}625\times0{,}4=0{,}2\). Tümleyenler \({}_2q_{80}=0{,}5\) ve \({}_3q_{80}=0{,}8\)’dir: 80 yaşındaki grubun yarısı iki yıl içinde, %80’i üç yıl içinde ölür.
Yorum. Her çarpan, o yaşa ulaşmış olanlar arasında hesaplanan koşullu bir olasılıktır: \(p_{81}=0{,}625\), 80 yaşındaki 1.000 kişiden değil, 81 yaşına ulaşan 800 kişiden hesaplanır. Kaplan–Meier tahminini de aynı nedenle çarpım olarak kurmuştuk (Hafta 6, Kaplan–Meier tahmini bölümü). Hafta 6’nın sağkalım fonksiyonu \(S(t)=P(T>t)\) ile bağ da buradadır: \(T\), \(x\) yaşındaki bir kişinin kalan ömrü olarak alınırsa \(S(t)={}_tp_x\) olur. Hayat tablosu bu fonksiyonu yalnızca tam yıllarda verir.
Olasılıklar kimin hangi yıl öldüğünü sayar, yıl içinde ne zaman öldüğünü sormaz. Bu kümenin iki sütunu o süreyi de hesaba katar.
Soru. Grup \(x\) ile \(x+1\) yaşları arasında toplam kaç yıl yaşar?
Tanım. Bir kişinin bir yıl boyunca yaşaması bir kişi-yıldır; Hafta 1’deki poliçe-yılın kişi karşılığıdır. \(x+1\) yaşına ulaşan \(l_{x+1}\) kişi aralığın tamamını, yani birer yıl yaşar. Ölen \(d_x\) kişi ise yılın yalnızca bir kesrini yaşar; ölenlerin öldükleri yıl içinde yaşadığı ortalama kesre \(a_x\) diyelim:
\[ L_x=l_{x+1}+a_x\,d_x. \]
\(l_x\) sütunu \(a_x\)’i söylemez, çünkü kişilerin yıl içinde ne zaman öldüğünü kaydetmez; bir varsayım gerekir. En yaygını ölümlerin düzgün dağılımı varsayımıdır (uniform distribution of deaths, UDD): ölümler yıl içine eşit dağılır ve ölenler ortalama yarım yıl yaşar, \(a_x=0{,}5\). Bu varsayımla kişi-yıl, yılın başındaki ve sonundaki kişi sayılarının ortalamasıdır:
\[ L_x=\frac{l_x+l_{x+1}}{2}. \]
Genel tanımdan, \(a_x=0{,}5\) ile:
\[ \begin{aligned} L_x&=l_{x+1}+\frac{d_x}{2}\\ &=(l_x-d_x)+\frac{d_x}{2}\\ &=l_x-\frac{d_x}{2}\\ &=l_x-\frac{l_x-l_{x+1}}{2}\\ &=\frac{l_x+l_{x+1}}{2}. \end{aligned} \]
Eşitlikler sırasıyla:
Bu sonucun bir geometrisi vardır. Kişi-yıl, yıl boyunca hayatta olanların sayısının zaman içindeki toplamıdır, yani \(l\) eğrisinin \(x\) ile \(x+1\) arasındaki alanı: \(L_x=\int_0^1 l_{x+t}\,dt\). Ölümler yıl içine eşit dağılınca \(t\) yıl sonra \(t\,d_x\) kişi ölmüştür ve eğri \(l_{x+t}=l_x-t\,d_x\) doğrusudur. Altındaki alan, paralel kenarları \(l_x\) ile \(l_{x+1}\), genişliği bir yıl olan bir yamuktur ve alanı iki kenarın ortalamasıdır.
\(l_{x+t}=l_x-t\,d_x\) doğrusunun \(0\)’dan \(1\)’e integrali alınır:
\[ \begin{aligned} L_x&=\int_0^1 (l_x-t\,d_x)\,dt\\ &=\Bigl[l_x\,t-\frac{t^2}{2}\,d_x\Bigr]_0^1\\ &=l_x-\frac{d_x}{2}. \end{aligned} \]
Son satır, yukarıdaki kutunun üçüncü satırıdır; oradan \((l_x+l_{x+1})/2\)’ye aynı adımlarla gidilir.
Örnekte. 80 yaşında yılı tamamlayan 800 kişi birer yıl, ölen 200 kişi ortalama yarım yıl yaşar: \(L_{80}=800+0{,}5\times200=900\) kişi-yıl. Aynı sayı iki kenarın ortalamasıdır, \((1.000+800)/2=900\). Öteki yaşlarda \(L_{81}=(800+500)/2=650\), \(L_{82}=(500+200)/2=350\) ve \(L_{83}=(200+0)/2=100\)’dür.
Yorum. \(L_x\) her zaman \(l_{x+1}\) ile \(l_x\) arasındadır: yılı tamamlayanların yılları, artı ölenlerin yaşadığı kesir. Ölüm ne kadar çoksa \(L_x\), \(l_x\)’ten o kadar uzaklaşır: \(L_{80}=900\), \(l_{80}\)’in %90’ıdır; \(L_{83}=100\) ise \(l_{83}\)’ün yalnızca yarısıdır.
Soru. Yaşanan bir kişi-yıla kaç ölüm düşer?
Tanım. Merkezi ölüm hızı (central death rate), aralıktaki ölüm sayısını aralıkta yaşanan kişi-yıla böler:
\[ m_x=\frac{d_x}{L_x}. \]
Hafta 6’daki hazard gibi bir hızdır: payı olay sayısı, paydası risk altında geçen süredir.
Örnekte. \(m_{80}=200/900=0{,}2222\), \(m_{81}=300/650=0{,}4615\), \(m_{82}=300/350=0{,}8571\) ve \(m_{83}=200/100=2\).
Yorum. \(m_{83}=2\) bir olasılık olamaz, olması da gerekmez. 83 yaşına ulaşan 200 kişinin hepsi yıl içinde ölür; ortalama yalnızca yarım yıl yaşadıkları için 100 kişi-yıla 200 ölüm düşer, yaşanan her kişi-yıla iki ölüm. Bir hızın üst sınırı yoktur; bir olasılık ise 1’i aşamaz.
Aynı tanım ters yönden kişi-yılı verir: ölüm sayısı ve ölüm hızı biliniyorsa \(L_x=d_x/m_x\)’tir. TÜİK dosyası \(m_x\)’i yayımladığı için Görev B kişi-yılı bu yoldan kurar ve \(a_x\) için bir varsayıma gerek kalmaz.
İki ölçünün payı aynıdır: yıl içindeki ölüm sayısı. Paydaları farklıdır: \(q_x\) yılın başındaki kişi sayısına (\(l_x\)), \(m_x\) yıl boyunca fiilen yaşanan kişi-yıla (\(L_x\)) bölünür. Ölenler yılın tamamını yaşamadığı için \(L_x<l_x\)’tir ve \(m_x\), \(q_x\)’ten büyük çıkar. Birini ötekinin yerine koymak, ileri yaşlarda ölüm riskini sistematik olarak yanlış gösterir. Örnekte iki ölçü yan yana:
| \(x\) | \(q_x\) | \(m_x\) | \(m_x/q_x\) |
|---|---|---|---|
| 80 | 0,200 | 0,2222 | 1,111 |
| 81 | 0,375 | 0,4615 | 1,231 |
| 82 | 0,600 | 0,8571 | 1,429 |
| 83 | 1,000 | 2,0000 | 2,000 |
Fark ölümlülükle büyür. \(q_x\) küçükken ölenlerin yaşamadığı süre azdır ve iki ölçü birbirine yakındır: 80 yaşında \(m_x\), \(q_x\)’ten %11 büyüktür. \(q_x\) büyüdükçe \(L_x\), \(l_x\)’ten uzaklaşır; 83 yaşında \(m_x\), \(q_x\)’in iki katıdır. Gerçek tabloda ölümlülük çok daha düşük olduğu için fark da küçüktür: mx ile qx arasındaki göreli fark 30 yaşında %0,04, 80 yaşında %3 dolayındadır. Alıştırma 2 bu farkı üç yaş için hesaplatır.
Düzgün dağılım varsayımı iki ölçüyü birbirine bağlar; biri bilinince öteki hesaplanır:
\[ \begin{aligned} m_x&=\frac{q_x}{1-q_x/2},\\ q_x&=\frac{m_x}{1+m_x/2}. \end{aligned} \]
İlk ilişki için \(m_x\)’in pay ve paydası \(l_x\)’e bölünür:
\[ \begin{aligned} m_x&=\frac{d_x}{l_x-d_x/2}\\ &=\frac{d_x/l_x}{1-d_x/(2\,l_x)}\\ &=\frac{q_x}{1-q_x/2}. \end{aligned} \]
Eşitlikler sırasıyla:
İkinci ilişki, birincinin \(q_x\) için çözülmesidir:
\[ \begin{aligned} m_x\Bigl(1-\frac{q_x}{2}\Bigr)&=q_x\\ m_x-\frac{m_x\,q_x}{2}&=q_x\\ m_x&=q_x+\frac{m_x\,q_x}{2}\\ m_x&=q_x\Bigl(1+\frac{m_x}{2}\Bigr)\\ q_x&=\frac{m_x}{1+m_x/2}. \end{aligned} \]
Satırlar sırasıyla:
Örnekte 82 yaşında \(m_{82}=300/350=6/7\)’dir. İkinci ilişki tablodaki \(q_{82}\)’yi geri verir:
\[ \begin{aligned} q_{82}&=\frac{m_{82}}{1+m_{82}/2}\\ &=\frac{6/7}{1+3/7}\\ &=\frac{6/7}{10/7}=0{,}6. \end{aligned} \]
Varsayım gerçek tabloda her yaşta aynı ölçüde tutmaz. \(L_x=l_{x+1}+a_x\,d_x\), \(m_x\)’in tanımına konunca \(a_x\) yayımlanan iki sütundan geri çözülür:
\[ a_x=1-\frac{1}{q_x}+\frac{1}{m_x}. \]
\(m_x=d_x/(l_{x+1}+a_x\,d_x)\)’in tersinden başlıyoruz:
\[ \begin{aligned} \frac{1}{m_x}&=\frac{l_{x+1}+a_x\,d_x}{d_x}\\ &=\frac{l_x-d_x+a_x\,d_x}{d_x}\\ &=\frac{l_x-(1-a_x)\,d_x}{d_x}\\ &=\frac{l_x}{d_x}-(1-a_x)\\ &=\frac{1}{q_x}-(1-a_x). \end{aligned} \]
Eşitlikler sırasıyla:
Son satırda \(1-a_x\) sola, \(1/m_x\) sağa geçince \(1-a_x=1/q_x-1/m_x\) olur ve yukarıdaki formül çıkar. \(a_x=0{,}5\) konunca düzgün dağılımdaki ilişkiye dönülür:
\[ \begin{aligned} \frac{1}{m_x}&=\frac{1}{q_x}-\frac{1}{2}\\ &=\frac{2-q_x}{2\,q_x}\\ m_x&=\frac{2\,q_x}{2-q_x}\\ &=\frac{q_x}{1-q_x/2}. \end{aligned} \]
İkinci satırda kesirler ortak paydada toplandı, üçüncüde iki yanın tersi alındı, dördüncüde pay ve payda 2’ye bölündü.
Örnekte \(L_x\)’i düzgün dağılımla kurduğumuz için formül her yaşta 0,5 vermelidir. 80 yaşında \(1/q_{80}=1/0{,}2=5\) ve \(1/m_{80}=900/200=4{,}5\)’tir; \(a_{80}=1-5+4{,}5=0{,}5\).
2023–2025 total tablosunda ise \(a_x\) kendi başına ölçülür: 1 ile 99 yaş arasında 0,46 ile 0,52 arasında kalır; düzgün dağılım varsayımı bu yaşlarda iyi bir yaklaşımdır. 0 yaşında ise \(a_0=0{,}15\)’tir: o yıl ölen bebekler yılın ortalama yalnızca %15’ini yaşar.
Bebek ölümleri doğumu izleyen ilk günlerde ve haftalarda yoğunlaşır; dosya ölüm tarihlerini taşımadığı için bunu doğrudan göremeyiz, \(a_0\) bu yoğunlaşmanın tablodaki izidir. Görev B’de kişi-yılı yalnızca \(l_x\)’ten değil \(m_x\)’ten kurmamızın nedeni budur; Görev B \(a_x\)’i bütün yaşlar için de hesaplar.
Son küme, bir yaşa ulaşanların o yaştan sonra ne kadar yaşadığını sorar. İki sütun da \(L_x\) sütunundan kurulur.
Soru. \(x\) yaşına ulaşan \(l_x\) kişi o yaştan sonra toplam kaç yıl yaşar?
Tanım. \(x\) yaşından tablonun sonuna kadar bütün kişi-yıllar toplanır:
\[ T_x=L_x+L_{x+1}+\cdots=\sum_{y\ge x}L_y. \]
Örnekte. Toplam en kolay tablonun sonundan başlayarak kurulur; her satır, bir sonraki satırın \(T\)’sine kendi \(L\)’sini ekler: \(T_{83}=L_{83}=100\), \(T_{82}=350+100=450\), \(T_{81}=650+450=1.100\) ve \(T_{80}=900+1.100=2.000\) kişi-yıl.
Yorum. \(T_x\), \(x\) yaşına ulaşanların kalan ömürlerinin toplamıdır. Bunu görmek için 1.000 kişiyi öldükleri yaş aralığına göre dört gruba ayıralım ve her grubun her yaş aralığında yaşadığı kişi-yılı bir hücreye yazalım. Bir grup, öldüğü aralığa kadar her aralıkta kişi başına bir yıl yaşar; öldüğü aralıkta, düzgün dağılım varsayımıyla, kişi başına yarım yıl:
| Öldüğü aralık | Kişi | 80–81 | 81–82 | 82–83 | 83–84 | Kalan ömür |
|---|---|---|---|---|---|---|
| 80–81 | 200 | 100 | 0 | 0 | 0 | 100 |
| 81–82 | 300 | 300 | 150 | 0 | 0 | 450 |
| 82–83 | 300 | 300 | 300 | 150 | 0 | 750 |
| 83–84 | 200 | 200 | 200 | 200 | 100 | 700 |
| Toplam | 1.000 | 900 | 650 | 350 | 100 | 2.000 |
Sütun toplamları yaş yaş kişi-yıllardır, \(L_{80}\)’den \(L_{83}\)’e. Satır toplamları grup grup kalan ömürlerdir: örneğin 81 ile 82 yaşları arasında ölen 300 kişi, 80 yaşından sonra 1,5’er yıl, toplam 450 yıl yaşar. Aynı hücreler iki yönden toplanınca aynı 2.000 çıkar; bu yüzden \(T_{80}\), 1.000 kişinin 80 yaşından sonraki ömürlerinin toplamıdır.
Soru. \(x\) yaşındaki bir kişi ortalama kaç yıl daha yaşar? Bu, kalan yaşam beklentisidir (life expectancy).
Tanım. Kalan ömürlerin toplamı kişi sayısına bölünür:
\[ e_x=\frac{T_x}{l_x}. \]
Pay kişi-yıl, payda kişi olduğu için oran kişi başına yıl verir.
Örnekte. \(e_{80}=2.000/1.000=2\), \(e_{81}=1.100/800=1{,}375\), \(e_{82}=450/500=0{,}9\) ve \(e_{83}=100/200=0{,}5\) yıl.
Yorum. Bir yıl yaşlanmak beklentiyi bir yıl düşürmez: \(e_{81}=1{,}375\), \(e_{80}-1=1\)’den büyüktür. 81 yaşına ulaşanlar, 80 ile 81 arasında ölen 200 kişiyi geride bırakmış olanlardır ve kalan ömürleri bu yüzden daha uzundur. Her \(e_x\) yalnızca o yaşa ulaşanlar arasında hesaplanan bir ortalamadır.
\(e_x\) yıl içinde yaşanan kesirleri de sayar; bu yüzden ona tam beklenti (complete expectation) denir. Yalnızca tamamlanan tam yılları sayan ölçü ise kesikli beklentidir (curtate expectation): kişinin \(x\) yaşından sonra tamamladığı tam yıl sayısına \(K\) dersek kesikli beklenti \(E[K]\)’dır ve her yıla ulaşma olasılıklarının toplamıdır:
\[ E[K]={}_1p_x+{}_2p_x+{}_3p_x+\cdots \]
\(K\), \(k=1,2,\dots\) için “\(x+k\) yaşına ulaştı mı?” sorularından kaçına evet dendiğidir. \(I_k\), \(k\)’ıncı soruya evet denirse 1, hayır denirse 0 olsun; \(K\) bu değişkenlerin toplamıdır, \(K=I_1+I_2+\cdots\):
\[ \begin{aligned} E[K]&=E[I_1+I_2+\cdots]\\ &=E[I_1]+E[I_2]+\cdots\\ &=P(I_1=1)+P(I_2=1)+\cdots\\ &={}_1p_x+{}_2p_x+\cdots \end{aligned} \]
Eşitlikler sırasıyla:
Bu, Hafta 3’ün Sıfır başlangıçlı Pareto / Pareto II bölümünde ortalamayı veren \(E[X]=\int_0^\infty S(t)\,dt\) formülünün tam yıllardaki karşılığıdır. \(S(t)={}_tp_x\) olduğu için tam beklenti integralin kendisidir: \(e_x=\int_0^\infty{}_tp_x\,dt\).
Örnekte. Ölüm aralığı tablosundaki gruplar tamamlanan yılları doğrudan verir: 80 ile 81 arasında ölenler 80 yaşından sonra tam yıl tamamlamaz, 81–82’de ölenler 1, 82–83’te ölenler 2, 83–84’te ölenler 3 tam yıl tamamlar. Her grubun kişi sayısı tamamladığı yıl sayısıyla çarpılıp toplanınca \(200\times0+300\times1\) \(+300\times2+200\times3\) \(=1.500\) yıl çıkar; ortalama \(1.500/1.000=1{,}5\) yıldır. Olasılıklarla da aynı sayı bulunur: \({}_1p_{80}+{}_2p_{80}+{}_3p_{80}\) \(=0{,}8+0{,}5+0{,}2\) \(=1{,}5\); \({}_4p_{80}=0\) olduğu için toplam burada biter.
Yorum. Kesikli beklenti tam beklentiden \(2-1{,}5=0{,}5\) yıl küçüktür. Fark, ölenlerin öldükleri yıl içinde yaşadığı kesirlerin ortalamasıdır: kalan ömrü tamamlanan yıllar \(K\) ile ölüm yılında yaşanan kesir \(R\)’nin toplamı olarak yazınca
\[ e_x=E[K]+E[R]. \]
Kalan ömür \(T\), kişinin tamamladığı yılların sayısı ile öldüğü yılda yaşadığı \(R\) kesrinin toplamıdır: \(T=K+R\), \(0\le R<1\). Beklenti alınınca
\[ \begin{aligned} e_x&=E[T]\\ &=E[K+R]\\ &=E[K]+E[R]. \end{aligned} \]
Eşitlikler sırasıyla:
Kişi \(x+k\) yaşında ölüyorsa \(R\)’nin ortalaması \(a_{x+k}\)’dır; düzgün dağılımda her yaşta \(a_x=0{,}5\) olduğu için fark tam yarım yıl olur.
Örnekte \(L_x\)’i düzgün dağılımla kurduğumuz için herkes öldüğü yılın ortalama yarısını yaşar ve \(E[R]\) tam 0,5’tir. Gerçek tabloda ölümler yıl içine tam eşit dağılmaz; fark yine yarım yıl dolayındadır, Görev B’de 0,55 yıl çıkar ve yarım yılın üstündeki kısmın gerçek \(a_x\)’lerden geldiği orada ölçülür.
Aktüerya kitapları, örneğin Dickson, Hardy ve Waters (Bölüm 2.5–2.6), \(e_x\) simgesini kesikli beklentiye ayırır ve tam beklentiyi \(\mathring{e}_x\) diye yazar; aynı kitaplarda \(T_x\) de kişi-yıl toplamı değil, kalan ömrün kendisidir. Bu sayfa TÜİK’in sütun adlarını izler: \(e_x\) tam beklenti, \(T_x\) kişi-yıl toplamıdır.
100+ gibi son satır bir açık yaş aralığıdır (open age interval): tek bir yaşı değil, 100 ve üzerindeki bütün yaşları kapsar ve bir sonraki tek yaşı yoktur. Bu nedenle lead(lx) ile hesaplanan \(d_x\) ve \(p_x\) bu satırda eksik kalır. Bu hata değil, açık aralığın veri yapısından doğan bir sınırdır.
Satırın sütunları yine de bellidir, yalnızca başka yoldan:
Kalan yaşam beklentisi bu yüzden yalnızca ölüm hızından gelir:
\[ e_{100+}=\frac{1}{m_{100+}}. \]
\[ \begin{aligned} e_{100+}&=\frac{T_{100+}}{l_{100}}\\ &=\frac{L_{100+}}{l_{100}}\\ &=\frac{d_{100+}/m_{100+}}{l_{100}}\\ &=\frac{l_{100}/m_{100+}}{l_{100}}\\ &=\frac{1}{m_{100+}}. \end{aligned} \]
Eşitlikler sırasıyla:
Sonucun anlamı da basittir: \(m_{100+}\) kişi-yıl başına düşen ölüm sayısıysa \(1/m_{100+}\) bir ölüm başına düşen kişi-yıldır; aralığa ulaşan herkes orada öldüğü için bu, kişi başına düşen yıl sayısıdır. Açık aralığın kalan yaşam beklentisi bu yüzden \(q_x\)’ten değil \(m_x\)’ten gelir. Örnekteki 83 yaşı da böyle bir son satırdır: oraya ulaşan herkes orada ölür ve \(1/m_{83}=1/2=0{,}5\), \(T_{83}/l_{83}=100/200\) ile aynı sayıdır. Görev B, dosyanın ex sütununu bu adımlarla lx ve mx sütunlarından yeniden üretir.
Sekiz sütun, örneğin dört yaşı için bir arada:
| \(x\) | \(l_x\) | \(d_x\) | \(q_x\) | \(p_x\) | \(L_x\) | \(m_x\) | \(T_x\) | \(e_x\) |
|---|---|---|---|---|---|---|---|---|
| 80 | 1.000 | 200 | 0,200 | 0,800 | 900 | 0,2222 | 2.000 | 2,000 |
| 81 | 800 | 300 | 0,375 | 0,625 | 650 | 0,4615 | 1.100 | 1,375 |
| 82 | 500 | 300 | 0,600 | 0,400 | 350 | 0,8571 | 450 | 0,900 |
| 83 | 200 | 200 | 1,000 | 0,000 | 100 | 2,0000 | 100 | 0,500 |
Her sütun kendinden öncekilerden hesaplandı; dışarıdan gelen tek bilgi, \(L_x\)’te kullanılan düzgün dağılım varsayımıdır. TÜİK dosyası bu sütunlardan \(l_x\), \(q_x\), \(m_x\) ve \(e_x\)’i yayımlar; Görev B geri kalan dördünü, \(d_x\), \(p_x\), \(L_x\) ve \(T_x\)’i, yayımlanan sütunlardan kurar ve \(e_x\)’i yeniden üretir.
Tanımlar bölümündeki örnek her sütunu elle göstermek içindi. Bu bölümün üç satırlık yapay tablosunu ise ardından R’de kuracak ve sonucu lifecontingencies paketiyle karşılaştıracağız:
| Yaş | \(l_x\) |
|---|---|
| 60 | 90.000 |
| 61 | 89.100 |
| 62 | 88.120 |
60 yaşı için
\[ \begin{aligned} d_{60}&=90.000-89.100=900,\\ p_{60}&=\frac{89.100}{90.000}=0{,}990,\\ q_{60}&=\frac{900}{90.000}=0{,}010. \end{aligned} \]
Kontrol: \(p_{60}+q_{60}=1\). Yani 60 yaşındaki varsayımsal grubun %99’u 61 yaşına ulaşırken %1’i yıl içinde ölür.
61 yaşı için aynı üç formül:
\[ \begin{aligned} d_{61}&=89.100-88.120=980,\\ p_{61}&=\frac{88.120}{89.100}=0{,}989001,\\ q_{61}&=\frac{980}{89.100}=0{,}010999. \end{aligned} \]
62 yaşı için \(d_{62}\) bulunamaz, çünkü tabloda \(l_{63}\) yoktur. İki yıllık sağkalım olasılığı iki bir yıllık olasılığın çarpımıdır ve \(l_{62}/l_{60}\) oranıyla aynı sayıyı verir:
\[ \begin{aligned} {}_2p_{60}&=p_{60}\,p_{61}\\ &=0{,}99\times0{,}989001\\ &=0{,}979111. \end{aligned} \]
Bu hafta kullanılan paketleri en başta yüklüyoruz:
library(readr)
library(dplyr)
library(tibble)
library(ggplot2)
library(scales)
library(lifecontingencies)Çalışılmış örnekteki üç satırlık tabloyu önce R’de bir çerçeveye yazıyoruz:
kucuk_tablo <- tibble(
  age_start = 60:62,
  lx = c(90000, 89100, 88120)
)

kucuk_tablo
#> # A tibble: 3 × 2
#> age_start lx
#> <int> <dbl>
#> 1 60 90000
#> 2 61 89100
#> 3 62 88120Çerçevede yalnızca iki sütun vardır: yaş ve o yaşa ulaşan kişi sayısı. \(d_x\), \(p_x\) ve \(q_x\) bu ikisinden üretilecek.
Şimdi formülü açıkça kodlayalım:
elle_hesap <- kucuk_tablo |>
  mutate(
    dx = lx - lead(lx),
    px = lead(lx) / lx,
    qx = dx / lx,
    toplam = px + qx
  )

elle_hesap
#> # A tibble: 3 × 6
#> age_start lx dx px qx toplam
#> <int> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 60 90000 900 0.99 0.01 1
#> 2 61 89100 980 0.989 0.0110 1
#> 3 62 88120 NA NA NA NAlead(x) — vektörü bir satır yukarı kaydırır, yani her satıra bir sonraki satırın değerini getirir. \(d_x = l_x - l_{x+1}\) gibi ardışık fark formüllerinin R’deki doğrudan karşılığı budur. Son satırın bir sonrası olmadığı için orada NA üretir: küçük tabloda 62 yaşının ardılı yoktur. Gerçek dosyada aynı durum açık yaş aralığı olan 100+ satırında ortaya çıkar.Çıktının ilk satırında \(d_{60}=900\), \(p_{60}=0{,}99\) ve \(q_{60}=0{,}01\) ile toplam sütununda 1 görmelisiniz. İkinci satır 61 yaşınındır: \(d_{61}=980\), \(p_{61}=0{,}989\) ve \(q_{61}=0{,}0110\); tibble sayıları üç anlamlı basamağa kısaltarak bastığı için elle bulduğumuz 0,989001 ve 0,010999 böyle görünür. 62 yaşı satırında bir sonraki \(l_x\) bulunmadığı için NA çıkar.
Denetimi, Hafta 1’deki isTRUE(all.equal(...)) ve stopifnot() kalıbıyla ayrı bir blokta yapıyoruz; qx60_kontrol bu karşılaştırmanın bayrağıdır:
qx60_kontrol <- isTRUE(all.equal(elle_hesap$qx[1], 0.01))
stopifnot(qx60_kontrol)
list(sonuclar = c(elle = elle_hesap$qx[1], beklenen = 0.01), uyumlu = qx60_kontrol)
#> $sonuclar
#> elle beklenen
#> 0.01 0.01
#>
#> $uyumlu
#> [1] TRUEListede elle bulunan değer ile beklenen 0,01 yan yana durur; uyumlu alanı TRUE olmalıdır.
Çok yıllık sağkalım olasılığı, bir yıllık olasılıkların birikimli çarpımıdır. px sütununun ilk iki değerini Hafta 6’da Kaplan–Meier için kullandığımız cumprod() ile çarpalım.
cok_yillik_sagkalim <- cumprod(elle_hesap$px[1:2])

cok_yillik_sagkalim
#> [1] 0.9900000 0.9791111İki sayı \(p_{60}=0{,}99\) ve \({}_2p_{60}=0{,}9791111\)’dir; ikincisi çalışılmış örnekteki \(l_{62}/l_{60}\) ile aynıdır. Üçüncü değer alınmadı, çünkü 62 yaşında px NA’dır ve NA ile çarpım NA verir.
lifecontingencies paketiyle karşılaştırmaKüçük tablonun \(l_x\) dizisini paketin hayat tablosu nesnesine dönüştürelim:
kucuk_hayat_tablosu <- new(
  "lifetable",
  x = kucuk_tablo$age_start,
  lx = kucuk_tablo$lx,
  name = "Küçük öğretim tablosu"
)

kucuk_hayat_tablosu
#> Life table Küçük öğretim tablosu
#>
#> x lx px ex
#> 1 60 90000 0.9900000 0
#> 2 61 89100 0.9890011 0new("lifetable", ...) — lifecontingencies paketinin tanımladığı bir S4 sınıfından (S4 class) nesne kurar. Nesnenin yuvaları (slots) — x, lx, name — ada göre eşleşir, sıraya göre değil. Sınıfın bir geçerlilik denetimi vardır: yaşlar ile kişi sayıları yer değiştirirse nesne hiç kurulmaz ve invalid class "lifetable" object: x must be consecutive integers hatası verir. Üç yuva nesnenin bütün bilgisidir: \(q_x\) ya da \(m_x\) için yuva yoktur; paket her olasılığı ve beklentiyi çağrıldığı anda lx’ten hesaplar. Nesne kendini yazdırırken adını, ardından x, lx, px ve ex sütunlarını gösterir. İki ayrıntıya dikkat edin: 62 yaşı satırı listede yoktur — bu, yukarıdaki NA değerlerini üreten sınırın paket çıktısındaki karşılığıdır; ex sütunu ise sıfır çıkar, çünkü paketin yazdırma yöntemi kalan yaşam beklentisini yaşın kendisinden değil satır sırasından okur ve bu tablo 0 değil 60 yaşından başlar. Karşılaştırmada kullanacağımız değerler bu sütundan değil, aşağıdaki iki çağrıdan gelir.
Önce paketin bir yıllık sağkalım olasılığını istiyoruz:
paket_px <- pxt(kucuk_hayat_tablosu, x = 60, t = 1)

paket_px
#> [1] 0.99pxt(tablo, x, t) — x yaşındaki bir kişinin t yıl daha yaşama olasılığını, yani yukarıda tanımlanan \({}_tp_x=l_{x+t}/l_x\)’i verir; adı bu simgenin okunuşudur. t = 1 bir yıllık sağkalım olasılığıdır.Çıktı, elle bulduğumuz \(p_{60}\) ile aynı olmalıdır.
Aynı yaş için bir yıllık ölüm olasılığını da paketten alıyoruz:
paket_qx <- qxt(kucuk_hayat_tablosu, x = 60, t = 1)

paket_qx
#> [1] 0.01qxt(tablo, x, t) — aynı imzanın ölme karşılığı, yani \({}_tq_x\). İkisi tamamlayıcıdır: pxt(...) + qxt(...) her zaman 1 verir. Aşağıdaki doğrulama ise ikisini ayrı ayrı, elle bulunan değerlerle karşılaştırır.Bu değer de elle bulduğumuz \(q_{60}\) ile aynı olmalıdır.
Karşılaştırmayı iki bayrağa ayırıyoruz; ilki \(p_x\) içindir:
px_kontrol <- isTRUE(all.equal(elle_hesap$px[1], paket_px))

px_kontrol
#> [1] TRUEİkinci bayrak \(q_x\) içindir. stopifnot() ikisini birlikte denetler; liste ise karşılaştırılan değerleri de gösterdiği için bir uyuşmazlık okunabilir olur:
qx_kontrol <- isTRUE(all.equal(elle_hesap$qx[1], paket_qx))
stopifnot(px_kontrol, qx_kontrol)
list(
  px = c(elle = elle_hesap$px[1], paket = paket_px),
  qx = c(elle = elle_hesap$qx[1], paket = paket_qx),
  uyumlu = c(px = px_kontrol, qx = qx_kontrol)
)
#> $px
#> elle paket
#> 0.99 0.99
#>
#> $qx
#> elle paket
#> 0.01 0.01
#>
#> $uyumlu
#> px qx
#> TRUE TRUEListedeki uyumlu alanının iki öğesi de TRUE olmalıdır.
Burada paket, formülün yerine geçmez. Formülü farklı bir uygulama üzerinden yeniden hesaplayarak kodumuzdaki indeksleme hatalarını yakalamaya yardım eder.
Paket kesirli bir süre için de olasılık verir. Tabloda yalnızca tam yaşların \(l_x\)’i bulunur; aradaki kesirli yaşlar için yıl içine dair bir varsayım gerekir. 60 yaşındaki bir kişinin altı ay daha yaşama olasılığını isteyelim.
paket_yarim_yil <- pxt(kucuk_hayat_tablosu, x = 60, t = 0.5)

paket_yarim_yil
#> [1] 0.995Çıktı 0,995’tir. Paket ölümlerin düzgün dağılımı varsayımını kullanır, yani yukarıda \(L_x\) için kurduğumuz \(l_{x+t}=l_x-t\,d_x\) doğrusunu: \(l_{60{,}5}=90.000-0{,}5\times900\) \(=89.550\) ve \(89.550/90.000=0{,}995\). Yarım yılda bir yıllık ölümlerin yarısı gerçekleşir. Aynı 89.550, bu varsayımla \(L_{60}=(90.000+89.100)/2\)’dir: bir doğrunun altındaki alan, orta noktadaki yüksekliğine eşittir.
fractional = "linear" — pxt()’nin varsayılanıdır, bu yüzden çağrıda yazılmamıştır. t tam sayı değilse iki tam yaşın arasını \(l\)’yi doğrusal alarak doldurur; bu, ölümlerin düzgün dağılımıdır. fractional = "constant force" ise yıl içinde sabit bir ölüm hızı varsayar ve 0,994987 verir; fark beşinci ondalık basamaktadır, çünkü \(q_{60}\) küçüktür. Paketin kalan yaşam beklentisini veren işlevi exn()’dir. Aynı küçük tabloda 60 yaşı için isteyelim.
paket_ex60 <- exn(kucuk_hayat_tablosu, x = 60)

paket_ex60
#> [1] 1.969111Çıktı 1,969111 olmalıdır: \(p_{60}+{}_2p_{60}=0{,}99+0{,}979111\), yani kesikli beklenti; yukarıdaki cok_yillik_sagkalim’in iki değerinin toplamı.
exn(tablo, x) — x yaşındaki bir kişinin kalan yaşam beklentisini verir. Varsayılan olarak yukarıda tanımlanan kesikli beklentiyi döndürür ve onu tanımdaki toplamla hesaplar: pxt()’yi \(t=1, 2, \dots\) için çağırıp toplar. Tam beklenti type = "complete" ile istenir (Görev B); o hesapta paket her yaşta \(L_x=l_x-d_x/2\) alır, yani ölenlere öldükleri yılın yarısını verir (\(a_x=0{,}5\)). Bu sayı 60 yaşındaki bir kişinin gerçek yaşam beklentisi değildir. Paket tablonun son satırından sonra kimsenin yaşamadığını varsayar (\(l_{63}=0\)), bu yüzden yalnızca üç satırın izin verdiği yılları sayar. Gerçek tabloda aynı varsayım açık aralıkta ortaya çıkar: Görev B’de paketin sonucu TÜİK’in ex sütunundan ayrışır.
tuik_life_table.csv neyi anlatıyor?Buraya kadar sütunları ders kitabı tanımlarıyla ve üç satırlık bir öğretim tablosuyla kurduk. Laboratuvar aynı büyüklükleri TÜİK’in gerçek dosyasında arayacak; bu bölüm onların dosyada hangi adla, hangi tiple ve hangi kodlamayla durduğunu söyler. Laboratuvarın bütün denetimleri “sütun ne söylüyor?” sorusuna dayanacak; o hâlde sözlüğü dosyayı okumadan önce yazalım.
Dosya nedir? TÜİK’in yayımladığı, Türkiye nüfusuna ait tek yaş adımlı dönem hayat tablosu. Bir sigorta portföyünün değil, ülkede yaşayan herkesin belirli bir üç yıllık dönemdeki ölüm deneyiminin yaş yaş özetidir; dosyanın bir iş kolu yoktur.
Nereden geldi? Kaynak, TÜİK’in Hayat Tabloları, 2023-2025 yayınıdır (kaynak sayfası). Lisans notu “TÜİK’in yayımladığı tablodur; kaynak gösterimi ve portal koşulları geçerlidir” biçimindedir; derste kullanılan kopya 24 Ağustos 2026 tarihinde alınmıştır. Üç bilginin de yazılı olduğu yer data_manifest.csv dosyasıdır ve buradaki cümleler oradaki İngilizce notların Türkçesidir. Dosya dönem boyunca değişmez — dersin sabit kopyasıdır. Bunun tek bir nedeni vardır: aynı kodu çalıştıran herkes aynı sayıyı görsün.
Bu notu okumak için bir şey indirmeniz gerekmez: laboratuvarın bütün çıktıları sayfada zaten duruyor. Kodu kendi bilgisayarınızda çalıştırmak isterseniz dersin veri dosyalarını buradan indirebilirsiniz:
tuik_life_table.csv — TÜİK hayat tablosu — bu bölümün konusu ve laboratuvarın ana dosyası;life_expectancy_education.csv — eğitim düzeyine göre yaşam beklentisi;healthy_life_expectancy.csv — sağlıklı yaşam beklentisi.Yukarıdaki gövde kodu hiçbir dosya okumadı, üç satırlık öğretim tablosuyla çalıştı; laboratuvar çıktılarının çoğu birinci dosyadan gelir. Son iki dosya yalnızca laboratuvarın Görev D bölümünde okunur; sözlükleri bu bölümün sonundadır (Ek iki dosyanın sözlüğü). Betiği kendi bilgisayarınızda çalıştıracaksanız üçünü de indirin; yoksa betik Görev D’ye geldiğinde durur.
İndirdiğiniz dosyaları betiğinizin yanında bir data/derived/ klasörüne koyarsanız aşağıdaki yollar olduğu gibi çalışır. Kaynağından yeni bir kopya indirmeyin. TÜİK’in sayfasındaki dosya bir Excel tablosudur: iki dönem alt alta, üç cinsiyet yan yana durur ve bu dersin dosyasındaki age_start ile open_interval sütunları orada yoktur. TÜİK her yıl yeni bir üç yıllık dönem de yayımlar; bir sonraki yayında sayılar bu sayfadakilerle tutmaz.
Bir satır ne demek? Bir satır bir dönem–cinsiyet–yaş birleşimidir: bir kişi değil, bir ölüm değil, bir poliçe değil. Gözlem birimi tek başına yaş değildir; aynı yaş dosyada altı kez geçer, çünkü iki dönem etiketi ile üç cinsiyet kodunun her birleşiminde bir kez yer alır. 2023-2025 döneminde female grubunun 65 yaşı tek bir satırdır ve o satır, o yaştaki bütün grubu özetleyen dört sayıyı (mx, qx, lx, ex) taşır. Dosyada \(101\times3\times2=606\) satır vardır: 101 yaş satırı (0’dan 99’a ve 100+), üç cinsiyet kodu, iki dönem. Aynı birleşimin iki kez geçmemesi, Görev C’de denetlenecek kurallardan biridir.
| Sütun | Anlamı | Birim / kodlama |
|---|---|---|
period |
Tablonun ait olduğu üç yıllık gözlem dönemi | Metin etiketi, iki değer: 2022-2024 ve 2023-2025. Sayı değildir; Görev A’da başlangıç yılı bu etiketten ayrıca çıkarılır |
sex |
Cinsiyet grubu | Metin, küçük harf ve İngilizce: female (kadın), male (erkek), total (kadın ve erkeğin birlikte tablosu). total üçüncü bir grup değildir; üç eğri aynı grafiğe çizilirken bu unutulmamalı |
age_label |
Yaşın etiketi | Metin: 0, 1, …, 99 ve son satırda 100+ |
age_start |
Etiketin başladığı tam yaş | Tam yıl; 100+ satırında 100’dür. Sıralamada ve grafiklerde bu sütun kullanılır, çünkü age_label metindir ve metin sıralamasında 100+ etiketi 2’den önce gelir |
open_interval |
Satırın açık yaş aralığı olup olmadığı | Mantıksal TRUE/FALSE; yalnızca 100+ satırlarında TRUE. Yukarıda anlatılan açık aralık sınırı bu bayrakla ayrılır |
mx |
\(m_x\): merkezi ölüm hızı | Kişi-yıl başına ölüm; hızdır, üst sınırı 1 değildir |
qx |
\(q_x\): bir yıl içinde ölme olasılığı | Birimsiz, 0 ile 1 arasında; 100+ satırında tanım gereği 1’dir |
lx |
\(l_x\): o yaşa ulaşan kişi sayısı | Kişi; bu dosyada varsayımsal kohort 0 yaşında 100.000 kişiyle başlar |
ex |
\(e_x\): o yaştaki bir kişinin kalan yaşam beklentisi | Yıl; tam beklentidir, yani yıl içinde yaşanan kesirleri de sayar |
Yukarıda tanımlanan büyüklüklerden dördü bu listede yoktur: \(d_x\), \(p_x\), \(L_x\) ve \(T_x\). Dördü de dosyada bulunmaz, lx ve mx sütunlarından türetilir ve Görev B’de tam olarak bunu yapacağız. Hangi sayının yayımlanmış, hangisinin bizim ürettiğimiz olduğunu ayırt etmek bu haftanın denetim mantığının temelidir.
Hangi soruyu yanıtlıyoruz? İki soru: bir hayat tablosunun sütunları birbirini nasıl doğrular — yayımlanmış qx, yalnızca lx kullanılarak yeniden üretilebilir mi — ve ölüm olasılığı yaşa ve cinsiyete göre nasıl değişir?
mx ile qx hesaplanmış olarak gelir. Bu hafta yapılan denetim, sütunların birbiriyle tutarlı olup olmadığıdır; TÜİK’in hesabının yeniden yapılması değildir.life_expectancy_education.csv).100+ satırının içi görünmez. Açık aralıkta tek tek yaşlar yoktur ve oradaki qx tanım gereği 1 olduğu için gruplar arasında ayırt edici bir bilgi taşımaz.Laboratuvarın Görev D’si ana tablonun yanında iki ek dosya daha okur. İkisi de aynı TÜİK yayınından (Hayat Tabloları, 2023-2025, kaynak) ve aynı lisansla (TÜİK yayımlanmış tablo; kaynak gösterimi ve portal koşulları geçerlidir) gelir; derste kullanılan kopyaları da ana tabloyla aynı gün, 24 Ağustos 2026’da alınmıştır. İndirme bağlantıları bu bölümün başındaki listededir.
life_expectancy_education.csv — 108 satır. Bir satır, belirli bir yaşta, belirli bir eğitim düzeyindeki, belirli bir cinsiyet kategorisi için kalan yaşam beklentisidir. 12 yaş × 3 eğitim düzeyi × 3 cinsiyet kategorisi = 108.
| Sütun | Anlamı | Birim / kodlama |
|---|---|---|
age |
Beklentinin okunduğu yaş | Tam sayı; yalnızca 12 değer: 30’dan 85’e beşer beşer. Ara yaşlar dosyada yoktur |
education |
Tamamlanmış eğitim düzeyi | Metin, üç düzey: below_upper_secondary (lise altı), upper_secondary (lise), tertiary (yükseköğretim). Sıralı bir kavramdır ama metin olarak saklanır; sıralamak isterseniz düzeyi kendiniz belirtmelisiniz |
sex |
Cinsiyet kategorisi | female, male, total. Ana tabloda olduğu gibi total üçüncü bir grup değildir, ikisinin birleşimidir |
life_expectancy |
O yaştaki kalan yaşam beklentisi | Yıl, ondalıklı; dosyadaki değerler 5,43 ile 56,92 arasındadır |
healthy_life_expectancy.csv — 57 satır. Bir satır, bir yaş grubu ve bir cinsiyet kategorisi için beklenen sağlıklı yaşam yılıdır. 19 yaş grubu × 3 cinsiyet = 57.
| Sütun | Anlamı | Birim / kodlama |
|---|---|---|
age_group |
Yaş grubu etiketi | Metin: 0, 1-4, 5-9, …, 85+. Gruplar eşit genişlikte değildir — ilki tek yaş, sonuncusu açık uçlu |
age_start |
Grubun başlangıç yaşı | Tam sayı; age_group etiketinin sayısal karşılığı, sıralama ve birleştirme için |
open_interval |
Grup açık uçlu mu? | Mantıksal; yalnızca 3 satırda TRUE — 85+ grubunun üç cinsiyet satırı |
sex |
Cinsiyet kategorisi | Yukarıdakiyle aynı üç değer ve aynı total uyarısı |
healthy_years |
Grubun başlangıç yaşından sonra beklenen sağlıklı yaşam yılı | Yıl, ondalıklı; 1,12 ile 59,12 arasındadır |
Hangi soruları yanıtlıyorlar? İki ayrı soru. Eğitim dosyası: kalan yaşam beklentisi eğitim düzeyine göre nasıl değişir? Sağlıklı yaşam dosyası, ana tabloyla birlikte: “daha uzun yaşamak” ile “daha uzun sağlıklı yaşamak” aynı şey midir?
Neyi yanıtlayamazlar. Üçü de önemli:
65-69 satırında kadınlar için 5,84 yıl, beş yıllık grubun genişliğini aşar. Bu yüzden 65 yaşındaki bir kişinin ex’i ile aynı yaşa aittir; iki sayıyı ayıran yaş değil, hesap yoludur (sonraki madde). healthy_years yalnızca ölüm verisinden gelmez. TÜİK’in tanımıyla bu sayı, günlük faaliyetleri kısıtlayan bir sağlık sorunu olmadan geçirilmesi beklenen süredir. Böyle bir gösterge genellikle Sullivan yöntemiyle (Sullivan method) hesaplanır: hayat tablosunun her yaş grubunda yaşanan yıllar, bir araştırmada kısıtlılık bildirmeyenlerin payıyla çarpılır. ex ise yalnızca ölüm hızlarından gelir. İki sayı aynı birimde (yıl) yazıldığı için karşılaştırılabilir görünür; ama biri, ötekinde olmayan, kişilerin kendi beyanına dayanan bir bilgi taşır.Gövde yöntemi üç satırlık bir tabloda kurdu; laboratuvar onu bir önceki bölümün sözlüğünde tanıtılan tuik_life_table.csv dosyasının gerçek tablosuna taşır. Görev D ayrıca eğitim ve sağlıklı yaşam dosyalarını okur; üçünün de indirme bağlantısı veri sözlüğündedir. Her görev gövdenin sormadığı bir soruyu sorar ve yanıtı bir karara bağlanır:
| Görev | Soru | Hangi karar için |
|---|---|---|
| A | Altı tablodan hangisiyle çalışacağız; seçim her yaşa tek satır veriyor mu? | Hesapların hangi dönemin ölüm deneyimine dayanacağı |
| B | Yayımlanan qx ve ex, dosyanın lx ve mx sütunlarından yeniden üretilebiliyor mu; paketin beklentisi neden ayrılıyor? |
Hesapların hangi sütuna dayanabileceği; paketin \(e_x\)’inin hangi ayarla kullanılacağı |
| C | Tablo dört yapısal kuralı hangi satırlarda sağlıyor? | Tablonun analize girip girmeyeceği |
| D | Ölüm olasılığı kadın ile erkek arasında yaşa göre nasıl ayrışır; iki dönem, eğitim ve sağlıklı yaşam ne ekler? | Cinsiyet ve dönem ayrımının gerekip gerekmediği; eğitim ve sağlıklı yaşam farklarının nasıl okunacağı |
Görevler gövdenin hiçbir nesnesini kullanmaz: dosyayı aşağıdaki bloklarla kendileri okur, her nesneyi kendileri kurar. İndirilebilir betik # Gorev A satırından önce yalnızca paketleri yükler ve ders/ içinden çalıştırıldığında bir üst klasöre geçer; sonrası bu sayfadaki bloklarla aynıdır.
Önce dosyanın yerini denetleyin:
veri_yolu <- file.path("data", "derived", "tuik_life_table.csv")
file.exists(veri_yolu)
#> [1] TRUEYol ve okuma kalıbı Hafta 2’dekinin aynısıdır. TRUE görmelisiniz; FALSE, dosyanın indirilmediğini ya da data/derived/ klasörüne konmadığını söyler ve sorun okuma adımından önce ortaya çıkar.
Kaynağından yeni bir kopya indirmeyin: veri sözlüğünde anlatıldığı gibi TÜİK’in dosyası başka bir biçimdedir ve her yıl yeni bir dönemle güncellenir. Dosya yerindeyse okuyalım:
hayat_tablosu <- read_csv(veri_yolu, show_col_types = FALSE)

hayat_tablosu
#> # A tibble: 606 × 9
#> period sex age_label age_start open_interval mx qx lx ex
#> <chr> <chr> <chr> <dbl> <lgl> <dbl> <dbl> <dbl> <dbl>
#> 1 2023-20… total 0 0 FALSE 9.02e-3 8.95e-3 1 e5 78.5
#> 2 2023-20… total 1 1 FALSE 9.52e-4 9.51e-4 9.91e4 78.2
#> 3 2023-20… total 2 2 FALSE 6.17e-4 6.17e-4 9.90e4 77.3
#> 4 2023-20… total 3 3 FALSE 4.97e-4 4.97e-4 9.89e4 76.3
#> 5 2023-20… total 4 4 FALSE 4.33e-4 4.33e-4 9.89e4 75.4
#> 6 2023-20… total 5 5 FALSE 4.07e-4 4.07e-4 9.89e4 74.4
#> 7 2023-20… total 6 6 FALSE 3.89e-4 3.89e-4 9.88e4 73.4
#> 8 2023-20… total 7 7 FALSE 3.76e-4 3.75e-4 9.88e4 72.5
#> 9 2023-20… total 8 8 FALSE 3.47e-4 3.47e-4 9.87e4 71.5
#> 10 2023-20… total 9 9 FALSE 3.59e-4 3.59e-4 9.87e4 70.5
#> # ℹ 596 more rowsÇıktının başlığı satır ve sütun sayısını verir (606 × 9); yazdırılan ilk on satır 2023-2025 döneminin total tablosundan gelir.
Beklenen sütun adlarını tek bir vektörde toplayın:
gerekli_sutunlar <- c(
  "period", "sex", "age_label", "age_start", "open_interval",
  "mx", "qx", "lx", "ex"
)

gerekli_sutunlar
#> [1] "period" "sex" "age_label" "age_start"
#> [5] "open_interval" "mx" "qx" "lx"
#> [9] "ex"Bu adlar, veri sözlüğündeki sütun tablosunda tanımlananlarla birebir aynıdır. Sonraki bütün bloklar sütunlara adıyla eriştiği için adları dosyayı okur okumaz denetliyoruz.
Bu listeden, okunan dosyada bulunmayan adları ayıklayın:
eksik_sutunlar <- setdiff(gerekli_sutunlar, names(hayat_tablosu))

eksik_sutunlar
#> character(0)setdiff(a, b) — a’da olup b’de olmayan öğeleri döndürür (2. haftadan tanıdık). Sıra önemlidir: burada soru “listede olup dosyada olmayan sütun var mı?” sorusudur; setdiff(names(hayat_tablosu), gerekli_sutunlar) öteki yönü, yani dosyada olup listede olmayanları verirdi.Çıktının character(0) olması gerekir. Bu, uzunluğu sıfır olan bir metin vektörüdür: eksik ad yoktur, beklenen sütunların hepsi dosyada vardır.
Son olarak dönem ve cinsiyet kırılımındaki satır sayısını sayın:
hayat_tablosu |> count(period, sex)#> # A tibble: 6 × 3
#> period sex n
#> <chr> <chr> <int>
#> 1 2022-2024 female 101
#> 2 2022-2024 male 101
#> 3 2022-2024 total 101
#> 4 2023-2025 female 101
#> 5 2023-2025 male 101
#> 6 2023-2025 total 101count(veri, sutun1, sutun2) — verilen sütunların her birleşimi için satır sayar; group_by() + summarise(n()) ikilisinin kısa yazımıdır ve sonucu n adlı bir sütunda döndürür.Çıktıda 6 satır görmelisiniz: iki dönem ile üç cinsiyet kodunun birleşimi; her birleşimde 0 yaşından 100+ satırına kadar 101 yaş bulunur.
Dosya altı tablo taşıyor (iki dönem × üç cinsiyet). Görev B’nin yeniden üretimi ve Görev C’nin tablo içi kuralları bir tablonun sütunlarını birbirine karşı sınar; yöntemi bu yüzden tek bir tabloda kuruyoruz ve önce hangisi olduğunu seçiyoruz.
period bir metin etiketidir (2022-2024 gibi), sayı değildir; “en güncel”i bulmak için önce içinden başlangıç yılını çıkarıyoruz:
guncel_donem <- hayat_tablosu |>
  distinct(period) |>
  mutate(donem_baslangici = parse_number(period)) |>
  slice_max(donem_baslangici, n = 1) |>
  pull(period)

guncel_donem
#> [1] "2023-2025"parse_number(period) — metnin içindeki ilk sayıyı çeker: "2023-2025" → 2023. En güncel dönemi bir sayıya bakarak seçmek, seçimi etiketin nasıl yazıldığından bağımsız kılar.slice_max(donem_baslangici, n = 1) — en büyük değeri taşıyan satırı döndürür. İki dönemin başlangıç yılı farklı olduğu için bu tek bir satırdır; pull(period) onun etiketini tek bir metin olarak verir.En güncel dönem 2023-2025 çıkmalıdır: eldeki en yeni ölüm deneyimi odur. Görev B ve C’nin denetimleri cinsiyete bağlı olmadığı için o dönemin total tablosunu seçiyoruz; kadın ve erkek tablolarını Görev D karşılaştıracak:
secilen_tablo <- hayat_tablosu |>
  filter(period == guncel_donem, sex == "total") |>
  arrange(age_start)

secilen_tablo
#> # A tibble: 101 × 9
#> period sex age_label age_start open_interval mx qx lx ex
#> <chr> <chr> <chr> <dbl> <lgl> <dbl> <dbl> <dbl> <dbl>
#> 1 2023-20… total 0 0 FALSE 9.02e-3 8.95e-3 1 e5 78.5
#> 2 2023-20… total 1 1 FALSE 9.52e-4 9.51e-4 9.91e4 78.2
#> 3 2023-20… total 2 2 FALSE 6.17e-4 6.17e-4 9.90e4 77.3
#> 4 2023-20… total 3 3 FALSE 4.97e-4 4.97e-4 9.89e4 76.3
#> 5 2023-20… total 4 4 FALSE 4.33e-4 4.33e-4 9.89e4 75.4
#> 6 2023-20… total 5 5 FALSE 4.07e-4 4.07e-4 9.89e4 74.4
#> 7 2023-20… total 6 6 FALSE 3.89e-4 3.89e-4 9.88e4 73.4
#> 8 2023-20… total 7 7 FALSE 3.76e-4 3.75e-4 9.88e4 72.5
#> 9 2023-20… total 8 8 FALSE 3.47e-4 3.47e-4 9.87e4 71.5
#> 10 2023-20… total 9 9 FALSE 3.59e-4 3.59e-4 9.87e4 70.5
#> # ℹ 91 more rowsSeçimin gerçekten “her yaş için tek satır” olduğunu iddia etmek yetmez, denetlemek gerekir. Görev B’nin lead(lx) adımı bir sonraki satırı bir sonraki yaş sayar: bir yaş iki kez geçse ya da sıra bozuk olsa \(d_x\) ve \(q_x\) hata vermeden yanlış satırdan hesaplanırdı.
gorev_a_kontrol <- c(
  satir_sayisi_101  = nrow(secilen_tablo) == 101L,
  her_yas_tek_satir = !any(duplicated(secilen_tablo$age_start)),
  yas_sirali        = !is.unsorted(secilen_tablo$age_start)
)
stopifnot(gorev_a_kontrol)
gorev_a_kontrol
#> satir_sayisi_101 her_yas_tek_satir yas_sirali
#> TRUE TRUE TRUEis.unsorted(x) — vektörün artan sırada olmadığını bildirir; başındaki ! ile “sıralı mı?” sorusuna çevrilir. arrange() bunu zaten sağlar, ama denetim arrange()’in çalıştığına güvenmek yerine sonucu ölçer.Üç bayrağın üçü de TRUE olmalıdır: 0’dan 100+’a 101 yaş, her yaştan bir satır, artan sırada.
Gövdenin üç satırlık tabloda kullandığı formülleri gerçek tabloya uygulayıp sonuçları TÜİK’in yayımladığı qx ve ex sütunlarıyla karşılaştırıyoruz. Neden? Tablonun arkasındaki ölüm ve kişi-yıl sayıları dosyada yoktur (Bu veri neyi yanıtlayamaz uyarısı); tabloyu ancak sütunlarını birbirinden yeniden üreterek denetleyebiliriz. Yayımlanan bir sütun ötekilerden yeniden üretilemiyorsa ya bir değer bozuktur ya da sütunlar farklı varsayımlarla hesaplanmıştır; iki durumda da sonraki hesaplar hangi sütuna dayanacağını bilemez. Küçük bir fark çıkarsa nereden geldiğini de soracağız: yayımlama yuvarlamasından mı, kayan noktalı aritmetikten (floating-point arithmetic), yani bilgisayarın sayıları sınırlı sayıda basamakla saklayıp hesaplamasından mı? (Alıştırma 10 bu soruyu yanıtlar.) Son adımda aynı beklentiyi paketin exn() işlevinden isteyip TÜİK’inkiyle karşılaştırıyoruz.
Görev A’da seçtiğimiz tabloya gövdenin formülleriyle üç yeni sütun ekliyoruz:
secilen_tablo <- secilen_tablo |>
  mutate(
    dx_turetilen = lx - lead(lx),
    px_turetilen = lead(lx) / lx,
    qx_turetilen = dx_turetilen / lx
  )

secilen_tablo |> select(age_start, lx, dx_turetilen, px_turetilen, qx_turetilen) |> head()
#> # A tibble: 6 × 5
#> age_start lx dx_turetilen px_turetilen qx_turetilen
#> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 0 100000 895. 0.991 0.00895
#> 2 1 99105. 94.3 0.999 0.000951
#> 3 2 99011. 61.1 0.999 0.000617
#> 4 3 98950. 49.2 1.00 0.000497
#> 5 4 98901. 42.8 1.00 0.000433
#> 6 5 98858. 40.2 1.00 0.000407İlk satırda varsayımsal kohort \(l_0=100.000\) kişiyle başlar; ilk yaş yılında yaklaşık 895 kişi ölür ve \(q_0\) yaklaşık 0,00895 çıkar. Formüller gövdenin küçük tablodaki mutate() adımıyla aynıdır; _turetilen eki yalnızca bu sütunları dosyanın yayımlanmış qx sütunundan ayırır. Tabloyu select() ile yalnızca okunabilirlik için daraltıyoruz: secilen_tablo artık 12 sütun taşır, dosyanın dokuz sütunu ve bizim eklediğimiz üç sütun.
Şimdi kendi ürettiğimiz qx_turetilen ile TÜİK’in yayımladığı qx sütununu karşılaştıralım — Görev C’nin üçüncü kuralı bu karşılaştırmaya dayanır ve aradaki farkın sıfıra çok yakın kalması beklenir:
secilen_tablo <- secilen_tablo |>
  mutate(qx_farki = qx_turetilen - qx)

secilen_tablo |> select(age_start, qx, qx_turetilen, qx_farki) |> head(10)
#> # A tibble: 10 × 4
#> age_start qx qx_turetilen qx_farki
#> <dbl> <dbl> <dbl> <dbl>
#> 1 0 0.00895 0.00895 1.11e-16
#> 2 1 0.000951 0.000951 3.05e-16
#> 3 2 0.000617 0.000617 -5.10e-16
#> 4 3 0.000497 0.000497 -6.21e-17
#> 5 4 0.000433 0.000433 4.51e-16
#> 6 5 0.000407 0.000407 -8.09e-16
#> 7 6 0.000389 0.000389 6.42e-16
#> 8 7 0.000375 0.000375 -3.97e-16
#> 9 8 0.000347 0.000347 -3.44e-16
#> 10 9 0.000359 0.000359 -2.69e-16Listelenen on satırın tamamında qx_farki mutlak değerce \(10^{-15}\)’ten küçük kalır; en büyüğü \(8{,}1\cdot10^{-16}\) dolayındadır. Bu büyüklük bir sapmanın değil, kayan noktalı aritmetiğin izidir: R bir sayıyı yaklaşık 16 anlamlı basamakla saklar ve 1 ile ondan büyük ilk saklanabilir sayı arasındaki aralık \(2{,}2\cdot10^{-16}\)’dır (Hafta 1’deki 0.1 + 0.2 ile 0.3 arasındaki fark da bu düzeydedir). Farkın bu düzeyde kalması iki sütunun da bütün basamaklarıyla saklandığını gösterir; yayımlanan sayılar yuvarlanmış olsaydı fark son yayımlanan basamakta görülürdü.
On satır tablonun tamamı değildir. Farkın bütün tablodaki en büyüğünü ve farkın hesaplanamadığı satır sayısını bulalım.
qx_en_buyuk_fark <- secilen_tablo |>
  summarise(
    en_buyuk_mutlak_fark = max(abs(qx_farki), na.rm = TRUE),
    eksik_fark = sum(is.na(qx_farki))
  )

qx_en_buyuk_fark
#> # A tibble: 1 × 2
#> en_buyuk_mutlak_fark eksik_fark
#> <dbl> <int>
#> 1 3.44e-15 1Farkın en büyüğü \(3{,}4\cdot10^{-15}\)’tir; bu da kayan noktalı aritmetiğin artığıdır. Fark bir satırda NA’dır: 100+ satırında lead(lx) bir sonraki yaşı bulamaz. na.rm = TRUE o satırı yalnızca bu özet için dışarıda bırakır; Görev C’nin kuralları açık aralığı zaten ayrı tutar.
Şimdi ex sütununu gövdedeki üç adımla (\(m_x\): merkezi ölüm hızı ve Kalan yaşam beklentisi: \(T_x\) ve \(e_x\) bölümleri) yeniden üretelim: her yaşın kişi-yılı \(L_x=d_x/m_x\), bu kişi-yılların o yaştan tablonun sonuna kadar toplamı \(T_x\) ve \(e_x=T_x/l_x\). Açık aralıkta ölen sayısı \(l_{100}\)’dür, çünkü oraya ulaşan herkes orada ölür. Kişi-yılı \(l_x\)’ten değil \(m_x\)’ten kuruyoruz: ölenlerin yıl içinde ne kadar yaşadığı \(l_x\)’te yoktur, \(m_x\)’in paydasında saklıdır; ilk satır bunun neden önemli olduğunu gösterecek.
secilen_tablo <- secilen_tablo |>
  mutate(
    Lx_turetilen = ifelse(open_interval, lx, dx_turetilen) / mx,
    Tx_turetilen = rev(cumsum(rev(Lx_turetilen))),
    ex_turetilen = Tx_turetilen / lx
  )

secilen_tablo |> select(age_start, lx, mx, Lx_turetilen, Tx_turetilen, ex_turetilen, ex) |> head()
#> # A tibble: 6 × 7
#> age_start lx mx Lx_turetilen Tx_turetilen ex_turetilen ex
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 0 100000 0.00902 99238. 7849498. 78.5 78.5
#> 2 1 99105. 0.000952 99054. 7750260. 78.2 78.2
#> 3 2 99011. 0.000617 98979. 7651206. 77.3 77.3
#> 4 3 98950. 0.000497 98925. 7552227. 76.3 76.3
#> 5 4 98901. 0.000433 98879. 7453302. 75.4 75.4
#> 6 5 98858. 0.000407 98837. 7354423. 74.4 74.4İlk satırda \(L_0\) 99.238 kişi-yıl, \(T_0\) 7.849.498 kişi-yıl ve ex_turetilen 78,5 yıldır; ex sütunuyla aynı. \(L_0\), \(l_0\) ile \(l_1\)’in ortalamasından (99.552,6) küçüktür, çünkü 0 yaşında ölenler yılın yalnızca %15’ini yaşar.
ifelse(open_interval, lx, dx_turetilen) — (2. haftadan tanıdık) açık aralık satırında ölen sayısı olarak lx’i, öteki satırlarda dx_turetilen’i alır: 100+ aralığına ulaşan herkes orada ölür ve dx_turetilen o satırda NA’dır.rev(x) — vektörü ters çevirir: son öğe başa gelir.rev(cumsum(rev(Lx_turetilen))) — cumsum() (6. haftadan tanıdık) birikimli toplamı baştan sona alır. Sütunu önce ters çevirip toplamı sonra yeniden ters çevirmek, toplamı sondan başa biriktirir: her satıra o yaşın ve sonraki bütün yaşların \(L\) değerlerinin toplamı, yani \(T_x\) gelir.Yüzde 15, gövdenin \(m_x\) ile \(q_x\) aynı şey değildir bölümündeki \(a_x\)’tir: ölenlerin öldükleri yıl içinde yaşadığı ortalama kesir, \(L_x=l_{x+1}+a_x\,d_x\). Aynı bölüm onu yayımlanan iki sütundan geri çözdü, \(a_x=1-1/q_x+1/m_x\); bütün yaşlar için hesaplayalım:
ax_ozeti <- secilen_tablo |>
  mutate(ax = 1 - 1 / qx + 1 / mx) |>
  summarise(
    a_0 = ax[age_start == 0],
    en_kucuk_1_99 = min(ax[age_start %in% 1:99]),
    en_buyuk_1_99 = max(ax[age_start %in% 1:99])
  )

ax_ozeti
#> # A tibble: 1 × 3
#> a_0 en_kucuk_1_99 en_buyuk_1_99
#> <dbl> <dbl> <dbl>
#> 1 0.149 0.460 0.520\(a_0\) 0,149’dur; 1 ile 99 yaş arasında \(a_x\) 0,460 ile 0,520 arasında kalır. Ölümleri yılın ortasına koyan varsayım (\(a_x=0{,}5\)) 1 yaşından sonra iyi bir yaklaşımdır, 0 yaşında değildir. \(L_x\)’i \(l_x\) ile \(l_{x+1}\)’in ortalamasından değil \(m_x\)’ten kurmamızın nedeni budur.
Karşılaştırmayı ayrı bir blokta yapıyoruz; listede en büyük fark ile bayrak yan yana durur.
ex_kontrol <- isTRUE(all.equal(secilen_tablo$ex_turetilen, secilen_tablo$ex))
stopifnot(ex_kontrol)
list(
  en_buyuk_fark = max(abs(secilen_tablo$ex_turetilen - secilen_tablo$ex)),
  uyumlu = ex_kontrol
)
#> $en_buyuk_fark
#> [1] 1.605827e-12
#>
#> $uyumlu
#> [1] TRUEEn büyük fark \(1{,}6\cdot10^{-12}\) yıl dolayındadır ve uyumlu TRUE’dur: TÜİK’in ex sütunu, dosyanın kendi lx ve mx sütunlarından bu üç adımla yeniden üretilir. Bayrak FALSE çıksaydı, lx, mx ve ex sütunlarından en az biri ötekilerle tutarsız olurdu: ya bir değer bozulmuştur ya da ex başka bir \(L_x\) varsayımıyla hesaplanmıştır.
Bir analist kalan yaşam beklentisini çoğu zaman tablonun ex sütunundan değil bir paketten alır. Paketin sonucu TÜİK’inkinden ayrılırsa farkın bir hata mı, bir tanım ya da varsayım farkı mı olduğunu bilmek gerekir; bu yüzden aynı beklentiyi paketten de istiyoruz. Paket yalnızca \(l_x\) dizisini alır; nesneyi seçilen tablodan, gövdenin küçük tablosundaki gibi kuruyoruz.
tuik_hayat_tablosu <- new(
  "lifetable",
  x = secilen_tablo$age_start,
  lx = secilen_tablo$lx,
  name = "TÜİK 2023-2025 toplam"
)

head(tuik_hayat_tablosu)
#> x lx
#> 1 0 100000.00
#> 2 1 99105.21
#> 3 2 99010.94
#> 4 3 98949.85
#> 5 4 98900.69
#> 6 5 98857.92head(tuik_hayat_tablosu) — bu nesnede ilk altı yaşın x ve lx değerlerini bir çerçeve olarak verir. Nesnenin kendisi yazdırılsaydı her yaş için bir satır basılırdı.Doğuşta kalan yaşam beklentisini paketten iki biçimde isteyip TÜİK’in değeriyle yan yana koyuyoruz.
paket_ex0 <- c(
  kesikli = exn(tuik_hayat_tablosu, x = 0),
  tam = exn(tuik_hayat_tablosu, x = 0, type = "complete"),
  tuik = secilen_tablo$ex[secilen_tablo$age_start == 0]
)

paket_ex0
#> kesikli tam tuik
#> 77.94499 78.44499 78.49498Üç sayı birbirinden farklıdır: kesikli beklenti 77,94, paketin tam beklentisi 78,44 ve TÜİK’in ex değeri 78,49 yıldır.
type = "complete" — tam beklentiyi ister. Verilmezse: exn() hata ya da uyarı vermeden kesikli beklentiyi döndürür; burada bu, TÜİK’in ex sütunundan 0,55 yıl küçük bir sayıdır. Kesikli beklentiden paketin tam beklentisine fark tam 0,5 yıldır. Kesikli beklenti bir yaşın kişi-yılı olarak yalnızca yılı tamamlayan \(l_{x+1}\) kişiyi sayar; paketin tam beklentisi o yıl ölenlere yarım yıl ekler: \(l_{x+1}+d_x/2\). Bütün yaşlarda ölenler kohortun kendisidir, \(\sum d_x=l_0\); eklenen süre bu yüzden kişi başına tam yarım yıldır.
Tam beklentiyle fark 0,05 yıla düşer ama sıfır olmaz. TÜİK kişi-yılı \(m_x\)’ten kurar ve ölenlerin yıl içinde yaşadığı payı, gövdedeki \(a_x\)’i, her yaşta ayrı alır: \(L_x=l_{x+1}+a_x\,d_x\). Paket her yaşta \(a_x=\tfrac12\) alır. İki kişi-yılın farkı \((a_x-\tfrac12)\,d_x\)’tir ve iki beklentinin farkı bu farkların kişi başına toplamıdır:
\[ \begin{aligned} e_0^{\text{TÜİK}}&-e_0^{\text{paket}}\\ &=\frac{1}{l_0}\sum_x\Big(a_x-\frac12\Big)\,d_x . \end{aligned} \]
Açık aralıkta \(q_{100+}=1\) olduğu için gövdedeki \(a_x=1-1/q_x+1/m_x\) formülü \(a_{100+}=1/m_{100+}=4{,}03\) yıl verir ve orada ölenler \(l_{100}\) kişidir. Paket ise oraya ulaşanlara da yarım yıl verir, çünkü tablonun son satırından sonra kimsenin yaşamadığını varsayar. Toplamı üç parçaya ayıralım:
ex_farki_parcalari <- secilen_tablo |>
  mutate(
    olen = ifelse(open_interval, lx, dx_turetilen),
    katki = (1 - 1 / qx + 1 / mx - 0.5) * olen / lx[1]
  ) |>
  summarise(
    yas_0 = katki[age_start == 0],
    yas_1_99 = sum(katki[age_start %in% 1:99]),
    acik_aralik = katki[open_interval],
    toplam = sum(katki)
  )

ex_farki_parcalari
#> # A tibble: 1 × 4
#> yas_0 yas_1_99 acik_aralik toplam
#> <dbl> <dbl> <dbl> <dbl>
#> 1 -0.00314 -0.00276 0.0559 0.0500katki formülün her yaştaki terimidir: 1 - 1 / qx + 1 / mx \(a_x\)’tir, olen de Lx_turetilen adımındaki ölen sayısıdır.
Açık aralığın katkısı 0,0559 yıldır, tek başına 0,05’ten büyük. 0 yaşınınki −0,0031 yıldır, çünkü bebekler yılın yarısını değil %15’ini yaşar; 1–99 yaşlarınınki −0,0028. Yıl içindeki iki parça ters yönde çalışır ve toplamı 0,0500’e indirir: toplam, iki beklentinin farkının kendisidir.
Kesikli beklentiyle TÜİK’in ex değeri arasındaki 0,55 yıl böylece iki kaynaktan gelir: 0,5 yılı kesikli sayımın ölünen yılın kesrini saymamasından, 0,05 yılı paketin her yaşta \(a_x=\tfrac12\) almasından. Görev B’nin kararı buradan çıkar: bir hesapta paketin beklentisi kullanılacaksa type = "complete" ile istenmelidir; kalan 0,05 yıl bir hata değil, ölenlerin yıl içinde yaşadığı pay için yapılan varsayımın farkıdır. Yayımlanan qx ve ex ise dosyanın kendi lx ve mx sütunlarıyla tutarlıdır: sonraki hesaplar hangisini kullanırsa kullansın aynı tabloya dayanır.
Dört yapısal kural denetliyoruz: biri bozulursa stopifnot() analizi durdurur, çünkü bozuk bir tablodan türetilen \(d_x\), \(p_x\) ve \(e_x\) anlamsız olur. Her kuralın hangi satırlara uygulandığı da kuralın bir parçasıdır:
qx 0 ile 1 arasında olmalı — dosyanın bütün satırlarında, yani altı tablonun hepsinde;lx yaşla artmamalı — seçtiğimiz tablonun kapalı yaş aralıklarında;qx, Görev B’de lx’ten türettiğimiz qx_turetilen ile aynı olmalı — yine kapalı yaş aralıklarında;Önce açık aralığı ayırıyoruz. 100+ satırında \(l_x\)’in ardılı olmadığı için türetilmiş px_turetilen ve qx_turetilen sütunları NA’dır; üçüncü kural orada uygulanamaz. İkinci kural için satırı dışarıda bırakmak zorunlu değildir, çünkü \(l_{100}\) zaten \(l_{99}\)’dan küçüktür; iki kural aynı çerçeveyi kullansın diye onu da kapalı aralıklarla sınırlıyoruz.
kapali_araliklar <- secilen_tablo |> filter(!open_interval)

kapali_araliklar |>
  select(age_start, lx, qx, px_turetilen, qx_turetilen) |>
  tail(4)
#> # A tibble: 4 × 5
#> age_start lx qx px_turetilen qx_turetilen
#> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 96 5221. 0.247 0.753 0.247
#> 2 97 3931. 0.258 0.742 0.258
#> 3 98 2916. 0.267 0.733 0.267
#> 4 99 2137. 0.259 0.741 0.259Son dört satırda \(l_x\) en küçük değerlerine iner ve \(q_x\) artık düzgün artmaz: 98 yaşında 0,267 iken 99 yaşında 0,259’dur.
Bu bir kural ihlali değildir: kurallar \(l_x\)’in artmamasını ister, \(q_x\)’in artmasını istemez. \(l_x\) tanım gereği artamaz, çünkü \(x+1\) yaşına ulaşan herkes \(x\) yaşına da ulaşmıştır. \(q_x\) ise düşebilir: bu tabloda \(q_{x+1}<q_x\) olan 14 yaş vardır. Dokuzu ilk on yaştadır (doğumdan sonra ölüm olasılığı düşer), dördü 22 ile 28 yaşları arasındadır, sonuncusu 98’dir. Şimdi dört kuralı tek bir bayrak vektöründe topluyoruz:
gorev_c_kontrol <- c(
  qx_sifir_bir_arasinda = all(hayat_tablosu$qx >= 0 & hayat_tablosu$qx <= 1),
  lx_yasla_artmiyor     = all(diff(kapali_araliklar$lx) <= 0),
  qx_yeniden_uretiliyor = all(abs(kapali_araliklar$qx_turetilen -
                                    kapali_araliklar$qx) < 1e-10),
  birlesim_tekrarsiz    = anyDuplicated(
                            hayat_tablosu[c("period", "sex", "age_label")]) == 0L
)
stopifnot(gorev_c_kontrol)
gorev_c_kontrol
#> qx_sifir_bir_arasinda lx_yasla_artmiyor qx_yeniden_uretiliyor
#> TRUE TRUE TRUE
#> birlesim_tekrarsiz
#> TRUEdiff(kapali_araliklar$lx) <= 0 — ardışık iki yaşın \(l_x\) farkını alır ve hepsinin sıfır ya da negatif olmasını ister. Karşılaştırma doğrudan sıfırla yapılır, pay bırakılmaz: yuvarlama sırayı bozmaz ve bu dosyada lx zaten yuvarlanmadan yayımlanmıştır (1 yaşında 99.105,2052692 kişi). Yaştan yaşa en küçük düşüş bile, 10 yaşından 11’e, 33,99 kişidir. abs(kapali_araliklar$qx_turetilen - kapali_araliklar$qx) < 1e-10 — yayımlanan qx ile lx’ten türetilen qx_turetilen’i satır satır karşılaştırır. Kayan noktalı aritmetik son basamakta küçük bir artık bıraktığı için eşitlik yerine 1e-10’luk bir pay kullanılır; Görev B’deki en büyük fark \(3{,}4\cdot10^{-15}\)’tir. Pay bu artığın yaklaşık 30.000 katıdır, ama bir olasılığın altıncı ondalığından, \(10^{-6}\)’dan, 10.000 kat küçüktür: artığı geçirir, altıncı ondalıktaki bir farkı yakalar. anyDuplicated(...) == 0L — anyDuplicated()’ın yinelenme yoksa 0 döndürdüğünü Hafta 1’de gördük; burada bir veri çerçevesine uygulanır ve satırları karşılaştırır. == 0L yazılmasaydı c() dört bayrağı tamsayıya çevirirdi (TRUE 1 olur) ve stopifnot(), hiçbir satır yinelenmediği hâlde “are not all TRUE” hatasıyla dururdu. Üçüncü kural dosyanın iki ayrı sütununu, qx ile lx’i, birbirine karşı sınar; bu yüzden bozulabilir. lx’teki tek bir yanlış değer, ikinci kuralı bozmayacak kadar küçük olsa bile, iki komşu yaşın qx_turetilen değerini değiştirir; yayımlanan qx ise değişmez. qx’teki yanlış bir değer de kuralı bozar. Alıştırma 5’in tablosunda ikisi de vardır.
Türetilen iki sütunun, px_turetilen ile qx_turetilen’in toplamını sınamak ise bir şey göstermezdi: ikisi aynı \(l_x\) değerlerinden hesaplandığı için toplamları cebirsel olarak 1’dir ve lx’teki bir değer değişse de 1 kalır. Bu tabloda o toplamın 1’den sapması tam olarak 0’dır.
Denetimde na.rm = TRUE kullanılmaz. Kapalı aralıklarda eksik değer yoktur; biri ortaya çıkarsa bayrak NA döner ve stopifnot() durur. Eksik bir değerin sessizce atlanmasındansa istenen davranış budur.
Dört bayrağın dördü de TRUE olmalıdır. Bu denetimler tabloyu doğrulamaz — TÜİK’in hesabını yeniden yapmıyoruz — yalnızca sütunların birbiriyle tutarlı olduğunu gösterir.
İkinci ve üçüncü kuralı yalnızca seçilen tabloda koştuk, çünkü sonraki görevler o tabloyu kullanır. Dosyanın öteki beş tablosunda da ikisi geçer: hiçbirinde \(l_x\) yaşla artmaz ve türetilen \(q_x\) hiçbirinde yayımlanandan \(10^{-14}\)’ten fazla ayrılmaz.
Görev C’nin kararı buradan çıkar: tablo analize girer, ama sütunları birbiriyle tutarlı olduğu için; ölümlülüğü doğru ölçtüğü bu denetimlerle kanıtlanmış değildir.
\(l_x\) kuralını diff() denetledi; bir grafik aynı işi göremez. Düşey eksen 0’dan 100.000 kişiye uzanır ve yaştan yaşa en küçük düşüş olan 33,99 kişi bu yüksekliğin %0,034’üdür. Aynı büyüklükte bir artış da çizginin kalınlığından çok küçük kalır ve görünmez.
Grafik başka bir şeyi gösterir: kohortun hangi yaşlarda hızla azaldığını ve kadın ile erkek eğrilerinin nerede ayrıldığını. Seçilen dönemin üç tablosunu, grafikte Türkçe adlarla görünecek bir cinsiyet sütunuyla hazırlıyoruz.
hayatta_kalanlar <- hayat_tablosu |>
  filter(period == guncel_donem) |>
  arrange(age_start) |>
  mutate(
    cinsiyet = factor(
      sex,
      levels = c("female", "male", "total"),
      labels = c("Kadın", "Erkek", "Toplam")
    )
  )

hayatta_kalanlar
#> # A tibble: 303 × 10
#> period sex age_label age_start open_interval mx qx lx ex
#> <chr> <chr> <chr> <dbl> <lgl> <dbl> <dbl> <dbl> <dbl>
#> 1 2023-20… total 0 0 FALSE 9.02e-3 8.95e-3 1 e5 78.5
#> 2 2023-20… male 0 0 FALSE 9.74e-3 9.66e-3 1 e5 75.9
#> 3 2023-20… fema… 0 0 FALSE 8.25e-3 8.19e-3 1 e5 81.1
#> 4 2023-20… total 1 1 FALSE 9.52e-4 9.51e-4 9.91e4 78.2
#> 5 2023-20… male 1 1 FALSE 9.73e-4 9.73e-4 9.90e4 75.6
#> 6 2023-20… fema… 1 1 FALSE 9.29e-4 9.28e-4 9.92e4 80.8
#> 7 2023-20… total 2 2 FALSE 6.17e-4 6.17e-4 9.90e4 77.3
#> 8 2023-20… male 2 2 FALSE 6.49e-4 6.49e-4 9.89e4 74.7
#> 9 2023-20… fema… 2 2 FALSE 5.84e-4 5.83e-4 9.91e4 79.9
#> 10 2023-20… total 3 3 FALSE 4.97e-4 4.97e-4 9.89e4 76.3
#> # ℹ 293 more rows
#> # ℹ 1 more variable: cinsiyet <fct>factor(sex, levels = ..., labels = ...) — levels düzeylerin sırasını, labels görünen adlarını verir (2. haftadan tanıdık): female satırları artık Kadın yazar ve göstergede (legend) bu sırayla dizilir.Tabloda 303 satır vardır: üç cinsiyet kodunun her biri için 101 yaş. Şimdi \(l_x\)’i yaşa göre çiziyoruz:
ggplot(hayatta_kalanlar, aes(age_start, lx, colour = cinsiyet)) +
  geom_line(linewidth = 0.8) +
  scale_y_continuous(
    limits = c(0, NA),
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_colour_manual(
    values = c("Kadın" = "#F28E2B", "Erkek" = "#1F4E79", "Toplam" = "#C8A45C")
  ) +
  labs(
    x = "Yaş (yıl)",
    y = "l(x): hayatta kalan kişi sayısı",
    colour = "Cinsiyet"
  ) +
  theme_minimal(base_size = 12)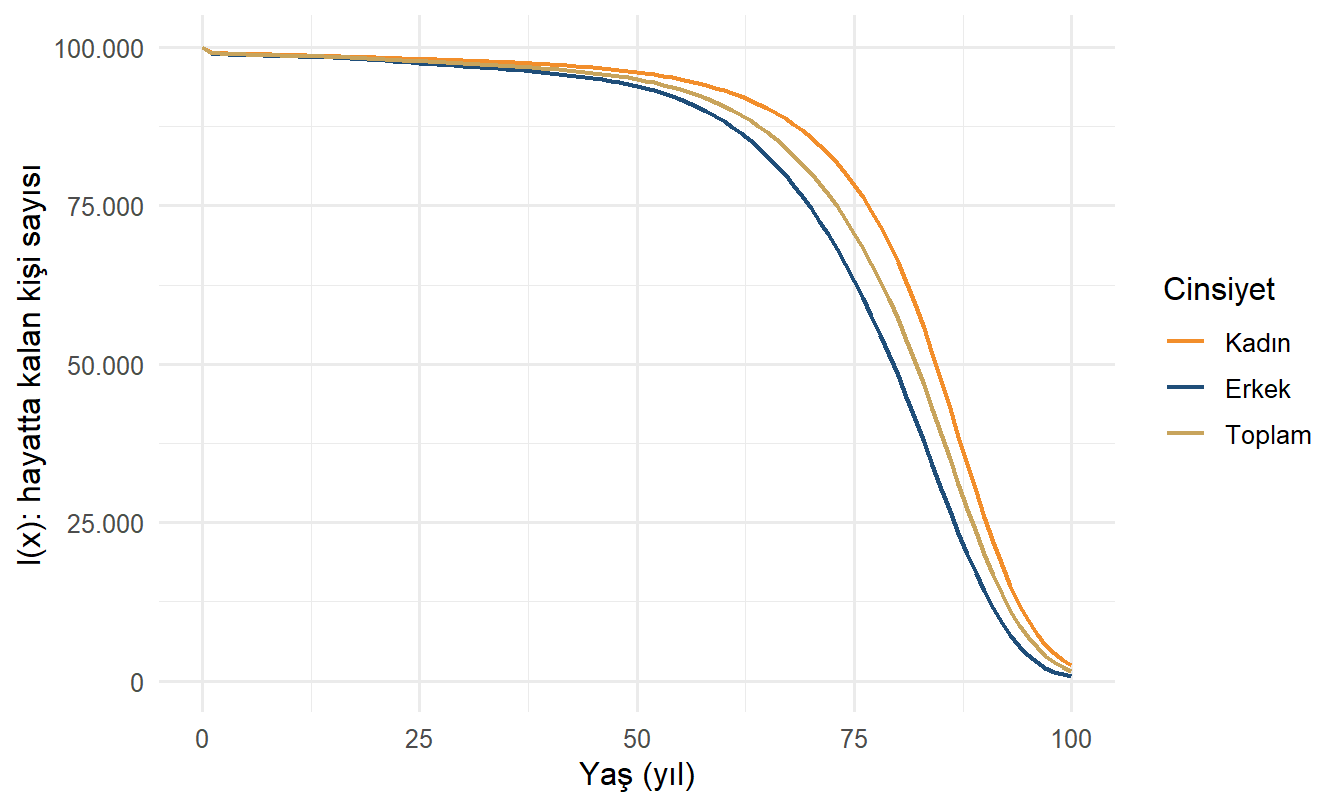
Grafiğin okunacağı yaşlarda sayıları yan yana getirelim:
hayatta_kalanlar |>
  filter(age_start %in% c(50, 70, 80, 82, 90)) |>
  select(age_start, cinsiyet, lx)
#> # A tibble: 15 × 3
#> age_start cinsiyet lx
#> <dbl> <fct> <dbl>
#> 1 50 Toplam 94966.
#> 2 50 Erkek 93892.
#> 3 50 Kadın 96085.
#> 4 70 Toplam 80093.
#> 5 70 Erkek 74579.
#> 6 70 Kadın 85809.
#> 7 80 Toplam 57115.
#> 8 80 Erkek 48180.
#> 9 80 Kadın 66112.
#> 10 82 Toplam 50304.
#> 11 82 Erkek 41248.
#> 12 82 Kadın 59372.
#> 13 90 Toplam 19973.
#> 14 90 Erkek 14080.
#> 15 90 Kadın 25748.Eğriler 50 yaşına kadar neredeyse yataydır: total tablosunda \(l_{50}=94.966\), yani kohortun yalnızca %5’i 50 yaşından önce ölür. Azalma 60 yaşından sonra hızlanır: çıktının Toplam satırlarında \(l_{70}\) ile \(l_{90}\)’ın farkı, kohortun %60’ının 70 ile 90 yaşları arasında öldüğünü gösterir.
Kadın eğrisi 0 yaşından sonraki her yaşta erkek eğrisinin üzerindedir. 80 yaşında kadınların yaklaşık 66.000’i, erkeklerin yaklaşık 48.000’i hayattadır; iki eğri arasındaki açıklık 82 yaşında en geniş hâlini alır ve 18.124 kişiye ulaşır. Bu açıklık, aynı yaştaki bir kadın ile bir erkeğin aynı teminat için farklı ölüm riski taşıdığını gösterir; Görev D farkı yaş yaş \(q_x\) üzerinden ölçer.
Görev A–C ağırlıkla tek bir tabloyla, 2023–2025 döneminin total tablosuyla çalıştı. Görev D bu seçimin neyi gizlediğini dört karşılaştırmayla sorar; her biri bir tablo kararını besler:
| Karşılaştırma | Soru | Hangi karar için |
|---|---|---|
| Cinsiyet | Aynı yaşta kadın ve erkeğin \(q_x\)’i ne kadar ayrışır? | Ayrı tablolar mı, tek bir total tablosu mu; Hafta 9 bu seçimin primdeki karşılığını ölçer |
| Dönem | Bir yıllık kaydırmada ölüm oranları ne kadar hareket eder? | Dönem tablosunun sabit tuttuğu oranlara iyileşme eklenmeli mi |
| Eğitim | Nüfusun alt grupları arasında kalan yaşam ne kadar ayrışır? | Bir portföyün, nüfusun bir alt grubu olarak, nüfus tablosundan ayrışabileceği |
| Sağlıklı yaşam | Uzun yaşamın ne kadarı sağlıklı geçer? | Yaşam beklentisinin bir bakım ya da maluliyet ürününe taşınıp taşınamayacağı |
İlk karşılaştırma cinsiyettir. Grafik için \(l_x\) eğrisindeki hazırlığı yineliyoruz, bu kez açık aralığı dışarıda bırakarak:
olum_olasiligi <- hayat_tablosu |>
  filter(period == guncel_donem, !open_interval, qx > 0) |>
  arrange(age_start) |>
  mutate(
    cinsiyet = factor(
      sex,
      levels = c("female", "male", "total"),
      labels = c("Kadın", "Erkek", "Toplam")
    )
  )

olum_olasiligi
#> # A tibble: 300 × 10
#> period sex age_label age_start open_interval mx qx lx ex
#> <chr> <chr> <chr> <dbl> <lgl> <dbl> <dbl> <dbl> <dbl>
#> 1 2023-20… total 0 0 FALSE 9.02e-3 8.95e-3 1 e5 78.5
#> 2 2023-20… male 0 0 FALSE 9.74e-3 9.66e-3 1 e5 75.9
#> 3 2023-20… fema… 0 0 FALSE 8.25e-3 8.19e-3 1 e5 81.1
#> 4 2023-20… total 1 1 FALSE 9.52e-4 9.51e-4 9.91e4 78.2
#> 5 2023-20… male 1 1 FALSE 9.73e-4 9.73e-4 9.90e4 75.6
#> 6 2023-20… fema… 1 1 FALSE 9.29e-4 9.28e-4 9.92e4 80.8
#> 7 2023-20… total 2 2 FALSE 6.17e-4 6.17e-4 9.90e4 77.3
#> 8 2023-20… male 2 2 FALSE 6.49e-4 6.49e-4 9.89e4 74.7
#> 9 2023-20… fema… 2 2 FALSE 5.84e-4 5.83e-4 9.91e4 79.9
#> 10 2023-20… total 3 3 FALSE 4.97e-4 4.97e-4 9.89e4 76.3
#> # ℹ 290 more rows
#> # ℹ 1 more variable: cinsiyet <fct>Açık aralığın üç satırı çıktığı için tabloda 300 satır kalır: 100+ satırında \(q_x\) tanım gereği 1’dir ve grafiğin sağ ucunda bir sıçrama gibi görünürdü. Şimdi çiziyoruz:
ggplot(olum_olasiligi, aes(age_start, qx, colour = cinsiyet)) +
  geom_line(linewidth = 0.8) +
  scale_y_log10(
    labels = label_number(
      accuracy = 0.0001, decimal.mark = ",", drop0trailing = TRUE
    )
  ) +
  scale_colour_manual(
    values = c("Kadın" = "#F28E2B", "Erkek" = "#1F4E79", "Toplam" = "#C8A45C")
  ) +
  labs(
    x = "Yaş (yıl)",
    y = "q(x): bir yıllık ölüm olasılığı (log ölçek)",
    colour = "Cinsiyet"
  ) +
  theme_minimal(base_size = 12)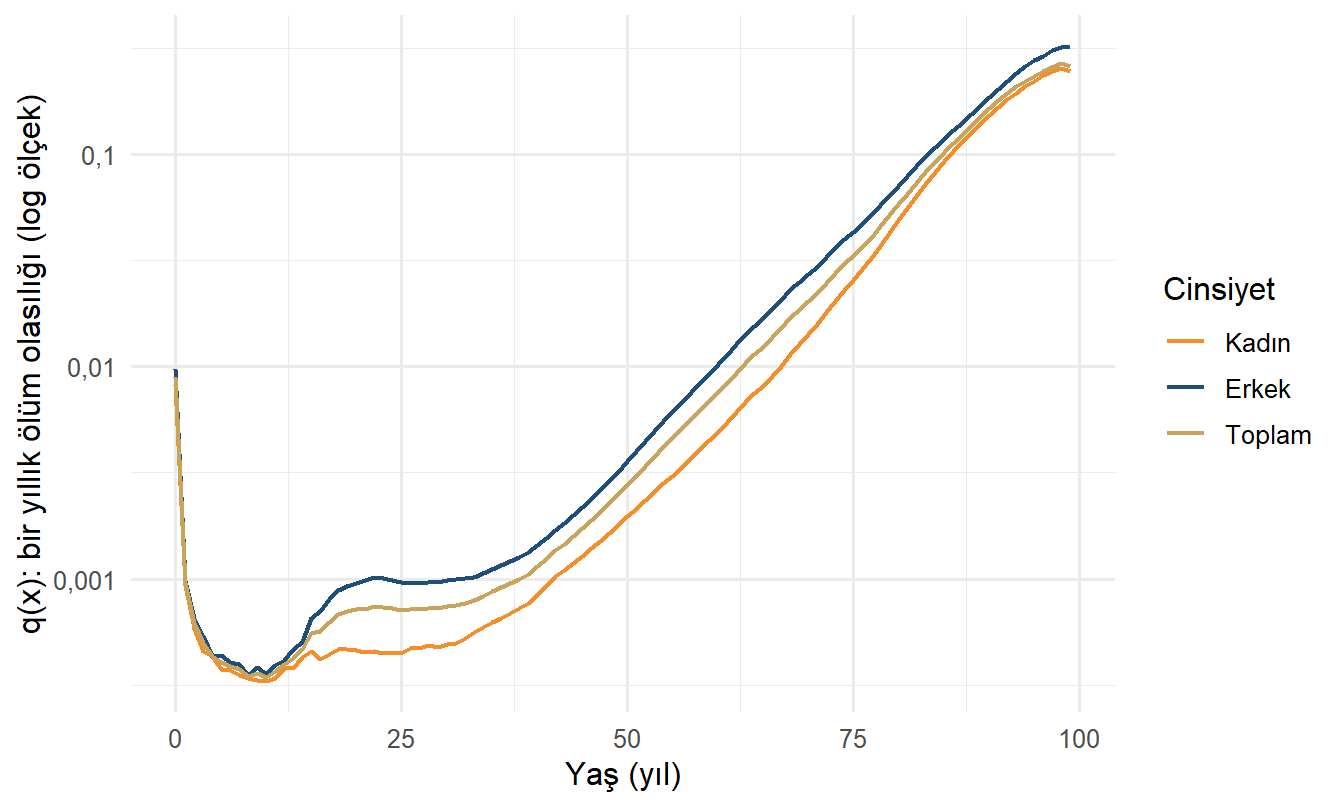
scale_y_log10() — düşey ekseni logaritmik ölçeğe çevirir: eksende her on kat aynı yüksekliği kaplar. Log ekseni sıfır ya da negatif bir değeri çizemez; bu dosyada öyle bir değer yoktur: qx > 0 süzgeci hiçbir satırı çıkarmaz ve 300 noktanın hepsi çizilir. Log ölçeğin gerekçesi aralığın genişliğidir. Grafikteki en küçük ölüm olasılığı 0,000331 (10 yaşındaki kadınlar), en büyüğü 0,319’dur (98 yaşındaki erkekler); en büyük değer en küçüğün yaklaşık 960 katıdır. 300 noktanın 154’ü, yani yarısından fazlası, en büyük değerin yüzde birinden küçüktür; doğrusal eksende bunlar sıfır çizgisinin hemen üstünde üst üste biner, çocukluk ile genç yetişkinlik arasındaki farklar görünmezdi.
Grafiğin iki okumasını sayılarla görelim: iki eğrinin arası ve eğim. Kadın ve erkeğin \(q_x\)’ini altı yaşta yan yana koyuyoruz:
cinsiyet_qx_yaslar <- olum_olasiligi |>
  filter(sex != "total", age_start %in% c(10, 20, 40, 60, 80, 98)) |>
  group_by(age_start) |>
  summarise(
    kadin = qx[sex == "female"],
    erkek = qx[sex == "male"],
    erkek_kadin_orani = erkek / kadin
  )

cinsiyet_qx_yaslar
#> # A tibble: 6 × 4
#> age_start kadin erkek erkek_kadin_orani
#> <dbl> <dbl> <dbl> <dbl>
#> 1 10 0.000331 0.000357 1.08
#> 2 20 0.000464 0.000958 2.07
#> 3 40 0.000840 0.00144 1.71
#> 4 60 0.00493 0.0103 2.08
#> 5 80 0.0489 0.0707 1.45
#> 6 98 0.255 0.319 1.25qx[sex == "female"] — summarise() içinde her yaş grubunun kendi satırlarında çalışır ve o grubun kadın satırındaki değeri seçer. Her yaşta her cinsiyet bir kez geçtiği için sonuç tek bir sayıdır.Tablonun ilk ve son satırı grafiğin iki ucudur. Erkeğin ölüm olasılığı 20, 40 ve 60 yaşlarında kadınınkinin 1,7 ile 2,1 katıdır; 80 yaşında 1,45, 98 yaşında 1,25 katına iner. Log eksende iki eğri arasındaki dikey uzaklık bu oranın logaritmasıdır; eğrilerin ileri yaşlarda birbirine yaklaşması bundandır. Tek bir total tablosu her yaşta bu ikisinin arasında kalır: bir ölüm teminatında kadını olduğundan pahalı, erkeği olduğundan ucuz fiyatlar.
Eğim de bir orandır. Tablonun 80 ve 40 yaş satırlarının oranı kırk yıllık artıştır; bu oranın 40’ıncı kökü, aynı artışı her yıla eşit dağıtan yıllık kattır: kadınlarda 1,107, erkeklerde 1,102. Ölüm olasılığı bu yaşlarda her yıl yaklaşık %10 artar, yani yaklaşık yedi yılda iki katına çıkar. Her yıl aynı oranla artan bir büyüklük log eksende düz bir doğrudur, çünkü eşit oranlar eşit yükseklik kaplar; eğrilerin orta ve ileri yaşlarda doğruya yakın olması bundandır. Yetişkin ölümlülüğünün yaşla böyle üstel artmasına Gompertz yasası (Gompertz law) denir.
Bir dönem tablosu gözlenen üç yılın ölüm oranlarını değişmeyecekmiş gibi kullanır; iki dönemi yan yana koymak bu oranların ne kadar hareket ettiğini gösterir. Dosyanın iki dönemi birbirine çok yakındır: 2022–2024 ile 2023–2025’in 2023 ve 2024 yılları ortaktır. total tablosunda üç yaşı iki dönem için yan yana koyuyoruz.
donem_karsilastirmasi <- hayat_tablosu |>
  filter(sex == "total", age_start %in% c(0, 65, 80)) |>
  group_by(age_start) |>
  summarise(
    qx_2022_24 = qx[period == "2022-2024"],
    qx_2023_25 = qx[period == "2023-2025"],
    qx_degisim = qx_2023_25 / qx_2022_24 - 1,
    ex_2022_24 = ex[period == "2022-2024"],
    ex_2023_25 = ex[period == "2023-2025"],
    ex_farki   = ex_2023_25 - ex_2022_24
  )

donem_karsilastirmasi
#> # A tibble: 3 × 7
#> age_start qx_2022_24 qx_2023_25 qx_degisim ex_2022_24 ex_2023_25 ex_farki
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 0 0.00939 0.00895 -0.0469 78.1 78.5 0.404
#> 2 65 0.0129 0.0124 -0.0398 18.0 18.4 0.363
#> 3 80 0.0614 0.0579 -0.0564 8.04 8.32 0.286Üç yaşın üçünde de ölüm olasılığı düşmüş, kalan yaşam beklentisi uzamıştır. Doğuşta beklenen yaşam 0,40 yıl, 65 yaşında 0,36 yıl uzamış; 65 yaşında ölüm olasılığı %4,0, 80 yaşında %5,6 azalmıştır.
qx_degisim ile ex_farki iki ayrı türden farktır: ilki göreli değişimdir, yani yeni dönemin olasılığının eskisine oranı eksi 1; ikincisi yıl cinsinden farktır.İki dönemin farkı bir yıllık kaydırmadan gelir: 2022 çıkmış, 2025 girmiştir. Bir dönem oranı kabaca üç yılın oranlarının ortalamasıdır; ortak iki yıl farkta birbirini götürür ve kalan, 2025 ile 2022 oranlarının farkının üçte biridir. 65 yaşındaki %4,0’lık düşüş bu yüzden 2022 ile 2025 arasında yaklaşık %12’lik bir düşüşe karşılık gelir. Tek yıllık oranlar dosyada olmadığı için bu bir ölçüm değil, kaba bir okumadır. Dönem tablosu bu iyileşmeyi içermez; onlarca yıl süren bir sözleşmede nasıl hesaba katılacağını Alıştırma 8 tartışır.
İki dosyanın sütunları ve neyi yanıtlayamadıkları veri sözlüğü bölümündedir (Ek iki dosyanın sözlüğü). Önce iki dosyanın yerini denetleyin:
egitim_yolu <- file.path("data", "derived", "life_expectancy_education.csv")
saglikli_yolu <- file.path("data", "derived", "healthy_life_expectancy.csv")
file.exists(c(egitim_yolu, saglikli_yolu))
#> [1] TRUE TRUEİki değer de TRUE olmalıdır. Bu iki dosyanın da yeni bir kopyasını TÜİK’ten indirmeyin: kaynaktaki tablolar da Excel biçimindedir ve her yıl güncellenir. Önce sağlıklı yaşam dosyasını okuyoruz:
saglikli <- read_csv(saglikli_yolu, show_col_types = FALSE)

saglikli
#> # A tibble: 57 × 5
#> age_group age_start open_interval sex healthy_years
#> <chr> <dbl> <lgl> <chr> <dbl>
#> 1 0 0 FALSE total 58.0
#> 2 1-4 1 FALSE total 57.5
#> 3 5-9 5 FALSE total 53.8
#> 4 10-14 10 FALSE total 49.0
#> 5 15-19 15 FALSE total 44.3
#> 6 20-24 20 FALSE total 39.7
#> 7 25-29 25 FALSE total 35.2
#> 8 30-34 30 FALSE total 30.7
#> 9 35-39 35 FALSE total 26.3
#> 10 40-44 40 FALSE total 22.1
#> # ℹ 47 more rowsKarşılaştırmayı doğuşta yapıyoruz: bu dosyanın ilk grubu (0) tek bir yaştır ve hem yaşı hem genişliğiyle ana tablonun 0 yaşına denk gelir.
dogusta_saglikli <- saglikli |>
  filter(age_start == 0) |>
  select(sex, healthy_years)

dogusta_saglikli
#> # A tibble: 3 × 2
#> sex healthy_years
#> <chr> <dbl>
#> 1 total 58.0
#> 2 male 59.1
#> 3 female 56.9Aynı üç grubun doğuşta beklenen yaşam süresini ana tablodan alıyoruz:
dogusta_beklenen <- hayat_tablosu |>
  filter(period == guncel_donem, age_start == 0) |>
  select(sex, ex)

dogusta_beklenen
#> # A tibble: 3 × 2
#> sex ex
#> <chr> <dbl>
#> 1 total 78.5
#> 2 male 75.9
#> 3 female 81.1İki tabloyu cinsiyet üzerinden birleştirip sağlıklı yılların payını hesaplıyoruz:
saglikli_karsilastirma <- dogusta_saglikli |>
  left_join(dogusta_beklenen, by = "sex") |>
  mutate(
    saglikli_pay = healthy_years / ex,
    saglikli_olmayan_yil = ex - healthy_years
  )

saglikli_karsilastirma
#> # A tibble: 3 × 5
#> sex healthy_years ex saglikli_pay saglikli_olmayan_yil
#> <chr> <dbl> <dbl> <dbl> <dbl>
#> 1 total 58.0 78.5 0.739 20.5
#> 2 male 59.1 75.9 0.779 16.7
#> 3 female 56.9 81.1 0.701 24.3left_join(x, y, by = "sex") — her x satırının yanına y’nin aynı cinsiyetteki satırını getirir (2. haftadan tanıdık). İki tabloda da her cinsiyet bir kez geçtiği için sonuç yine üç satırdır.Çıktıda şunları görmelisiniz:
total satırı, TÜİK’in bültende duyurduğu iki sayıyı verir: doğuşta 78,5 yıllık yaşam beklentisinin yaklaşık 58 yılı sağlıklıdır. saglikli_pay’ın anlamını Sullivan yöntemi (Ek iki dosyanın sözlüğü) verir. \(y\) yaşında günlük faaliyetlerinde kısıtlılık bildirenlerin payına \(\pi_y\) dersek, sağlıklı yaşam yılı \(h_x\) (dosyadaki healthy_years), gövdedeki \(e_x=T_x/l_x\)’te her kişi-yılın \(1-\pi_y\) ile çarpılmasıyla bulunur. Doğuşta \(e_0\) bütün kişi-yılların toplamını \(l_0\)’a böldüğü için iki beklentinin oranı \(1-\pi_y\)’lerin kişi-yılla ağırlıklı ortalamasıdır:
\[ \begin{aligned} h_x&=\frac{1}{l_x}\sum_{y\ge x}L_y\,(1-\pi_y),\\ \frac{h_0}{e_0}&=\frac{\sum_{y}L_y\,(1-\pi_y)}{\sum_{y}L_y}. \end{aligned} \]
saglikli_pay bu orandır: kadınların yaşadığı her 100 kişi-yılın yaklaşık 70’i, erkeklerinkinin 78’i kısıtlılıksız geçer.
Daha uzun yaşam bu yüzden daha uzun sağlıklı yaşam demek değildir. Sağlıklı sayılmayan süre (saglikli_olmayan_yil) kadınlarda 24,29, erkeklerde 16,75 yıldır; kadınlarınki 7,54 yıl daha uzundur. Bu farkın 5,27 yılı kadınların daha uzun ömründen, 2,27 yılı da sağlıklı yıllarının erkeklerinkinden kısa olmasından gelir: kadınların fazladan ömrü sağlıklı yıllara değil, kısıtlılıkla geçen süreye eklenir. Kısıtlılık kişinin kendi beyanıdır; farkın kadınların daha sağlıksız olmasından mı, kısıtlılığı daha sık bildirmesinden mi geldiğini bu iki dosya ayıramaz.
Eğitim dosyasına geçiyoruz:
egitim <- read_csv(egitim_yolu, show_col_types = FALSE)

egitim
#> # A tibble: 108 × 4
#> age education sex life_expectancy
#> <dbl> <chr> <chr> <dbl>
#> 1 30 below_upper_secondary total 49.8
#> 2 35 below_upper_secondary total 45.1
#> 3 40 below_upper_secondary total 40.3
#> 4 45 below_upper_secondary total 35.6
#> 5 50 below_upper_secondary total 31.0
#> 6 55 below_upper_secondary total 26.6
#> 7 60 below_upper_secondary total 22.3
#> 8 65 below_upper_secondary total 18.3
#> 9 70 below_upper_secondary total 14.6
#> 10 75 below_upper_secondary total 11.3
#> # ℹ 98 more rowsKarşılaştırmayı dosyadaki en küçük yaşta, 30’da yapalım:
egitim_30 <- egitim |> filter(age == 30)

egitim_30
#> # A tibble: 9 × 4
#> age education sex life_expectancy
#> <dbl> <chr> <chr> <dbl>
#> 1 30 below_upper_secondary total 49.8
#> 2 30 below_upper_secondary male 46.8
#> 3 30 below_upper_secondary female 52.3
#> 4 30 upper_secondary total 51.1
#> 5 30 upper_secondary male 48.9
#> 6 30 upper_secondary female 55.0
#> 7 30 tertiary total 53.4
#> 8 30 tertiary male 51.9
#> 9 30 tertiary female 56.9Dokuz satır vardır: üç eğitim düzeyi ve üç cinsiyet kategorisi. Lise altı ile yükseköğretim arasındaki farkı her cinsiyet kategorisi için hesaplıyoruz:
egitim_farki <- egitim_30 |>
  group_by(sex) |>
  summarise(
    lise_alti = life_expectancy[education == "below_upper_secondary"],
    yuksekogretim = life_expectancy[education == "tertiary"],
    fark = yuksekogretim - lise_alti
  )

egitim_farki
#> # A tibble: 3 × 4
#> sex lise_alti yuksekogretim fark
#> <chr> <dbl> <dbl> <dbl>
#> 1 female 52.3 56.9 4.58
#> 2 male 46.8 51.9 5.10
#> 3 total 49.8 53.4 3.59life_expectancy[education == "tertiary"], cinsiyet_qx_yaslar’daki qx[sex == "female"] gibi, her cinsiyet grubunda o grubun yükseköğretim satırını seçer.
30 yaşında lise altı eğitimli bir kadının kalan yaşam beklentisi 52,3 yıl, yükseköğretim mezunu bir kadınınki 56,9 yıldır; fark 4,58 yıldır. Erkeklerde fark 5,10 yıldır.
total satırındaki fark (3,59 yıl) iki cinsiyetin farkından da küçüktür. Bu bir hata değildir: total her eğitim düzeyinde kadın ve erkek değerlerinin bir karışımıdır. Karışım iki düzeyde aynı olsaydı toplam fark 4,58 ile 5,10 arasında kalırdı; altında kalması, karışımın düzeyden düzeye değiştiğini gösterir.
Dosya karışımı vermez, ama total değerinin iki cinsiyet arasında nerede durduğu okunur:
\[ \text{konum}=\frac{\text{toplam}-\text{erkek}}{\text{kadın}-\text{erkek}} . \]
konum 0 ise total erkek değerine, 1 ise kadın değerine eşittir. Üç eğitim düzeyi için 30 yaşında hesaplayalım; bu kez her eğitim düzeyinde cinsiyet satırları seçilir:
egitim_konum <- egitim_30 |>
  group_by(education) |>
  summarise(
    kadin = life_expectancy[sex == "female"],
    erkek = life_expectancy[sex == "male"],
    toplam = life_expectancy[sex == "total"],
    konum = (toplam - erkek) / (kadin - erkek)
  )

egitim_konum
#> # A tibble: 3 × 5
#> education kadin erkek toplam konum
#> <chr> <dbl> <dbl> <dbl> <dbl>
#> 1 below_upper_secondary 52.3 46.8 49.8 0.541
#> 2 tertiary 56.9 51.9 53.4 0.296
#> 3 upper_secondary 55.0 48.9 51.1 0.369konum lise altında 0,54, lisede 0,37, yükseköğretimde 0,30’dur: eğitim düzeyi yükseldikçe total erkek değerine yaklaşır.
Yükseköğretimin total değeri erkeklerin kısa ömrüne, lise altınınki kadınların uzun ömrüne çekildiği için toplam fark iki cinsiyet farkından da küçük çıkar. Bu, lise altı grubunda kadınların, yükseköğretimde erkeklerin ağırlığının büyük olmasıyla uyumludur; ama konum bir nüfus payı değildir ve dosya grupların gerçek kadın–erkek bileşimini vermez. total satırını üçüncü bir grup gibi okumamanın bir nedeni de budur. Aynı nedenle iki portföyün total tabloyla okunan ölümlülük farkı, portföylerin kadın–erkek bileşimine de bağlıdır.
Görev D’nin yanıtları kısaca şöyledir. total tablosu, genç ve orta yaşlarda riski iki katına yakın farklı iki grubu ortalar. Örtüşen iki dönem arasında bile ölüm olasılıkları düşmüştür ve dönem tablosu bu iyileşmeyi içermez. Eğitim düzeyleri arasındaki fark bir ilişkidir, eğitimin ömrü uzattığını göstermez (Ek iki dosyanın sözlüğü bölümündeki nedensellik uyarısı); ama nüfusun alt grupları arasında kalan yaşamın yıllarca ayrışabildiğini gösterir. “Daha uzun yaşam”, “daha uzun sağlıklı yaşam” demek değildir: kadınların fazladan ömrü kısıtlılıkla geçen süreye eklenir.
Aşağıdaki alıştırmalar haftanın sütun ilişkilerini ve tutarlılık denetimlerini pekiştirmek içindir. Önce kendi çözümünüzü oluşturun, ardından her kutudaki Çözümü göster düğmesiyle karşılaştırın. Gerçek sayılar, aksi söylenmedikçe, tuik_life_table.csv dosyasının 2023–2025 dönemine aittir; Alıştırma 6 ayrıca sağlıklı yaşam dosyasını, Alıştırma 8 iki dönemi birlikte kullanır. Bir alıştırma laboratuvardaki bir tabloya, kurala ya da nesneye dayanıyorsa, o bilgi alıştırmanın içinde yeniden verilmiştir; geri dönüp aramanız gerekmez. Bazı çözümler laboratuvarın nesnelerini (secilen_tablo, tuik_hayat_tablosu, kapali_araliklar) kullanır. Yıldızlı (★) alıştırma daha fazla yorum gerektirir.
Alıştırma 1 (Hayatta kalanlardan olasılıklara). Aşağıdaki hayat tablosu parçası verilmiştir:
| Yaş \(x\) | \(l_x\) |
|---|---|
| 50 | 95.000 |
| 51 | 94.715 |
| 52 | 94.383 |
| 53 | 93.995 |
(a) Gövdenin \(l_x\)’ten ölüm ve sağkalım olasılıkları bölümündeki \(d_x=l_x-l_{x+1}\) tanımıyla
\[ \begin{aligned} d_{50}&=95.000-94.715=285,\\ d_{51}&=94.715-94.383=332,\\ d_{52}&=94.383-93.995=388. \end{aligned} \]
(b) \(q_x=d_x/l_x\) ve \(p_x=l_{x+1}/l_x\) tanımlarıyla
\[ \begin{aligned} q_{50}&=\frac{285}{95.000}=0{,}003000, &\qquad p_{50}&=\frac{94.715}{95.000}=0{,}997000,\\ q_{51}&=\frac{332}{94.715}=0{,}003505, &\qquad p_{51}&=\frac{94.383}{94.715}=0{,}996495,\\ q_{52}&=\frac{388}{94.383}=0{,}004111, &\qquad p_{52}&=\frac{93.995}{94.383}=0{,}995889. \end{aligned} \]
(c) Üç yaşta da toplam tam olarak 1’dir: \(0{,}003000+0{,}997000=1\), \(0{,}003505+0{,}996495=1\) ve \(0{,}004111+0{,}995889=1\). Bunun nedeni aynı \(l_x\) paydası üzerinde yıl içinde ölenlerin (\(l_x-l_{x+1}\)) ve yıl sonunda hayatta olanların (\(l_{x+1}\)) toplanmasıdır; ikisi birlikte yılın başındaki grubu verir: \(d_x+l_{x+1}=l_x\) olduğundan \(q_x+p_x=l_x/l_x=1\).
(d) \(d_{53}=l_{53}-l_{54}\) tanımı \(l_{54}\) değerini gerektirir; tabloda ise 53 son satırdır. R’de lead(lx) bu satırda NA üretir. TÜİK dosyasının 100+ satırında da lead(lx) aynı NA’yı verir, ama iki durum farklıdır. Burada tablo yalnızca bir parçadır: \(l_{54}\) tam tabloda vardır, bu parçada yoktur; bu yüzden \(d_{53}\) buradan bilinemez. 100+ satırında ise ardıl yaş hiç yoktur, ama ölen sayısı yine de bellidir: o aralığa ulaşan herkes orada ölür, \(d_{100+}=l_{100}\) (Açık yaş aralığı bölümü). İkisi de veri hatası değil, tablonun kapsam sınırıdır.
Alıştırma 2 (Hız mı, olasılık mı?). Aşağıdaki değerler 2023–2025 dönemi total tablosundan sekiz ondalığa yuvarlanarak alınmıştır. Burada \(m_x\) merkezi ölüm hızı, \(q_x\) ise bir yıllık ölüm olasılığıdır.
| Yaş | \(m_x\) | \(q_x\) |
|---|---|---|
| 30 | 0,00074213 | 0,00074185 |
| 60 | 0,00759101 | 0,00756243 |
| 80 | 0,05963301 | 0,05791449 |
100+ |
0,24802086 | 1,00000000 |
100+ satırında \(q_x=1\) iken \(m_x=0{,}248\) olması bir çelişki midir? Bu satırda \(1/m_x\) hangi sütuna eşittir?(a) Tabloda verilen değerlerle
\[ \begin{aligned} x=30:&\quad 100\times\frac{0{,}00074213-0{,}00074185}{0{,}00074185}=\%0{,}038,\\ x=60:&\quad 100\times\frac{0{,}00759101-0{,}00756243}{0{,}00756243}=\%0{,}378,\\ x=80:&\quad 100\times\frac{0{,}05963301-0{,}05791449}{0{,}05791449}=\%2{,}967. \end{aligned} \]
(b) İki ölçünün payı aynıdır: yıl içindeki ölüm sayısı. Paydaları farklıdır: \(q_x\) yılın başında hayatta olan \(l_x\) kişiye, \(m_x\) ise yıl içinde fiilen yaşanan kişi-yıla, yani \(L_x\)’e bölünür. Yıl içinde ölenler tam bir yıl yaşamadığından \(L_x<l_x\)’tir ve bu yüzden her yaşta \(m_x>q_x\) olur. Ölümlülük düşükken ölenlerin yaşamadığı kişi-yıl ihmal edilebilir ve iki değer neredeyse aynıdır; 80 yaşında kohortun yaklaşık %5,8’i yıl içinde öldüğü için payda belirgin biçimde küçülür.
Farkın tam büyüklüğü gövdedeki \(a_x=1-1/q_x+1/m_x\) ilişkisinden (\(m_x\) ile \(q_x\) aynı şey değildir bölümü) iki adımda çıkar: \(1-a_x\)’i yalnız bırakın, sonra iki yanı \(m_x\) ile çarpın.
\[ \begin{aligned} 1-a_x&=\frac{1}{q_x}-\frac{1}{m_x},\\ (1-a_x)\,m_x&=\frac{m_x}{q_x}-1\\ &=\frac{m_x-q_x}{q_x}. \end{aligned} \]
Göreli fark tam olarak \((1-a_x)\,m_x\)’tir. Görev B’de \(a_x\) 1 ile 99 yaş arasında 0,460–0,520 aralığında kaldığı için fark yaklaşık \(m_x/2\)’dir ve \(m_x\) ile birlikte büyür: \(m_x\) 30’dan 80’e \(0{,}05963301/0{,}00074213\) \(=80{,}35\) kat artar. Yani \(m_x\) ile \(q_x\)’i birbirinin yerine kullanmak genç yaşlarda zararsız görünür, ileri yaşlarda ise sistematik hata üretir.
\(m_x/2\), 30 yaşında \(0{,}00074213/2\), yani %0,037; 80 yaşında \(0{,}05963301/2\), yani %2,98’dir. 80 yaşında (a)’daki %2,967 ile kalan fark, \(a_{80}=0{,}5024\)’ün 0,5’ten biraz büyük olmasından gelir: \((1-0{,}5024)\times0{,}05963301\) \(=0{,}029673\).
30 yaşında ise (a)’daki %0,038’in bir kısmı tablonun yuvarlamasından gelir: \(m_{30}-q_{30}=0{,}00000028\) farkının yalnızca iki anlamlı basamağı vardır. Dosyanın tam değerleriyle göreli fark %0,0374’tür ve tam değerlerden hesaplanan \(a_{30}=0{,}4959\) ile \((1-0{,}4959)\times0{,}00074213\) \(=0{,}000374\) aynı sayıyı verir. \(a_{30}\)’u tablodaki sekiz ondalıklı değerlerle hesaplamak 0,491 verir: \(1/q_{30}\) ile \(1/m_{30}\) 1.348 dolayındadır ve aradaki yarım birimlik fark sekizinci ondalıktaki yuvarlamaya duyarlıdır.
(c) Çelişki değildir. Açık aralıkta “100 yaşına ulaşan herkes eninde sonunda ölür” olduğu için \(q_x=1\) tanım gereğidir ve bu satırda hiçbir ayırt edici bilgi taşımaz. \(m_x\) ise 100 yaş ve üzerinde yaşanan kişi-yıl başına ölüm sayısını ölçmeye devam eder. Bu satırda
\[ \frac{1}{m_x}=\frac{1}{0{,}24802086}=4{,}031919 \]
bulunur ve bu değer tablodaki \(e_x\) sütununa eşittir (4,031919 yıl). Nedeni Açık yaş aralığı bölümünde gösterildi: açık aralıkta ölen sayısı \(l_{100}\) olduğundan \(e_{100+}=1/m_{100+}\)’dır. Açık aralıkta kalan yaşam beklentisi bu yüzden \(q_x\)’ten değil \(m_x\)’ten gelir; bir olasılık ile bir hızın aynı şey olmadığının en açık örneği budur.
Alıştırma 3 (Paydayı seçmek). 2023–2025 total tablosunda \(l_0=100.000\), \(l_{80}=57.115{,}49\) ve \(l_{90}=19.972{,}70\)’dir.
(a) Ölen sayısı iki \(l_x\) değerinin farkıdır:
\[ l_{80}-l_{90}=57.115{,}49-19.972{,}70=37.142{,}79 \text{ kişi}. \]
(b) Payda doğumdaki kohort büyüklüğüdür:
\[ \frac{37.142{,}79}{100.000}=0{,}371428 \quad (\%37{,}14). \]
(c) Payda 80 yaşına ulaşanların sayısıdır; aranan olasılık \({}_{10}q_{80}\)’dir:
\[ {}_{10}q_{80}=\frac{37.142{,}79}{57.115{,}49}=0{,}650310 \quad (\%65{,}03). \]
Kontrol: \({}_{10}p_{80}=19.972{,}70/57.115{,}49=0{,}349690\) ve \({}_{10}q_{80}+{}_{10}p_{80}=0{,}650310+0{,}349690=1\).
(d) Pay iki hesapta da aynıdır; yalnızca payda değişir. Koşulsuz olasılık iki şeyin birlikte olmasıdır: önce 80 yaşına ulaşmak, sonra 80 ile 90 arasında ölmek. Kohortun yalnızca %57,1’i 80 yaşına ulaşır (\({}_{80}p_0=l_{80}/l_0=0{,}571155\)) ve (b)’deki olasılık bu iki adımın çarpımıdır; \({}_{80}p_0\) ile (c)’deki \({}_{10}q_{80}\) çarpılınca \(l_{80}\) sadeleşir:
\[ \begin{aligned} &\frac{l_{80}-l_{90}}{l_0}={}_{80}p_0\times{}_{10}q_{80}\\ &=0{,}571155\times0{,}650310\\ &=0{,}371428. \end{aligned} \]
Bu yüzden koşullu olasılık, koşulsuz olanın \(1/0{,}571155\approx1{,}75\) katıdır. 80 yaşındaki bir kişiye ürün fiyatlayan aktüer için o kişinin 80 yaşına ulaşmış olması zaten bilinen bir bilgidir; doğru ölçü koşullu olasılıktır. Bu, Hafta 1’deki maruziyet tartışmasının hayat tablosundaki karşılığıdır: yanlış payda, doğru görünen bir hesabı yanlış bir sonuca çevirir.
Alıştırma 4 (Birden çok yıl için sağkalım). Aynı tabloda \(l_{60}=90.718{,}34\), \(l_{65}=86.532{,}04\) ve \(l_{70}=80.093{,}45\)’tir. Çok yıllık sağkalım olasılığı gövdenin \(l_x\)’ten ölüm ve sağkalım olasılıkları bölümünde tanımlandı: \({}_{t}p_{x}=l_{x+t}/l_{x}\).
secilen_tablo çerçevesinden kurulan tuik_hayat_tablosu nesnesiyle (a) şıkkındaki \({}_{5}p_{60}\) değerini pxt() ile doğrulayın.secilen_tablo, Görev A’da seçilen 2023–2025 total tablosudur; tuik_hayat_tablosu Görev B’de ondan şöyle kurulmuştu:
tuik_hayat_tablosu <- new(
  "lifetable",
  x = secilen_tablo$age_start,
  lx = secilen_tablo$lx,
  name = "TÜİK 2023-2025 toplam"
)(a)
\[ {}_{5}p_{60}=\frac{86.532{,}04}{90.718{,}34}=0{,}953854, \qquad {}_{10}p_{60}=\frac{80.093{,}45}{90.718{,}34}=0{,}882880. \]
(b)
\[ {}_{5}p_{65}=\frac{80.093{,}45}{86.532{,}04}=0{,}925593, \qquad 0{,}953854\times0{,}925593=0{,}882881. \]
Yuvarlanmamış \(l_x\) değerleriyle çalışıldığında iki taraf tam olarak eşittir; yukarıdaki son basamak farkı hesap hatası değil, ara sonuçları altı basamağa yuvarlamanın etkisidir. Eşitliğin kendisi \(l_{70}/l_{60}=(l_{65}/l_{60})\times(l_{70}/l_{65})\) sadeleşmesinden gelir: 60’tan 70’e ulaşmak, önce 65’e ulaşıp sonra oradan 70’e ulaşmakla aynı olaydır.
(c) 65 ile 70 arasında ölenlerin payı, paydası \(l_{60}\) olan bir orandır:
\[ {}_{5|5}q_{60}=\frac{86.532{,}04-80.093{,}45}{90.718{,}34} =\frac{6.438{,}59}{90.718{,}34}=0{,}070973. \]
Ayrıca \({}_{5}q_{60}=1-0{,}953854=0{,}046146\) olduğundan
\[ 0{,}046146+0{,}070973+0{,}882880=0{,}999999\approx1. \]
Tam duyarlıkla toplam tam olarak 1’dir; 60 yaşındaki bir kişi ya ilk beş yılda ölür, ya 65–70 arasında ölür, ya da 70 yaşına ulaşır. Bu üç olay birbirini dışlar ve birlikte bütün olasılığı kaplar.
(d) Nesne Görev B’de, lifecontingencies karşılaştırmasındaki küçük tablo gibi kuruldu; yaşlar ve \(l_x\) değerleri secilen_tablo çerçevesinden gelir. Doğrulama elle bulunan değeri paketinkiyle karşılaştırır:
elle_5p60 <- secilen_tablo$lx[secilen_tablo$age_start == 65] /
  secilen_tablo$lx[secilen_tablo$age_start == 60]
paket_5p60 <- pxt(tuik_hayat_tablosu, x = 60, t = 5)

stopifnot(isTRUE(all.equal(elle_5p60, paket_5p60)))
c(elle = elle_5p60, paket = paket_5p60)
İki değer de 0,953854’tür; qxt(tuik_hayat_tablosu, x = 60, t = 5) ise 0,046146 verir. Nesnede 100 yaşı son satırdır ve nesne onun ötesine ait bir değer taşımaz; ama \({}_{5}p_{60}\) yalnızca 60 ve 65 yaşlarının \(l_x\) değerlerini kullandığı için sonuç bundan etkilenmez. Denetim başarısız olsaydı bu, tablonun bozulduğunu değil, büyük olasılıkla yaş indeksinin bir satır kaydığını gösterirdi.
Alıştırma 5 (Tutarlılık denetimleri). Bir hayat tablosu dosyasından alınan aşağıdaki beş satır tek bir dönem–cinsiyet birleşimine aittir:
| Satır | age_label |
open_interval |
qx |
lx |
|---|---|---|---|---|
| 1 | 70 | FALSE |
0,020226 | 80.093,4 |
| 2 | 71 | FALSE |
0,022050 | 80.150,0 |
| 3 | 72 | FALSE |
1,024711 | 76.743,1 |
| 4 | 72 | FALSE |
0,024711 | 76.743,1 |
| 5 | 100+ |
TRUE |
1,000000 | 1.582,6 |
Görev C’nin dört kuralı, uygulandıkları satırlarla birlikte:
qx 0 ile 1 arasında olmalı — dosyanın bütün satırlarında;lx yaşla artmamalı — kapalı yaş aralıklarında;qx, lx’ten türetilen qx_turetilen ile aynı olmalı — kapalı yaş aralıklarında;lx’in yaşla artmadığını denetleyen tek satırlık R koşulunu yazın ve açık yaş aralığı satırının neden bu denetim kümesinin dışında tutulduğunu açıklayın.(a) Üç hata vardır ve ikisi ikişer kuralı çiğner:
age_label (72) birleşimi iki kez yer alır; 4. kuralın anyDuplicated() denetimi bunu yakalar.Bunların hiçbiri “araştırılacak inceleme bayrağı” değildir; dördü de analizi durdurması gereken yapısal kurallardır. Düzeltilmeden hesaplanan \(d_x\) ve \(p_x\) sütunları anlamsız olur; Görev B’de \(L_x=d_x/m_x\) üzerinden kurulan \(e_x\) de öyle.
(b) 100+ açık bir yaş aralığıdır. Bir sonraki tek yaş bulunmadığından lead(lx) NA verir ve \(d_x\) ile \(p_x\) hesaplanamaz. \(q_x=1\) ise tanım gereğidir: açık aralıktaki herkes eninde sonunda ölür. Bu değer \([0,1]\) sınırını da ihlal etmez. Bu nedenle satır, türetilmiş sütunlara dayanan denetimlerin dışında bırakılır.
(c) Laboratuvardaki koşul şudur:
kapali_araliklar <- secilen_tablo |> filter(!open_interval)
all(diff(kapali_araliklar$lx) <= 0)
Sonucun TRUE olması gerekir; FALSE çıkması en az bir yaşta hayatta kalan sayısının arttığını, yani yaş sıralamasının ya da veri kaynağının bozulduğunu gösterir. Yukarıdaki tabloya uygulandığında 2. satır yüzünden sonuç FALSE olur.
Açık aralık satırını bu kural için dışarıda tutmak aslında zorunlu değildir: \(l_{100}\), 100 yaşına ulaşanların sayısıdır ve \(l_{99}\)’dan büyük olamaz, yani satır kurala uyar. Satır, aynı kapali_araliklar çerçevesi yayımlanan ve türetilen \(q_x\)’i karşılaştıran kuralda da kullanıldığı için dışarıda kalır: o kural türetilmiş qx_turetilen sütununa dayanır ve açık aralıkta bu sütun NA’dır. Öteki iki kural — \(q_x\)’in \([0,1]\) aralığında kalması ve birleşimlerin tekrar etmemesi — dosyanın bütün satırlarına uygulanır.
Alıştırma 6 (★ Uzun yaşam mı, sağlıklı yaşam mı?). 2023–2025 tablosunda 65 yaşındaki bir kişi için kalan yaşam beklentisi kadınlarda \(e_{65}=19{,}98\), erkeklerde \(e_{65}=16{,}66\) yıldır; aynı yaşta bir yıllık ölüm olasılıkları \(q_{65}=0{,}008107\) (kadın) ve \(q_{65}=0{,}016811\) (erkek) olarak verilmiştir. healthy_life_expectancy.csv dosyasında 65–69 yaş grubunun sağlıklı yaşam yılı ise kadınlarda 5,84, erkeklerde 6,95’tir.
(a) \(19{,}98-16{,}66=3{,}32\) yıl. Aynı yönde bir gözlem olarak, 65 yaşında erkeğin bir yıllık ölüm olasılığı kadınınkinin yaklaşık 2,07 katıdır (\(0{,}016811/0{,}008107\)).
(b) Sağlıklı yılların kalan yaşama oranı:
\[ \text{kadın: } \frac{5{,}84}{19{,}98}=0{,}292 \ (\%29{,}2), \qquad \text{erkek: } \frac{6{,}95}{16{,}66}=0{,}417 \ (\%41{,}7). \]
Sağlıklı sayılmayan süre kadınlarda \(19{,}98-5{,}84=14{,}14\) yıl, erkeklerde \(16{,}66-6{,}95=9{,}71\) yıldır.
(c) Hayır, üç ayrı nedenle.
65-69 satırındaki 5,84 yıl o grubun içinde yaşanan yıl değildir, çünkü beş yıllık bir grupta en çok beş yıl yaşanır; 65 yaşından sonra beklenen sağlıklı yıllardır. İki sayı da 65 yaşından başlar, ama hesap yolları farklıdır; karşılaştırma bu nedenle yaklaşıktır. (d) En az şu üç çekince yazılmalıdır:
healthy_years, hayat tablosunu bir araştırmadaki sağlık beyanıyla birleştiren bir göstergedir. Burada “sağlıklı” olmak, kişinin günlük faaliyetlerinde kısıtlılık bildirmemesi demektir; bir sigorta ürününün ödeme koşulu olan sağlık tanımı (örneğin bakım ihtiyacı ya da maluliyet) değildir. Bu nedenle bu sayı bir bakım ya da maluliyet ürününün fiyatına doğrudan konulamaz. Ayrıca cinsiyete göre farklı tarife uygulanıp uygulanamayacağı ayrı bir düzenleme sorunudur.Bu nedenle ders içindeki bütün prim ve anüite örnekleri öğretim amaçlıdır; ticari tarife olarak sunulamaz.
Bu alıştırmalar hesaplamadan çok, kullanılan ölçünün anlamını ve analizin sınırlılıklarını kısa biçimde tartışmak içindir. Önce yanıtınızı oluşturun, ardından ilgili Çözümü göster düğmesiyle karşılaştırın.
Alıştırma 7 (Grup ortalaması ve birey). Aynı yaşta kadınların qx değeri daha düşükse bu, her kadının her erkekten uzun yaşayacağı anlamına gelir mi?
Hayır. \(q_x\) bir bireyin değil, o yaştaki bütün grubun ortalama ölüm olasılığıdır. 2023–2025 tablosunda 65 yaşında \(q_{65}=0{,}008107\) (kadın) ve \(q_{65}=0{,}016811\) (erkek) olduğundan erkeklerin bir yıllık ölüm olasılığı kadınlarınkinin yaklaşık 2,07 katıdır; ama her iki cinsiyette de o yaştakilerin %98’inden fazlası yılı tamamlar. Ölüm yaşı dağılımları da büyük ölçüde çakışır. 65 yaşındaki erkeklerin yaklaşık yarısı 82 yaşına ulaşır (\(l_{82}/l_{65}=41.248/82.846\) \(=0{,}498\)); aynı yaştaki kadınların ise %34’ü 82 yaşından önce ölür (\(1-59.372/90.361\) \(=0{,}343\)). Yani kadınların üçte birinden fazlası, erkeklerin yarısının ulaştığı yaşa ulaşamaz. Tablo ayrıca betimseldir: cinsiyet ile ölümlülük arasında nedensel bir bağ kurmaz (Alıştırma 6(c)). Doğru okuma “aynı yaşta erkek grubunun ortalama riski daha yüksektir” biçimindedir, “her erkek daha kısa yaşar” biçiminde değil.
Alıştırma 8 (Dönem tablosunun sınırı). Dönem hayat tablosu gelecek mortalite iyileşmesini otomatik olarak içerir mi?
Hayır. Dönem tablosu, adı geçen üç yılda bütün yaşlarda aynı anda gözlenen ölüm oranlarını alır ve bu oranları hiç değişmeyecekmiş gibi varsayımsal bir kohorta uygular. Oysa oranlar zaman içinde hareket eder ve Görev D’deki dönem tablosu bunu gösterir: total için doğuşta beklenen yaşam süresi 2022–2024 döneminde 78,09 yıl iken 2023–2025 döneminde 78,49 yıldır; 65 yaşında ölüm olasılığı %4,0, 80 yaşında %5,6 düşmüştür. İki dönemin iki yılı ortaktır (2023 ve 2024); üç yıllık pencereyi bir yıl ileri kaydırmak, yani 2022’yi çıkarıp 2025’i eklemek bile doğuşta 0,40 yıllık bir fark üretmiştir. Bugün 40 yaşında olan birinin 80 yaşındaki ölüm olasılığı, bugünün 80 yaşlılarının oranı değil, kırk yıl sonrasının oranı olacaktır. Gelecekteki iyileşmeyi hesaba katmak için ya bir kohort hayat tablosu (cohort life table) ya da dönem tablosunun üzerine açıkça yazılmış bir iyileşme (projeksiyon) varsayımı gerekir. Uzun süreli sözleşmelerde bu ayrım fiyatı doğrudan etkiler.
Görev D’nin dönem karşılaştırması (total tablosu):
| Yaş | \(q_x\), 2022–2024 | \(q_x\), 2023–2025 | \(q_x\)’teki değişim | \(e_x\), 2022–2024 | \(e_x\), 2023–2025 |
|---|---|---|---|---|---|
| 0 | 0,009388 | 0,008948 | −%4,7 | 78,09 | 78,49 |
| 65 | 0,012871 | 0,012359 | −%4,0 | 18,04 | 18,40 |
| 80 | 0,061377 | 0,057914 | −%5,6 | 8,04 | 8,32 |
Alıştırma 9 (Ölçek ve olasılık). lx değerini 100.000 yerine 1.000 ile başlatmak qx’i değiştirir mi?
Değiştirmez. \(q_x=(l_x-l_{x+1})/l_x\) bir orandır; pay ve payda aynı sabitle çarpıldığında sabit sadeleşir. Aynı şey \(p_x=l_{x+1}/l_x\) için ve \(e_x=T_x/l_x\) için de geçerlidir: \(T_x\)’teki kişi-yıllar da kişi sayısıyla birlikte aynı sabitle çarpılır. Değişen yalnızca mutlak sayılardır: 2023–2025 total tablosunda \(l_0=100.000\) ile \(d_{60}=686{,}05\) kişi bulunurken \(l_0=1.000\) ile aynı değer 6,86 olur. Bu nedenle \(l_0\), yani gövdedeki başlangıç büyüklüğü, bir ölçek seçimidir, bir varsayım değildir; tablodaki 100.000 sayısı gerçek bir nüfusu değil, okumayı kolaylaştıran varsayımsal bir kohort büyüklüğünü gösterir.
Alıştırma 10 (Küçük sayısal farklar). qx_turetilen ile yayımlanmış qx arasında küçük farklar çıkmasının iki olası nedeni nedir?
Birinci neden yayımlama yuvarlamasıdır: \(q_x\) ile \(l_x\) farklı basamak sayılarıyla yayımlandığında, yuvarlanmış \(l_x\)’ten yeniden üretilen \(q_x\) son basamaklarda tutmayabilir. İkinci neden kayan noktalı aritmetiktir; bölme ve çıkarma işlemleri \(10^{-15}\) düzeyinde artık bırakır. Bu haftanın dosyasında fiilen ikincisi geçerlidir ve Görev B’deki qx_en_buyuk_fark çıktısı bunu gösterir: bütün tabloda \(|q_x^{\text{türetilen}}-q_x|\) farkının en büyüğü yaklaşık \(3{,}4\times10^{-15}\)’tir, yani sütunlar kendi içinde tutarlıdır. Aynı çıktı farkın tek bir satırda NA olduğunu da gösterir: 100+ satırında lead(lx) bir sonraki yaşı bulamaz ve bu bir hata değil, açık aralığın sınırıdır.
Görev B’nin qx_en_buyuk_fark çıktısı, 2023–2025 total tablosunun 101 satırı için:
en_buyuk_mutlak_fark |
eksik_fark |
|---|---|
| \(3{,}4\cdot10^{-15}\) | 1 (100+ satırı) |
Birinci nedenin ne kadarlık bir fark üretebileceğini ölçebiliriz. Aşağıdaki blok, \(l_x\) tam kişiye yuvarlanarak yayımlansaydı türetilen \(q_x\)’in yayımlanandan en çok hangi yaşta ve ne kadar ayrılacağını bulur.
yuvarlama_etkisi <- secilen_tablo |>
  mutate(
    lx_tam_kisi = round(lx),
    qx_tam_kisiden = (lx_tam_kisi - lead(lx_tam_kisi)) / lx_tam_kisi,
    yuvarlama_farki = qx_tam_kisiden - qx
  ) |>
  filter(!open_interval) |>
  slice_max(abs(yuvarlama_farki), n = 1) |>
  select(age_start, lx, lx_tam_kisi, qx, qx_tam_kisiden, yuvarlama_farki)

yuvarlama_etkisi
#> # A tibble: 1 × 6
#> age_start lx lx_tam_kisi qx qx_tam_kisiden yuvarlama_farki
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 99 2137. 2137 0.259 0.259 -0.000131En büyük fark 99 yaşındadır: \(l_{99}=2.136{,}79\) ve \(l_{100}=1.582{,}57\) tam kişiye yuvarlanınca \(q_{99}=(2.137-1.583)/2.137\) \(=0{,}259242\) çıkar; yayımlanan değer 0,259373’tür ve fark 0,000131’dir.
Fark dördüncü ondalıktadır, çünkü payda küçüktür: yuvarlamada her \(l_x\) en çok yarım kişi, \(d_{99}\) en çok bir kişi oynar; \(q_{99}\) de bu yüzden \(1/2.137\approx0{,}00047\) mertebesinde kayabilir. 30 yaşında, 97.459 kişilik paydada, aynı yuvarlamanın farkı yalnızca \(3{,}1\cdot10^{-6}\)’dır. 100 kapalı yaşın 13’ünde fark \(10^{-5}\)’i aşar ve hepsi 80 yaş ve üzeridir.
Demek ki dördüncü ondalıktaki bir fark da yuvarlamadan gelebilir; ölçüt, yayımlanan basamak sayısının üretebileceği farktır. Bu dosyada \(l_x\) yuvarlanmadan yayımlanır (1 yaşında 99.105,2052692 kişi); bu yüzden yuvarlama payı yoktur ve \(3{,}4\cdot10^{-15}\) yalnızca kayan nokta artığıdır. Bu düzeyi belirgin biçimde aşan bir fark ise yanlış sıralamayı, dönem–cinsiyet süzgecinin karışmasını ya da yaş indeksinin bir satır kaymasını düşündürmelidir. Görev C’deki 1e-10 payı da yalnızca böyle bir dosyada işler: tam kişiye yuvarlanmış bir tabloda üçüncü kural 100 kapalı yaşın hepsinde bozulurdu.
Alıştırma 11 (Nüfus tablosu ve tarife). TÜİK tablosundan bulunan bir prim neden gerçek sigorta tarifesi olarak sunulmamalıdır?
Çünkü TÜİK tablosu Türkiye nüfusuna ait bir dönem tablosudur; sigorta portföyünün deneyimini değil, sigortalı olan olmayan herkesin ortalamasını ölçer. Sigortalanan kişiler sağlık değerlendirmesinden geçtiği için ilk yıllarda nüfustan daha düşük ölümlülük gösterir (sayfanın başındaki uyarıda adı geçen seçilmiş mortalite), anüite satın alanlar ise kendi uzun ömürlülüğünü bildiği için ters seçilim (anti-selection) yoluyla nüfus ortalamasından uzun yaşar. Bu iki etki aynı tabloyu iki yönde birden yanıltıcı kılar: nüfus tablosuyla hesaplanan hayat sigortası primi olduğundan yüksek, anüite primi ise olduğundan düşük çıkar. Buna gelecekteki mortalite iyileşmesinin, gider paylarının, iptal ve faiz varsayımlarının hiçbirinin bu hesapta bulunmaması eklenir. Bu nedenle derste hesaplanan bütün prim değerleri yalnızca yöntemi göstermek için üretilmiş öğretim örnekleridir ve ticari tarife olarak sunulamaz.