Kodu göster / gizle
library(readr)
library(dplyr)
library(ggplot2)
library(scales)IST5109 İleri Aktüerya Teknikleri · Sigorta Verileriyle İstatistiksel Programlama
Geçen haftaya kadar ölçtüğümüz büyüklükler sayılar ve tutarlardı: hasar sayısı, kayıp, ödeme, toplam hasar, prim. Süre yalnızca maruziyet olarak, sıklığın paydasında göründü (Hafta 1 ve 3). Bu hafta sürenin kendisini ölçüyoruz.
Bir kişinin ölümüne, bir poliçenin sona ermesine ya da bir hasarın kapanmasına kadar geçen süre sıradan bir sayısal değişken gibi ele alınamaz. Gözlem sona erdiğinde olay henüz gerçekleşmemiş olabilir. O zaman olay zamanını bilmeyiz, ama hakkında kısmi bir bilgimiz vardır: olay zamanı, gözlemin bittiği andan büyüktür. Bu duruma sansürleme (censoring) denir; kısmi bilgi atılmaz, hesaba katılır.
Bu hafta sağkalım ve hazard kavramlarını tanımlarından kuracak, küçük bir risk tablosundan Kaplan–Meier ve Nelson–Aalen tahminlerini elle üretecek, sonra aynı sonuçları survival paketiyle doğrulayacağız. Ardından aynı araçları, büyük bir Kanada sigorta şirketinin yıllık gelir sözleşmelerinden alınmış 2.000 kişilik bir dosyada kullanacağız.
Oturum sonunda öğrenci:
Surv() ve survfit() ile aynı sonuçları üretip doğrular;time sütununun sansürlü satırlarda neyi taşıdığını açıklar;| Süre | Etkinlik |
|---|---|
| 0–40 dk | Olay zamanı, sansürleme, sağkalım, hazard ve \(S(t)=e^{-H(t)}\) ilişkisi |
| 40–75 dk | Risk tablosu; Kaplan–Meier, medyan, Nelson–Aalen’in elle hesabı ve iki tahminin farkı; Greenwood varyansı ve güven aralığı; survival ile doğrulama |
| 75–85 dk | Ara |
| 85–100 dk | canlifins veri sözlüğü, dosyayı okumak ve yapısal denetim |
| 100–155 dk | R laboratuvarı: Görev A–E |
| 155–175 dk | Eğri, belirsizlik ve sınırlılık tartışması |
| 175–180 dk | Haftanın özeti ve açık sorular |
\(T\ge0\), bir başlangıç anından ilgilendiğimiz olaya kadar geçen süre olsun. Olay:
olabilir. Olay da başlangıç anı da analizden önce sabitlenmelidir. Başlangıç anı, yani zamanın sıfır noktası poliçenin başladığı gün, hasarın bildirildiği gün ya da doğum olabilir ve süre ona göre değişir: 60 yaşında poliçesi başlayıp 75 yaşında ölen birinin süresi poliçe başlangıcından ölçülürse 15 yıl, doğumdan ölçülürse 75 yıldır. Bu haftanın gerçek verisinde sıfır noktası doğumdur ve süre bir yaştır.
Her gözlem için en az iki alan gerekir:
time: seçilen zaman ölçeğinde gözlenen süre veya yaş,event: olay gözlendiyse 1, gözlem olay görülmeden bittiyse 0.event = 0, olayın hiç gerçekleşmeyeceğini değil, gözlem penceresinde gerçekleşmediğini söyler.
Sağdan sansürleme (right censoring), olayın gözlem sona erene kadar gerçekleşmemesidir: olay zamanının yalnızca bir değerden büyük olduğunu biliriz. Her kişi için iki zaman vardır. \(T\) gerçek olay zamanıdır. \(C\) ise olay olmasa bile gözlemin biteceği an, yani sansür zamanıdır: çalışmanın kapandığı tarih ya da kişinin izlemden ayrıldığı an. Hangisi önce gelirse gözlem o anda biter. Veride bu yüzden ikisi birden görünmez; görünen iki şeydir: gözlemin bittiği an \(Y\) ve gözlemi neyin bitirdiğini söyleyen olay göstergesi \(\delta\):
\[ \begin{aligned} Y&=\min(T,C),\\ \delta&=\begin{cases}1, & T\le C\ \text{(önce olay geldi)},\\ 0, & T>C\ \text{(önce gözlem bitti)}.\end{cases} \end{aligned} \]
Sayfanın sonraki bölümleri altı kişilik küçük bir örnek kullanır; altısı birden Risk kümesi bölümünde tabloya girer. İlk iki kişi, çalışmanın 10 yıl sürdüğünü varsayarak şöyledir:
| Kişi | \(T\) | \(C\) | \(Y\) (time) |
\(\delta\) (event) |
Bildiğimiz |
|---|---|---|---|---|---|
| 1 | 2 | 10 | 2 | 1 | 2’de öldü: \(T=2\) |
| 2 | bilinmiyor | 3 | 3 | 0 | 3’te izlemden ayrıldı, o an hayattaydı: \(T>3\) |
Kişi 1’de önce ölüm geldi, \(Y\) ölüm zamanıdır. Kişi 2’de önce gözlem bitti; \(Y=3\) ile \(\delta=0\) birlikte, ölümün 3’ten sonra olduğunu söyler. Bir sağkalım dosyasında \(Y\) time, \(\delta\) event sütunudur. (Bu haftanın gerçek dosyasında sansürlü satırların time’ı \(Y\)’yi değil, kişinin gözleme girdiği yaşı taşır; Veri sözlüğü bölümünde ayrıca okuyacağız.)
Kişi 2 gibi sansürlü bir gözlemle ne yapıldığı, hayatta kalanların payının doğru hesaplanıp hesaplanmayacağını belirler. Yalnız bu iki kişiye bakalım: biri (kişi 1) 2’de öldü, öbürü (kişi 2) 3’te hâlâ hayattaydı. 2’yi olaysız geçenlerin payı bu yüzden kesin olarak \(1/2\)’dir. Akla üç yol gelir:
İki yanlış da hayatta kalanların payını yalnızca düşürebilir, hiçbir zaman artıramaz. Nedeni sayımdadır. Silmek ölümleri olduğu gibi bırakır, ama her ölüm anında risk altındaki kişi sayısını azaltır. Olay saymak risk altındaki kişi sayısını aynı bırakır, ama ölüm ekler. İkisinde de bir ölüm anında ölenlerin risk altındakilere oranı büyür ya da aynı kalır; o anı olaysız geçenlerin payı da bu yüzden küçülür ya da aynı kalır. Hayatta kalmak her ölüm anını olaysız geçmek demek olduğu için genel pay da küçülür ya da aynı kalır. Yukarıdaki iki kişide silmek payı \(1/2\)’den \(0\)’a indirdi. Alıştırma 3 aynı karşılaştırmayı sekiz kişilik bir örnekte, laboratuvarın Görev E’si sansürü olay saymanın etkisini dersin dosyasında yapar.
Sağkalım fonksiyonu, olayın \(t\) anına kadar gerçekleşmemiş olma olasılığıdır. Hafta 3’te hasar tutarı için tanımladığımız ve orada aşma olasılığı dediğimiz \(1-F\)’nin aynısıdır; bu kez değişken bir süredir:
\[ S(t)=P(T>t)=1-F(t). \]
Burada \(F(t)=P(T\le t)\), olayın \(t\)’ye kadar gerçekleşmiş olma olasılığıdır (dağılım fonksiyonu). Onun türevi \(f(t)=F'(t)\), olay zamanının yoğunluğudur: küçük bir \(\Delta t\) için
\[ P(t<T\le t+\Delta t)\approx f(t)\,\Delta t. \]
Sol taraf, başlangıçtan bakıldığında olayın \(t\) ile \(t+\Delta t\) arasında gerçekleşme olasılığıdır. \(f(t)\) ise bu olasılığın aralık uzunluğuna bölümünün, aralık kısalırken yaklaştığı değerdir; Hafta 3’teki gibi kendisi bir olasılık değildir ve 1’i aşabilir. \(S=1-F\) olduğu için \(f(t)=-S'(t)\)’dir: sağkalım eğrisi \(t\)’de ne kadar dik iniyorsa yoğunluk o kadar büyüktür.
Hazard (hazard rate), \(t\)’ye kadar olay yaşamadan gelmiş birinin hemen sonraki kısa bir aralıkta olay yaşama olasılığının aralık uzunluğuna bölümüdür; aralık sıfıra kısaltılırken bu bölümün limiti alınır:
\[ h(t)=\lim_{\Delta t\to0} \frac{P(t<T\le t+\Delta t\mid T>t)}{\Delta t}. \]
Tanımın iki parçası vardır:
Hazard bu yüzden bir olasılık değil, bir hızdır (rate): birimi “zaman başına”dır ve 1’den büyük olabilir.
Hazard ile sağkalımın ilişkisi. Yoğunluk ile hazard aynı kısa aralığa bakar, ama farklı kişilere. \(f(t)\,\Delta t\), başlangıçtaki herkes için olayın \(t\) ile \(t+\Delta t\) arasında olma olasılığıdır; \(h(t)\,\Delta t\) aynı olasılığı yalnızca \(t\)’ye olaysız ulaşanlar için verir. İkincisi birincinin \(S(t)\)’ye bölümüdür:
\[ h(t)=\frac{f(t)}{S(t)}=-\frac{d}{dt}\log S(t). \]
Neden \(S(t)\)’ye bölünür? Hazard tanımındaki olasılık koşulludur; koşullu olasılık da olayın olasılığının koşulun olasılığına bölümüdür. Koşul \(T>t\)’dir ve olasılığı \(S(t)\)’dir. Olay, \(t\) ile \(t+\Delta t\) arasında olay yaşamaktır; bu aralıkta olay yaşayan herkes \(t\)’ye olaysız ulaşmış olduğundan, olayın koşulla birlikte olasılığı aralığa düşme olasılığının kendisidir, yani yaklaşık \(f(t)\,\Delta t\). İkinci eşitlik aynı kesrin başka bir yazılışıdır: \(f=-S'\) olduğu için \(f/S=-S'/S\)’dir ve bu, \(\log S\)’nin türevinin eksi işaretlisidir. Bu biçim aşağıda kümülatif hazardı tanımlarken işe yarar.
Türetmeler, kapalı duran ve tıklanınca açılan Türetmeyi göster kutularındadır; metin yalnız sonuçları ve ne anlama geldiklerini verir. Her kutu, türettiği formülün altındadır.
Koşullu olasılık. İki olay adlandırılır: \(A=\{t<T\le t+\Delta t\}\), olayın aralıkta gerçekleşmesi; \(B=\{T>t\}\), \(t\)’ye olaysız ulaşmak. \(A\) gerçekleşmişse \(T>t\)’dir; yani \(A\), \(B\)’nin içinde kalır ve \(A\cap B=A\)’dır:
\[ \begin{aligned} P(A\mid B)&=\frac{P(A\cap B)}{P(B)}\\ &=\frac{P(A)}{P(B)}\\ &=\frac{F(t+\Delta t)-F(t)}{S(t)}. \end{aligned} \]
Eşitlikler sırasıyla:
Limit. Bu kesir hazard tanımındaki koşullu olasılığın yerine yazılır ve \(\Delta t\)’ye bölünür:
\[ \begin{aligned} h(t)&=\lim_{\Delta t\to0}\frac{F(t+\Delta t)-F(t)}{\Delta t\,S(t)}\\ &=\frac{1}{S(t)}\lim_{\Delta t\to0}\frac{F(t+\Delta t)-F(t)}{\Delta t}\\ &=\frac{f(t)}{S(t)}. \end{aligned} \]
Eşitlikler sırasıyla:
Limit alınmadan, küçük bir \(\Delta t\) için aynı adımlar \(h(t)\,\Delta t\approx P(A\mid B)\) \(=P(A)/S(t)\) \(\approx f(t)\,\Delta t/S(t)\) verir: yukarıda sözle anlatılan bölme budur.
Logaritmik biçim.
\[ \begin{aligned} \frac{f(t)}{S(t)}&=\frac{-S'(t)}{S(t)}\\ &=-\frac{d}{dt}\log S(t). \end{aligned} \]
Eşitlikler sırasıyla:
Sayıyla. 100 kişiyi başlangıçtan izleyelim. Bunlardan 40’ı 70 yaşına olaysız ulaşmış, bu 40 kişiden 4’ü de 70 ile 71 yaş arasında ölmüş olsun. Aralık bir yıldır (\(\Delta t=1\)). Üç olasılığın payı ve paydası şöyledir:
| Olasılık | Sorduğu | Pay / payda | Değer |
|---|---|---|---|
| \(S(70)\) | Başlangıçtaki biri 70’e olaysız ulaşır mı? | 40 / 100 | 0,40 |
| \(f(70)\,\Delta t\) | Başlangıçtaki biri 70 ile 71 arasında ölür mü? | 4 / 100 | 0,04 |
| \(h(70)\,\Delta t\) | 70’e ulaşmış biri 70 ile 71 arasında ölür mü? | 4 / 40 | 0,10 |
\(f\,\Delta t\) ile \(h\,\Delta t\) aynı 4 ölümü sayar; yalnızca paydaları farklıdır: biri başlangıçtaki 100 kişi, öbürü 70’e ulaşan 40 kişi. \(S(70)\) de bu iki paydanın oranıdır, \(40/100\). Formül paydayı bu oranla değiştirir:
\[ \begin{aligned} h(70)\,\Delta t&\approx\frac{f(70)\,\Delta t}{S(70)}\\ &=\frac{4/100}{40/100}=\frac{4}{40}=0{,}10. \end{aligned} \]
\(S(70)\)’e bölmek 100’leri sadeleştirir ve ölümleri başlangıçtaki 100 kişi yerine 70’e ulaşan 40 kişiyle karşılaştırır. Tanımdaki \(T>t\) koşulu hesapta bu bölmedir. Bir yıl kısa bir aralık olmadığı için \(f\,\Delta t\) ve \(h\,\Delta t\) burada yaklaşık değerlerdir; ama \(4/40=(4/100)/(40/100)\) eşitliği yaklaşık değil, tamdır: aralık ne uzunlukta olursa olsun koşullu olasılık, birlikte olasılığın koşulun olasılığına bölümüdür.
Kümülatif hazard (cumulative hazard), hazardın \(0\)’dan \(t\)’ye birikimidir. Hazard \(-\log S\)’nin türevi olduğu için birikimi \(-\log S\)’nin kendisidir:
\[ \begin{aligned} H(t)&=\int_0^t h(u)\,du=-\log S(t),\\ S(t)&=e^{-H(t)}. \end{aligned} \]
\(H(t)\) bir olasılık değildir; hızların birikimidir ve 1’i aşabilir. Onu ayrıca tanımlamamızın nedeni, Nelson–Aalen tahmini bölümünde veriden toplanarak tahmin edilecek olmasıdır: \(S=e^{-H}\) bu tahmini sağkalıma çevirir.
Hazard ile sağkalımın ilişkisinin logaritmik biçimi \(h(u)=-\frac{d}{du}\log S(u)\)’dur. İki yanın \(0\)’dan \(t\)’ye integrali alınır:
\[ \begin{aligned} H(t)&=\int_0^t h(u)\,du\\ &=-\int_0^t\frac{d}{du}\log S(u)\,du\\ &=-\bigl[\log S(t)-\log S(0)\bigr]\\ &=-\log S(t). \end{aligned} \]
Eşitlikler sırasıyla:
Son eşitlik \(\log S(t)=-H(t)\) demektir; iki yanın üsteli alınınca \(S(t)=e^{-H(t)}\) çıkar.
Anlamı. Hazard her an aynıysa, \(h(t)=\lambda\), o ana kadar olaysız gelmiş birinin hemen sonraki kısa aralıkta olay yaşama riski, kişinin ne kadar süredir gözlendiğine bağlı değildir: yeni girmiş biriyle on yıldır olaysız biri aynı riski taşır. Rastgele bir arıza böyle düşünülebilir; insan ölümü böyle değildir, çünkü hazard yaşla artar.
Sağkalım. Yukarıdaki iki formüle sabit hazard konur:
\[ \begin{aligned} H(t)&=\int_0^t\lambda\,du=\lambda t,\\ S(t)&=e^{-H(t)}=e^{-\lambda t}. \end{aligned} \]
Bu üstel dağılımdır. Üç özelliğine sırayla bakalım: yoğunluğu, Hafta 3’teki Gamma dağılımıyla bağı ve hazardının neden gerçekten sabit çıktığı.
1. Yoğunluk. Yoğunluk, sağkalımın türevinin eksi işaretlisidir: \(f=-S'\). \(e^{-\lambda t}\)’nin türevi zincir kuralıyla bulunur: üsteki \(-\lambda t\)’nin türevi \(-\lambda\)’dır ve bu çarpan öne iner, \(S'(t)=-\lambda e^{-\lambda t}\). Buradan:
\[ \begin{aligned} f(t)&=-S'(t)\\ &=-\bigl(-\lambda e^{-\lambda t}\bigr)\\ &=\lambda e^{-\lambda t}. \end{aligned} \]
2. Gamma’nın özel hâli. Hafta 3’teki Gamma yoğunluğu \(\beta^{\alpha}x^{\alpha-1}e^{-\beta x}/\Gamma(\alpha)\)’dır. İçine \(x\) yerine \(t\), \(\alpha=1\) ve \(\beta=\lambda\) konur:
\[ \begin{aligned} \frac{\beta^{\alpha}t^{\alpha-1}e^{-\beta t}}{\Gamma(\alpha)} &=\frac{\lambda^{1}\,t^{0}\,e^{-\lambda t}}{\Gamma(1)}\\ &=\lambda e^{-\lambda t}. \end{aligned} \]
İkinci satırda \(\lambda^{1}=\lambda\), \(t^{0}=1\) ve \(\Gamma(1)=0!=1\)’dir. Sonuç, birinci adımda bulduğumuz yoğunluğun aynısıdır: üstel dağılım, Gamma’nın \(\alpha=1\) hâlidir.
3. Hazard sabit kalır. Yoğunluk ile sağkalım hazard formülüne konunca \(e^{-\lambda t}\) çarpanı pay ile paydada sadeleşir:
\[ h(t)=\frac{f(t)}{S(t)}=\frac{\lambda e^{-\lambda t}}{e^{-\lambda t}}=\lambda. \]
Yoğunluk zamanla küçülür, ama sağkalım da aynı oranda küçülür; ikisinin oranı değişmez. Örneğin \(\lambda=2\) (yıl başına) için:
| \(t\) (yıl) | \(S(t)=e^{-2t}\) | \(f(t)=2e^{-2t}\) | \(h(t)=f(t)/S(t)\) |
|---|---|---|---|
| 0 | 1,0000 | 2,0000 | 2 |
| 0,5 | 0,3679 | 0,7358 | 2 |
| 1 | 0,1353 | 0,2707 | 2 |
Yoğunluğun küçülmesi riskin azaldığı anlamına gelmez. \(f(t)\) başlangıçtaki herkese göredir ve \(t\) büyüdükçe o ana olaysız ulaşan kişi azalır: 1 yılda başlangıçtakilerin yalnızca %13,53’ü kalmıştır. Olay yaşayanlar azalır, çünkü olay yaşayabilecek kişi azalmıştır; \(t\)’ye ulaşanlar arasında risk her an aynıdır, \(\lambda=2\).
Ortalama olay zamanı, Hafta 3’teki \(E[T]=\int_0^\infty S(t)\,dt\) eşitliğinden
\[ E[T]=\int_0^\infty e^{-\lambda t}\,dt=\frac{1}{\lambda} \]
olur: ortalama süre hazardın tersidir; hazard büyüdükçe olay erken gelir.
\[ \begin{aligned} E[T]&=\int_0^\infty e^{-\lambda t}\,dt\\ &=\Bigl[-\frac{1}{\lambda}e^{-\lambda t}\Bigr]_0^\infty\\ &=0-\Bigl(-\frac{1}{\lambda}\Bigr)\\ &=\frac{1}{\lambda}. \end{aligned} \]
Eşitlikler sırasıyla:
Sayıyla: hız ile olasılık. Hazardın neden bir olasılık değil bir hız olduğunu bir örnekle görelim. Ortalama süresi yarım yıl (6 ay) olan bir olay alalım. Ortalama süre hazardın tersi olduğu için hazard
\[ \lambda=\frac{1}{E[T]}=\frac{1}{0{,}5}=2 \]
olur ve birimi “yıl başına”dır. Bu sayı 1’den büyüktür; bir olasılık olsaydı 1’i aşamazdı. Nedenini, böyle 100 kişiyi herkes olayını yaşayana kadar izleyerek adım adım görelim:
Oran 1’i aşar, çünkü payda kişi sayısı değil, risk altında geçen süredir. Her kişi olayını ortalama yarım yılda yaşayıp riskten çıktığı için 100 kişi toplam 50 kişi-yıl risk altında kalır; bir kişi-yıllık risk süresine iki olay düşer. Hafta 1’deki hasar sıklığı da böyle bir hızdı: hasar sayısının, poliçelerin risk altında geçirdiği süreye (maruziyete) bölümü. Bir olasılık ise kişi sayısına bölünür ve bir zaman aralığı ister; “olay yaşar mı?” sorusu süre belirtilmeden sorulursa yanıt herkes için evettir. Aşağıda önce ilk yılın olasılığını bulup sonra ikisini aynı yılda yan yana koyuyoruz.
Aynı olayın bir yıllık olasılığı. Tek bir kişinin ilk yıl içinde olay yaşama olasılığı \(1-S(1)\)’dir ve kümülatif hazard üzerinden üç adımda bulunur:
\[ \begin{aligned} H(1)&=\lambda\cdot1=2,\\ S(1)&=e^{-H(1)}=e^{-2}=0{,}1353,\\ 1-S(1)&=1-0{,}1353=0{,}8647. \end{aligned} \]
\(S(1)=0{,}1353\), yukarıdaki tablonun \(t=1\) satırıdır. Bir yıllık kümülatif hazard 2’dir ve 1’i aşar; bir yıllık olasılık 0,8647’dir ve olasılık olduğu için aşamaz: 100 kişiden yaklaşık 86’sı ilk yıl içinde olay yaşar.
Olasılık ile hız aynı yılda. Aynı 100 kişiyi yalnızca ilk yıl boyunca izleyelim. İki ölçünün payı aynıdır: ilk yılda beklenen olay sayısı, \(100\cdot0{,}8647=86{,}47\). Fark paydadadır:
Kişi başına ortalama risk süresi, olayın ya da yıl sonunun hangisi önce gelirse ona kadar geçen süredir. Hafta 5’teki sınırlı beklenen değer formülüyle bu, ilk \(u\) yılı olaysız geçirme olasılığının (\(e^{-2u}\)) \(0\)’dan \(1\)’e integralidir:
\[ \begin{aligned} E[\min(T,\,1)]&=\int_0^1 e^{-2u}\,du\\ &=\frac{1-e^{-2}}{2}=0{,}4323\ \text{yıl}. \end{aligned} \]
100 kişide bu 43,23 kişi-yıldır. İki ölçü yan yana:
| Olasılık | Hız (hazard) | |
|---|---|---|
| Pay: ilk yıldaki olay | 86,47 | 86,47 |
| Payda | 100 kişi | 43,23 kişi-yıl |
| Oran | 0,8647 | 2 |
Olasılık 1’i aşamaz, çünkü her kişi paydada bir kez sayılır ve en çok bir kez olay yaşar. Hız aşabilir, çünkü olayını yaşayan kişi paydaya artık süre eklemez: 100 kişi bir yılda 100 değil, yalnızca 43,23 kişi-yıl risk altında kalır. Sabit hazardda bu oran hangi aralık seçilirse seçilsin 2’dir; olasılık ise aralık uzadıkça 1’e yaklaşır.
Birim değişince. Aynı olayı ay birimiyle yazalım: ortalama süre 6 ay, hazard \(\lambda=1/6=0{,}1667\) (ay başına), bir yılda 12 ay vardır.
| Birim | \(\lambda\) | Bir yıllık \(H\) | Bir yıllık olasılık |
|---|---|---|---|
| Yıl | 2 | \(2\cdot1=2\) | 0,8647 |
| Ay | 0,1667 | \((1/6)\cdot12=2\) | 0,8647 |
Hızın sayısı birime bağlıdır (yıl başına 2, ay başına 0,1667); bir yıllık kümülatif hazard ve olasılık bağlı değildir.
Tanımdaki limit. Hazard tanımı, koşullu olasılığın aralık uzunluğuna bölümünün limitiydi. Bu örnekte o limiti sayıyla izleyebiliriz. Önce koşullu olasılık: \(t\)’ye olaysız ulaşmış birinin sonraki \(\Delta t\) içinde olay yaşama olasılığı
\[ \begin{aligned} &P(t<T\le t+\Delta t\mid T>t)\\ &=\frac{S(t)-S(t+\Delta t)}{S(t)}\\ &=1-\frac{e^{-2(t+\Delta t)}}{e^{-2t}}\\ &=1-e^{-2\Delta t}. \end{aligned} \]
Eşitlikler sırasıyla:
Sonuçta \(t\) yoktur; sabit hazardın anlamı tam da budur.
Olasılığı \(\Delta t\)’ye bölmek ne anlatır? Koşullu olasılık tek bir kişi için sorulur; onu bir gruba çevirince bölmenin anlamı görünür. \(t\)’ye olaysız ulaşmış 1.000 kişi alalım:
\[ \begin{aligned} \frac{\text{olasılık}}{\Delta t} &=\frac{1.000\times\text{olasılık}}{1.000\times\Delta t}\\ &=\frac{\text{olay sayısı}}{\text{kişi-yıl}}. \end{aligned} \]
Olasılık / \(\Delta t\) bu yüzden, Sayıyla: hız ile olasılık örneğindeki gibi, kişi-yıl başına olay sayısıdır ve birimi “yıl başına”dır. Şimdi aralığı kısaltalım:
| \(\Delta t\) (yıl) | Koşullu olasılık |
1.000 kişide olay |
Kişi-yıl \(1.000\times\Delta t\) |
Olasılık / \(\Delta t\) |
|---|---|---|---|---|
| 1 | 0,8647 | 864,7 | 1.000 | 0,8647 |
| 0,1 | 0,1813 | 181,3 | 100 | 1,813 |
| 0,01 | 0,01980 | 19,80 | 10 | 1,980 |
| 0,001 | 0,001998 | 1,998 | 1 | 1,998 |
Aralık kısaldıkça olasılığın kendisi sıfıra gider, çünkü kısa bir aralıkta olay yaşayan az kişi olur. Ama kişi-yıl başına olay sayısı, yani olasılığın aralık uzunluğuna bölümü, hazarda, 2’ye yaklaşır: hazard bu bölümün limitidir.
Uzun aralıkta bölüm neden 2’nin altında kalır? Bir yıllık aralıkta bölüm 0,8647’dir. Tablonun dördüncü sütunu herkesin aralığın tamamında risk altında kaldığını varsayar. Oysa aralığın başında olay yaşayan biri aralığın kalanında artık risk altında değildir; aynı kişi ikinci kez olay yaşayamaz. Sayıyla: hız ile olasılık örneğindeki gibi, sabit hazardda bir kişinin bir yıllık aralıkta gerçekten risk altında geçirdiği süre ortalama 0,4323 yıldır. 1.000 kişide bu 1.000 değil, 432,3 kişi-yıldır; olay sayısı bu gerçek süreye bölününce \(864{,}7/432{,}3=2\) çıkar, tam hazard. Aralık kısaldıkça aralık içinde olay yaşayan azalır, varsayılan süre gerçek süreye yaklaşır ve fark kaybolur.
Sonraki iki bölümün tahmin edicileri, Kaplan–Meier ve Nelson–Aalen, her ölüm anında iki soruya verilen yanıttan kurulur: o anda kaç kişi ölebilirdi ve kaç kişi öldü? Sansürlü bir kişinin hangi ölümlerde sayılacağı da bu sorularla belirlenir; Sağdan sansürleme bölümündeki doğru yol budur. Altı kişi için gözlenen veri solda, bu bölümde ondan kuracağımız risk tablosu sağdadır:
| Kişi | Süre ( time) |
Olay ( event) |
|---|---|---|
| 1 | 2 | 1 (olay) |
| 2 | 3 | 0 (sansür) |
| 3 | 3 | 1 (olay) |
| 4 | 5 | 1 (olay) |
| 5 | 6 | 0 (sansür) |
| 6 | 8 | 1 (olay) |
| \(t_j\) | \(n_j\) | \(d_j\) | \(d_j/n_j\) | \(1-d_j/n_j\) |
|---|---|---|---|---|
| 2 | 6 | 1 | 1/6 | 5/6 |
| 3 | 5 | 1 | 1/5 | 4/5 |
| 5 | 3 | 1 | 1/3 | 2/3 |
| 8 | 1 | 1 | 1/1 | 0 |
Sağdaki tablonun her satırı bir olay zamanıdır; sütunlarını bu bölümde soldaki veriden tek tek kuracağız. Soldaki tablonun süre sütunu \(Y\), olay sütunu \(\delta\)’dır: örneğin kişi 2 için bildiğimiz yalnızca \(T>3\)’tür. Olay zamanları 2, 3, 5 ve 8’dir; sansür zamanları 3 ve 6’dır. 3’te bir ölüm (kişi 3) ile bir sansür (kişi 2) aynı ana düşer.
Olay zamanlarını küçükten büyüğe \(t_1<t_2<\dots\) diye adlandıralım; bu örnekte \(t_1=2\), \(t_2=3\), \(t_3=5\) ve \(t_4=8\)’dir: sağdaki tablonun \(t_j\) sütunu. Bir \(t_j\) anında risk kümesi (risk set), \(t_j\)’den önce ne olay yaşamış ne de sansürlenmiş, yani tam o anda olay yaşayabilecek kişilerdir. Hazard tanımındaki \(T>t\) koşulunun veride karşılığıdır. Her olay zamanı için sağdaki tablonun ikinci ve üçüncü sütunundaki iki sayı yazılır:
Saymanın pratik kuralı bu tanımdan çıkar: süresi \(t_j\)’den küçük olan biri \(t_j\)’den önce ya ölmüş ya da sansürlenmiştir. \(n_j\) bu yüzden süresi \(t_j\)’den küçük olmayan kişi sayısıdır. Altı kişide:
3’teki sayım bir kurala dayanır. Aynı zamana düşen gözlemlere bağlı gözlemler (ties) denir ve iki tür bağ için kural gerekir:
Hangi kuralın kullanıldığı veri tanımında ve yazılımda belgelenmelidir; survival paketi yaygın kuralı uygular.
Bu sayılar, bölümün başında verinin sağında duran risk tablosunda toplanır. Tablo soldan sağa şöyle doldurulur:
\(d_j/n_j\) neden doğru oran? Sezgiyle açık görünür, ama bir modelden de çıkar. Adım adım:
Adım 1: varsayım. Riskteki \(n_j\) kişinin her biri \(t_j\)’de, birbirinden bağımsız olarak, aynı \(q\) olasılığıyla ölür. \(q\) her olay zamanında başka olabilir; yazıyı sade tutmak için \(j\) indisini yazmıyoruz.
Adım 2: model. O zaman ölüm sayısı \(d_j\), \(n_j\) denemeli ve her denemede başarı olasılığı \(q\) olan bir binom değişkendir:
\[ P(d_j)=\binom{n_j}{d_j}\,q^{d_j}\,(1-q)^{n_j-d_j}. \]
Adım 3: tahmin ilkesi. \(q\) için, gözlenen \(d_j\)’yi en olası kılan değer seçilir. Bu, Hafta 3’ün Küçük çalışılmış örnek: Poisson bölümündeki maksimum olabilirlik ilkesidir.
Adım 4: sayıyla. 2’de \(n_j=6\), \(d_j=1\)’dir. Altı kişiden hangisinin öleceği 6 biçimde olabilir; binom katsayısı bu yüzden \(\binom{6}{1}=6\)’dır ve gözlenen sonucun olasılığı \(6\,q\,(1-q)^5\)’tir. Tabloda \(q\), \(d_j/n_j=1/6\) ile onun iki yanındaki birkaç değerdir. Örneğin \(q=1/6\)’da \(6\cdot(1/6)\cdot(5/6)^5\) \(=(5/6)^5\) \(=0{,}4019\)’dur:
| \(q\) | \(6\,q\,(1-q)^5\) |
|---|---|
| 0,10 | 0,3543 |
| \(1/6\approx0{,}1667\) | 0,4019 |
| 0,25 | 0,3560 |
| 0,40 | 0,1866 |
En yüksek değer \(q=1/6\)’dadır, yani risk tablosundaki \(d_j/n_j\).
Adım 5: genel sonuç. Dört değer, \(1/6\)’nın yalnızca bu dördü arasında en iyisi olduğunu gösterir. Bütün \(q\) değerleri arasında en iyisi olduğunu göstermek için, Hafta 3’teki gibi olasılığın logaritması (log-olabilirlik) alınır ve türevi sıfıra eşitlenir (türetme aşağıdaki kutuda). Sonuç risk tablosunun her satırında aynı biçimdedir: olay yaşayanların riskteki kişilere oranı.
\[ \widehat q=\frac{d_j}{n_j}. \]
\(d_j\)’nin binom olasılığının logaritması üç terimdir:
\[ \begin{aligned} \ell(q)&=\log\binom{n_j}{d_j}+d_j\log q\\ &\quad+(n_j-d_j)\log(1-q). \end{aligned} \]
Türev terim terim alınır: sabit binom katsayısı kaybolur, \(\log q\)’nunki \(1/q\), \(\log(1-q)\)’nunki zincir kuralıyla \(-1/(1-q)\)’dur:
\[ \begin{aligned} \frac{d_j}{q}-\frac{n_j-d_j}{1-q}&=0\\ d_j(1-q)&=(n_j-d_j)\,q\\ d_j-d_jq&=n_jq-d_jq\\ d_j&=n_jq\\ \widehat q&=d_j/n_j. \end{aligned} \]
Satırlar sırasıyla:
İkinci türev \(-d_j/q^2-(n_j-d_j)/(1-q)^2\) her \(0<q<1\)’de negatiftir; bulunan nokta bir tepedir. \(d_j=n_j\) ise (tablonun 8’deki satırı) log-olabilirlik \(n_j\log q\)’dur ve \(q\) ile artar: tepe sınırda, \(q=1\)’dedir ve formül yine 1 verir.
Aşağıdaki iki tahmin edici bu aynı sütunu kullanır: Kaplan–Meier onun 1’den farkını çarpar, Nelson–Aalen kendisini toplar.
Soru. Risk tablosundan sağkalım eğrisini, yani her \(t\) için \(\widehat S(t)\)’yi nasıl kurarız? “5’ten sonra hayatta olanların herkese oranı”nı doğrudan sayamayız: kişi 2’nin 5’te hayatta olup olmadığını bilmiyoruz. Kaplan–Meier bu sorunu, sağkalımı her olay anını atlatma olasılıklarına ayırarak çözer.
Adım 1: sağkalımı olay zamanlarında parçalara ayırmak. 5’i olaysız geçmek için önce 2’yi, sonra 3’ü, sonra 5’i olaysız geçmek gerekir. Sağkalım bu yüzden koşullu olasılıkların çarpımıdır:
\[ \begin{aligned} S(5)&=P(T>2)\\ &\quad\times P(T>3\mid T>2)\\ &\quad\times P(T>5\mid T>3). \end{aligned} \]
Koşullu olasılığın tanımı adım adım uygulanır:
\[ \begin{aligned} S(5)&=P(T>5)\\ &=P(T>3)\,\frac{P(T>5)}{P(T>3)}\\ &=P(T>3)\,P(T>5\mid T>3)\\ &=P(T>2)\,\frac{P(T>3)}{P(T>2)}\\ &\quad\times P(T>5\mid T>3)\\ &=P(T>2)\,P(T>3\mid T>2)\\ &\quad\times P(T>5\mid T>3). \end{aligned} \]
Eşitlikler sırasıyla:
Her yeni olay zamanı çarpıma bir koşullu olasılık daha ekler.
Adım 2: her çarpanı tahmin etmek. Her çarpan bir olay anını atlatma olasılığıdır. Tahmini, risk tablosunun son sütunu \(1-d_j/n_j\)’dir: 3’te riskteki beş kişiden dördü ölmedi, \(P(T>3\mid T>2)\)’nin tahmini \(4/5\)’tir. Sansürlü kişi 2 bu hesaba katkı yapar: 3’teki beş kişinin içindedir, 5’tekilerin içinde değildir.
Bölme noktaları neden yalnızca olay zamanlarıdır? Araya 4 gibi bir nokta daha koysaydık çarpıma \(P(T>4\mid T>3)\) de girerdi. 4’te riskte üç kişi vardır (süreleri 5, 6 ve 8) ve ölen yoktur; bu çarpanın tahmini \(1-0/3=1\)’dir ve çarpımı değiştirmez. Olay zamanlarının arasındaki her nokta için durum aynıdır: ölüm olmayan bir anın çarpanı 1’dir.
Adım 3: çarpmak. Kaplan–Meier tahmini, \(t\)’ye kadarki bütün olay zamanlarının çarpanlarının çarpımıdır (\(\prod\) işareti “çarp” demektir):
\[ \widehat S(t)=\prod_{t_j\le t}\left(1-\frac{d_j}{n_j}\right). \]
İlk olay zamanından önce kimse ölmemiştir, \(\widehat S(t)=1\)’dir; tablo bu yüzden 1’den başlar ve her satırda bir önceki değer o satırın çarpanıyla çarpılır:
| \(t_j\) | Çarpan \(1-d_j/n_j\) | Hesap | \(\widehat S(t_j)\) |
|---|---|---|---|
| 2 | 5/6 | \(1\cdot5/6=5/6\) | 0,8333 |
| 3 | 4/5 | \(5/6\cdot4/5=2/3\) | 0,6667 |
| 5 | 2/3 | \(2/3\cdot2/3=4/9\) | 0,4444 |
| 8 | 0 | \(4/9\cdot0=0\) | 0 |
Adım 4: olay zamanlarının arasında. \(\widehat S(t)\) yalnızca olay zamanlarında değişir; aradaki \(t\)’lerde son olay zamanındaki değerde kalır. Örneğin \(\widehat S(4)=\widehat S(3)=0{,}6667\)’dir. Eğri bu yüzden basamaklıdır. Sansür zamanı 6 eğriyi düşürmez; yalnızca sonraki risk kümesini küçültür ve eğrinin grafiğinde küçük bir işaretle gösterilir (grafik Açık R koduyla risk tablosu ve Kaplan–Meier eğrisi bölümünde çizilir).
Varsayım. Kaplan–Meier, bilgi taşımayan sansür (non-informative censoring) varsayar: sansürlenen kişinin, sansür anından sonra riskte kalanlarla aynı olay riskini taşıdığı kabul edilir. Çalışmadan ayrılma yüksek riskle ilişkiliyse bu varsayım tartışılmalıdır.
Varsayım neyi belirler? 5’e kadarki sağkalımı iki uç hesapla sınırlayalım. 5’e kadar kesin ölenler kişi 1, 3 ve 4’tür. Belirsiz olan, 3’te sansürlenen kişi 2’dir; 6’da sansürlenen kişi 5 ise 5’te hâlâ hayattadır.
Kaplan–Meier ikisinin arasındadır. Adım adım:
\[ \widehat S(5)=\frac{6-3-1/3}{6}=\frac{4}{9}=0{,}4444 . \]
İki uç kişi 2’yi 1 ya da 0 ölüm sayar, Kaplan–Meier \(1/3\). Aradaki her değer veriyle uyumludur, çünkü sansürlenenlerin sonrası gözlenmemiştir; seçimi varsayım yapar. Alt uç, laboratuvarın Görev E’sinde bilerek kurulan sansürü olay sayan eğrinin bu örnekteki karşılığıdır.
Sigortacılık diliyle: bu küçük portföyde beşinci yılı olaysız tamamlama tahmini %44,4’tür. O anda risk kümesi yalnızca 3 kişi olduğu için tahmin kesin değildir: tek bir kişinin durumu değişse, örneğin 5. yıldaki olay bir sansür olsaydı, tahmin 0,4444’ten 0,6667’ye çıkardı: 5’teki çarpan \(1-0/3=1\) olur ve \(\widehat S(5)=\widehat S(3)=2/3\) kalır.
Medyan sağkalım süresi (median survival time), eğrinin 0,5’e ya da altına indiği ilk zamandır:
\[ \widehat t_{0{,}5}=\min\{t:\widehat S(t)\le0{,}5\}. \]
Tablodan adım adım: \(\widehat S(2)=0{,}8333\) ve \(\widehat S(3)=0{,}6667\) 0,5’in üstündedir; \(\widehat S(5)=0{,}4444\) ilk kez altına iner. Medyan bu yüzden 5’tir: bu küçük portföyde kişilerin yarısının olay yaşamış olacağı ilk süre 5 yıl olarak tahmin edilir.
Altı kişilik örnekte eğri hiçbir zaman tam 0,5 düzeyinde durmaz: eğri 3 zamanındaki 0,6667’den 5 zamanında doğrudan 0,4444’e iner. Eğri tam 0,5’te yatay bir basamak çizseydi yukarıdaki tanım basamağın başladığı zamanı verirdi; o durumda kullanılan kural survival paketiyle doğrulama bölümünde açıklanıyor.
Soru. Kaplan–Meier sağkalımı tahmin etti. Kümülatif hazard \(H(t)\)’yi, yani Sağkalım ve hazard bölümündeki hazardın \(0\)’dan \(t\)’ye birikimini veriden nasıl tahmin ederiz? Bu tahmine iki nedenle ihtiyaç vardır: \(S=e^{-H}\) ilişkisi üzerinden Kaplan–Meier’e ikinci bir sağkalım tahmini verir (Adım 4); iki tahmin yan yana konunca da risk kümesinin küçük olduğu zamanlarda birbirinden ayrıldıkları görülür (Adım 5).
Adım 1: birikimi parçalara ayırmak. \(H(t)=\int_0^t h(u)\,du\)’dur. Kısa bir aralıkta \(h(u)\,\Delta u\), o aralığın koşullu olay olasılığıdır (Sağkalım ve hazard bölümü). \(H(t)\) bu yüzden yaklaşık olarak, \(0\) ile \(t\) arasındaki kısa aralıkların koşullu olay olasılıklarının toplamıdır.
Sayıyla, En basit örnek: hazard sabitse alt bölümündeki \(\lambda=2\) ile \(H(1)=2\cdot1=2\)’dir. Bir yılı 100 eşit parçaya bölelim: \(\Delta t=0{,}01\). Sabit hazardda her parçanın koşullu olay olasılığı aynıdır ve oradaki tabloya göre 0,01980’dir; yüz parçanın toplamı \(100\cdot0{,}01980=1{,}980\) olur. Bin parçada her parçanın olasılığı 0,001998, toplam \(1.000\cdot0{,}001998=1{,}998\)’dir: parçalar kısaldıkça toplam \(H(1)=2\)’ye yaklaşır. Oradaki tablonun son sütunu tam bu toplamdır, çünkü bir yılda \(1/\Delta t\) parça vardır.
Adım 2: her parçayı tahmin etmek. Veride olay olmayan bir aralığın koşullu olay olasılığının tahmini 0’dır; bir olay zamanınınki \(d_j/n_j\)’dir (Risk kümesi bölümü). Sıfırlar düşünce geriye olay zamanlarının oranları kalır. Nelson–Aalen tahmini, \(t\)’ye kadarki bütün olay zamanlarının \(d_j/n_j\) oranlarının toplamıdır (\(\sum\) işareti “topla” demektir):
\[ \widehat H(t)=\sum_{t_j\le t}\frac{d_j}{n_j}. \]
\([0,t]\) aralığını \(\Delta u\) uzunluğunda kısa parçalara bölelim; \(u_k\) bu parçaların başlangıç noktaları olsun:
\[ \begin{aligned} H(t)&=\int_0^t h(u)\,du\\ &\approx\sum_k h(u_k)\,\Delta u\\ &\approx\sum_k q_k . \end{aligned} \]
Satırlar sırasıyla:
Her \(q_k\)’nın yerine tahmini konur (Risk kümesi bölümü); olay olmayan parçaların sıfırları düşer ve toplam \(\sum_{t_j\le t}d_j/n_j\) olur.
Adım 3: toplamak. Her satırda bir önceki değere o satırın oranı eklenir:
| \(t_j\) | \(d_j/n_j\) | Hesap | \(\widehat H(t_j)\) |
|---|---|---|---|
| 2 | 1/6 | \(0+1/6\) | 0,1667 |
| 3 | 1/5 | \(0{,}1667+0{,}2000\) | 0,3667 |
| 5 | 1/3 | \(0{,}3667+0{,}3333\) | 0,7000 |
| 8 | 1 | \(0{,}7000+1\) | 1,7000 |
\(\widehat H\) da yalnızca olay zamanlarında değişir: her olayda \(d_j/n_j\) kadar yukarı sıçrar, aralarda yatay kalır.
Adım 4: ikinci sağkalım tahmini. Sağkalım ve hazard bölümündeki \(S(t)=e^{-H(t)}\) ilişkisine \(\widehat H\) konunca ikinci bir sağkalım tahmini çıkar: \(\exp[-\widehat H(t)]\). Üstel işlev toplamı çarpıma çevirdiği için (\(e^{-(a+b)}=e^{-a}e^{-b}\)) bu tahmin de bir çarpımdır:
\[ \exp\big[-\widehat H(t)\big]=\prod_{t_j\le t}e^{-d_j/n_j}. \]
İki tahmin edici aynı olay zamanlarında aynı \(d_j/n_j\)’yi kullanır ve yalnızca çarpanda ayrılır: Kaplan–Meier \(1-d_j/n_j\) ile, bu tahmin \(e^{-d_j/n_j}\) ile çarpar. Aşağıdaki tabloda ikinci ve üçüncü sütun çarpanlardır, son iki sütun onların ardışık çarpımı; örneğin 3’te \(0{,}8465\cdot0{,}8187=0{,}6930\):
| \(t_j\) | \(1-d_j/n_j\) | \(e^{-d_j/n_j}\) | \(\widehat S_{KM}(t_j)\) | \(\exp[-\widehat H(t_j)]\) |
|---|---|---|---|---|
| 2 | 0,8333 | 0,8465 | 0,8333 | 0,8465 |
| 3 | 0,8000 | 0,8187 | 0,6667 | 0,6930 |
| 5 | 0,6667 | 0,7165 | 0,4444 | 0,4966 |
| 8 | 0 | 0,3679 | 0 | 0,1827 |
Adım 5: iki tahmin ne kadar ayrışır? İki tahmin aynı \(d_j/n_j\) oranlarını sağkalıma farklı yoldan çevirir. Kaplan–Meier, sağkalımın yalnızca gözlenen olay zamanlarında düştüğünü kabul eder ve her olay zamanında sağkalımı o anı atlatma olasılığı \(1-d_j/n_j\) ile çarpar. \(\exp(-\widehat H)\) ise Sağkalım ve hazard bölümünde zamanın sürekli olduğu, yani olayın herhangi bir anda gerçekleşebildiği varsayımıyla türetilen \(S=e^{-H}\) ilişkisini kullanır.
Küçük \(x=d_j/n_j\) için iki çarpan hemen hemen aynıdır: Hafta 3’teki \(e^{\lambda}=\sum\lambda^k/k!\) açılımında \(\lambda=-x\) yazılınca \(e^{-x}=1-x+x^2/2-\cdots\) olur ve aradaki fark yaklaşık \(x^2/2\)’dir. 2’de \(x=1/6\): çarpanlar 0,8333 ve 0,8465, farkları 0,013; \(x^2/2=1/72\) ise 0,014’tür.
Risk kümesi küçüldükçe \(x\) büyür ve fark da büyür. 8’de riskte tek kişi kalmıştır, \(x=1\): Kaplan–Meier’in çarpanı \(1-1/1=0\) olur ve tahmin sıfıra iner; Nelson–Aalen ise toplama 1 ekler ve \(e^{-1{,}70}=0{,}1827\) verir.
Adım 6: hangisi büyük? Kaplan–Meier her adımda \(\exp(-\widehat H)\)’nin altında ya da ona eşit kalır: her \(x\ge0\) için \(1-x\le e^{-x}\)’tir, yani Kaplan–Meier’in her çarpanı karşılığından büyük değildir ve çarpanları küçük olan çarpım da küçük kalır. Tabloda her satırda \(\widehat S_{KM}\) sağındaki sütundan büyük değildir. İkisini zorla eşit kabul etmeyin; hangisinin raporlandığını yazın.
Eşitsizlik. \(g(x)=e^{-x}-(1-x)\) farkına bakalım:
\[ \begin{aligned} g(0)&=e^{0}-1=0,\\ g'(x)&=-e^{-x}+1\ge0\quad(x\ge0). \end{aligned} \]
\(x\ge0\) iken \(e^{-x}\le1\) olduğu için türev negatif olamaz: \(g\) sıfırdan başlar ve azalmaz, yani \(g(x)\ge0\) ve \(1-x\le e^{-x}\)’tir.
Çarpım. Negatif olmayan çarpanları birer birer büyütmek çarpımı küçültmez: \(0\le a_1\le b_1\) ve \(0\le a_2\le b_2\) ise
\[ a_1a_2\le b_1a_2\le b_1b_2 . \]
Kaplan–Meier’in çarpanları negatif değildir (\(d_j\le n_j\)); adım her yeni çarpanda yinelenir.
Soru. Altı kişilik örnekte \(\widehat S(5)=0{,}4444\) yalnızca üç kişilik bir risk kümesine dayanır; tek bir kişinin durumu değişse tahmin belirgin biçimde oynar (Kaplan–Meier tahmini bölümü). Bu oynaklığı bir aralıkla göstermek için iki şey gerekir: tahminin varyansı ve aralığın hangi ölçekte kurulacağı. Sayfanın geri kalanı bu aralığı okur: laboratuvarın Görev B ve C’si ve dört alıştırma.
Adım 1: varyans. Kaplan–Meier tahmininin varyansını Greenwood formülü (Greenwood’s formula) verir:
\[ \widehat{\operatorname{Var}}\big[\widehat S(t)\big]=\widehat S(t)^2\,\sigma(t)^2, \qquad \sigma(t)^2=\sum_{t_j\le t}\frac{d_j}{n_j(n_j-d_j)}. \]
Formül iki parçadır ve hesap da iki aşamada yapılır:
Altı kişilik örnekte birinci aşama, yani terimler ve toplamları:
| \(t_j\) | \(n_j\) | \(d_j\) | \(n_j(n_j-d_j)\) | Terim | \(\sigma(t_j)^2\) |
|---|---|---|---|---|---|
| 2 | 6 | 1 | 30 | 1/30 | 1/30 |
| 3 | 5 | 1 | 20 | 1/20 | 1/12 |
| 5 | 3 | 1 | 6 | 1/6 | 1/4 |
| 8 | 1 | 1 | 0 | tanımsız | tanımsız |
Sütunlar soldan sağa şöyle doldurulur:
İkinci aşamada her satırın toplamı, o satırdaki tahminin karesiyle çarpılır:
| \(t_j\) | \(\widehat S(t_j)\) | \(\widehat S(t_j)^2\) | \(\sigma(t_j)^2\) | \(\widehat{\operatorname{Var}}\big[\widehat S(t_j)\big]\) |
|---|---|---|---|---|
| 2 | 5/6 | 25/36 | 1/30 | 5/216 = 0,0231 |
| 3 | 2/3 | 4/9 | 1/12 | 1/27 = 0,0370 |
| 5 | 4/9 | 16/81 | 1/4 | 4/81 = 0,0494 |
| 8 | 0 | 0 | tanımsız | tanımsız |
Örneğin 2’de \(\frac{25}{36}\cdot\frac{1}{30}\) \(=\frac{25}{1.080}\) \(=\frac{5}{216}\). İki sütunu yan yana okumak formülün işleyişini gösterir: risk kümesi küçüldükçe \(\sigma^2\) hızla büyür, 2’den 5’e \(1/30\)’dan \(1/4\)’e, 7,5 kat; tahmin de küçüldüğü için \(\widehat S^2\) bu büyümeyi kısmen dengeler ve varyans iki kattan biraz fazla artar, 0,0231’den 0,0494’e. 8’de tahmin 0’dır ve terim tanımsız olduğu için varyans da tanımsızdır.
Formül nereden gelir? Formül üç hesaptan çıkar ve bunların ikisi aynı yaklaşımı kullanır: delta yöntemi (delta method). Bir tahmin \(\widehat p\)’nin varyansı biliniyorsa, türevlenebilir bir \(g\) işlevi için
\[ \operatorname{Var}[g(\widehat p)]\approx g'(p)^{2}\operatorname{Var}(\widehat p) \]
olur. Burada \(p\), \(\widehat p\)’nin tahmin ettiği gerçek değerdir; bilinmediği için hesapta yerine \(\widehat p\) konur. \(g\), \(\widehat p\)’nin küçük oynamalarını o noktadaki eğimiyle büyütür ya da küçültür; varyans oynamaların karesiyle ölçüldüğü için eğim de karesiyle girer.
Üç hesap şunlardır; kapalı kutudaki türetme aynı başlıkları kullanır.
Sayıyla, 2 zamanında \(n_j=6\), \(d_j=1\) ve \(\widehat p_j=5/6\)’dır. Birinci hesapta payın varyansı \((5/6)(1/6)/6=5/216\), \(g'(5/6)^2=(6/5)^2=36/25\)’tir. Çarpımları Adım 1 tablosunun ilk terimidir (\(36/216=1/6\) ve \(5/25=1/5\)):
\[ \frac{5}{216}\cdot\frac{36}{25}=\frac{1}{6}\cdot\frac{1}{5}=\frac{1}{30}. \]
Bu zamanda toplam tek terimdir, \(\sigma(2)^2=1/30\). Üçüncü hesap bunu \(\widehat S(2)^2=25/36\) ile çarpar: \(\widehat{\operatorname{Var}}[\widehat S(2)]=\frac{25}{36}\cdot\frac{1}{30}\) \(=\frac{5}{216}\). Bu, birinci hesaptaki payın varyansıyla aynıdır, çünkü ilk olay zamanında Kaplan–Meier tahmini sıradan bir paydır: altı kişiden beşi o anı atlattı.
Delta yöntemi. \(g\), \(p\) çevresinde teğet doğrusuyla yaklaşık yazılır (birinci dereceden Taylor açılımı (Taylor expansion)), sonra iki yanın varyansı alınır:
\[ \begin{aligned} g(\widehat p)&\approx g(p)+g'(p)\,(\widehat p-p)\\ \operatorname{Var}[g(\widehat p)]&\approx g'(p)^{2}\operatorname{Var}(\widehat p) . \end{aligned} \]
İkinci satırda \(g(p)\) ve \(g'(p)\) sabittir: sabit eklemek varyansı değiştirmez, sabitle çarpmak varyansı sabitin karesiyle çarpar.
Bir olay zamanı. \(t_j\)’deki çarpan \(\widehat p_j=1-d_j/n_j\), riskteki \(n_j\) kişiden olayı atlatanların oranıdır. Atlatanların sayısı binom dağılır ve oranın varyansı \(p_j(1-p_j)/n_j\)’dir; karekökü, Hafta 2’de bir payın standart hatası olarak kullandığımız \(\sqrt{p(1-p)/n}\)’dir. Delta yönteminde \(g=\log\) ve \(g'(p)=1/p\)’dir:
\[ \begin{aligned} \operatorname{Var}(\log\widehat p_j) &\approx\frac{1}{p_j^{2}}\cdot\frac{p_j(1-p_j)}{n_j}\\ &=\frac{1-p_j}{n_j\,p_j}\\ &=\frac{d_j/n_j}{n_j\,p_j}\\ &=\frac{d_j/n_j}{n_j-d_j}\\ &=\frac{d_j}{n_j(n_j-d_j)} . \end{aligned} \]
Eşitlikler sırasıyla:
Bilinmeyen \(p_j\) yerine tahmini \(\widehat p_j\) konur; 2 zamanındaki sayısal örnek kutunun üstündeki metindedir.
Toplam. Kaplan–Meier tahmini bölümündeki çarpımın logaritması, çarpanların logaritmalarının toplamıdır. Risk kümeleri iç içedir (3’teki beş kişi 2’deki altı kişinin içindedir), ama her çarpan, önceki anları kimin atlattığı bilindiğinde yalnız o anın ölümlerine bağlıdır. Çarpanlar bu yüzden birbirinden bağımsız sayılır:
\[ \begin{aligned} \operatorname{Var}\big[\log\widehat S(t)\big] &=\operatorname{Var}\Big[\sum_{t_j\le t}\log\widehat p_j\Big]\\ &=\sum_{t_j\le t}\operatorname{Var}(\log\widehat p_j)\\ &\approx\sum_{t_j\le t}\frac{d_j}{n_j(n_j-d_j)}\\ &=\sigma(t)^2 . \end{aligned} \]
Eşitlikler sırasıyla:
Logaritmadan geri. \(\widehat S(t)=e^{\log\widehat S(t)}\)’dir. Delta yöntemi bu kez \(g=\exp\) ile uygulanır ve \(\exp\)’in türevi kendisidir:
\[ \begin{aligned} \operatorname{Var}\big[\widehat S(t)\big] &=\operatorname{Var}\big[e^{\log\widehat S(t)}\big]\\ &\approx\big(e^{\log S(t)}\big)^{2}\,\sigma(t)^2\\ &=S(t)^2\,\sigma(t)^2 . \end{aligned} \]
Eşitlikler sırasıyla:
Bilinmeyen \(S(t)\) yerine \(\widehat S(t)\) konunca Greenwood formülü çıkar; karekökü, tahminin standart hatası \(\widehat S(t)\,\sigma(t)\)’dir.
Adım 2: standart hata. Standart hata varyansın kareköküdür. Adım 1’in ikinci tablosundan \(\sqrt{5/216}\), \(\sqrt{1/27}\) ve \(\sqrt{4/81}\) alınabilir; aynı sayılar iki kökün çarpımı olarak daha kolay hesaplanır, \(\widehat S(t)\,\sigma(t)\). \(\sigma(t_j)\), birinci tablodaki \(\sigma(t_j)^2\)’nin kareköküdür: \(\sqrt{1/30}=0{,}18257\), \(\sqrt{1/12}=0{,}28868\) ve \(\sqrt{1/4}=0{,}5\). Tahminin standart hatası ilk üç olay zamanında:
\[ \begin{aligned} \widehat S(2)\,\sigma(2)&=\tfrac{5}{6}\cdot0{,}18257=0{,}1521,\\ \widehat S(3)\,\sigma(3)&=\tfrac{2}{3}\cdot0{,}28868=0{,}1925,\\ \widehat S(5)\,\sigma(5)&=\tfrac{4}{9}\cdot0{,}5=\tfrac{2}{9}=0{,}2222. \end{aligned} \]
8 zamanındaki terim, Adım 1’de gördüğümüz gibi tanımsızdır: tahmin orada 0’dır ve bir standart hatası yoktur.
Adım 3: aralığın ölçeği. Varyans aralığın genişliğini belirler; aralığın hangi ölçekte kurulacağı ayrı bir seçimdir. Kural her ölçekte aynıdır: aralık seçilen ölçekte “tahmin ± \(z\) × standart hata” olarak kurulur, sonra sınırlar sağkalım ölçeğine geri çevrilir. Burada \(z=1{,}96\)’dır: Hafta 3’teki gibi, standart normal bir değişkenin mutlak değeri 1,96’yı yalnız %5 olasılıkla aşar ve aralık bu yüzden %95’liktir.
Neden ölçek değiştirilir? \(\widehat S\) bir olasılıktır ve 0 ile 1 arasında kalmalıdır; “tahmin ± \(z\) × standart hata” ise bu sınırları tanımaz. Düz ölçekte alt sınır \(\widehat S\,(1-z\sigma)\)’dır ve \(z\sigma>1\) olunca, yani \(\sigma\) yaklaşık \(1/1{,}96=0{,}51\)’i aşınca 0’ın altına iner. 5 zamanında \(\sigma=0{,}5\) olduğu için alt sınır 0’ın hemen üstünde kalır: Adım 4’te 0,0089 çıkacak. Log ve log-log ölçekleri aralığı başka bir ölçekte kurup geri çevirerek bu sorunu azaltır. Üç ölçek şunlardır:
Üç formülde de standart hata seçilen ölçeğinkidir: düz ölçekte Greenwood’un \(\widehat S\,\sigma\)’sı, log ölçeğinde \(\sigma\); log-log ölçeğinde delta yöntemi onu \(\sigma/\lvert\log\widehat S\rvert\) yapar ve \(c\) bunun \(z\) katıdır. R’de ölçeği conf.type argümanı seçer: "plain" (düz), "log" ve "log-log" (Güven aralığını kodla kurmak alt bölümü).
Log ölçeği. \(\log\widehat S\)’nin standart hatası \(\sigma\)’dır. Aralık bu ölçekte kurulur ve iki yanın üssü alınır:
\[ \begin{aligned} \log S&=\log\widehat S\pm z\,\sigma\\ S&=e^{\log\widehat S\pm z\,\sigma}\\ &=e^{\log\widehat S}\,e^{\pm z\,\sigma}\\ &=\widehat S\,e^{\pm z\,\sigma} . \end{aligned} \]
Satırlar sırasıyla:
Log-log ölçeği. \(y=\log\widehat S\) dersek ölçek \(g(y)=\log(-y)\)’dir. Türevi zincir kuralıyla alınır: dıştaki \(\log\)’un türevi \(1/(-y)\), içteki \(-y\)’nin türevi \(-1\)’dir:
\[ g'(y)=\frac{1}{-y}\cdot(-1)=\frac{1}{y} . \]
Delta yöntemi \(\operatorname{Var}(y)=\sigma^2\)’yi \(g'(y)^2\) ile çarpar:
\[ \begin{aligned} \operatorname{Var}\big[\log(-\log\widehat S)\big] &\approx g'(\log S)^{2}\,\sigma^{2}\\ &=\frac{\sigma^{2}}{(\log S)^{2}} . \end{aligned} \]
Karekökü \(\sigma/\lvert\log S\rvert\)’dir; \(\log S\) negatif olduğu için karekök mutlak değeri verir. \(S\) yerine \(\widehat S\) konur; aralık \(\log(-\log\widehat S)\pm c\) olur ve \(c=z\,\sigma/\lvert\log\widehat S\rvert\)’dir. Sınırlar iki logaritma sırayla geri alınarak bulunur:
\[ \begin{aligned} \log(-\log S)&=\log(-\log\widehat S)\pm c\\ -\log S&=e^{\log(-\log\widehat S)\pm c}\\ &=(-\log\widehat S)\,e^{\pm c}\\ \log S&=\log\widehat S\cdot e^{\pm c}\\ S&=e^{\log\widehat S\cdot e^{\pm c}}\\ &=\widehat S^{\,e^{\pm c}} . \end{aligned} \]
Satırlar sırasıyla:
Adım 4: beşinci yılda üç aralık. Beşinci yılda \(\widehat S(5)=4/9\) ve \(\sigma(5)=0{,}5\)’tir. Düz ölçekte:
\[ \begin{aligned} &\frac{4}{9}\pm1{,}96\cdot\frac{4}{9}\cdot0{,}5\\ &=\frac{4}{9}\pm1{,}96\cdot\frac{2}{9}\\ &=\frac{4}{9}\pm\frac{3{,}92}{9}\\ &=\frac{4\pm3{,}92}{9}\\ &\Rightarrow\Big(\frac{0{,}08}{9};\ \frac{7{,}92}{9}\Big)\\ &=(0{,}0089;\ 0{,}8800). \end{aligned} \]
Log ölçeğinde:
\[ \begin{aligned} \tfrac{4}{9}\,e^{\pm1{,}96\cdot0{,}5}&=\tfrac{4}{9}\,e^{\pm0{,}98},\\ \text{alt: }\tfrac{4}{9}\,e^{-0{,}98}&=\tfrac{4}{9}\cdot0{,}3753=0{,}1668,\\ \text{üst: }\tfrac{4}{9}\,e^{0{,}98}&=\tfrac{4}{9}\cdot2{,}6645=1{,}1842. \end{aligned} \]
Üst sınır 1’i aştığı için 1’de kesilir. Log-log ölçeğinde \(\lvert\log(4/9)\rvert=0{,}8109\) ve \(c=1{,}96\cdot0{,}5/0{,}8109=1{,}2085\)’tir:
\[ \left(\frac{4}{9}\right)^{e^{1{,}2085}}=\left(\frac{4}{9}\right)^{3{,}3485}=0{,}0662, \qquad \left(\frac{4}{9}\right)^{e^{-1{,}2085}}=\left(\frac{4}{9}\right)^{0{,}2986}=0{,}7849. \]
Aynı tahmin ve aynı varyansla üç ölçek üç ayrı aralık verir. Düz aralık simetriktir ve alt sınırı 0,0089 ile 0’a çok yakındır; log aralığının üst sınırı 1’i aşar ve 1’de kesilir; log-log aralığı kesilmeye gerek duymaz. Genişlikler düz ölçekte \(0{,}8800-0{,}0089=0{,}8711\), log ölçeğinde \(1-0{,}1668=0{,}8332\), log-log ölçeğinde \(0{,}7849-0{,}0662=0{,}7187\)’dir; bu zamanda en dar aralık log-log’unkidir.
Sigortacılık diliyle: altı kişilik bir portföyden çıkan %44,4’lük tahminin en dar aralığı bile 0,07 ile 0,78 arasını kapsar; bu büyüklükte bir risk kümesi tek başına bir fiyatlama kararı taşıyamaz.
Adım 5: medyanın güven aralığı. Medyan, eğrinin 0,5’e ya da altına indiği ilk zamandır (Kaplan–Meier tahmini bölümü). Medyanın aralığı için aralıkları tek bir zamanda değil, bütün zamanlarda birlikte okuruz. Aralık her \(t\) için ayrı kurulur; bütün zamanlardaki alt sınırlar birleşince alt sınır eğrisi, üst sınırlar birleşince üst sınır eğrisi çıkar. İki eğrinin arasındaki bölgeye güven bandı (confidence band) denir.
Medyanın aralığı, medyanın tanımını bu iki eğriye uygular: aralığın alt sınırı, alt sınır eğrisinin 0,5’e ya da altına ilk indiği zamandır; üst sınırı da üst sınır eğrisinin 0,5’e ya da altına ilk indiği zamandır. Gerekçesi şudur:
Burada log ölçeğindeki bandı kullanıyoruz; sayfanın kodla kurduğu fit de bu ölçektedir. Ölçek medyanın aralığını da değiştirir: log-log ölçeğinde alt sınır eğrisi 2 zamanında zaten 0,2731’dir ve o ölçekte medyanın alt sınırı 2 çıkar.
Log ölçeğinde alt sınır \(\widehat S\,e^{-z\sigma}\)’dır. \(\sigma\), Adım 2’deki 0,18257 ve 0,28868’dir; çarpan \(z=1{,}96\):
| \(t_j\) | \(\widehat S\) | \(\sigma\) | \(1{,}96\,\sigma\) | \(e^{-1{,}96\,\sigma}\) | Alt sınır |
|---|---|---|---|---|---|
| 2 | 5/6 | 0,18257 | 0,3578 | 0,6992 | 0,5827 |
| 3 | 2/3 | 0,28868 | 0,5658 | 0,5679 | 0,3786 |
2 zamanında alt sınır 0,5’in üstünde, 3 zamanında altındadır: medyanın alt sınırı 3’tür.
Üst sınır eğrisi ise hiçbir zamanda 0,5’in altına inmez. Log ölçeğinde üst sınır \(\widehat S\,e^{z\sigma}\)’dır: 2 zamanında \(\tfrac{5}{6}\,e^{0{,}3578}\) \(=\tfrac{5}{6}\cdot1{,}4302\) \(=1{,}1918\), 3 zamanında \(\tfrac{2}{3}\,e^{0{,}5658}\) \(=\tfrac{2}{3}\cdot1{,}7609\) \(=1{,}1739\)’dur. İkisi de 1’i aşar ve 1’de kesilir. 5 zamanında da üst sınır 1’i aşar (Adım 4’teki 1,1842); 8’de ise tanımsızdır. Medyanın üst sınırı bu yüzden tanımsız kalır.
Risk kümesi, Kaplan–Meier tahmini ve Nelson–Aalen tahmini bölümlerinde elle kurduğumuz tabloları şimdi açık R koduyla üretelim: önce risk tablosu, sonra iki tahmin, en sonda Kaplan–Meier eğrisi. Bu hafta kullanılan paketleri en başta yüklüyoruz:
library(readr)
library(dplyr)
library(ggplot2)
library(scales)Önce altı kişilik veriyi bir veri çerçevesine yazalım:
kucuk <- data.frame(
  time = c(2, 3, 3, 5, 6, 8),
  event = c(1, 0, 1, 1, 0, 1)
)

kucuk
#> time event
#> 1 2 1
#> 2 3 0
#> 3 3 1
#> 4 5 1
#> 5 6 0
#> 6 8 1Çıktıda 6 satır ve time ile event olmak üzere 2 sütun görmelisiniz; event sütununda dört 1 (olay) ve iki 0 (sansür) bulunur. Sütun adları bilerek haftanın veri dosyası canlifins_sample.csv’deki sütunlarla aynı seçildi: aşağıdaki paket çağrıları iki veride aynı biçimde yazılır.
Şimdi risk tablosunu iki adımda kuralım. Önce olayın gözlendiği ayrı zamanları sıralayalım; tablonun satırları bunlardan doğar:
olay_zamanlari <- sort(unique(kucuk$time[kucuk$event == 1]))

olay_zamanlari
#> [1] 2 3 5 8Çıktıdaki değerlerin Risk kümesi bölümündeki risk tablosunun \(t_j\) sütunuyla aynı olması gerekir. Çağrının üç parçası birer iş görür:
kucuk$time[kucuk$event == 1] — yalnız olay satırlarının sürelerini alır. event == 0 olan süreler bu vektöre girmez: sansür bir olay zamanı üretmez, yalnızca sonraki paydaları küçültür.unique() — aynı zamana iki olay düşerse tabloya iki satır değil, \(d_j=2\) olan tek satır girer. İki satır açılsaydı o zamanın çarpanı eğriye iki kez girerdi.sort() — aşağıdaki cumprod() çarpanları satır sırasıyla biriktirir; zamanlar sırasız gelirse bir satırın değeri o zamana kadarki olaylardan oluşmaz. Sıra 5, 2, 3, 8 olsaydı 5 zamanının satırı 4/9 yerine yalnız kendi çarpanını, 2/3’ü taşırdı. Bu altı kişide olay zamanları zaten farklı ve sıralıdır, bu yüzden unique() ile sort() çıktıyı değiştirmez; başka bir veride ikisi de gerekir.
Şimdi her olay zamanı için riskteki kişi sayısını (\(n_j\)) ve olay sayısını (\(d_j\)) hesaplayalım; bu değerlerin Risk kümesi bölümündeki risk tablosunun \(n_j\) ve \(d_j\) sütunlarıyla aynı çıkması gerekir:
risk_tablosu <- data.frame(
  time = olay_zamanlari,
  n_risk = vapply(
    olay_zamanlari,
    function(t) sum(kucuk$time >= t),
    numeric(1)
  ),
  n_event = vapply(
    olay_zamanlari,
    function(t) sum(kucuk$time == t & kucuk$event == 1),
    numeric(1)
  )
)

risk_tablosu
#> time n_risk n_event
#> 1 2 6 1
#> 2 3 5 1
#> 3 5 3 1
#> 4 8 1 1Bu blokta derste ilk kez geçen iki çağrı var:
vapply(olay_zamanlari, f, ...) — birinci argümanın her öğesini sırayla f’ye verir ve dönen değerleri tek bir vektörde toplar; her olay zamanı için risk kümesinin büyüklüğü böyle ayrı ayrı sayılır.numeric(1) — üçüncü argüman, her çağrının ne döndüreceğini önceden bildirir: tek bir sayı. vapply() her sonucu bu kalıpla karşılaştırır; uymayan ilk öğede durur ve hangisi olduğunu söyler: values must be length 1, but FUN(X[[2]]) result is length 2. Aynı işi yapan sapply() bu karşılaştırmayı yapmaz. Öğelerden biri iki sayı döndürürse sapply() bir liste döndürür ve data.frame() bu listeyi hata vermeden ayrı sütunlara açar: bu altı kişide tablo yine dört satırlı çıkar, ama n_risk yerine adı n_risk. ile başlayan dört sütun taşır ve iki sayılık öğe satırlara yinelenerek yazılır. Ne hata ne uyarı çıkar. İki sayma koşulu Risk kümesi bölümündeki tanımların kodudur:
kucuk$time >= t — \(n_j\), süresi \(t_j\)’den küçük olmayanların sayısıdır; >=, tam \(t_j\)’de olay yaşayanı da orada sansürleneni de paydaya alır. > yazılırsa hata çıkmaz, ama 2 zamanında payda 6 yerine 5 olur ve ilk çarpan 5/6 yerine 4/5 çıkar. & kucuk$event == 1 — \(d_j\)’yi olay satırlarıyla sınırlar. Yazılmazsa: 3 zamanında sansürlenen kişi de olay sayılır; o satırın \(d_j\)’si 1 yerine 2 olur ve \(\widehat S(3)\) 0,6667 yerine 0,5 çıkar. Son olarak iki tahmini risk tablosuna üç sütun olarak işleyelim: km_manual Kaplan–Meier tahminini (\(\widehat S_{KM}(t_j)\)), na_manual Nelson–Aalen kümülatif hazard tahminini (\(\widehat H(t_j)\)), exp_na ise ondan gelen ikinci sağkalım tahminini (\(\exp[-\widehat H(t_j)]\)) taşır.
risk_tablosu$km_manual <- cumprod(1 - risk_tablosu$n_event / risk_tablosu$n_risk)
risk_tablosu$na_manual <- cumsum(risk_tablosu$n_event / risk_tablosu$n_risk)
risk_tablosu$exp_na <- exp(-risk_tablosu$na_manual)

risk_tablosu
#> time n_risk n_event km_manual na_manual exp_na
#> 1 2 6 1 0.8333333 0.1666667 0.8464817
#> 2 3 5 1 0.6666667 0.3666667 0.6930406
#> 3 5 3 1 0.4444444 0.7000000 0.4965853
#> 4 8 1 1 0.0000000 1.7000000 0.1826835Değerler Kaplan–Meier tahmini ve Nelson–Aalen tahmini bölümlerindeki elle hesapla aynı çıkmalıdır: km_manual sütununda 0,8333; 0,6667; 0,4444 ve 0, na_manual sütununda 0,1667; 0,3667; 0,7000 ve 1,7000, exp_na sütununda ise 0,8465; 0,6930; 0,4966 ve 0,1827.
Bu blokta derste ilk kez geçen iki işlev var:
cumprod() — bir sayı vektörü alır ve aynı uzunlukta bir vektör döndürür: çıktının \(j\)’inci öğesi girdinin ilk \(j\) öğesinin çarpımıdır. Kaplan–Meier’in ardışık çarpımını tek satırda veren şey budur; tek bir sayı döndüren prod() ile karıştırmayın, o yalnızca çarpımın son değerini verir ve çizilecek bir eğri bırakmaz.cumsum() — aynı işi çarpma yerine toplama ile yapar: \(j\)’inci öğe ilk \(j\) öğenin toplamıdır. Nelson–Aalen’in kümülatif hazard tahminini veren budur. sum() ile arasındaki fark prod() ile cumprod() arasındakiyle aynıdır: sum() tek bir sayı, cumsum() her satır için bir değer verir.exp_na sütununu kuran exp(), na_manual’ın her satırını ayrı ayrı dönüştürür; sütun Nelson–Aalen tahmini bölümünün 4. adımındaki ikinci sağkalım tahminidir.
Bu kod genel amaçlı bir sağkalım paketinin yerini almaz. Küçük risk tablosunun mantığını görünür kılar.
Şimdi aynı sayıları basamak eğrisine dönüştürelim. Çizimden önce grafiğin okuduğu iki küçük çerçeveyi ayrı ayrı kurup ekrana getiriyoruz. İlki eğrinin kendisidir: risk tablosunun önüne \(t=0\) satırını, \(\widehat S(0)=1\)’i ekliyoruz, çünkü kimse olay yaşamadan önce sağkalım 1’dir. Bu satır olmasa eğri 2’de 0,8333’ten başlar: 2’deki düşüş de 0 ile 2 arasındaki yatay bölüm de çizilmez.
km_basamak <- data.frame(
  zaman = c(0, risk_tablosu$time),
  sagkalim = c(1, risk_tablosu$km_manual)
)

km_basamak
#> zaman sagkalim
#> 1 0 1.0000000
#> 2 2 0.8333333
#> 3 3 0.6666667
#> 4 5 0.4444444
#> 5 8 0.0000000zaman sütunu basamağın kırıldığı yeri, sagkalim sütunu ise o kırılmadan sonraki düzeyi verir; ilk satır hiçbir olay gerçekleşmeden önceki durumdur.
Sansür işaretlerinin yatay konumu, olayı gözlenmeyen kişilerin süreleridir:
sansur_zamani <- kucuk$time[kucuk$event == 0]

sansur_zamani
#> [1] 3 6İşaretlerin dikey konumu ise eğrinin o andaki yüksekliğidir: her sansür zamanı için basamak tablosunda o zamanı geçmeyen son satırın sagkalim değerini okuyoruz.
sansur_isareti <- data.frame(
  zaman = sansur_zamani,
  sagkalim = vapply(
    sansur_zamani,
    function(t) km_basamak$sagkalim[max(which(km_basamak$zaman <= t))],
    numeric(1)
  )
)

sansur_isareti
#> zaman sagkalim
#> 1 3 0.6666667
#> 2 6 0.4444444Çıktıda iki satır görmelisiniz: 3’teki sansür 0,6667, 6’daki sansür 0,4444 yüksekliğinde durur.
which() mantıksal bir vektörü konum numaralarına çevirir: TRUE olan öğelerin kaçıncı sırada olduğunu döndürür, FALSE olanları atar. Böylece max(which(km_basamak$zaman <= t)) sansür zamanını geçmeyen son satırın numarası olur. Yazılmazsa: max() doğrudan mantıksal vektörün kendisi üzerinde çalışır, TRUE sayı olarak 1 sayıldığı için sonuç her zaman 1 çıkar; iki sansür işareti de km_basamak’ın ilk satırını okur ve eğrinin başlangıç yüksekliğinde, 1 düzeyinde çizilir.
Karşılaştırmanın <= olması bir seçimdir: 3 zamanında kişi 3 ölür, kişi 2 sansürlenir. <= bu yüzden 3’teki işareti zaman = 3 satırından, yani ölümden sonraki düzeyden okur: 0,6667. Bu, Risk kümesi bölümündeki kuraldır: tam \(t_j\)’de sansürlenen kişi o anın ölümünde risk altındadır, yani sansür ölümden hemen sonra sayılır. < yazılırsa hata çıkmaz, ama 3’teki işaret 2’nin satırından, 0,8333 yüksekliğinden okunur ve ölümden önceki düzeyde çizilir.
Son olarak iki çerçeveyi tek grafikte birleştiriyoruz:
ggplot(
  km_basamak,
  aes(x = zaman, y = sagkalim)
) +
  geom_step(
    aes(colour = "Kaplan–Meier tahmini"),
    linewidth = 1.1
  ) +
  geom_point(
    data = sansur_isareti,
    aes(colour = "Sansürlenen gözlem"),
    shape = 3,
    size = 3.5,
    stroke = 1.2
  ) +
  scale_colour_manual(
    name = NULL,
    values = c(
      "Kaplan–Meier tahmini" = "#1F4E79",
      "Sansürlenen gözlem" = "#F28E2B"
    )
  ) +
  scale_x_continuous(breaks = 0:8) +
  scale_y_continuous(
    limits = c(0, 1),
    breaks = seq(0, 1, 0.25),
    labels = label_number(
      accuracy = 0.01,
      big.mark = ".",
      decimal.mark = ","
    )
  ) +
  labs(
    x = "Süre (yıl)",
    y = "Sağkalım tahmini (olasılık)"
  ) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "bottom")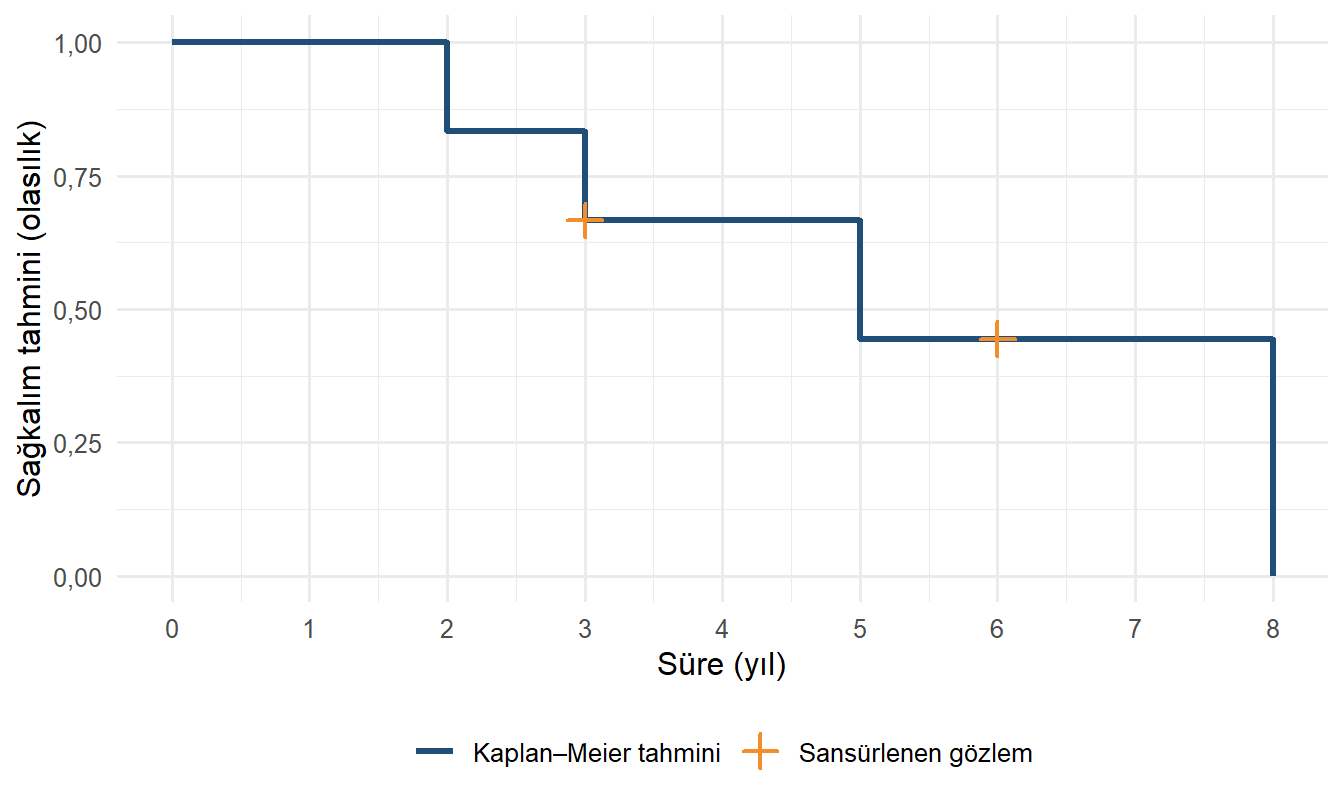
geom_step() noktaları düz bir doğruyla değil basamakla birleştirir: iki nokta arasında önce yatay gider, sonra dikey iner (varsayılan direction = "hv"). Yazılmazsa: yerine geom_line() kullanıldığında eğri olay zamanları arasında eğik bir çizgiyle iner ve sağkalımın iki olay arasında yavaş yavaş azaldığını söyler; hata da uyarı da çıkmaz. Oysa Kaplan–Meier tahmini yalnızca olay anlarında düşer, aralarında sabit kalır.
Bu grafik iki aşamada kurulur ve ikinci aşama haftanın tek cümlelik özetini gözle görülür hâle getirir: sansürlü gözlem olay değildir.
Aşama 1 — yalnızca basamak eğrisi. Sağkalım tahmini tek başına çizilir:
ggplot(
  km_basamak,
  aes(x = zaman, y = sagkalim)
) +
  geom_step(
    aes(colour = "Kaplan–Meier tahmini"),
    linewidth = 1.1
  ) +
  scale_colour_manual(
    name = NULL,
    values = c(
      "Kaplan–Meier tahmini" = "#1F4E79",
      "Sansürlenen gözlem" = "#F28E2B"
    )
  ) +
  scale_x_continuous(breaks = 0:8) +
  scale_y_continuous(
    limits = c(0, 1),
    breaks = seq(0, 1, 0.25),
    labels = label_number(
      accuracy = 0.01,
      big.mark = ".",
      decimal.mark = ","
    )
  ) +
  labs(
    x = "Süre (yıl)",
    y = "Sağkalım tahmini (olasılık)"
  ) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "bottom")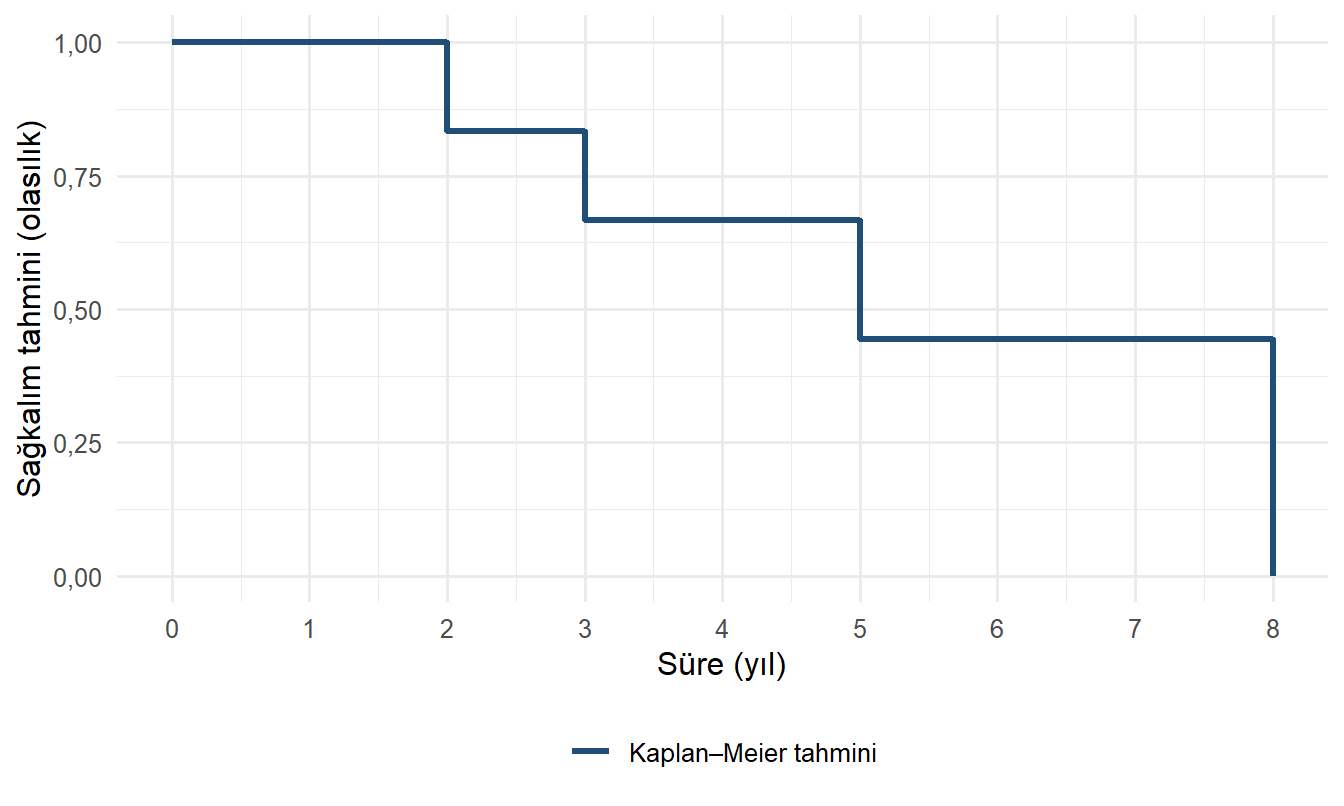
Bu aşamanın argümanları:
linewidth = 1.1 — basamağın kalınlığı; sonraki aşamada eklenecek işaretlerin altında da seçilebilecek kadar.colour doğrudan bir metne bağlanmıştır (aes(colour = "Kaplan–Meier tahmini")). Bu, sabit bir renk atamanın değil, göstergede bir satır oluşturmanın yoludur.breaks = 0:8 — yatay eksende her tam yıl işaretlenir, çünkü olay zamanlarının hepsi tam sayıdır.limits = c(0, 1) — düşey eksen bir olasılık eksenidir ve verinin ulaştığı en küçük değere göre değil, tanım gereği 0 ile 1 arasındadır. Bu grafikte görünür bir etkisi yoktur: eğri zaten 1’den 0’a indiği için eksen, limits verilmese de aynı aralığı alır. Etkisi eğrinin 0’a inmediği verilerde görülür: orada eksen verinin en küçük değerinden başlar ve düşüş olduğundan dik görünür.labels = label_number(accuracy = 0.01, ...) olasılıkları iki ondalıkla ve Türkçe biçimde yazar; base_size = 12 bütün yazıları birden, legend.position = "bottom" göstergeyi alta alır.Aşama 2 — sansür işaretleri. Tek eklenen katman geom_point()’tir ve başka bir tabloyu okur. Bu aşama yukarıdaki asıl bloğun tamamıdır.
ggplot(
  km_basamak,
  aes(x = zaman, y = sagkalim)
) +
  geom_step(
    aes(colour = "Kaplan–Meier tahmini"),
    linewidth = 1.1
  ) +
  geom_point(
    data = sansur_isareti,
    aes(colour = "Sansürlenen gözlem"),
    shape = 3,
    size = 3.5,
    stroke = 1.2
  ) +
  scale_colour_manual(
    name = NULL,
    values = c(
      "Kaplan–Meier tahmini" = "#1F4E79",
      "Sansürlenen gözlem" = "#F28E2B"
    )
  ) +
  scale_x_continuous(breaks = 0:8) +
  scale_y_continuous(
    limits = c(0, 1),
    breaks = seq(0, 1, 0.25),
    labels = label_number(
      accuracy = 0.01,
      big.mark = ".",
      decimal.mark = ","
    )
  ) +
  labs(
    x = "Süre (yıl)",
    y = "Sağkalım tahmini (olasılık)"
  ) +
  theme_minimal(base_size = 12) +
  theme(legend.position = "bottom")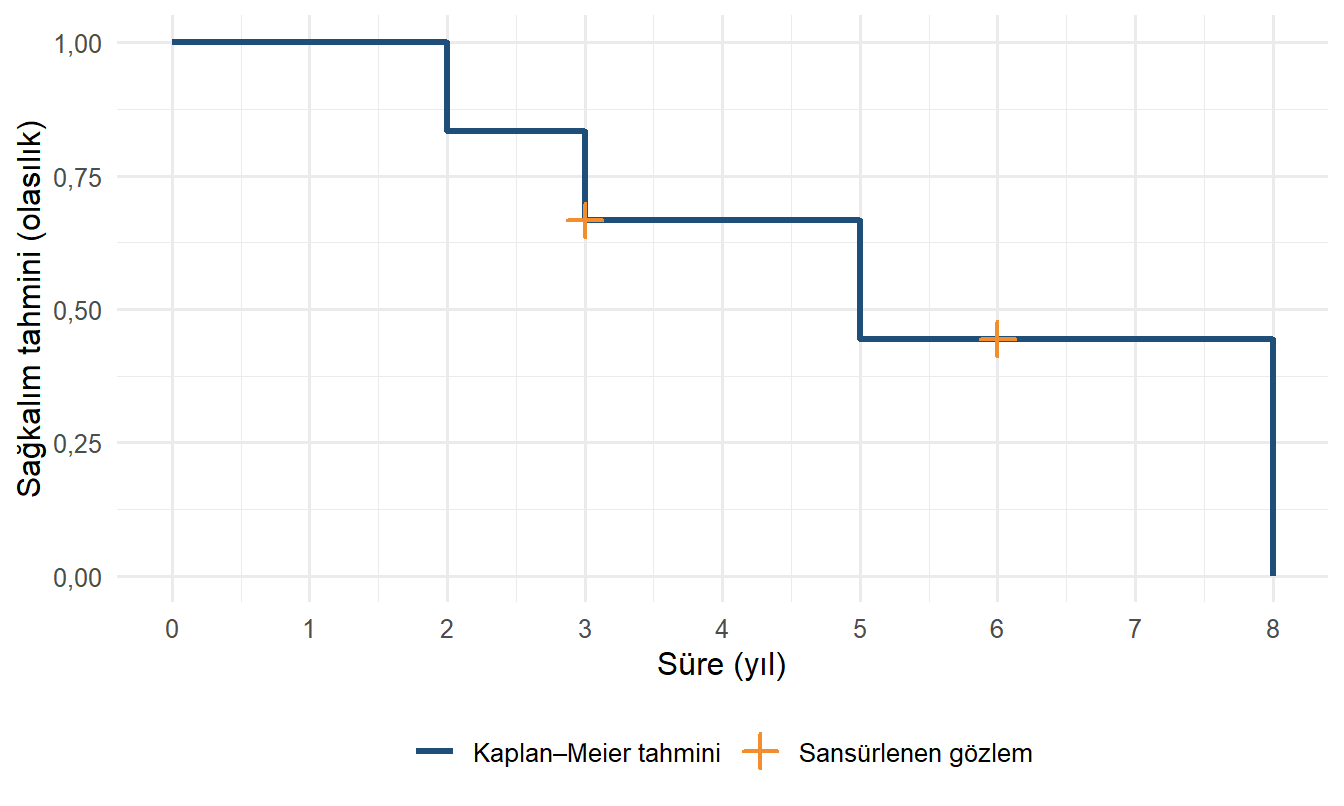
data = sansur_isareti — bu katman eğrinin tablosunu değil, sansür zamanlarının tablosunu okur. İki tablonun aynı eksende buluşması, “sansür nerede oldu?” sorusunun yanıtıdır.shape = 3 artı işareti, size = 3.5 ve stroke = 1.2 ise işaretin büyüklüğü ile kalem kalınlığıdır — eğrinin üzerinde görünecek, ama basamakları örtmeyecek kadar.Asıl kazanç iki aşamayı üst üste okumaktadır: işaretler eklendiğinde eğrinin yüksekliği hiçbir yerde değişmez. Sansür, riskteki kişi sayısını küçültür ve böylece sonraki basamakları derinleştirir; kendi anında eğriyi düşürmez. Bunu bir cümle olarak okumak ile iki grafiği yan yana görmek aynı şey değildir.
survival paketiyle doğrulamaAynı tahminleri şimdi survival paketiyle üretip elle kurduğumuz sütunlarla karşılaştırıyoruz. Paketin girdisi, süreyi ve olay göstergesini birleştiren bir sağkalım yanıtıdır; onu survival::Surv() kurar. Altı kişide nasıl göründüğüne bakalım.
survival::Surv(kucuk$time, kucuk$event)#> [1] 2 3+ 3 5 6+ 8Sansürlü süreler + işaretiyle yazılır: 3+, olayın 3’ten sonra olduğunu, yani yalnız \(T>3\) bilindiğini söyler (Sağdan sansürleme bölümü). Surv() ikinci argümanı 1 olay, 0 sansür diye okur. Kodlama ters çevrilirse hata çıkmaz: + işaretleri olaylara geçer ve paket olayların değil sansürlerin eğrisini tahmin eder.
Şimdi paketin kendi uyum nesnesini kuralım.
fit <- survival::survfit(
  survival::Surv(time, event) ~ 1,
  data = kucuk
)

fit
#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = kucuk)
#>
#> n events median 0.95LCL 0.95UCL
#> [1,] 6 4 5 3 NAFormülün sol yanı aynı Surv() çağrısıdır; data = kucuk verildiği için sütunlar adlarıyla yazılır. survfit(... ~ 1) tüm örneklem için tek eğri üretir. survfit() varsayılan olarak sağkalımı Kaplan–Meier ile (stype = 1), kümülatif hazardı Nelson–Aalen ile (ctype = 1) tahmin eder; aşağıdaki karşılaştırma bu yüzden elle kurduğumuz iki sütunla yapılabilir.
Yazdırıldığında fit tek bir özet satırı gösterir; çıktıda şunları arayın:
n) ve olay sayısı (events): 6 ve 4;median) ile onun %95 güven aralığı (0.95LCL, 0.95UCL): 5, 3 ve NA. Medyanın tanımına survival bir ayrıntı ekler. Altı kişide eğri hiçbir basamakta tam 0,5 düzeyinde durmaz; median bu yüzden doğrudan tanımdan gelir ve 5’tir. Eğri tam 0,5 düzeyinde yatay bir basamak çizdiğinde ise paket medyan olarak basamağın başladığı zamanı değil, orta noktasını verir. Örneğin 70, 78, 80 ve 85’te dört olay varsa eğri 78’de tam 0,5’e iner ve 80’e kadar orada kalır; paketin medyanı 78 değil, \((78+80)/2=79\)’dur. Dört sayının sıradan medyanı da 79’dur: bu kural sayesinde sansürsüz bir örneklemde eğrinin medyanı sıradan örneklem medyanıyla aynı çıkar. Laboratuvarın Görev E’si bunu gerçek veride görecek.
Medyanın güven aralığı (0.95LCL ve 0.95UCL), Güven aralığı bölümünün 5. adımındaki kuraldan gelir. Kuralın okuduğu alt ve üst sınır eğrileri aşağıdaki tablonun lower ve upper sütunlarıdır; iki sınır o tablonun altında okunuyor.
Zaman başına sağkalım ve kümülatif hazard tahminleri bu özette yer almaz; onlar nesnenin surv ve cumhaz bileşenlerinde durur ve aşağıda tam olarak oradan okunur. Nesnenin zaman başına bileşenlerini tek bir tabloda görelim.
fit_bilesenleri <- data.frame(
  time = fit$time, n.risk = fit$n.risk, n.event = fit$n.event,
  n.censor = fit$n.censor, surv = fit$surv, cumhaz = fit$cumhaz,
  std.err = fit$std.err, lower = fit$lower, upper = fit$upper
)

round(fit_bilesenleri, 4)
#> time n.risk n.event n.censor surv cumhaz std.err lower upper
#> 1 2 6 1 0 0.8333 0.1667 0.1826 0.5827 1
#> 2 3 5 1 1 0.6667 0.3667 0.2887 0.3786 1
#> 3 5 3 1 0 0.4444 0.7000 0.5000 0.1668 1
#> 4 6 2 0 1 0.4444 0.7000 0.5000 0.1668 1
#> 5 8 1 1 0 0.0000 1.7000 Inf NA NAHer satır verideki ayrı bir süredir, olay ya da sansür:
time — 2, 3, 5, 6 ve 8. 3 zamanı hem bir olayı hem bir sansürü taşıdığı hâlde tek satırdır.n.risk ve n.event — o zamandan hemen önce riskteki kişi ve o zamandaki olay sayısı; olay satırlarında risk tablosunun \(n_j\) ve \(d_j\)’si.n.censor — o zamanda sansürlenen kişi sayısı.surv ve cumhaz — \(\widehat S(t)\) ve \(\widehat H(t)\). 6’daki sansür satırında ikisi de 5’tekiyle aynıdır: sansür eğriyi düşürmez.std.err — \(\widehat S(t)\)’nin değil, \(\log\widehat S(t)\)’nin standart hatası; Güven aralığı bölümünde \(\sigma(t)\) adıyla kuruldu.lower ve upper — %95 güven aralığının alt ve üst sınırı, varsayılan log ölçeğinde; zaman boyunca alt ve üst sınır eğrisini verirler (Güven aralığı bölümü). Medyanın güven aralığı bu iki sütundan okunur. lower 2’de 0,5827, 3’te 0,3786’dır: alt sınır eğrisi 0,5’e ya da altına ilk kez 3’te iner ve medyanın alt sınırı 3 olur. upper 2, 3, 5 ve 6’da 1, 8’de NA’dır: üst sınır eğrisi 0,5’e ya da altına hiç inmez ve medyanın üst sınırı NA çıkar.
fit nesnesi sansür zamanlarını da satır olarak taşır; elle kurduğumuz risk_tablosu tablosu ise yalnızca olay zamanlarından oluşur. Bu yüzden karşılaştırmadan önce olay satırlarını işaretliyoruz:
olay_satiri <- fit$n.event > 0

olay_satiri
#> [1] TRUE TRUE TRUE FALSE TRUEBu mantıksal vektörle paketin sağkalım tahminlerinden yalnızca olay satırlarını seçiyoruz:
km_paket <- fit$surv[olay_satiri]

km_paket
#> [1] 0.8333333 0.6666667 0.4444444 0.0000000Aynı seçimi kümülatif hazard için de yapıyoruz:
na_paket <- fit$cumhaz[olay_satiri]

na_paket
#> [1] 0.1666667 0.3666667 0.7000000 1.7000000Aşağıdaki blokta iki karşılaştırmanın da TRUE vermesi gerekir: elle kurduğumuz km_manual ve na_manual sütunları paketin surv ve cumhaz değerleriyle örtüşmelidir. Blok, Hafta 1’deki denetim adımının kalıbını izler: all.equal() karşılaştırır, isTRUE() sonucu tek bir TRUE ya da FALSE’a indirir, stopifnot() biri bile FALSE olursa sayfayı burada durdurur.
paket_kontrol <- c(
  km = isTRUE(all.equal(risk_tablosu$km_manual, km_paket)),
  na = isTRUE(all.equal(risk_tablosu$na_manual, na_paket))
)
stopifnot(paket_kontrol)
list(
  degerler = data.frame(
    km_elle = risk_tablosu$km_manual, km_paket = km_paket,
    na_elle = risk_tablosu$na_manual, na_paket = na_paket
  ),
  uyumlu = paket_kontrol
)
#> $degerler
#> km_elle km_paket na_elle na_paket
#> 1 0.8333333 0.8333333 0.1666667 0.1666667
#> 2 0.6666667 0.6666667 0.3666667 0.3666667
#> 3 0.4444444 0.4444444 0.7000000 0.7000000
#> 4 0.0000000 0.0000000 1.7000000 1.7000000
#>
#> $uyumlu
#> km na
#> TRUE TRUEKarşılaştırmayı hesaptan ayrı bir kod bloğunda yapıyoruz: denetim tutmazsa sayfa tam bu blokta durur, hesabın kendisi ise yukarıdaki çıktılarda görünür kalır ve hangi sütunun tutmadığı oradan okunur.
Bu iki karşılaştırmanın TRUE vermemesi genellikle bir yuvarlama sorunu değil, bir tanım sorunudur. İlk bakılacak üç yer şunlardır: aynı anda gerçekleşen olay ile sansürün sıralaması, risk kümesinin time >= t yerine time > t ile sayılması ve olay kodlamasının ters çevrilmesi. Böyle bir durumda paket çıktısını değil, kendi risk tablomuzu düzeltmeye başlarız.
Aynı anda birden çok olay olduğunda kümülatif hazarda uygulanabilen düzeltmeyi (ctype = 2) programlamak bu haftanın hedefi değildir; bu altı kişide aynı anda iki olay olmadığı için iki hesap aynı sonucu verir. Temel tahmin ediciyi elle kurup güvenilir paketle eşleştirir, bağlı gözlemlerde yaygın kuralı (tam \(t_j\)’de sansürlenen kişi o anın risk kümesindedir) kullanırız. Güven aralığını ise Güven aralığı bölümünde elle kurduk; aşağıdaki Güven aralığını kodla kurmak alt bölümü onu kodla kurup paketle karşılaştırıyor.
Güven aralığı bölümünde elle kurduğumuz varyansı ve üç aralığı burada kodla kuruyor, paketin olay zamanı başına tablosuyla karşılaştırıyoruz. Önce o tabloyu ekrana getiriyoruz.
print(summary(fit), digits = 4)#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = kucuk)
#>
#> time n.risk n.event survival std.err lower 95% CI upper 95% CI
#> 2 6 1 0.8333 0.1521 0.5827 1
#> 3 5 1 0.6667 0.1925 0.3786 1
#> 5 3 1 0.4444 0.2222 0.1668 1
#> 8 1 1 0.0000 NaN NA NAsummary(fit) — survfit nesnesini olay zamanı başına bir tabloya açar: riskteki kişi, olay sayısı, sağkalım tahmini, onun standart hatası ve %95 güven aralığının alt ve üst sınırı. Sansür zamanlarının satırı yoktur. Buradaki std.err, fit_bilesenleri’ndeki aynı adlı sütundan farklı olarak \(\widehat S\)’nin kendi standart hatasıdır; ikisinin bağı aşağıda kuruluyor. print(..., digits = 4) — basılacak anlamlı basamak sayısını seçer; varsayılan üç basamak (0.833) aşağıdaki elle hesapla karşılaştırmaya yetmez.lower 95% CI ve upper 95% CI sütunları log ölçeğindeki (varsayılan) aralığın alt ve üst sınırıdır. Üst sınırın ilk üç satırda 1 olması Güven aralığı bölümündeki kesilmedir. Son satırda std.err NaN, iki sınır NA çıkar: 8’de tahmin 0’dır ve log ölçeğinde aralık kurulamaz, çünkü \(\log 0\) tanımsızdır. NaN’ın nereden geldiğini aşağıdaki Greenwood tablosu gösterir.
Greenwood hesabını açık R koduyla, risk tablosunun sütunlarından kuruyoruz: toplam \(\sigma(t)^2\), sigma \(\sigma(t)\), std_err ise tahminin kendi standart hatası \(\widehat S(t)\,\sigma(t)\) olacak.
greenwood_tablosu <- data.frame(
  time = risk_tablosu$time,
  surv = risk_tablosu$km_manual,
  toplam = cumsum(
    risk_tablosu$n_event /
      (risk_tablosu$n_risk * (risk_tablosu$n_risk - risk_tablosu$n_event))
  )
)
greenwood_tablosu$sigma <- sqrt(greenwood_tablosu$toplam)
greenwood_tablosu$std_err <- greenwood_tablosu$surv * greenwood_tablosu$sigma

greenwood_tablosu
#> time surv toplam sigma std_err
#> 1 2 0.8333333 0.03333333 0.1825742 0.1521452
#> 2 3 0.6666667 0.08333333 0.2886751 0.1924501
#> 3 5 0.4444444 0.25000000 0.5000000 0.2222222
#> 4 8 0.0000000 Inf Inf NaNstd_err sütununda 0,1521; 0,1925 ve 0,2222 görmelisiniz. Son satırda toplam ile sigma Inf, std_err ise NaN çıkar: R \(1/(1\cdot0)\)’ı sonsuz sayar ve \(0\times\infty\)’u tanımsız (NaN, not a number) bırakır. Elle hesaptaki “tanımsız” kodda böyle görünür.
Sütunlar şöyle kurulur:
toplam — her olay zamanının \(d_j/[n_j(n_j-d_j)]\) terimini cumsum(), Nelson–Aalen’deki gibi, zaman sırasıyla biriktirir.sigma — toplam’ın karekökü: \(\log\widehat S(t)\)’nin standart hatası.std_err — surv ile sigma’nın çarpımı: tahminin kendi standart hatası.Paketin aynı sütunu, summary(fit) tablosunun std.err sütunudur:
greenwood_paket <- summary(fit)$std.err

greenwood_paket
#> [1] 0.1521452 0.1924501 0.2222222 NaNKarşılaştırmayı ayrı blokta yapıyoruz. Dört satırın hepsi karşılaştırılır: all.equal() eksik değerlerin yerlerini de karşılaştırır ve 8’deki NaN iki tarafta da aynı yerdedir.
greenwood_kontrol <- isTRUE(all.equal(greenwood_tablosu$std_err, greenwood_paket))
stopifnot(greenwood_kontrol)
list(
  degerler = data.frame(
    zaman = greenwood_tablosu$time,
    elle = greenwood_tablosu$std_err,
    paket = greenwood_paket
  ),
  uyumlu = greenwood_kontrol
)
#> $degerler
#> zaman elle paket
#> 1 2 0.1521452 0.1521452
#> 2 3 0.1924501 0.1924501
#> 3 5 0.2222222 0.2222222
#> 4 8 NaN NaN
#>
#> $uyumlu
#> [1] TRUESonuç TRUE olmalıdır. FALSE görülürse ilk bakılacak yer iki standart hatanın karıştırılmasıdır: greenwood_tablosu$sigma \(\log\widehat S\)’nin standart hatasıdır, summary(fit)$std.err ise \(\widehat S\)’nin; ikisi ancak \(\widehat S\) ile çarpılınca eşitlenir. Aynı ayrım aşağıda broom::tidy() çıktısını okurken de gerekecek.
Güven aralığı bölümündeki üç formül paketin kendi tanımlarıdır: survival 3.5-7’nin kaynak kodunda aralıkları kuran survfit_confint() işlevi aynı üç formülü uygular.
Aynı üç aralığı R’de, paketin kullandığı tam \(z\) ile kuruyoruz. Formüller küçük bir işlevin gövdesinde, Güven aralığı bölümünün 3. adımındaki sırayla (düz, log, log-log) duruyor; girdileri Greenwood tablosunun 5 zamanındaki satırından alıyoruz.
uc_aralik <- function(s, sigma, z = qnorm(0.975)) {
  us <- z * sigma / abs(log(s))
  data.frame(
    olcek = c("plain", "log", "log-log"),
    alt = c(max(s - z * s * sigma, 0), s * exp(-z * sigma), s^exp(us)),
    ust = c(min(s + z * s * sigma, 1), min(s * exp(z * sigma), 1), s^exp(-us))
  )
}

aralik_elle <- uc_aralik(
  s = greenwood_tablosu$surv[greenwood_tablosu$time == 5],
  sigma = greenwood_tablosu$sigma[greenwood_tablosu$time == 5]
)

aralik_elle
#> olcek alt ust
#> 1 plain 0.008896892 0.8799920
#> 2 log 0.166807937 1.0000000
#> 3 log-log 0.066186753 0.7849084Altı sınır, Güven aralığı bölümünün 4. adımındaki elle hesapla aynıdır: düz ölçekte (0,0089; 0,8800), log ölçeğinde (0,1668; 1) ve log-log ölçeğinde (0,0662; 0,7849).
qnorm(0.975) — standart normal dağılımın %97,5 yüzdeliği, yani iki yanlı %95 aralığın çarpanı: 1,959964. Elle hesaptaki 1,96 ile bu sayı, buradaki altı sınırı dördüncü ondalığa kadar aynı verir. z = qnorm(0.975) işlev tanımındaki varsayılan değerdir: çağrıda z yazılmadığı için bu değer kullanılır.max(..., 0) ve min(..., 1) paketin sınırları 0 ve 1’de kesmesinin elle karşılığıdır.us — log-log formülündeki \(c\); s^exp(us) alt, s^exp(-us) üst sınırdır.Paketin üç aralığını, aynı uyumu üç conf.type ile kurup 5 zamanında okuyarak alıyoruz.
paket_araligi <- function(tip) {
  uyum <- survival::survfit(
    survival::Surv(time, event) ~ 1,
    data = kucuk,
    conf.type = tip
  )
  o <- summary(uyum, times = 5)
  data.frame(olcek = tip, alt = o$lower, ust = o$upper)
}

aralik_paket <- rbind(
  paket_araligi("plain"),
  paket_araligi("log"),
  paket_araligi("log-log")
)

aralik_paket
#> olcek alt ust
#> 1 plain 0.008896892 0.8799920
#> 2 log 0.166807937 1.0000000
#> 3 log-log 0.066186753 0.7849084conf.type = tip — güven aralığının ölçeğini seçer: "plain", "log" ya da "log-log". Verilmezse: survfit() aralığı "log" ölçeğinde kurar; bu sayfada conf.type yazılmayan her uyum, örneğin altı kişilik fit, bu ölçektedir. summary(uyum, times = 5) — eğriyi yalnızca istenen zamanda okur.Elle kurulan aralıkları paketinkilerle ayrı blokta karşılaştırıyoruz:
aralik_kontrol <- isTRUE(all.equal(aralik_elle, aralik_paket))
stopifnot(aralik_kontrol)
aralik_kontrol
#> [1] TRUESonuç TRUE olmalıdır. FALSE, formüllerden biriyle paketin tanımının ayrıştığını gösterir. Log-log’da bu ayrışmaya kolayca düşülür: \(0<\widehat S(t)<1\) olduğu için büyük üs (\(e^{c}\)) daha küçük bir sayı, yani alt sınırı verir; iki üs yer değiştirirse aralık ters döner.
Bu karşılaştırma yalnız 5 zamanına bakar. Şimdi üç ölçeğin aralık genişliklerini 2, 3 ve 5 zamanlarında yan yana görelim; son sütun, log aralığının 1’de kesilmeden önceki genişliğidir.
genislik_oku <- function(tip) {
  uyum <- survival::survfit(
    survival::Surv(time, event) ~ 1,
    data = kucuk,
    conf.type = tip
  )
  o <- summary(uyum, times = c(2, 3, 5))
  o$upper - o$lower
}

genislik_tablosu <- data.frame(
  zaman = c(2, 3, 5),
  duz = genislik_oku("plain"),
  log = genislik_oku("log"),
  log_log = genislik_oku("log-log"),
  log_kesilmeden = greenwood_tablosu$surv[1:3] *
    (exp(qnorm(0.975) * greenwood_tablosu$sigma[1:3]) -
       exp(-qnorm(0.975) * greenwood_tablosu$sigma[1:3]))
)

round(genislik_tablosu, 4)
#> zaman duz log log_log log_kesilmeden
#> 1 2 0.4649 0.4173 0.7016 0.6092
#> 2 3 0.7105 0.6214 0.7098 0.7953
#> 3 5 0.8711 0.8332 0.7187 1.0174genislik_oku(tip) — paket_araligi() gibi uyumu verilen ölçekte kurar, ama eğriyi times = c(2, 3, 5) ile üç zamanda birden okur ve her zaman için upper - lower farkını, yani aralığın genişliğini döndürür.log_kesilmeden — log aralığının üst sınırı 1’de kesilmeseydi alacağı genişlik, \(\widehat S\,(e^{z\sigma}-e^{-z\sigma})\); Greenwood tablosunun ilk üç satırından, yani 2, 3 ve 5 zamanlarından hesaplanır.Log-log’un 5 zamanında en dar çıkması (Güven aralığı bölümünün 4. adımı) o zamana özgüdür. Tablonun ilk iki satırında log ile log-log şöyle ayrışır:
Log-log aralığının 1’e yakın tahminlerde genişlemesi \(c\)’nin paydasından gelir: log-log ölçeğinde standart hata \(\sigma/\lvert\log\widehat S\rvert\)’dir ve \(\widehat S\) 1’e yaklaştıkça \(\lvert\log\widehat S\rvert\) küçülür. 2 zamanında \(\lvert\log(5/6)\rvert=0{,}1823\) ve \(c=1{,}96\cdot0{,}18257/0{,}1823=1{,}963\)’tür; aynı sayı 5 zamanında 1,2085’ti (Güven aralığı bölümünün 4. adımı).
Görev C’nin gerçek verisinde de çeyrekliklerde log-log, kuyrukta log aralığı daha geniştir; görev ikisini eğrinin tamamı boyunca karşılaştırıyor.
plot()survfit nesnesinin kendi çizim yöntemi vardır: eğriyi, sansür işaretlerini ve güven bandını tek çağrıda çizer. Dersin grafik kuralı ggplot2’dir; bu çizim ve laboratuvardaki tam örneklem eğrisi bu kuralın iki istisnasıdır, çünkü burada amaç paketin kendi aracının ne gösterdiğini görmektir. Çizim, Açık R koduyla risk tablosu ve Kaplan–Meier eğrisi bölümünde elle çizdiğimiz eğriyle aynı basamakları vermelidir.
plot(
  fit,
  mark.time = TRUE,
  yaxt = "n",
  xlab = "Süre (yıl)",
  ylab = "Sağkalım tahmini (olasılık)"
)
axis(2, at = seq(0, 1, by = 0.2),
     labels = format(seq(0, 1, by = 0.2), decimal.mark = ","))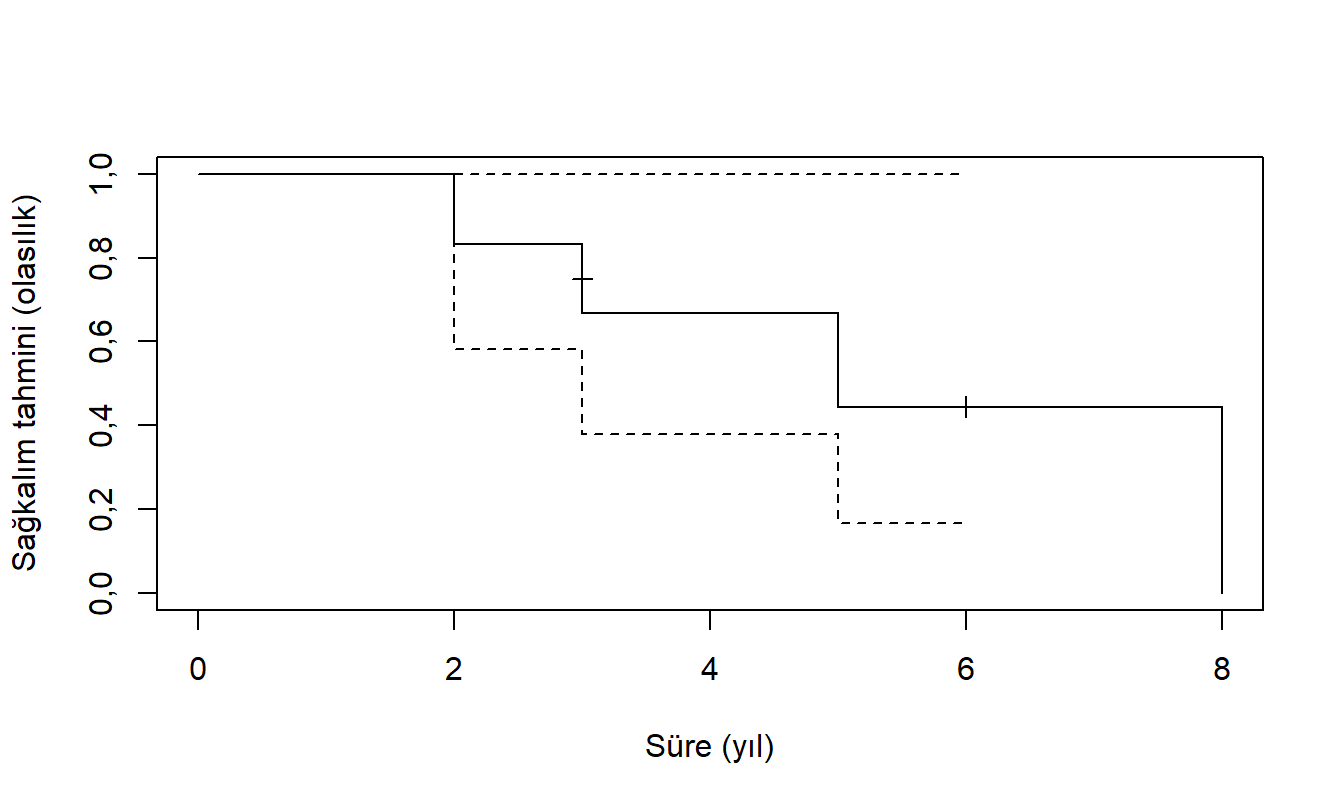
survival paketinin kendi çizimi: altı kişilik örneğin Kaplan–Meier eğrisi, sansür işaretleri ve kesikli çizgilerle %95 güven bandı. Basamaklar elle çizilen eğrinin basamaklarıyla aynıdır.plot(fit) — plot() bir genel işlevdir (generic function): kendisine verilen nesnenin sınıfına göre farklı bir yöntem çağırır. fit’in sınıfı survfit olduğu için survival paketinin çizim yöntemi çalışır ve Kaplan–Meier basamaklarını çizer. Tek bir eğride %95 güven bandını da kendiliğinden, kesikli çizgilerle ekler; sınırlar fit’in kurulduğu "log" ölçeğindedir.mark.time = TRUE — sansür zamanlarına eğri üzerinde artı işareti koyar. Verilmezse: varsayılanı FALSE’tur; işaretler çizilmez ve 3 ile 6’daki iki sansür grafikte görünmez.yaxt = "n" ve axis(2, ...) — temel R eksenleri ondalığı noktayla yazar. yaxt = "n" paketin düşey eksenini çizdirmez; axis(2, ...) aynı noktalara (at) Türkçe ondalık virgülüyle yazılmış etiketler koyar. format(..., decimal.mark = ",") 0,2’yi "0,2" diye yazar.xlab, ylab — eksen başlıkları; paket kendiliğinden başlık yazmaz. Grafiği elle çizdiğimiz eğriyle karşılaştıralım. Basamaklar aynıdır: eğri 2’de 0,8333’e, 3’te 0,6667’ye, 5’te 0,4444’e iner ve 8’de sıfıra düşer. İki fark çizim seçimidir, tahminde bir fark değildir:
canlifins_sample.csv neyi anlatıyor?Bu haftanın gerçek veri hesapları tek bir dosyadan geliyor. Sansürleme kararlarının tamamı “bu sütun neyi kodluyor?” sorusuna dayandığı için sözlüğü dosyaya dokunan ilk hesaptan önce yazıyoruz.
Bu dosya nedir. Ortak ve son hayatta kalan yıllık gelir (joint and last-survivor annuity) sözleşmelerinden derlenmiş bir öğretim veri kümesidir: ödeme, iki alıcıdan sonuncusu ölene kadar sürer. Her sözleşmede bir erkek ve bir kadın yıllık gelir alıcısı vardır ve her ikisi için de gözlem süresince ölümün gözlenip gözlenmediği kayıtlıdır. Ölçü birimi yıl cinsinden yaştır; dosya para tutarı, teminat ya da prim içermez.
Nereden geldi. Kaynak, CASdatasets paketinin canlifins veri kümesidir (sürüm 1.2-1); lisansı GPL (>= 2) ve kopyanın alındığı tarih 24 Ağustos 2026’dır. Üçü de data_manifest.csv dosyasında yazılıdır — bir sayıyı tartışmaya açacaksanız önce oraya bakın. Paketin belgesine göre veri, büyük bir Kanada sigorta şirketinin 29 Aralık 1988 – 31 Aralık 1993 arasında ödeme aşamasında olan 14.889 sözleşmesinden oluşur. Belgenin kendi Kaplan–Meier örneği de çıkış yaşını zaman ölçeği olarak kullanır; bu ders aynı biçimi izler; bu biçimin neyi yok saydığı aşağıdaki yanıtlayamaz kutusundadır. Ders dosyası bu kaynaktan seçilmiş 2.000 satırlık basit rassal bir örnektir; seçim sabit bir kuralla yapıldığı için her çalıştırmada aynı 2.000 satır gelir. Dosya dönem boyunca değişmez ve bunun tek bir amacı vardır: herkes aynı kodu çalıştırdığında aynı sayıyı görsün.
Bu notu okumak için bir şey indirmeniz gerekmez: aşağıdaki bütün çıktılar sayfada zaten duruyor. Kodu kendi bilgisayarınızda çalıştırmak isterseniz dersin veri dosyasını buradan indirebilirsiniz:
İndirdiğiniz dosyayı betiğinizin yanında bir data/derived/ klasörüne koyarsanız aşağıdaki yollar olduğu gibi çalışır. Kaynağından yeni bir kopya indirmeyin — kaynak 14.889 sözleşmenin hepsini, her çifti tek satırda ve başka sütun adlarıyla tutar; bu ders ondan seçilmiş 2.000 kişilik bir örnek kullanır. Kaynaktan hesaplanan sayılar sayfadakilerle tutmaz.
Bir satır neyi temsil ediyor? Bir satır bir kişidir — bir sözleşme değil, bir ölüm değil. Kaynak dosyada bir satır bir sözleşmeye, yani bir çifte karşılık gelir; ders dosyası her sözleşmeyi ikiye açar ve her alıcı için ayrı bir satır yazar. Bu ayrım id sütununu okurken önemlidir: id kişinin değil, satırın geldiği sözleşmenin numarasıdır.
| Sütun | Anlamı | Birim / kodlama |
|---|---|---|
id |
Satırın geldiği sözleşmenin numarası | Tam sayı; benzersiz anahtar değildir — aynı sözleşmenin iki alıcısı da örneğe düştüyse iki satır aynı numarayı taşır |
sex |
Belgelenmiş cinsiyet kategorisi | Metin, yalnızca iki değer: "female" ve "male". Sayısal kod değildir. İki değer alfabetik sıralandığı için gruplu çıktılarda sex=female katmanı önce gelir |
entry_age |
Kişinin gözleme girdiği yaş | Yıl, ondalıklı. Eğrilerin zaman ölçeğine girmez — o ölçek time’dır. Sayfada üç yerde kullanılır: aşağıdaki yapısal denetimde (exit_age >= entry_age), laboratuvarın Görev A’sında ve Alıştırma 5’te |
exit_age |
Kişinin gözlemden çıktığı yaş | Yıl, ondalıklı. Ölüm gözlendiyse ölüm yaşıdır; gözlenmediyse entry_age ile aynı değeri taşır |
time |
Haftanın zaman değişkeni | Yıl, ondalıklı; exit_age ile birebir aynıdır, yani ölümlerde ölüm yaşı, sansürlülerde giriş yaşıdır. Süre değil yaştır: sıfır noktası doğum, gözlemin başlangıcı değil |
event |
Olay göstergesi | İki değerli sayısal kod: 1 = ölüm gözlendi, 0 = sağdan sansürlü. Ters kodlama değildir; 0, “kişi hayatta kalacak” demek değil, “bu pencerede ölüm görülmedi” demektir |
Hangi soruları yanıtlıyoruz? Bu dosyayla iki soru soruyoruz:
time bir yaştır, bir süre değil. “Bu kişi kaç yıl izlendi?” sorusunun yanıtı bu sütunda yoktur.ExitAge) gerçek çıkış yaşını yalnızca ölüm gözlenen kayıtlarda taşır; ölüm gözlenmeyen kayıtlarda giriş yaşını tekrarlar ve ders dosyası bunu exit_age olarak devralır. Yani event = 0 olan bir satırda time, gözlemin bittiği değil başladığı yaştır. Gözlem penceresi beş yıl olduğu için sansürlü kişi gerçekte girişinden en çok beş yıl sonra gözlemden çıkmıştır; dosya bu yaşı tutmaz.Surv(time, event) herkesi 0 yaşından itibaren riskte sayar, oysa kimse gözleme doğduğu anda girmemiştir ve gözleme girmeden önce ölen biri dosyada hiç yoktur. Girişi hesaba katan düzeltmeye sol kesme düzeltmesi denir (Hafta 3 aynı durumu hasar eşiğinde gördü); bu hafta kurulmuyor. Eğri bu yüzden iki yönde kusurludur: girişi yok saymak her ölüm yaşının risk kümesine o yaşta henüz gözlemde olmayanları da koyar ve eğriyi yukarı iter; sansürlülerin giriş yaşında riskten çıkması (bir önceki madde) risk kümesini küçültür ve eğriyi aşağı iter. Hangisinin hangi yaşta ağır bastığı bu hafta ölçülmüyor. entry_age sütunu dosyada durur ve aşağıdaki yapısal denetimde kullanılır, ama eğrilerin zaman ölçeğine girmez.id değerini taşıyan iki satır aynı çiftin iki üyesidir. Örnekte böyle 78 çift, yani 156 satır var; Kaplan–Meier ise her satırı bağımsız sayar. Tahminin kendisi bundan bozulmaz, çünkü her çarpan yalnız o yaştaki sayımlara bakar; eşlerin birbirine bağlı olması bu sayımların oynaklığını etkiler. Satırları bağımsız sayan, Greenwood varyansıdır. 156 satırla etkisi küçüktür: survfit()’e cluster = id verildiğinde paket, aynı sözleşmenin iki satırını tek birim sayan bir varyans tahmini kullanır; bu tahmin 70, 80 ve 90 yaşında standart hatayı en çok %0,3 değiştirir. Bu nedenle buradaki eğriler bir fiyatlama tablosu ya da nüfus ölüm hızı yerine kullanılamaz; gösterdikleri şey tahmin edicinin nasıl çalıştığıdır.
Bu haftanın gerçek veri hesapları için önce dosyanın yerinde olduğunu denetleyip onu okuyalım.
veri_yolu <- file.path("data", "derived", "canlifins_sample.csv")
file.exists(veri_yolu)
#> [1] TRUEfile.exists(veri_yolu) — o yolda bir dosya bulunup bulunmadığını sorar; TRUE görmelisiniz. FALSE görürseniz sorun okuma adımından önce ortaya çıkar: dosya ya indirilmemiş ya da data/derived/ klasörüne konmamıştır.veri <- read_csv(veri_yolu, show_col_types = FALSE)
veri#> # A tibble: 2,000 × 6
#> id sex entry_age exit_age time event
#> <dbl> <chr> <dbl> <dbl> <dbl> <dbl>
#> 1 1 female 62.1 62.1 62.1 0
#> 2 7 male 62.9 62.9 62.9 0
#> 3 29 male 56.6 56.6 56.6 0
#> 4 42 female 65.2 65.2 65.2 0
#> 5 47 female 64.2 64.2 64.2 0
#> 6 58 female 61.6 61.6 61.6 0
#> 7 62 male 60.9 60.9 60.9 0
#> 8 66 male 69.0 69.0 69.0 0
#> 9 77 female 65.3 65.3 65.3 0
#> 10 110 female 65.2 65.2 65.2 0
#> # ℹ 1,990 more rowsTibble başlığı satır ve sütun sayısını, sütun adlarının altındaki tip işaretleri de her sütunun sayısal mı metin mi olduğunu söyler; sözlükte sıralanan sütunların tamamı çıktıda görünmelidir.
Denetimden önce veriye dört araçla bakalım. Her biri başka bir soruyu yanıtlar: satırlar neye benziyor (head()), her sütun hangi tipte (str()), sayısal sütunlar hangi aralıkta (summary()) ve bir sütunda hangi değer kaç kez geçiyor (table()).
head(veri)#> # A tibble: 6 × 6
#> id sex entry_age exit_age time event
#> <dbl> <chr> <dbl> <dbl> <dbl> <dbl>
#> 1 1 female 62.1 62.1 62.1 0
#> 2 7 male 62.9 62.9 62.9 0
#> 3 29 male 56.6 56.6 56.6 0
#> 4 42 female 65.2 65.2 65.2 0
#> 5 47 female 64.2 64.2 64.2 0
#> 6 58 female 61.6 61.6 61.6 0head(veri) — ilk altı satırı basar; ikinci argüman satır sayısını değiştirir (head(veri, 10)). Tibble’ı adıyla yazmak ilk on satırı basıyordu.İlk altı satırın hepsi sansürlüdür (event = 0) ve her birinde üç yaş sütunu aynı değeri taşır: sansürlü satırda exit_age ve time giriş yaşını tekrarlar (sözlükteki time satırı).
str(veri, give.attr = FALSE)#> spc_tbl_ [2,000 × 6] (S3: spec_tbl_df/tbl_df/tbl/data.frame)
#> $ id : num [1:2000] 1 7 29 42 47 58 62 66 77 110 ...
#> $ sex : chr [1:2000] "female" "male" "male" "female" ...
#> $ entry_age: num [1:2000] 62.1 62.9 56.6 65.2 64.2 ...
#> $ exit_age : num [1:2000] 62.1 62.9 56.6 65.2 64.2 ...
#> $ time : num [1:2000] 62.1 62.9 56.6 65.2 64.2 ...
#> $ event : num [1:2000] 0 0 0 0 0 0 0 0 0 0 ...str(veri, give.attr = FALSE) — tablonun yapısını verir: ilk satırda satır ve sütun sayısı (2.000 × 6), sonra her sütun için bir satırda adı, tipi (num sayı, chr metin) ve ilk değerleri.give.attr = FALSE — read_csv()’nin tabloya eklediği iki ek bilgiyi, sütun tiplerinin tanımını (spec) ve okuma sorunlarının kaydını (problems), basmaz. Yazılmazsa çıktının sonuna bu iki bilginin on satırı eklenir. sex metin olarak, event ise 0 ve 1 taşıyan bir sayı olarak okunmuştur; sözlükteki kodlamalar bunlardır. id de sayıdır, ama bir ölçü değil, sözleşme numarasıdır.
summary(veri)#> id sex entry_age exit_age
#> Min. : 1 Length:2000 Min. :24.35 Min. :24.35
#> 1st Qu.: 4182 Class :character 1st Qu.:62.66 1st Qu.:62.67
#> Median : 7815 Mode :character Median :66.44 Median :66.51
#> Mean : 7719 Mean :66.48 Mean :66.66
#> 3rd Qu.:11290 3rd Qu.:70.87 3rd Qu.:71.26
#> Max. :14884 Max. :92.95 Max. :95.52
#> time event
#> Min. :24.35 Min. :0.000
#> 1st Qu.:62.67 1st Qu.:0.000
#> Median :66.51 Median :0.000
#> Mean :66.66 Mean :0.067
#> 3rd Qu.:71.26 3rd Qu.:0.000
#> Max. :95.52 Max. :1.000summary(veri) — her sayısal sütun için en küçük değeri, çeyreklikleri, ortalamayı ve en büyük değeri verir. Metin sütunu için yalnızca uzunluğunu (Length) ve tipini yazar; sex sütununun değerlerini saymaz.Çıktıdan şunlar okunur:
time ile exit_age’in özetleri birebir aynıdır: sözlüğün dediği gibi aynı sütunun iki adıdır.entry_age ile time’ın medyanları çok yakındır, 66,44 ve 66,51, çünkü sansürlü satırda time giriş yaşının kendisidir. İki sütun yalnızca ölümlerde ayrılır; en çok üst uçta görünür: entry_age en çok 92,95, time en çok 95,52. event’in ortalaması 0,067’dir. 0 ve 1 taşıyan bir sütunun ortalaması 1’lerin payıdır: satırların %6,7’sinde ölüm gözlenmiştir. Medyan ve çeyreklikler bu yüzden 0’dır. id’nin özeti bir şey söylemez, çünkü sözleşme numarasının ortalaması bir anlam taşımaz.Metin sütununun değerlerini ve 0/1 kodlu event’in iki değerini table() sayar:
table(veri$sex)#>
#> female male
#> 1021 979table(veri$sex) — bir sütunda her farklı değerin kaç kez geçtiğini sayar. 1.021 kadın, 979 erkek; toplam 2.000. table(veri$event)#>
#> 0 1
#> 1866 1341.866 satır sansürlü (0), 134 satırda ölüm gözlenmiş (1). \(134/2.000=0{,}067\), summary()’deki ortalamanın aynısıdır. Cinsiyet ile olayı birlikte saymak laboratuvarın Görev A’sının işidir.
Surv() bir sütunun neyi kodladığını sormaz. Örneğin bir dosya ölümü 1, hayatta kalmayı 2 diye kodlasa Surv() yine 1’i sansür, 2’yi ölüm sayar: eğri ölümlerin değil sansürlerin eğrisi olur ve uyarı çıkmaz. Böyle bir kodlamayı aşağıdaki olay_ikili yakalar. Bu yüzden eğriden önce sözlüğün iddialarını kodla sınıyoruz. Beş denetimin de TRUE dönmesi gerekir; biri bile FALSE olsaydı stopifnot() sayfayı burada durdururdu.
veri_kontrol <- c(
  yas_pozitif = all(veri$time > 0),
  olay_ikili = all(veri$event %in% c(0, 1)),
  yas_sirali = all(veri$exit_age >= veri$entry_age),
  time_cikis_yasina_esit = isTRUE(all.equal(veri$time, veri$exit_age)),
  sansur_var = any(veri$event == 0)
)
stopifnot(veri_kontrol)
veri_kontrol
#> yas_pozitif olay_ikili yas_sirali
#> TRUE TRUE TRUE
#> time_cikis_yasina_esit sansur_var
#> TRUE TRUEHer denetim sözlükteki bir iddiayı kodla sınar:
yas_pozitif: time doğumdan ölçülen bir yaştır; sıfır ya da negatif bir değer bozuk bir satırdır.olay_ikili: event yalnız 0 ve 1 taşır; başka bir kod, sansür kodlamasının değiştiğini gösterir.yas_sirali: çıkış yaşı giriş yaşından küçük değildir. entry_age burada kullanılır, ama eğrilerin zaman ölçeğine girmez.time_cikis_yasina_esit: time ile exit_age ayrı iki ölçü değil, aynı sütunun iki adıdır.sansur_var: en az bir satır sansürlüdür; sansür kodlaması bozulup bütün satırlar olay olarak yazılsaydı sayfa burada dururdu.Eğrilerin zaman ölçeği time’dır; entry_age hiçbir eğrinin hesabına girmez.
Sözlük id’nin benzersiz bir anahtar olmadığını söylemişti; kaç sözleşmenin iki satırla örnekte bulunduğunu sayalım.
c(
  satir = nrow(veri),
  farkli_sozlesme = length(unique(veri$id)),
  iki_satirli_sozlesme = sum(duplicated(veri$id))
)
#> satir farkli_sozlesme iki_satirli_sozlesme
#> 2000 1922 78duplicated(veri$id) — bir numarayı ikinci kez gördüğü her satırda TRUE verir. Toplamı, iki satırla örnekte bulunan sözleşme sayısıdır, çünkü bir sözleşmenin en çok iki alıcısı vardır.2.000 satır 1.922 sözleşmeden gelir: 78 sözleşmenin iki alıcısı da örnektedir, yani 156 satır bir çiftin üyesidir. Kaplan–Meier bu satırları bağımsız sayar; sözlüğün yanıtlayamaz kutusundaki uyarı bu sayıya dayanır.
Gövde eğriyi altı kişide elle kurdu, pakete doğrulattı, gerçek veriyi okuyup denetledi. Laboratuvar eğriyi gerçek veride kurar; beş görevi bu eğrinin etrafında, gövdenin sormadığı soruları soruyor ve her birinin yanıtı bir karara bağlanır:
| Görev | Soru | Hangi karar için |
|---|---|---|
| A | Sansür hangi cinsiyette ve hangi giriş yaşlarında yoğunlaşıyor? | Eğrinin hangi kesiminin ne kadar ölüme dayandığı; sansürün bilgi taşıyıp taşımadığı |
| B | time’ın çeyrekliklerinde sağkalım, aralık ve riskteki kişi sayısı ne? |
Bir yaştaki sağkalımın hangi kesinlikle raporlanacağı |
| C | "log" ve "log-log" aralıkları eğri boyunca nerede ayrışıyor? |
Raporda aralığın hangi ölçekte kurulacağı |
| D | Kaplan–Meier ile \(\exp(-\widehat H)\) 2.000 kişide ne kadar ayrışıyor? | Raporlanan tahmin edicinin hangi yaşlarda sonucu değiştirdiği |
| E | Sansürü olay saymak medyanı hangi yöne, ne kadar kaydırıyor? | Uyumun olay sayısını veridekiyle karşılaştıran bir denetimin analize eklenmesi |
Sonuncusu haftanın ana dersini ölçer: sansürlü gözlem olay değildir. Görevler gövdenin okuyup denetlediği veri’yi hazır kullanır; indirilebilir betik onu # Gorev A satırından önce kendisi okur ve gövdedeki veri_kontrol ile denetler, sonrası bu sayfadaki bloklarla aynıdır.
Görev B–E tek bir tam örneklem eğrisi üzerinde çalışıyor: cinsiyete bölünmemiş, 2.000 satırın hepsinden kurulan tek eğri. Önce onu kuruyoruz.
fit_tam <- survival::survfit(
  survival::Surv(time, event) ~ 1,
  data = veri,
  conf.type = "log-log"
)
fit_tam
#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = veri,
#> conf.type = "log-log")
#>
#> n events median 0.95LCL 0.95UCL
#> [1,] 2000 134 81.6 80.3 85.4conf.type = "log-log" — gövdenin Güven aralığı bölümünde tanımlanan üç ölçekten, sınırları her zaman 0 ile 1 arasında kalan "log-log"’u seçer. survfit()’in varsayılanı "log"’dur; Görev C ikisini karşılaştıracak, o yüzden burada seçimi açıkça yazıyoruz. Verilmezse: aralıklar sessizce "log" ölçeğinde kurulur ve Görev C log aralığını kendisiyle karşılaştırmış olur. Çıktıda 2.000 gözlem, 134 ölüm ve 81,6 yaşlık medyan sağkalım görülmelidir. Görev E bu medyanı bilerek yanlış kurulan bir eğrinin medyanıyla karşılaştıracak.
Eğriyi paketin kendi çizimiyle görelim (survival paketiyle doğrulama bölümündeki plot()). Noktalı dikey çizgiler Görev B’nin okuyacağı üç yaştır, time’ın çeyreklikleri.
plot(
  fit_tam,
  xlim = c(55, 100),
  yaxt = "n",
  xlab = "Yaş (yıl)",
  ylab = "Sağkalım tahmini (olasılık)"
)
axis(2, at = seq(0, 1, by = 0.2),
     labels = format(seq(0, 1, by = 0.2), decimal.mark = ","))
abline(v = quantile(veri$time, c(0.25, 0.5, 0.75)), lty = 3)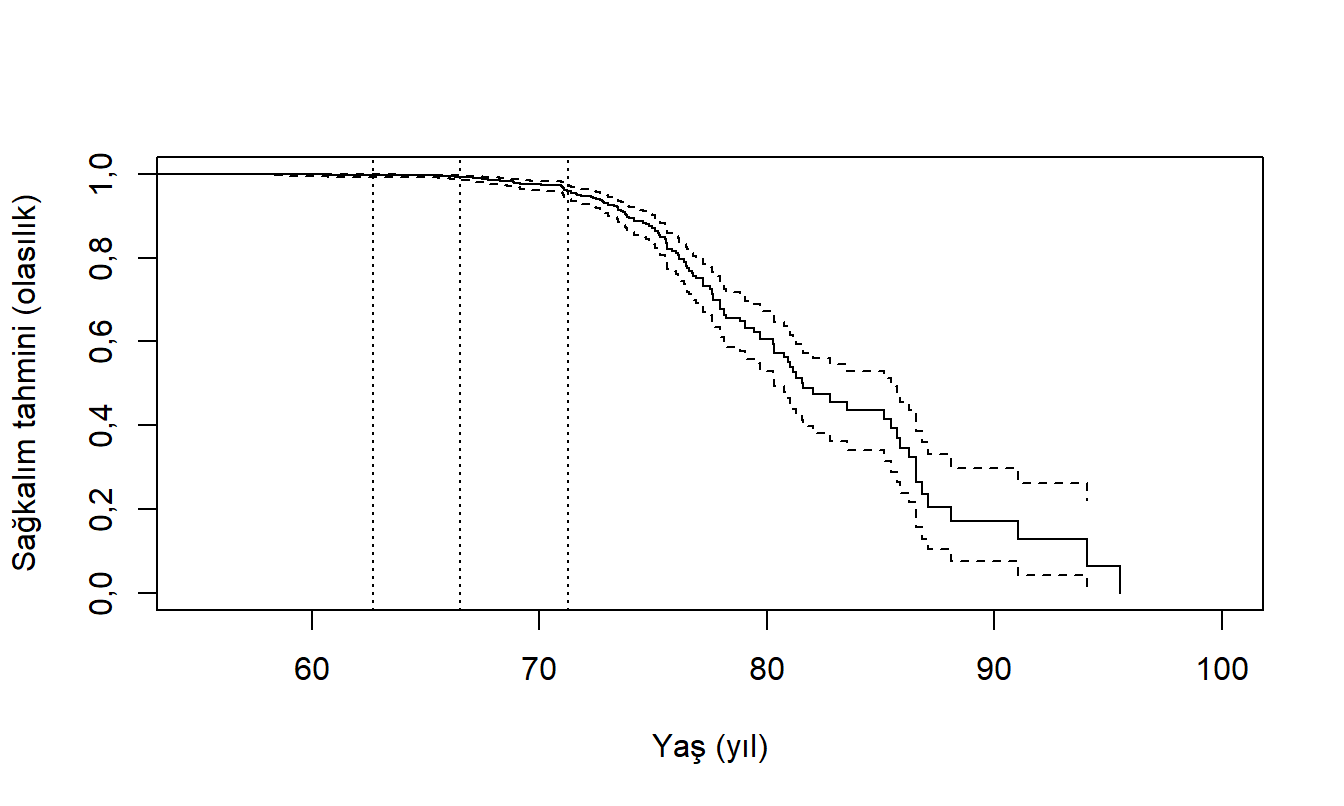
survival paketinin kendi çizimiyle; kesikli çizgiler log-log ölçeğinde %95 güven bandı, noktalı dikey çizgiler time’ın çeyreklikleri.xlim = c(55, 100) — yatay ekseni 55 ile 100 yaş arasına daraltır. Eğri 0 yaşından başlar, ama ilk ölüm 58,20 yaşındadır ve eğri o yaşa kadar 1’de yataydır; eksen 0’dan başlasaydı grafiğin yarısından fazlası bu yatay çizgi olurdu. abline(v = ..., lty = 3) — çizilmiş grafiğe dikey çizgiler ekler: v çizgilerin yatay konumudur, lty = 3 noktalı çizgi.yaxt = "n" ve axis(2, ...) survival paketiyle doğrulama bölümündeki gibi düşey ekseni ondalık virgülüyle yeniden yazar. Bant fit_tam’ın kurulduğu "log-log" ölçeğindedir.Sansür işaretlerini bu kez çizdirmiyoruz; mark.time varsayılanı FALSE’ta kalır. 1.866 işaretin %93’ü 55 ile 80 yaş arasına düşer ve eğriyi o kesimde kalın bir şeride çevirirdi. Üstelik sansürlü satırda time giriş yaşı olduğu için işaretler, kişilerin gözlemden çıktığı değil gözleme girdiği yaşlarda dururdu.
Eğri 70 yaşına kadar 1’e çok yakın kalır (70’te 0,9746), 70 ile 90 arasında hızla iner (80’de 0,6049, 90’da 0,1714) ve son ölümle 95,52 yaşında sıfıra düşer. Bant yaşla genişler: 70’te 0,9620–0,9830, 90’da 0,0761–0,2990.
Üç noktalı çizgi eğrinin henüz düşmediği kesimdedir. Örneklemin çoğu gözleme bu yaşlarda girer, ölümlerin çoğu ise daha sonra gelir: 134 ölümün 101’i üçüncü çeyreklikten, 71,26 yaştan sonradır. Görev B bu üç yaştaki tahmini, aralığı ve riskteki kişi sayısını sayıyla okur.
Görevin iki sorusu var: sansür hangi cinsiyette ve hangi giriş yaşlarında yoğunlaşıyor? Bu dosyada sansür bilgi taşıyor mu? Yanıtlar, eğrinin hangi kesiminin kaç ölüme dayandığını ve sansürün Kaplan–Meier’in varsayımına uyup uymadığını söyler.
Kaplan–Meier, sansürün bilgi taşımadığını varsayar: ayrılanların, kalanlarla aynı riski taşıdığı kabul edilir. Bu varsayım veriden sınanamaz, çünkü sansürlenen kişinin sonradan ne yaşadığını görmeyiz. Yapabileceğimiz, sansürün gruplara ve yaşa göre nasıl dağıldığına bakmaktır: bu, varsayımı kanıtlamaz, ama eğrinin hangi kesiminin ne kadar bilgiye dayandığını gösterir.
gorev_a_grup <- veri |>
  group_by(sex) |>
  summarise(
    n            = n(),
    olay         = sum(event),
    sansur       = sum(event == 0),
    sansur_orani = mean(event == 0),
    .groups = "drop"
  )
gorev_a_grup
#> # A tibble: 2 × 5
#> sex n olay sansur sansur_orani
#> <chr> <int> <dbl> <int> <dbl>
#> 1 female 1021 49 972 0.952
#> 2 male 979 85 894 0.913Kadınlarda sansür oranı %95,2, erkeklerde %91,3 çıkmalıdır: 1.021 kadının 49’unda, 979 erkeğin 85’inde olay gözlenmiştir.
İki grupta sansür oranı eşit değildir. Bu tek başına bir hata belirtisi değildir; cinsiyete göre iki eğri kurulursa (Alıştırma 5) iki eğrinin aynı miktarda bilgiye dayanmadığını söyler: kadın eğrisi 49, erkek eğrisi 85 ölümle kurulur.
İkinci bakış yaşa göredir: sansürlenen kişiler gözleme, ölümü gözlenenlerle aynı yaşlarda mı girmiş? Burada time değil entry_age karşılaştırılır, çünkü time sansürlü satırlarda giriş yaşını, ölümlerde ölüm yaşını taşır. İki grubun time ortalamasını karşılaştırmak, bir grubun giriş yaşıyla öbür grubun ölüm yaşını karşılaştırmak olurdu.
gorev_a_yas <- c(
  sansurlu_giris_yasi = mean(veri$entry_age[veri$event == 0]),
  olayli_giris_yasi   = mean(veri$entry_age[veri$event == 1]),
  fark                = mean(veri$entry_age[veri$event == 1]) -
                          mean(veri$entry_age[veri$event == 0])
)
round(gorev_a_yas, 2)
#> sansurlu_giris_yasi olayli_giris_yasi fark
#> 66.05 72.41 6.35veri$entry_age[veri$event == 0] — köşeli parantezin içindeki mantıksal vektör yalnızca sansürlü satırları seçer; dışındaki entry_age ise seçilen satırlardan okunacak sütundur.Sansürlülerin ortalama giriş yaşı 66,05, ölümü gözlenenlerinki 72,41; fark 6,35 yıl.
İki yuvarlanmış ortalamayı çıkarınca 6,36 bulunur; çıktıdaki 6,35 ise yuvarlanmamış ortalamaların farkıdır: \(72{,}407-66{,}053=6{,}354\).
Bu fark beklenen bir sonuçtur: kaynağın gözlem penceresi beş yıldır (29 Aralık 1988 – 31 Aralık 1993) ve beş yıl içinde ölme olasılığı yaşla artar. Bunu iki ortalamayla değil giriş yaşı dilimleriyle görelim. Tabloya her dilimdeki erkeklerin payını da ekliyoruz; cinsiyetler arasındaki sansür farkının bir kısmının yaştan gelip gelmediğini bu sütun gösterecek.
gorev_a_dilim <- veri |>
  group_by(giris_dilimi = cut(entry_age, c(0, 60, 65, 70, 75, 80, 100))) |>
  summarise(
    n            = n(),
    sansur       = sum(event == 0),
    sansur_orani = mean(event == 0),
    erkek_payi   = mean(sex == "male"),
    .groups = "drop"
  )
gorev_a_dilim
#> # A tibble: 6 × 5
#> giris_dilimi n sansur sansur_orani erkek_payi
#> <fct> <int> <int> <dbl> <dbl>
#> 1 (0,60] 296 291 0.983 0.280
#> 2 (60,65] 479 469 0.979 0.449
#> 3 (65,70] 629 604 0.960 0.504
#> 4 (70,75] 420 366 0.871 0.614
#> 5 (75,80] 125 99 0.792 0.608
#> 6 (80,100] 51 37 0.725 0.588group_by(giris_dilimi = cut(...)) — gruplama sütununu gruplarken kurar; ayrı bir mutate() gerekmez. Hafta 2’de tanıtılan cut()’ın çıktısında (60,65], 60’tan büyük ve en çok 65 olan yaşlar demektir. Sansür oranı giriş yaşıyla düzenli olarak düşer: 60 yaşına kadar girenlerin %98,3’ü, 80’den sonra girenlerin %72,5’i pencereyi ölmeden tamamlamıştır. Sayıca ise sansür 60 ile 75 yaş arasında yoğunlaşır: 1.866 sansürlünün üç dilimdeki \(469+604+366=1.439\)’u, yani %77’si bu yaşlarda girmiştir.
Son sütun cinsiyet farkının bir kaynağını gösterir: erkeklerin payı en genç dilimde %28,0, 70 yaşından sonra girenlerde %59–61’dir. Erkekler gözleme daha yaşlı girmiştir ve yaşlı girenler pencerede daha sık ölür. Cinsiyetin yaştan ayrı payını Alıştırma 5(b) giriş yaşına göre standartlaştırarak ölçer.
Sansür oranının giriş yaşıyla değişmesi Kaplan–Meier’in varsayımını tek başına bozmaz: varsayım, bir yaşta sansürlenenlerin sonraki riskinin o yaşta riskte kalanlarınkiyle aynı olmasıdır. Bu dosyada varsayımı bozan, sözlükten bildiğimiz kayıt biçimidir. Adım adım:
time’ı giriş yaşıdır. Surv(time, event) onu bu yaşa kadar riskte sayar ve bu yaştan sonraki hiçbir ölümün paydasına koymaz.Bu, sözlüğün yanıtlayamaz kutusunda sayılan iki kusurdan biridir: sansürlünün giriş yaşında riskten çıkması.
Görev A’nın yanıtı şudur: sansür kadınlarda (%95,2) ve genç girişlerde (60 yaşına kadar girenlerde %98,3) daha yoğundur. Ölümler ise ileri yaş girişlerinde toplanır: son üç dilimde, yani 70 yaşından sonra girenlerde \(54+26+14=94\) ölüm vardır, 134 ölümün %70’i. Bu dosyada sansür bilgi taşır, çünkü sansürlü kişi pencereyi ölmeden tamamladığı hâlde giriş yaşında riskten çıkar.
Eğrinin tamamına bakmak bir izlenim verir; bir yaştaki sağkalımı raporlamak için o yaşta üç sayı gerekir: tahmin, güven aralığı ve tahminin kaç kişilik bir risk kümesine dayandığı. Üç yaşı verinin kendi çeyrekliklerinden seçiyoruz:
ceyreklikler <- as.numeric(quantile(veri$time, c(0.25, 0.5, 0.75)))
round(ceyreklikler, 2)
#> [1] 62.67 66.51 71.26Çeyreklikler yaklaşık 62,67; 66,51 ve 71,26 yaştır.
quantile(veri$time, c(0.25, 0.5, 0.75)) — time sütununun alt çeyrek, medyan ve üst çeyrek değerlerini döndürür. Bu sütun sansürlülerde giriş, ölenlerde ölüm yaşı olduğu ve satırların %93’ü sansürlü olduğu için çeyreklikler neredeyse giriş yaşlarının çeyrekleridir. Yaşları elle seçmek yerine veriden almak, tablonun örneklemin yoğun olduğu yaşları göstermesini sağlar. as.numeric(...) — quantile()’in sonuca eklediği 25%, 50% ve 75% adlarını atar, yalın üç sayı bırakır; aşağıdaki summary() bu sayıları yaş olarak alır. gorev_b_ozet <- summary(fit_tam, times = ceyreklikler, extend = TRUE)
gorev_b_ozet#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = veri,
#> conf.type = "log-log")
#>
#> time n.risk n.event survival std.err lower 95% CI upper 95% CI
#> 62.7 1500 6 0.996 0.00144 0.992 0.998
#> 66.5 1000 4 0.993 0.00227 0.987 0.996
#> 71.3 500 23 0.960 0.00732 0.943 0.972summary(fit_tam, times = , extend = TRUE) — eğriyi verilen zamanlarda okur. extend = TRUE, son gözlem zamanının ötesinde bir yaş istendiğinde o yaş için de bir satır yazar; varsayılan FALSE böyle bir isteği tablodan çıkarır. Bu haftanın bütün istekleri son gözlemden (95,52 yaş) önce olduğu için burada sonucu değiştirmez. Aynı bilgiyi altı sütunlu sade bir tabloya indiriyoruz; sonraki görevler bu biçimi kullanacak:
gorev_b <- data.frame(
  yas       = round(gorev_b_ozet$time, 2),
  riskteki  = gorev_b_ozet$n.risk,
  olay      = gorev_b_ozet$n.event,
  sagkalim  = round(gorev_b_ozet$surv, 4),
  alt_sinir = round(gorev_b_ozet$lower, 4),
  ust_sinir = round(gorev_b_ozet$upper, 4)
)
gorev_b
#> yas riskteki olay sagkalim alt_sinir ust_sinir
#> 1 62.67 1500 6 0.9965 0.9922 0.9984
#> 2 66.51 1000 4 0.9930 0.9868 0.9963
#> 3 71.26 500 23 0.9598 0.9426 0.9719Bu üç yaşta sağkalım 0,9965; 0,9930 ve 0,9598, riskteki kişi sayısı ise 1.500, 1.000 ve 500 olmalıdır.
Bu üç sayının yuvarlak çıkması rastlantı değildir. Bir yaşta riskteki kişi, time değeri o yaştan küçük olmayan satırdır; yaşlar time’ın kendi çeyreklikleri olduğu için riskte satırların dörtte üçü, yarısı ve dörtte biri kalır: 2.000’in 1.500’ü, 1.000’i ve 500’ü.
olay sütunu bir önceki satırdan o yaşa kadar gözlenen ölüm sayısıdır: ilk satırda ilk çeyrekliğe kadar 6, ikincide iki çeyreklik arasında 4, üçüncüde 23 ölüm. 134 ölümün geri kalan 101’i üst çeyrekliğin ötesindedir.
Risk kümesinin bu hızla küçülmesinin nedeni Görev A’daki sansürlerdir: 71,26 yaşta riskte 500 kişi kalır, yani 2.000 kişiden 1.500’ü o yaşa gelmeden riskten çıkmıştır. Bu 1.500 kişinin yalnız \(6+4+23=33\)’ü ölümdür; kalan 1.467’si giriş yaşında riskten çıkan sansürlüdür.
Görev C’nin incelediği 80 yaşta riskte 64 kişi kalır; oraya kadarki düşüşün de büyük kısmı sansürdür.
İlk satırın 0,9965’i o ilk altı ölümden gelir. Risk kümesi yaşla yalnız küçülebildiği için her biri en az 1.500 kişilik bir risk kümesinde gerçekleşmiş ve eğriyi en çok \(1/1.500=0{,}00067\) oranında indirmiştir; altısı birlikte \(1-0{,}9965=0{,}0035\) indirir.
Ama 0,9965’i “doğan bir kişinin o yaşa ulaşma olasılığı” diye okumayın: gözleme girmeden önce ölen kimse dosyaya giremez, girişi yok sayan eğri ise herkesi 0 yaşından riskte sayar (sözlüğün yanıtlayamaz kutusu). Bu sayı tahmin edicinin bu dosyada verdiği değerdir, bir nüfus olasılığı değil.
Aralığın genişliğini büyük ölçüde riskteki sütunu belirler. Genişlik ilk satırda \(0{,}9984-0{,}9922=0{,}0062\), üçüncüde \(0{,}9719-0{,}9426=0{,}0293\)’tür; oran yaklaşık 4,7’dir. Nedeni Güven aralığı bölümündeki Greenwood toplamıdır: her ölüm toplama \(d_j/[n_j(n_j-d_j)]\) ekler. Payda risk kümesinin karesi gibi büyüdüğü için tek bir ölüm 500 kişilik risk kümesinde 1.500 kişiliktekinin dokuz katına yakın ekler.
Katkı dokuz kat büyüdüğü hâlde genişlik yalnız 4,7 kat büyür. Genişlik varyansı değil standart hatayı, yani toplamın karekökünü izler ve toplam o yaşa kadarki bütün ölümleri taşır. Risk kümesi küçüldükçe hem her ölümün katkısı büyür hem ölümler çoğalır. Görev B’nin özetindeki standart hatalar 0,00144 ve 0,00732’dir; oranları yaklaşık 5.
Görevin yanıtı şudur: bir yaştaki sağkalım riskteki kişi sayısıyla birlikte raporlanır. Ölümlerin çoğu üst çeyrekliğin ötesinde, riskte 500’den az kişinin kaldığı yaşlardadır; eğrinin o kesimini Görev C izliyor.
Aralığın ölçeği bir seçimdir: gövdedeki eğriler varsayılan "log" ile, fit_tam "log-log" ile kuruldu. Gövdenin Güven aralığı bölümü üç ölçeği altı kişilik örnekte beşinci yılda karşılaştırdı; burada ikisini gerçek veride, eğrinin tamamı boyunca karşılaştırıp seçimin raporlanan aralığı hangi yaşlarda değiştirdiğini ölçüyoruz. Bunun için aynı eğriyi "log" ile ikinci kez kuruyoruz.
fit_log <- survival::survfit(
  survival::Surv(time, event) ~ 1,
  data = veri,
  conf.type = "log"
)
fit_log
#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = veri,
#> conf.type = "log")
#>
#> n events median 0.95LCL 0.95UCL
#> [1,] 2000 134 81.6 80.8 85.7İki uyumun nokta tahminleri ve standart hataları birebir aynıdır, çünkü ikisi de aynı veriden aynı Kaplan–Meier ve Greenwood hesabını yapar; conf.type yalnız aralığın kurulduğu ölçeği değiştirir.
Medyan da iki çıktıda 81,6 yaştır, ama aralığı değişir: log-log’da 80,3–85,4, log’da 80,8–85,7.
Medyanın sınırları güven bandının alt ve üst sınır eğrilerinden okunur (Güven aralığı bölümünün 5. adımı); bant değişince onlar da değişir. Log-log’da iki sınırın da daha erken olmasının nedenini aşağıda, iki ölçeğin üslerini karşılaştırırken göreceğiz.
İki bölgeye bakıyoruz: Görev B’nin çeyreklikleri (risk kümesinin büyük olduğu yaşlar) ve riskteki kişi sayısının azaldığı kuyruk.
karsilastirma_yaslari <- c(ceyreklikler, 80, 85, 90, 95)
round(karsilastirma_yaslari, 2)
#> [1] 62.67 66.51 71.26 80.00 85.00 90.00 95.00Aralık genişliğini iki uyumdan da aynı biçimde okuyan küçük bir işlev yazıp iki uyumun genişliklerini, her yaşta riskte kalan kişi sayısıyla birlikte tek tabloya koyuyoruz. İşlev hangi yaşlarda okuyacağını argüman olarak alır; böylece her sütun tek satıra iner.
aralik_genisligi <- function(uyum, yaslar) {
  o <- summary(uyum, times = yaslar, extend = TRUE)
  o$upper - o$lower
}

gorev_c <- data.frame(
  yas             = round(karsilastirma_yaslari, 2),
  riskteki        = summary(fit_tam, times = karsilastirma_yaslari, extend = TRUE)$n.risk,
  loglog_genislik = round(aralik_genisligi(fit_tam, karsilastirma_yaslari), 4),
  log_genislik    = round(aralik_genisligi(fit_log, karsilastirma_yaslari), 4)
)
gorev_c
#> yas riskteki loglog_genislik log_genislik
#> 1 62.67 1500 0.0063 0.0056
#> 2 66.51 1000 0.0095 0.0089
#> 3 71.26 500 0.0293 0.0287
#> 4 80.00 64 0.1445 0.1452
#> 5 85.00 21 0.1898 0.1931
#> 6 90.00 5 0.2229 0.2465
#> 7 95.00 1 0.2140 0.3187İlk üç satır çeyreklikler, son dört satır kuyruktur. Çeyrekliklerde iki genişlik birbirine yakındır ve biraz daha geniş olan "log-log" aralığıdır: ilk çeyreklikte 0,0063’e karşı 0,0056.
Kuyrukta sıra değişir ve fark, riskteki kişi sayısı azaldıkça büyür: 80 yaşta (64 kişi) iki genişlik arasında 0,0007 vardır; son satırda, 95 yaşta (1 kişi), "log" aralığı "log-log" aralığından %49 daha geniştir: \(0{,}3187/0{,}2140=1{,}49\).
Farkın nereden geldiğini son satırda, 95 yaşta görelim. Gereken iki sayı, tahmin ve standart hatası, o yaşın özetinde durur:
print(summary(fit_tam, times = 95), digits = 4)#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = veri,
#> conf.type = "log-log")
#>
#> time n.risk n.event survival std.err lower 95% CI upper 95% CI
#> 95 1 133 0.06428 0.05376 0.006823 0.2208Tek bir yaş istendiği için n.event sütunu, Görev B’deki gibi iki istek arasındaki ölümleri değil, 0’dan 95 yaşa kadarki bütün ölümleri sayar: 133. Son ölüm 95,52 yaşındadır. Tahmin \(\widehat S=0{,}06428\), onun standart hatası 0,05376’dır.
Bu standart hata \(\widehat S\)’nin kendisinin standart hatasıdır (Güven aralığını kodla kurmak alt bölümü). Gövdenin Güven aralığı bölümündeki \(\sigma\), yani \(\log\widehat S\)’nin standart hatası, ikisinin oranıdır: \(\sigma=0{,}05376/0{,}06428=0{,}8363\) ve \(z\sigma=1{,}96\cdot0{,}8363=1{,}639\). Log-log’un \(c\)’si bunu \(|\log\widehat S|\)’ye böler: \(|\log0{,}06428|=2{,}745\) ve \(c=1{,}639/2{,}745=0{,}597\).
Log ölçeği tahmini yukarı \(e^{z\sigma}\) ile çarparak, aşağı aynı sayıya bölerek taşır. Log-log ise tahminin kuvvetini alır: alt sınır \(\widehat S^{e^{c}}\), üst sınır \(\widehat S^{e^{-c}}\)’dir. İkisini karşılaştırmak için log-log sınırlarını da \(\widehat S\,e^{u}\) biçiminde yazalım; \(u\)’ya çarpanın üssü diyoruz. Log’da üs yukarıda \(z\sigma\), aşağıda \(-z\sigma\)’dır. \(\widehat S\)’nin herhangi bir \(a\) kuvveti için:
\[ \begin{aligned} \widehat S^{a}&=e^{a\log\widehat S}\\ &=\widehat S\,e^{(a-1)\log\widehat S}\\ &=\widehat S\,e^{(1-a)|\log\widehat S|}. \end{aligned} \]
Eşitlikler sırasıyla:
Üst sınırda \(a=e^{-c}\), alt sınırda \(a=e^{c}\) konur. Log’un üssünü de \(c\)’nin tanımıyla, \(z\sigma=c\,|\log\widehat S|\) diye yazarsak üç sınır yan yana gelir:
\[ \begin{aligned} \text{log:}\ &\widehat S\,e^{\pm c|\log\widehat S|}\\ \text{log-log, üst:}\ &\widehat S\,e^{(1-e^{-c})|\log\widehat S|}\\ \text{log-log, alt:}\ &\widehat S\,e^{-(e^{c}-1)|\log\widehat S|} \end{aligned} \]
Log-log’un yukarı çarpanının üssü log’unkinden küçük, aşağı bölenin üssü ise büyüktür, çünkü her \(c>0\) için \(1-e^{-c}<c<e^{c}-1\)’dir. Soldaki eşitsizlik Nelson–Aalen tahmini bölümündeki \(1-x\le e^{-x}\)’in \(x=c\) hâlidir; sağdaki aynı bölümün 5. adımındaki açılımdan okunur: \(e^{c}-1=c+c^2/2+\cdots\) ve \(c>0\) iken bu toplam \(c\)’den büyüktür. Log-log bandı bu yüzden her yaşta log bandının altında durur: alt sınır eğrisi de üst sınır eğrisi de daha aşağıdadır. Medyanın log-log aralığının iki ucunun da daha erken çıkması (80,3 ve 85,4’e karşı 80,8 ve 85,7) bundandır. Bu kaymanın genişliğe etkisi üslerin büyüklüğüne bağlıdır.
95 yaşta üsler büyüktür. Yukarıdaki formüllere \(z\sigma\), \(c\) ve \(|\log\widehat S|\) konunca üsler ve çarpanlar şöyle çıkar. Çarpanlar üslerin küçük yuvarlama farklarına duyarlı olduğu için dört ondalıkla hesaplıyoruz: \(z\sigma=1{,}6394\), \(|\log\widehat S|=2{,}7446\) ve \(c=0{,}5973\).
Sınırlar tahminin bu çarpanlarla çarpımı ya da bölümüdür; örneğin log’un üst sınırı \(0{,}06428\cdot5{,}15=0{,}331\), log-log’un alt sınırı \(0{,}06428/9{,}42=0{,}0068\)’dir:
| Ölçek | Yukarı çarpan | Aşağı bölen | Alt sınır | Üst sınır |
|---|---|---|---|---|
"log" |
5,15 | 5,15 | 0,0125 | 0,331 |
"log-log" |
3,44 | 9,42 | 0,0068 | 0,221 |
Alt sınır 0’ın altına inemez; bu yüzden alt sınırın tahmine uzaklığı en çok tahminin kendisi, 0,064 kadardır. Log’da bu uzaklık \(0{,}0643-0{,}0125=0{,}0518\), log-log’da \(0{,}0643-0{,}0068=0{,}0575\)’tir: 5,15 yerine 9,42’ye bölmek alt sınırı yalnız 0,0057 daha aşağı taşır.
Üst sınırın tahmine uzaklığını ise yalnız olasılığın en büyük değeri olan 1 kısıtlar; o da 0,064’lük tahminden çok uzaktadır. Log’da bu uzaklık \(0{,}331-0{,}0643=0{,}2667\), log-log’da \(0{,}221-0{,}0643=0{,}1567\)’dir: 5,15 yerine 3,44 ile çarpmak üst sınırı 0,110 aşağı taşır. Üst sınırdaki bu kayma alt sınırdakinden çok büyük olduğu için log-log aralığı kuyrukta daha dardır; Görev C tablosunda 95 yaşta 0,2140’a karşı 0,3187.
Çeyrekliklerde üsler küçüktür. İlk çeyreklikte (62,67 yaş) Görev B’nin özetindeki tahmin 0,9965, standart hatası 0,00144’tür: \(\sigma=0{,}00144/0{,}9965=0{,}00145\) ve \(z\sigma=1{,}96\cdot0{,}00145=0{,}0028\).
Üs bu kadar küçükken \(e^{u}\approx1+u\)’dur. Yukarı üsse \(u_{\text{üst}}\), aşağı üsse \(u_{\text{alt}}\) dersek üst sınır yaklaşık \(\widehat S\,(1+u_{\text{üst}})\), alt sınır \(\widehat S\,(1-u_{\text{alt}})\) olur ve genişlik kabaca \(\widehat S\,(u_{\text{üst}}+u_{\text{alt}})\)’dir. İki üssün toplamı log’da \(2c|\log\widehat S|\), log-log’da \((e^{c}-e^{-c})|\log\widehat S|\)’dir.
\(c\) ise burada küçük değildir: \(|\log0{,}9965|=0{,}0035\) ve \(c=0{,}0028/0{,}0035=0{,}80\). \(e^{0{,}80}-e^{-0{,}80}=1{,}78\) ve \(2\cdot0{,}80=1{,}60\); log-log’un toplamı yaklaşık \(1{,}78/1{,}60=1{,}11\) kat büyüktür. Log-log aralığı orada bu yüzden biraz daha geniştir (0,0063’e karşı 0,0056).
Görevin yanıtı şudur: iki ölçek risk kümesi yüzlerce kişiyken birbirine yakın aralıklar verir ve risk kümesi birkaç kişiye inince ayrışır. Hangisinin raporlanacağına genişlik karar vermez: dar bir aralık, olmayan bir kesinliği de gösterebilir. "log-log" ölçeğini seçmemizin nedeni başkadır: sınırları her zaman 0 ile 1 arasında kalır. "log" ölçeğinin üst sınırı ise 1’i aşabilir ve paket onu 1’de keser; gövdedeki altı kişilik örnekte beşinci yılda böyle olmuştu (1,1842). Bu tablodaki yaşlarda böyle bir kesilme olmuyor; aradaki farkı yukarıdaki iki üs çifti açıklar.
Gövde Kaplan–Meier ile \(\exp(-\widehat H)\)’yi altı kişide karşılaştırdı ve hangisinin raporlandığını yazmamızı istedi (Nelson–Aalen tahmini). Görevin sorusu şudur: 2.000 kişilik gerçek veride bu seçim raporlanan sağkalım olasılığını hangi yaşlarda ve ne kadar değiştirir? Yanıt, tahmin edicinin adını yazmanın bir raporlama kuralı mı, yoksa sayıyı değiştiren bir karar mı olduğunu söyler. İki tahmini eğrinin her noktasında yan yana koyuyoruz.
gorev_d <- data.frame(
  yas    = fit_tam$time,
  km     = fit_tam$surv,
  exp_na = exp(-fit_tam$cumhaz)
)
gorev_d$fark <- gorev_d$km - gorev_d$exp_na
head(gorev_d)
#> yas km exp_na fark
#> 1 24.3498 1 1 0
#> 2 31.1271 1 1 0
#> 3 35.9851 1 1 0
#> 4 37.0329 1 1 0
#> 5 37.1271 1 1 0
#> 6 38.1338 1 1 0fit_tam$time yalnız ölüm yaşlarını değil, verideki 1.804 farklı yaşın hepsini taşır; ilk satırlar genç yaşlardaki sansürlerdir. İlk ölümden önce iki tahmin de tam 1’dir: çarpılacak ya da toplanacak bir \(d_j/n_j\) yoktur, boş çarpım 1, boş toplam 0’dır ve \(e^{0}=1\).
Farkın en büyük olduğu yeri ve yönünü üç sonuçta toplayalım.
gorev_d_ozet <- list(
  en_buyuk_fark = round(max(abs(gorev_d$fark)), 4),
  nerede        = round(gorev_d$yas[which.max(abs(gorev_d$fark))], 2),
  km_hep_kucuk  = all(gorev_d$km <= gorev_d$exp_na)
)
gorev_d_ozet
#> $en_buyuk_fark
#> [1] 0.0315
#>
#> $nerede
#> [1] 95.52
#>
#> $km_hep_kucuk
#> [1] TRUEwhich.max(abs(gorev_d$fark)) — en büyük mutlak farkın konumunu döndürür, değerini değil; o konumu yas sütununa uygulayınca farkın nerede ortaya çıktığı okunur.list(...) — üç sonucu kendi türleriyle bir arada tutar: iki sayı ve bir mantıksal değer. Bir c() vektörüne konsalardı TRUE sayıya çevrilir ve 1 diye basılırdı.En büyük mutlak fark 0,0315 ve tam olarak eğrinin sonunda, 95,52 yaşında ortaya çıkıyor; km_hep_kucuk TRUE olmalıdır. Farkın neden en sonda en büyük olduğunu görevin sonunda, son ölümde göreceğiz.
Farkın yönü veriye bağlı değildir: \(1-x\le e^{-x}\) olduğundan Kaplan–Meier her adımda \(\exp(-\widehat H)\)’nin altında ya da ona eşit kalır (Nelson–Aalen tahmini). Büyüklüğü ise riskteki kişi sayısına bağlıdır; farkı bu yüzden Görev C’nin yaşlarında, riskteki kişi sayısının yanında okuyoruz.
gorev_d_yaslarda <- data.frame(
  yas      = round(karsilastirma_yaslari, 2),
  riskteki = gorev_c$riskteki,
  km       = summary(fit_tam, times = karsilastirma_yaslari, extend = TRUE)$surv,
  exp_na   = exp(-summary(fit_tam, times = karsilastirma_yaslari, extend = TRUE)$cumhaz)
)
gorev_d_yaslarda$fark <- gorev_d_yaslarda$km - gorev_d_yaslarda$exp_na
round(gorev_d_yaslarda, 4)
#> yas riskteki km exp_na fark
#> 1 62.67 1500 0.9965 0.9965 0.0000
#> 2 66.51 1000 0.9930 0.9930 0.0000
#> 3 71.26 500 0.9598 0.9598 0.0000
#> 4 80.00 64 0.6049 0.6062 -0.0013
#> 5 85.00 21 0.4374 0.4403 -0.0028
#> 6 90.00 5 0.1714 0.1813 -0.0099
#> 7 95.00 1 0.0643 0.0856 -0.0214summary(...)$cumhaz — özetteki Nelson–Aalen kümülatif hazardıdır, yani fit_tam$cumhaz’ın istenen yaşlardaki değeri.Riskte yüzlerce kişi varken iki tahmin ayırt edilemez: mutlak fark 71,26 yaşa kadar dördüncü ondalıkta görünmez. 80 yaşta (64 kişi) 0,0013, 90 yaşta (5 kişi) 0,0099, 95 yaşta (1 kişi) 0,0214’tür.
Eğri farkının kuyrukta büyümesinin nedeni iki çarpan arasındaki farktır: Kaplan–Meier eğriyi \(1-x\) ile, \(\exp(-\widehat H)\) ise \(e^{-x}\) ile çarpar. Tek ölümlü bir adımda (\(x=1/n_j\)) bu çarpan farkı, Nelson–Aalen tahmini bölümündeki açılımla
\[ e^{-x}-(1-x)\approx\frac{x^2}{2}=\frac{1}{2n_j^2} \]
kadardır: riskteki kişi sayısının karesiyle küçülür. 1.500 kişi riskteyken çarpan farkı \(2{,}2\cdot10^{-7}\), 64 kişi riskteyken \(1{,}2\cdot10^{-4}\)’tür.
Tablodaki eğri farkı ise tek bir çarpanın değil, o yaşa kadarki bütün ölüm yaşlarının çarpan farklarının birikimidir: her ölüm yaşı Kaplan–Meier’i \(\exp(-\widehat H)\)’ye göre yaklaşık \(x_j^2/2\) oranında daha çok indirir. 80 yaşına kadar 104 ölüm yaşı vardır ve bu oranların toplamı 0,0021’dir: \(0{,}6062\cdot0{,}0021=0{,}0013\), tablodaki 80 yaş farkı. Riskte yüzlerce kişi varken bu toplam dördüncü ondalığa ulaşmaz; fark ancak kuyrukta, riskte birkaç kişi kalınca birikir.
En büyük fark son ölümdedir: 95 yaşta riskte tek kişi kalmıştır ve o kişi 95,52 yaşında ölür (\(x=1\)). Kaplan–Meier’in çarpanı \(1-x=0\)’dır ve eğri 0’a iner; \(\exp(-\widehat H)\) ise yalnız \(e^{-1}\) ile çarpılır, bu yüzden son noktadaki fark \(\exp(-\widehat H)\)’nin o noktadaki değerinin kendisidir. Gövdenin altı kişilik örneğinde 8 zamanında olan da buydu.
Sayıyla: 95 yaşta \(\exp(-\widehat H)=0{,}0856\)’dır (gorev_d_yaslarda tablosunun son satırı) ve son ölüm onu \(e^{-1}=0{,}3679\) ile çarpar: \(0{,}0856\cdot0{,}3679=0{,}0315\). Görevin başındaki en büyük fark budur.
Görev D’nin yanıtı şudur: risk kümesi büyük olduğu sürece tahmin edici seçimi raporlanan sağkalım olasılığını değiştirmez, kuyrukta değiştirir. Ama kuyrukta bile fark, Görev C’deki log-log aralığının genişliğinin en çok onda biri kadardır (95 yaşta 0,0214’e karşı 0,2140): orada sayıyı belirsiz kılan, tahmin edici seçiminden çok birkaç kişiye dayanan tahminin kendisidir. Hangi tahmin edicinin kullanıldığı yine yazılır, çünkü kuyrukta iki sayı aynı değildir.
Bu haftanın tek cümlelik özeti şudur: sansürlü gözlem olay değildir; bu dosyada olay ölüm olduğu için sansürlü kişi ölmüş sayılamaz. Görevin sorusu şudur: sansürü olay saymak medyanı hangi yöne ve ne kadar kaydırır? Hata sessizdir, yanlış eğri de düzgün görünür ve paket uyarı vermez; yanıt bu yüzden bir sağkalım analizinin hangi otomatik denetimi taşıması gerektiğini belirler. Bütün event değerlerini 1 yaparak bilerek yanlış bir eğri kuruyoruz.
yanlis_fit <- survival::survfit(
  survival::Surv(time, rep(1L, nrow(veri))) ~ 1,
  data = veri
)
yanlis_fit
#> Call: survfit(formula = survival::Surv(time, rep(1L, nrow(veri))) ~
#> 1, data = veri)
#>
#> n events median 0.95LCL 0.95UCL
#> [1,] 2000 2000 66.5 66.2 66.9rep(1L, nrow(veri)) — event sütununun yerine, her satırı olay sayan bir vektör koyar; survival::Surv() olay göstergesinde 1’i olay, 0’ı sansür okur. 1L, tamsayı olarak yazılmış 1’dir; 1 yazmak da aynı eğriyi verir. Doğru ve yanlış eğriyi medyanları ve olay sayılarıyla yan yana koyuyoruz.
gorev_e <- c(
  dogru_medyan  = unname(summary(fit_tam)$table["median"]),
  yanlis_medyan = unname(summary(yanlis_fit)$table["median"]),
  olay_dogru    = sum(veri$event),
  olay_yanlis   = nrow(veri)
)
round(gorev_e, 2)
#> dogru_medyan yanlis_medyan olay_dogru olay_yanlis
#> 81.61 66.51 134.00 2000.00summary(fit_tam)$table["median"] — uyumun özet tablosundan yalnızca medyan değerini, median adıyla birlikte çeker; unname() bu adı siler. Yazılmazsa: c() iki adı birleştirir ve çıktıda dogru_medyan yerine dogru_medyan.median yazar. Sansürü doğru kodlayan eğrinin medyanı 81,61, yanlış eğrininki 66,51 çıkmalıdır: yanlış analiz medyanı 15,1 yıl aşağı çekiyor ve olay sayısını 134’ten 2.000’e taşıyor.
Yanlış eğrinin çıktısında medyanın aralığı da dardır: 66,2–66,9, doğru eğrinin 80,3–85,4’üne karşı. 2.000 sahte ölüm, Görev C’nin sözünü ettiği türden, gerçekte olmayan bir kesinlik üretir.
Sansürü doğru kodlayan eğri de sözlüğün yanıtlayamaz kutusundaki iki kusuru taşır; bu karşılaştırma yalnızca sansür kodlamasının etkisini ölçer.
Kaymanın yönü rastlantı değildir: her satırı olay saymak riskteki kişi sayılarını (\(n_j\)) değiştirmez, yalnız ölüm sayılarını (\(d_j\)) büyütür. Hiçbir \(1-d_j/n_j\) çarpanı büyüyemediği için yanlış eğri her yaşta doğrunun altında ya da ona eşit kalır ve medyanı doğrununkinden büyük olamaz; Alıştırma 3 bunu küçük bir örnekte elle gösterir.
Kaymanın bu kadar büyük olmasının nedeni time sütunudur. Her satır olay sayılınca hiç sansür kalmaz ve bir ölüm yaşında riskten çıkanlar yalnız o yaşta ölenlerdir: \(n_{j+1}=n_j-d_j\), yani \(1-d_j/n_j=n_{j+1}/n_j\). Çarpımın ardışık terimleri sadeleşir ve eğrinin \(t\) yaşındaki değeri, time’ı \(t\)’den büyük satırların 2.000’e oranı olur: time’ın sıradan örneklem dağılımı. survival paketiyle doğrulama bölümündeki orta nokta kuralıyla medyanı da time’ın sıradan medyanı olur; Görev B’nin ortadaki çeyrekliği bu yüzden aynı sayıyı, 66,51’i basar.
Oysa time sansürlü 1.866 satırda ölüm yaşı değil, gözleme giriş yaşıdır (ortalaması 66,05; Görev A) ve örneklemin %93’ü sansürlüdür: yanlış eğrinin medyanı, büyük çoğunluğu giriş yaşı olan bir sütunun medyanıdır.
Otomatik denetim ihtiyacı tam olarak buradan gelir: gözle bakarak fark edilmeyen bu hata, uyumun kendi sansür sayısına bakan tek satırlık bir denetimle yakalanır. Bu denetimin bir zayıflığını ve daha güvenilir biçimini bloğun ardından göreceğiz.
sansur_denetimi <- c(
  dogru_uyum  = sum(fit_tam$n.censor) > 0,
  yanlis_uyum = sum(yanlis_fit$n.censor) > 0
)
sansur_denetimi
#> dogru_uyum yanlis_uyum
#> TRUE FALSEDoğru uyumda en az bir sansürlü gözlem vardır, yanlış uyumda hiç yoktur. stopifnot(sum(uyum$n.censor) > 0), uyum yerine denetlenen uyumun adı yazılınca, doğru uyumda sessizce geçer, yanlış uyumda analizi durdururdu; sayfayı durdurmamak için burada denetimin vereceği sonucu yazdırıyoruz.
Denetim veriye değil uyuma bakar, çünkü hata veride değildir: iki analiz de aynı veriyi kullandığı için gövdenin veri_kontrol’ündeki sansur_var ikisinde de TRUE verir. n.censor denetiminin bir zayıflığı vardır: hiç sansür içermeyen bir veride doğru kurulmuş bir uyumu da durdurur. Daha güvenilir biçim uyumun olay sayısını veridekiyle karşılaştırır, sum(uyum$n.event) == sum(veri$event): fit_tam’da 134’e 134, yanlis_fit’te 2.000’e 134.
Görev E’nin yanıtı şudur: sansürü olay saymak medyanı hiçbir veride yukarı taşıyamaz, bu dosyada 15,1 yıl aşağı çeker. Eğri de paket de hatayı göstermediği için bir sağkalım analizi, uyumun olay sayısını veridekiyle karşılaştıran denetimi taşımalıdır.
Aşağıdaki alıştırmalar risk kümesi, Kaplan–Meier ve Nelson–Aalen hesaplarını küçük tablolar üzerinde pekiştirmek içindir. Önce kendi çözümünüzü kâğıt üzerinde üretin, ardından her kutudaki Çözümü göster düğmesiyle karşılaştırın. Bir alıştırma gövdedeki ya da laboratuvardaki bir tabloya dayanıyorsa, o tablo alıştırmanın içinde yeniden verilmiştir; geri dönüp aramanız gerekmez. Bazı çözümlerdeki bloklar gövdenin ve laboratuvarın nesnelerini (veri, fit_tam) kullanır. Yıldızlı (★) alıştırma daha fazla yorum gerektirir.
Alıştırma 1 (Risk kümesi ve bağlı gözlemler). Yedi poliçe için gözlenen süre (yıl) ve olay göstergesi aşağıdadır. Burada olay, hasar dosyasının kapanmasıdır.
| Poliçe | time |
event |
Açıklama |
|---|---|---|---|
| 1 | 1 | 1 | Olay |
| 2 | 4 | 1 | Olay |
| 3 | 4 | 1 | Olay |
| 4 | 4 | 0 | Sansür |
| 5 | 6 | 0 | Sansür |
| 6 | 9 | 1 | Olay |
| 7 | 9 | 0 | Sansür |
(a) Olay zamanları 1, 4 ve 9’dur. Risk kümesi bölümündeki kurala göre riskte olmak \(\text{time}\ge t_j\) demektir; \(n_j\) bu koşulu sağlayan poliçeleri sayar:
| \(t_j\) | Riskteki poliçeler | \(n_j\) | \(d_j\) | \(1-d_j/n_j\) |
|---|---|---|---|---|
| 1 | 1–7 | 7 | 1 | 6/7 |
| 4 | 2–7 | 6 | 2 | 4/6 |
| 9 | 6, 7 | 2 | 1 | 1/2 |
4 zamanında iki olay ve bir sansür aynı andadır. Risk kümesi bölümündeki kurala göre tam o anda sansürlenen poliçe de o anın risk kümesindedir. Payda bu yüzden süresi en az 4 olan altı poliçedir (2–7): o anda kapanan 2. ve 3. poliçeler, o anda sansürlenen 4. poliçe ve sonra çıkan 5., 6. ve 7. poliçeler. Sansürlenen 4. poliçe yalnızca sonraki risk kümelerinden düşer.
(b) Kaplan–Meier ardışık çarpımdır:
\[ \widehat S(1)=1-\frac{1}{7}=\frac{6}{7}=0{,}8571, \]
\[ \widehat S(4)=\frac{6}{7}\left(1-\frac{2}{6}\right) =\frac{6}{7}\cdot\frac{2}{3}=\frac{4}{7}=0{,}5714, \]
\[ \widehat S(9)=\frac{4}{7}\left(1-\frac{1}{2}\right)=\frac{2}{7}=0{,}2857. \]
(c) Sansür \(d_j\)’yi artırmaz, bu yüzden eğri 6 zamanında yatay kalır. Değiştirdiği sayı paydadır: 5. poliçe 6 zamanında gözlemden çıktığı için 9 zamanındaki risk kümesi 3 değil 2 kişidir. Sansür bilgisi kaybolmaz: 5. poliçe 6’ya kadar olaysız izlendiği için 1 ve 4 zamanlarındaki risk kümelerinde (7 ve 6 poliçe) sayılmıştır.
(d) En büyük gözlenen süre olan 9’da hem bir olay hem bir sansür vardır. \(n_j=2\) ve \(d_j=1\) olduğu için çarpan \(1/2\)’dir ve tahmin \(2/7=0{,}2857\) düzeyinde durur. En büyük gözlemlerden biri sansürlü olduğunda Kaplan–Meier sıfıra inmez; 9’dan sonrası için tahmin tanımsızdır.
Aynı tabloyu açık R koduyla da kurabiliriz. Önce poliçelerin süresini ve olay göstergesini bir veri çerçevesine yazalım:
alistirma_veri <- data.frame(
  time = c(1, 4, 4, 4, 6, 9, 9),
  event = c(1, 1, 1, 0, 0, 1, 0)
)

alistirma_veri
#> time event
#> 1 1 1
#> 2 4 1
#> 3 4 1
#> 4 4 0
#> 5 6 0
#> 6 9 1
#> 7 9 0Çıktıdaki satırların alıştırmanın tablosundaki time ve event sütunlarıyla aynı sırada olması gerekir.
Şimdi olayın gözlendiği ayrı zamanları sıralayalım; risk tablosunun satırları bunlardan doğar:
olay_zamani <- sort(unique(alistirma_veri$time[alistirma_veri$event == 1]))

olay_zamani
#> [1] 1 4 9Bu zamanların her biri için riskteki poliçe sayısını ve o anda kapanan dosya sayısını sayıyoruz; çıktıdaki n_risk ve n_event sütunları (a) şıkkındaki \(n_j\) ve \(d_j\) değerleridir:
alistirma_risk <- data.frame(
  time = olay_zamani,
  n_risk = vapply(
    olay_zamani,
    function(t) sum(alistirma_veri$time >= t),
    numeric(1)
  ),
  n_event = vapply(
    olay_zamani,
    function(t) sum(alistirma_veri$time == t & alistirma_veri$event == 1),
    numeric(1)
  )
)

alistirma_risk
#> time n_risk n_event
#> 1 1 7 1
#> 2 4 6 2
#> 3 9 2 1Son olarak ardışık çarpımı km_manual sütunu olarak ekliyoruz; bu sütunun (b) şıkkında elle bulduğumuz değerleri vermesi gerekir:
alistirma_risk$km_manual <-
  cumprod(1 - alistirma_risk$n_event / alistirma_risk$n_risk)
alistirma_risk
#> time n_risk n_event km_manual
#> 1 1 7 1 0.8571429
#> 2 4 6 2 0.5714286
#> 3 9 2 1 0.2857143Paket doğrulamasını ayrı bir kod bloğunda yapıyoruz. Önce aynı veriye paketin kendi uyumunu kuralım:
alistirma_fit <- survival::survfit(
  survival::Surv(time, event) ~ 1,
  data = alistirma_veri
)

alistirma_fit
#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = alistirma_veri)
#>
#> n events median 0.95LCL 0.95UCL
#> [1,] 7 4 9 4 NAPaket nesnesi sansür zamanlarını da satır olarak taşıdığı için, karşılaştırmadan önce yalnızca olay satırlarını işaretliyoruz:
olay_satiri_al <- alistirma_fit$n.event > 0

olay_satiri_al
#> [1] TRUE TRUE FALSE TRUEŞimdi elle kurduğumuz km_manual sütunu ile paketin aynı satırlardaki sağkalım değerlerini karşılaştırıyoruz:
alistirma_1_kontrol <- isTRUE(all.equal(
  alistirma_risk$km_manual,
  alistirma_fit$surv[olay_satiri_al]
))
stopifnot(alistirma_1_kontrol)
alistirma_1_kontrol
#> [1] TRUESonucun TRUE olması beklenir. FALSE görülürse sırasıyla olay kodlaması, risk kümesi tanımı, aynı zamandaki olay–sansür sırası ve yalnız olay satırlarının seçilip seçilmediği denetlenmelidir.
Alıştırma 2 (Nelson–Aalen ve \(e^{-\widehat H}\)). Beş kişilik küçük bir izlemde gözlenen süreler (yıl) ve olay göstergeleri şöyledir:
| Kişi | time |
event |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 1 |
| 3 | 2 | 1 |
| 4 | 3 | 0 |
| 5 | 4 | 1 |
(a) Olay zamanları 1, 2 ve 4’tür. Riskteki kişiler yine \(\text{time}\ge t_j\) koşulunu sağlayanlardır:
| \(t_j\) | Riskteki kişiler | \(n_j\) | \(d_j\) | \(d_j/n_j\) | \(\widehat H(t_j)\) |
|---|---|---|---|---|---|
| 1 | 1–5 | 5 | 1 | 0,20 | 0,20 |
| 2 | 2–5 | 4 | 2 | 0,50 | 0,70 |
| 4 | 5 | 1 | 1 | 1,00 | 1,70 |
\(\widehat H\) sütunu, her olay zamanında \(d_j/n_j\)’yi bir öncekine ekler (Nelson–Aalen tahmini):
\[ \widehat H(4)=\frac{1}{5}+\frac{2}{4}+\frac{1}{1}=1{,}70. \]
3 zamanındaki sansür bir olay üretmez; yalnızca 4 zamanındaki paydayı 2’den 1’e indirir.
(b) Kaplan–Meier çarpımı \((1-0{,}20)\), sonra \((1-0{,}50)\), sonra \((1-1{,}00)\) çarpanlarını uygular:
| \(t\) | \(\widehat S_{KM}(t)\) | \(\exp[-\widehat H(t)]\) |
|---|---|---|
| 1 | 0,8000 | 0,8187 |
| 2 | 0,4000 | 0,4966 |
| 4 | 0,0000 | 0,1827 |
(c) Hayır. \(\widehat H\), her olay zamanındaki \(d_j/n_j\) oranlarının toplamıdır; zaman birimi taşımaz, ne bir hız ne de bir olasılıktır. Burada 1’i aşarak 1,70 olmuştur; bir olasılık 1’i aşamaz.
İki tahmin edici her olay zamanında farklı bir çarpan uygular: Kaplan–Meier \(1-d_j/n_j\), \(\exp(-\widehat H)\) ise \(e^{-d_j/n_j}\). \(d_j/n_j=0{,}20\)’de çarpanlar 0,8000 ile 0,8187, \(0{,}50\)’de 0,5000 ile 0,6065’tir; birbirine yakındır. 4 zamanında risk kümesinde tek kişi kaldığı için \(d_j/n_j=1\)’dir: Kaplan–Meier’in çarpanı \(1-1=0\) olur ve tahmin sıfıra iner, öbür çarpan \(e^{-1}=0{,}3679\)’dur ve \(\exp[-\widehat H(4)]\) \(=0{,}4966\cdot0{,}3679\) \(=0{,}1827\) verir.
İki tahmin edici büyük örneklemde birbirine yakınsar, fakat küçük risk kümelerinde aynı sayı değildir; Nelson–Aalen tahmini bölümünde uyarıldığı gibi ikisi zorla eşitlenmemelidir.
Laboratuvarın Görev D’si aynı karşılaştırmayı ders verisinin bütün eğrisi boyunca yapmıştı. İki veri yan yana:
| Veri | En büyük fark | Nerede | \(\widehat S_{KM}\le\exp[-\widehat H]\) her adımda |
|---|---|---|---|
| bu alıştırmanın beş kişisi | 0,1827 | \(t=4\) | evet |
canlifins_sample.csv, 2.000 kişi |
0,0315 | 95,52 yaş, eğrinin sonu | evet |
Fark ikisinde de risk kümesinin en küçük olduğu yerde, eğrinin sonunda en büyüktür; 2.000 kişilik veride bile sıfır değildir.
Alıştırma 3 (Sansürü yanlış işlemenin yönü). Sekiz kişilik bir izlemde süreler (yıl) ve olay göstergeleri aşağıdadır:
| Kişi | time |
event |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 0 |
| 3 | 3 | 1 |
| 4 | 5 | 0 |
| 5 | 6 | 1 |
| 6 | 7 | 0 |
| 7 | 8 | 0 |
| 8 | 10 | 1 |
Laboratuvarın Görev E’si bu hatalardan birini, her satırı olay saymayı, ders verisinde bilerek yapmıştı:
| Eğri | Olay sayısı | Medyan (yaş) |
|---|---|---|
| sansür doğru kodlanmış | 134 | 81,61 |
| her satır olay sayılmış | 2.000 | 66,51 |
(a) Olay zamanları 1, 3, 6 ve 10’dur. 6 zamanına kadar olan risk tablosu:
| \(t_j\) | Riskteki kişiler | \(n_j\) | \(d_j\) | \(1-d_j/n_j\) |
|---|---|---|---|---|
| 1 | 1–8 | 8 | 1 | 7/8 |
| 3 | 3–8 | 6 | 1 | 5/6 |
| 6 | 5–8 | 4 | 1 | 3/4 |
\[ \widehat S(6)=\frac{7}{8}\cdot\frac{5}{6}\cdot\frac{3}{4} =\frac{35}{64}=0{,}5469. \]
(b) Dört sansürlü satır silinince geriye yalnızca 1, 3, 6 ve 10 zamanlı dört olay kalır. Paydalar 4, 3 ve 2’ye iner:
\[ \frac{3}{4}\cdot\frac{2}{3}\cdot\frac{1}{2}=\frac{1}{4}=0{,}2500. \]
(c) Sekiz satırın hepsi olay sayılırsa eğri her gözlemde düşer:
\[ \frac{7}{8}\cdot\frac{6}{7}\cdot\frac{5}{6}\cdot\frac{4}{5}\cdot\frac{3}{4} =\frac{3}{8}=0{,}3750. \]
(d) Doğru tahmin 0,5469 iken iki hatalı yol da tahmini aşağı çekmiştir: sansürlüleri silmek 0,2500, hepsini olay saymak 0,3750 verir. Sansürlü kişiyi olay saymak gerçekleşmemiş olaylar üretir; sansürlü kişiyi silmek ise onu, sansürlendiği ana kadarki olay zamanlarının paydalarından çıkarır. Gerçek veride de yön aynıdır: sansürü olay saymak medyanı 81,6 yaştan 66,5 yaşa indirir; 2.000 gözlemin 1.866’sı sansürlü olduğu için kayma bu kadar büyüktür.
Bu yön rastlantı değildir, her veride aynıdır. Kaplan–Meier çarpanı \(1-d_j/n_j\)’dir:
İkisinde de hiçbir çarpan büyüyemez, bu yüzden eğri ya aşağı iner ya da yerinde kalır. Veriden veriye değişen yalnızca sapmanın büyüklüğüdür; neye bağlı olduğunu Alıştırma 12 gösteriyor. İki hata da uyarı vermez ve eğri düzgün görünür; bu yüzden, laboratuvarın Görev E’sindeki gibi, denetim veriye değil uyuma konur. Uyumun olay sayısını verideki olay sayısıyla karşılaştıran stopifnot(sum(uyum$n.event) == sum(veri$event)) sansürlüyü olay saymayı yakalar. Sansürlüyü silmeyi ise uyumun gözlem sayısını dosyadan okunan satır sayısıyla karşılaştıran denetim yakalar (Alıştırma 12).
Üç yolu tek bir kod bloğunda karşılaştıralım:
sansur_veri <- data.frame(
  time = c(1, 2, 3, 5, 6, 7, 8, 10),
  event = c(1, 0, 1, 0, 1, 0, 0, 1)
)

s_alti <- function(veri_cercevesi) {
  uyum <- survival::survfit(
    survival::Surv(time, event) ~ 1,
    data = veri_cercevesi
  )
  summary(uyum, times = 6)$surv
}

c(
  dogru = s_alti(sansur_veri),
  sansurluler_silindi = s_alti(sansur_veri[sansur_veri$event == 1, ]),
  hepsi_olay = s_alti(transform(sansur_veri, event = 1))
)
#> dogru sansurluler_silindi hepsi_olay
#> 0.546875 0.250000 0.375000Üç değer (a), (b) ve (c)’deki 0,5469; 0,2500 ve 0,3750 olmalıdır.
transform(sansur_veri, event = 1) — veri çerçevesinin bir kopyasını döndürür ve adı verilen sütunu yalnız o kopyada değiştirir. Üç satırın aynı sansur_veri’den başlayabilmesi bundandır: sansur_veri çağrıdan sonra da özgün olay kodlamasını taşır.Alıştırma 4 (Risk kümesi küçülünce belirsizlik). Dersin canlifins_sample.csv dosyasında 2.000 gözlem ve 134 olay vardır. conf.type = "log-log" ile kurulan tam örneklem eğrisinde (fit_tam, cinsiyete bölünmemiş tek eğri) seçilmiş iki ulaşılmış yaşta şu değerler okunur:
| Ulaşılmış yaş | Riskteki kişi | \(\widehat S\) | %95 alt | %95 üst |
|---|---|---|---|---|
| 70 | 611 | 0,9746 | 0,9620 | 0,9830 |
| 90 | 5 | 0,1714 | 0,0761 | 0,2990 |
(a) Sansürlü gözlem sayısı \(2.000-134=1.866\)’dır:
\[ \frac{1.866}{2.000}=0{,}933 \quad (\%93{,}3). \]
Veri ağırlıklı biçimde sansürlüdür. Satır sayısı 2.000 olsa da bütün belirsizlik yalnızca 134 olaydan gelir; “n büyük, o hâlde tahmin kesindir” denemez.
(b) Genişlikler ve oranları:
\[ \begin{aligned} 0{,}9830-0{,}9620&=0{,}021,\\ 0{,}2990-0{,}0761&=0{,}223,\\ 0{,}223/0{,}021&\approx10{,}6. \end{aligned} \]
90 yaşındaki aralık yaklaşık on kat geniştir. Nedeni standart hatanın iki çarpanıdır (Güven aralığı bölümü): tahminin standart hatası \(\widehat S(t)\,\sigma(t)\)’dir. \(\sigma(t)\), \(\log\widehat S(t)\)’nin standart hatasıdır ve karesi Greenwood toplamıdır:
\[ \sigma(t)^2=\sum_{t_j\le t}\frac{d_j}{n_j(n_j-d_j)}. \]
Birinci çarpan \(\widehat S(t)\) tahminin kendisidir. İkincisi \(\sigma(t)\) risk kümelerine bağlıdır, çünkü toplamın her terimi \(n_j\) küçüldükçe büyür. İki yaştaki standart hatayı paketin özeti verir.
print(summary(fit_tam, times = c(70, 90)), digits = 4)#> Call: survfit(formula = survival::Surv(time, event) ~ 1, data = veri,
#> conf.type = "log-log")
#>
#> time n.risk n.event survival std.err lower 95% CI upper 95% CI
#> 70 611 25 0.9746 0.005239 0.96197 0.983
#> 90 5 106 0.1714 0.058445 0.07606 0.299\(\sigma\), Görev C’deki gibi standart hatanın tahmine oranıdır:
| Yaş | Riskteki | \(\widehat S\) | Standart hata | \(\sigma\) |
|---|---|---|---|---|
| 70 | 611 | 0,9746 | 0,005239 | 0,00538 |
| 90 | 5 | 0,1714 | 0,058445 | 0,341 |
| 90’ın 70’e oranı | 0,176 | 11,2 | 63,4 |
70 ile 90 arasında risk kümesi 611 kişiden 5 kişiye iner ve Greenwood toplamına eklenen terimler büyür: \(\sigma\) 63,4 katına çıkar. Tahminin 0,9746’dan 0,1714’e inmesi bunu 0,176 ile çarpar ve standart hata \(63{,}4\cdot0{,}176\) \(=11{,}2\) katına çıkar. Log-log aralığı simetrik olmadığından genişlik oranı bundan biraz farklıdır (10,6). Başlıca etken bu yüzden risk kümesidir; tahminin küçülmesi onu yalnız kısmen dengeler.
(c) Hayır. Nokta tahmin 0,1714 (\(\approx 1/6\)) olsa da %95 aralık 0,0761 ile 0,2990 arasındadır; veriyle uyumlu değerler kabaca %8 ile %30 arasında değişir.
Beş kişilik bir risk kümesinde tek bir ek ölüm eğriyi \(1-1/5\) ile çarpar: \(0{,}1714\cdot0{,}8=0{,}1371\), beşte bir düşüş. Bu tahmin raporlanırken nokta değerle birlikte riskteki kişi sayısı ve güven aralığı mutlaka verilmelidir.
Nokta tahminin kendisi de bir nüfus olasılığı diye okunamaz: bu eğri sözlüğün yanıtlayamaz kutusundaki iki kusuru taşır ve hangisinin 90 yaşta ağır bastığı bu hafta ölçülmüyor.
Alıştırma 5 (★ Ham oran, eğri ve nedensellik). Aynı ders verisinde cinsiyete göre özet aşağıdadır:
| Cinsiyet | Gözlem | Olay | Ham olay oranı | Kaplan–Meier medyanı |
%95 aralık |
|---|---|---|---|---|---|
| Kadın | 1.021 | 49 | %4,80 | 82,1 | 80,3 – 86,5 |
| Erkek | 979 | 85 | %8,68 | 81,5 | 79,5 – 85,4 |
Tablodaki medyanlar bir ondalığa yuvarlanmıştır; iki ondalıkla kadınlarda 82,05, erkeklerde 81,53’tür ve aradaki fark \(82{,}05-81{,}53=0{,}52\) yıldır.
time sütununun ortalaması kadınlarda 65,2, erkeklerde 68,2’dir; entry_age ortalaması ise kadınlarda 65,1, erkeklerde 67,9’dur.
Cinsiyete göre ayrı kurulan Kaplan–Meier eğrilerinde iki yaştaki sağkalım:
| Yaş | Kadın | Erkek |
|---|---|---|
| 80 | 0,6575 | 0,5715 |
| 85 | 0,4419 | 0,4319 |
time ortalamalarıyla değil entry_age ortalamalarıyla ölçülür? Aynı yaşta, 80 yaşına kadar ölme olasılıklarının oranı kaçtır?(a) Oranlar ve orantı:
\[ \frac{49}{1.021}=0{,}0480, \qquad \frac{85}{979}=0{,}0868, \qquad \frac{0{,}0868}{0{,}0480}\approx1{,}81. \]
(b) Ham oran zaman ölçeğini yok sayar: kimin hangi yaşlarda izlendiğine bakmadan ölümleri gözlem sayısına böler. Erkekler gözleme ortalama \(67{,}9-65{,}1=2{,}8\) yıl daha yaşlı girmiştir ve beş yıllık pencerede ölme olasılığı yaşla artar: laboratuvarın Görev A’sında ölenler gözleme ortalama 6,35 yıl daha yaşlı girmişti. Erkeklerin ham ölüm payı bu yüzden, aynı yaşta riskleri eşit olsa bile yükselirdi.
Yaş farkını entry_age ile ölçüyoruz, time ile değil. time sansürlü satırda giriş yaşı, ölüm satırında ölüm yaşıdır (Veri sözlüğü); bir grubun time ortalaması bu iki büyüklüğün karışımıdır ve karışımın oranı grubun ölüm payına bağlıdır. Görev A aynı nedenle entry_age’i karşılaştırmıştı. İki grupta aynı şeyi ölçen sütun gözleme giriş yaşıdır.
Yaş burada bir karıştırıcı (confounder) değişkendir: hem cinsiyetle hem ölümle ilişkilidir. Ham oranın ne kadarının ondan geldiğini ölçmek için iki grubu aynı yaş dağılımına getiririz. Önce giriş yaşını altı banda ayırıp (55’e kadar, 55 ile 75 arasında beşer yıl, 75’ten büyük) her bantta kadınların ve erkeklerin ölüm payını ayrı hesaplıyoruz.
yas_bandi_payi <- veri |>
  mutate(giris_bandi = cut(entry_age, c(0, 55, 60, 65, 70, 75, 100))) |>
  group_by(giris_bandi) |>
  summarise(
    kisi = n(),
    kadin = mean(event[sex == "female"]),
    erkek = mean(event[sex == "male"]),
    .groups = "drop"
  )

yas_bandi_payi
#> # A tibble: 6 × 4
#> giris_bandi kisi kadin erkek
#> <fct> <int> <dbl> <dbl>
#> 1 (0,55] 99 0 0.0526
#> 2 (55,60] 197 0.0226 0.0156
#> 3 (60,65] 479 0.0189 0.0233
#> 4 (65,70] 629 0.0417 0.0379
#> 5 (70,75] 420 0.0864 0.155
#> 6 (75,100] 176 0.2 0.245kisi bandın iki cinsiyetteki toplam kişi sayısıdır; giriş yaşlarının hepsi 0 ile 100 arasında olduğu için her satır bir banda düşer. Erkeklerin payı altı bandın dördünde daha yüksektir; fark en büyük 70–75 bandındadır (0,0864’e karşı 0,155).
Sonra iki grubun bant paylarını aynı ağırlıklarla, bantların toplam kişi sayısıyla ortalıyoruz; iki cinsiyet de bütün örneklemin yaş dağılımına sahipmiş gibi karşılaştırılır. Bu hesaba doğrudan standartlaştırma (direct standardization) denir. Formülü \(\bar p=\sum_b n_b\,p_b\big/\sum_b n_b\)’dir: \(n_b\) bandın kisi sayısı, \(p_b\) grubun o banttaki ölüm payıdır. Elle hesap için yukarıdaki çıktının paylarını kullanalım (kadınlarda \(p_K\), erkeklerde \(p_E\)):
| Bant | \(n_b\) | \(p_K\) | \(n_b\,p_K\) | \(p_E\) | \(n_b\,p_E\) |
|---|---|---|---|---|---|
| 55’e kadar | 99 | 0 | 0 | 0,0526 | 5,21 |
| 55–60 | 197 | 0,0226 | 4,45 | 0,0156 | 3,07 |
| 60–65 | 479 | 0,0189 | 9,05 | 0,0233 | 11,16 |
| 65–70 | 629 | 0,0417 | 26,23 | 0,0379 | 23,84 |
| 70–75 | 420 | 0,0864 | 36,29 | 0,155 | 65,10 |
| 75’ten büyük | 176 | 0,2 | 35,20 | 0,245 | 43,12 |
| Toplam | 2.000 | 111,22 | 151,50 |
Toplamlar bantlardaki kişilerin toplamına, 2.000’e bölünür: kadınlarda \(111{,}22/2.000=0{,}0556\), erkeklerde \(151{,}50/2.000\approx0{,}0758\). Aynı hesabı kodla yapalım.
yasa_gore_pay <- c(
  kadin = sum(yas_bandi_payi$kisi * yas_bandi_payi$kadin) / sum(yas_bandi_payi$kisi),
  erkek = sum(yas_bandi_payi$kisi * yas_bandi_payi$erkek) / sum(yas_bandi_payi$kisi)
)

round(c(yasa_gore_pay, oran = yasa_gore_pay[["erkek"]] / yasa_gore_pay[["kadin"]]), 4)
#> kadin erkek oran
#> 0.0556 0.0758 1.3624Aynı yaş dağılımında kadınların ölüm payı 0,0556, erkeklerinki 0,0758’dir ve oran 1,81’den 1,36’ya iner. Oranın 1’i aşan kısmı 0,81’den 0,36’ya düşer: \((0{,}81-0{,}36)/0{,}81\approx0{,}56\), yani yaş farkı bu fazlalığın yarısından biraz fazlasını açıklar; kalanı aynı yaşta da süren bir farktır.
Kaplan–Meier karşılaştırmayı zaten yaş ekseninde yapar: her ölüm yaşında paydaya o yaşa ulaşmış sayılanları koyar. Bunu kusurlu biçimde yapar (girişi yok sayar ve sansürlüleri giriş yaşında paydadan çıkarır, sözlüğün yanıtlayamaz kutusu), ama iki grubu aynı yaşlarda karşılaştırır. 80 yaşına kadar ölme olasılığı kadınlarda \(1-0{,}6575=0{,}3425\), erkeklerde \(1-0{,}5715=0{,}4285\)’tir; oranları \(0{,}4285/0{,}3425=1{,}25\), standartlaştırılmış orana (1,36) yakın.
Medyan ise düşey değil yatay bir ölçüdür: eğrinin 0,5’i kestiği yaştır. 80 ile 85 yaş arasında iki eğri dik iner ve birbirine yaklaşır; aralarındaki fark 80’de 0,0860, 85’te 0,0100’dür (sorudaki tablo). Dik inen iki eğri 0,5 düzeyini birbirine yakın yaşlarda keser: 81,5 ve 82,1. Ham oranla medyan farkı bu yüzden çelişmez; biri farklı yaşlarda izlenen grupların ölüm paylarını oranlar, öbürü iki eğrinin aynı düzeyi kestiği yaşları karşılaştırır.
(c) Aralıklar (80,3 – 86,5) ve (79,5 – 85,4) neredeyse tümüyle üst üste biner ve her grubun medyanı diğerinin aralığı içindedir. Bu veri, medyanlar arasında güvenilir bir fark bulunduğunu göstermez. Gözlenen 0,5 yıllık fark, belirsizliğin yanında küçüktür.
Aralıkların örtüşmesi tek başına bir sınama değildir: iki aralık örtüşse bile farkın kendi aralığı sıfırı dışarıda bırakabilir. Farkı doğrudan sınamak ayrı bir sınama gerektirir; bu hafta kurulmuyor.
(d) En azından şunlar gerekir:
Ayrıca bu dosya öğretim amaçlı seçilmiş, değişmeyen bir alt örneklemdir; betimsel bir eğri farkı tek başına nedensel etki kanıtı değildir ve fiyatlama tablosu yerine kullanılamaz.
Tablodaki sayıları veriden yeniden üretelim. Önce cinsiyete göre ham olay oranını hesaplıyoruz:
ham_oran <- tapply(veri$event, veri$sex, mean)

ham_oran
#> female male
#> 0.04799216 0.08682329Ardından aynı veriye conf.type = "log-log" seçeneğiyle cinsiyete göre iki eğri kuruyoruz; medyanlar ve güven aralıkları bu uyumdan okunur:
fit_alistirma <- survival::survfit(
  survival::Surv(time, event) ~ sex,
  data = veri,
  conf.type = "log-log"
)

fit_alistirma
#> Call: survfit(formula = survival::Surv(time, event) ~ sex, data = veri,
#> conf.type = "log-log")
#>
#> n events median 0.95LCL 0.95UCL
#> sex=female 1021 49 82.1 80.3 86.5
#> sex=male 979 85 81.5 79.5 85.4Son olarak dört özeti tek listede topluyoruz. Medyan satırları yukarıdaki fit_alistirma çıktısında da vardır; burada daha çok basamakla yazdırılırlar, çünkü round(..., 2) paketin kendi yuvarlamasından daha ayrıntılıdır. Değerlerin alıştırmanın tablosuyla eşleşmesi gerekir:
list(
  ham_olay_orani = round(ham_oran, 4),
  ortalama_time = round(tapply(veri$time, veri$sex, mean), 2),
  ortalama_giris_yasi = round(tapply(veri$entry_age, veri$sex, mean), 2),
  medyan_tablosu = round(
    summary(fit_alistirma)$table[
      , c("records", "events", "median", "0.95LCL", "0.95UCL")
    ],
    2
  )
)
#> $ham_olay_orani
#> female male
#> 0.0480 0.0868
#>
#> $ortalama_time
#> female male
#> 65.23 68.15
#>
#> $ortalama_giris_yasi
#> female male
#> 65.08 67.93
#>
#> $medyan_tablosu
#> records events median 0.95LCL 0.95UCL
#> sex=female 1021 49 82.05 80.31 86.54
#> sex=male 979 85 81.53 79.46 85.44Bu alıştırmalar hesaplamadan çok, kullanılan ölçünün anlamını ve analizin sınırlılıklarını kısa biçimde tartışmak içindir. Önce yanıtınızı oluşturun, ardından ilgili Çözümü göster düğmesiyle karşılaştırın.
Alıştırma 6 (Sansür ve olay ayrımı). event = 0 neden “kişi hayatta kalacaktır” anlamına gelmez?
event = 0, yalnızca gözlem penceresi kapandığında olayın henüz gerçekleşmemiş olduğunu söyler: \(Y=\min(T,C)\) ve \(\delta=0\) iken bildiğimiz tek şey \(T>C\)’dir (Sağdan sansürleme). Olayın hiç gerçekleşmeyeceği değil, gerçek olay zamanının gözlenen süreden büyük olduğu bilgisi elimizdedir.
Kaydı “hayatta kalacak” diye okumak, kişiyi pencereden sonra da her ölüm zamanının paydasında tutmak demektir. O zaman her \(d_j\) aynı kalır, \(n_j\) yalnız büyüyebilir; hiçbir \(1-d_j/n_j\) çarpanı küçülemez ve eğri ya yukarı kayar ya yerinde kalır. Yön, Alıştırma 3(d)’deki iki hatanınkinin tersidir. Sapma ağır sansürlü verilerde büyür: dersin dosyasında 2.000 gözlemin 1.866’sı, yani %93,3’ü sansürlüdür.
Doğrusu, sansürlü kaydı gözlendiği süre boyunca paydada saymak, sansür anından sonra paydadan çıkarmaktır. Ders dosyası bunun için gereken sansür yaşını bile tutmaz: sansürlü satırda time giriş yaşıdır (sözlüğün Bu veri neyi yanıtlayamaz kutusu).
Alıştırma 7 (Sansürün paydaya etkisi). Sansür zamanında Kaplan–Meier eğrisi neden düşmez?
Kaplan–Meier çarpımı \(\prod(1-d_j/n_j)\) yalnızca olay zamanları üzerinden alınır; sansür zamanında \(d_j=0\) olduğu için o anda uygulanacak bir çarpan yoktur ve eğri yatay kalır. Sansürün değiştirdiği sayı pay değil, sonraki paydalardır.
Gövdenin altı kişilik örneğinde süreler 2, 3, 3, 5, 6 ve 8’dir; 3’teki iki kişiden biri ve 6’daki kişi sansürlüdür. survival::survfit() bu veri için şu satırları verir:
| Zaman | Riskte | Olay | Sansür | \(\widehat S\) |
|---|---|---|---|---|
| 2 | 6 | 1 | 0 | 0,8333 |
| 3 | 5 | 1 | 1 | 0,6667 |
| 5 | 3 | 1 | 0 | 0,4444 |
| 6 | 2 | 0 | 1 | 0,4444 |
| 8 | 1 | 1 | 0 | 0 |
6 zamanındaki satırda olay yoktur ve \(\widehat S\) 0,4444’te kalır. Değişen, 8 zamanındaki risk kümesidir: 6’daki kişi 8’e kadar olaysız izlenseydi orada 2 kişi riskte olurdu, son çarpan \(1-1/2\) olurdu ve \(\widehat S(8)=0{,}4444\cdot0{,}5\) \(=0{,}2222\) çıkardı. Sansürle risk kümesi 1 kişiye iner, çarpan \(1-1/1=0\) olur ve eğri sıfıra düşer. Bilgi kaybolmaz, sonraki basamakların derinliğine yansır; sansür grafikte bu yüzden yalnız küçük bir işaretle gösterilir.
Alıştırma 8 (Risk kümesi ve belirsizlik). Risk kümesi küçüldükçe güven aralıklarına ne olur?
Aralıklar hızla genişler, çünkü varyansı kuran Greenwood toplamının her terimi \(d_j/[n_j(n_j-d_j)]\)’dir (Güven aralığı bölümü) ve risk kümesi küçüldükçe büyür. Tek ölümlü bir adımda terim \(1/[n_j(n_j-1)]\)’dir: 611 kişide \(1/(611\cdot610)\) \(=2{,}68\cdot10^{-6}\), beş kişide \(1/(5\cdot4)=0{,}05\). İkincisi birincinin \(611\cdot610/(5\cdot4)\) \(=18.635{,}5\), yaklaşık 18.600 katıdır.
Alıştırma 4’teki ders verisinde 70 yaşında risk kümesi 611 kişidir ve %95 aralığın genişliği 0,021; 90 yaşında risk kümesi 5 kişiye indiğinde genişlik 0,223, yani yaklaşık 10,6 katıdır. Alıştırma 4(b) bu oranı riskteki kişiye ve tahminin kendi değerine ayırmıştı.
Eğrinin kuyruktaki basamakları görsel olarak keskin görünse de tek bir ek ölüm tahmini büyük ölçüde değiştirir: Alıştırma 4(c)’de 90 yaşta 0,1714’ten 0,1371’e. Bu nedenle bir sağkalım tahmini raporlanırken nokta değerin yanına o andaki riskteki kişi sayısı ve güven aralığı mutlaka yazılmalıdır.
Alıştırma 9 (Hız ve olasılık ayrımı). Hazard neden olasılık değildir?
Hazard \(h(t)\), \(t\)’ye olaysız ulaşmış birinin sonraki kısa \(\Delta t\) aralığında olay yaşama olasılığının \(\Delta t\)’ye bölümünün limitidir (Sağkalım ve hazard bölümü). Bu bir hızdır: birimi “zaman başına olay”dır ve üst sınırı yoktur. Yoğunluk \(f(t)\) ile karıştırılmamalıdır: yoğunluk aynı olasılığı başlangıçtaki herkese göre verir, hazard yalnızca \(t\)’ye olaysız ulaşanlara göre; ikisinin ilişkisi \(h(t)=f(t)/S(t)\)’dir. Bir olasılık ise birimsizdir ve 0 ile 1 arasında kalmak zorundadır. En basit örnek: hazard sabitse bölümü bunu sayıyla gösterir: ortalaması 6 ay olan bir sürede hazard yılda 2’dir, ay birimiyle yazılırsa 0,1667; aynı kişinin bir yıl içinde olay yaşama olasılığı ise \(1-e^{-2}=0{,}8647\)’dir. Hız birim değişince değişir ve 1’i aşabilir; olasılık ikisini de yapmaz.
Gövdenin altı kişilik örneği (süreler 2, 3, 3, 5, 6, 8; 3’teki iki kişiden biri ve 6’daki kişi sansürlü) şu risk tablosunu verir:
| \(t_j\) | \(n_j\) | \(d_j\) | \(d_j/n_j\) | \(\widehat H(t_j)\) |
|---|---|---|---|---|
| 2 | 6 | 1 | 1/6 | 0,1667 |
| 3 | 5 | 1 | 1/5 | 0,3667 |
| 5 | 3 | 1 | 1/3 | 0,7000 |
| 8 | 1 | 1 | 1/1 | 1,7000 |
Tablodaki \(d_j/n_j\) bir hız değil, tek bir olay anındaki koşullu olasılığın tahminidir; bu yüzden 1’i aşamaz. En büyüğü, riskte tek kişinin kaldığı 8 zamanındaki \(1/1\)’dir.
Kümülatif hazard da bir olasılık değildir; zaman birimi taşımadığı için bir hız da değildir. Son satırdaki \(\widehat H(8)=1{,}70\) 1’i aştığı için hiçbir biçimde “%170 olasılık” diye okunamaz. Olasılık isteniyorsa \(S(t)=e^{-H(t)}\) ilişkisiyle sağkalıma geçilir, sonra \(1-S(t)\) alınır: \(1-e^{-1{,}70}=0{,}8173\). Kaplan–Meier’e göre aynı olasılık \(1-0=1\)’dir; iki tahmin edicinin neden ayrıştığını Alıştırma 10 açıklıyor.
Alıştırma 10 (İki tahmin edicinin farkı). Kaplan–Meier tahmini ile \(\exp(-\widehat H)\) neden tam eşit olmak zorunda değildir?
İkisi aynı büyüklüğün iki ayrı tahmin edicisidir ve her olay zamanında farklı bir çarpan uygular. \(x=d_j/n_j\) olsun: Kaplan–Meier \(1-x\) ile çarpar. Nelson–Aalen \(x\)’leri toplar; \(\exp(-\widehat H)\) bu toplamın eksi işaretlisinin üssünü aldığı için her olay zamanında \(e^{-x}\) ile çarpar. Gövdenin altı kişilik örneğinde çarpanlar ve onların ardışık çarpımları yan yana:
| \(t_j\) | \(n_j\) | \(1-x\) | \(e^{-x}\) | \(\widehat S_{KM}(t_j)\) | \(\exp[-\widehat H(t_j)]\) |
|---|---|---|---|---|---|
| 2 | 6 | 0,8333 | 0,8465 | 0,8333 | 0,8465 |
| 3 | 5 | 0,8000 | 0,8187 | 0,6667 | 0,6930 |
| 5 | 3 | 0,6667 | 0,7165 | 0,4444 | 0,4966 |
| 8 | 1 | 0 | 0,3679 | 0 | 0,1827 |
Sağdaki her sütun kendi çarpan sütununun ardışık çarpımıdır; örneğin \(0{,}8465\cdot0{,}8187=0{,}6930\). Nelson–Aalen tahmini bölümündeki \(1-x\le e^{-x}\) eşitsizliği yüzünden Kaplan–Meier hiçbir adımda üste çıkmaz.
Çarpanların farkı \(x=1/6\)’da 0,0131, \(x=1/3\)’te 0,0499, \(x=1\)’de 0,3679’dur. Küçük \(x\)’te fark yaklaşık \(x^{2}/2\)’dir, çünkü \(e^{-x}=1-x+x^{2}/2-\cdots\); \(x\) büyüdükçe, yani risk kümesi küçüldükçe hızla büyür.
İlk iki fark tam değerlerle hesaplanmıştır. Tablonun dört ondalıklı sayılarından çıkarılınca son basamak bir birim farklı çıkar: \(0{,}8465-0{,}8333=0{,}0132\) ve \(0{,}7165-0{,}6667=0{,}0498\).
Büyük risk kümelerinde iki tahmin birbirine yakınsar; küçük örneklemde zorla eşitlenmemeli, hangi tahmin edicinin raporlandığı yazılmalıdır.
Laboratuvarın Görev D’si büyük risk kümelerindeki yakınsamayı ders verisinde ölçmüştü: 2.000 kişinin eğrisinde en büyük fark 0,0315’tir ve risk kümesinin en küçük olduğu yerde, 95,52 yaşında, eğrinin sonunda ortaya çıkar.
Alıştırma 11 (Betimsel ve nedensel ayrımı). İki grubun Kaplan–Meier eğrileri arasında fark görmek neden nedensellik kanıtı değildir?
Eğri farkı betimseldir: iki grubun gözlenen deneyimini özetler, farkın kaynağını söylemez. Alıştırma 5 bunu ders verisinde sayıyla gösterdi:
Kalan fark da nedensel bir etki diye okunamaz, çünkü yalnız giriş yaşı dengelenmiştir. Nedensel bir yoruma geçmek için Alıştırma 5(d)’deki bilgiler gerekir: yaşın ve giriş koşullarının dengelendiği bir karşılaştırma, sansür mekanizmasının gruplarda benzer olduğunun gösterilmesi ve seçilim etkisi yaratabilecek karıştırıcı değişkenler hakkında bilgi. Bu dosya öğretim amaçlı seçilmiş, değişmeyen bir alt örneklemdir; buradaki eğriler bir fiyatlama tablosu yerine kullanılamaz.
Alıştırma 12 (Sansürlü kaydı silmenin yönü). Sansürlü kayıtları silmek tahmini hangi mekanizmayla bozabilir?
Silme işlemi payı değil paydayı değiştirir: sansürlü kişi, sansürlendiği ana kadar bulunduğu bütün paydalardan düşer, olay sayıları (\(d_j\)) ise aynı kalır. Kişinin bulunduğu her paydada \(d_j/n_j\) yapay biçimde büyür; sonraki olay zamanlarının paydası değişmez. Alıştırma 3’ün sekiz kişilik verisinde doğru tahmin \(\widehat S(6)=0{,}5469\) iken sansürlüler silindiğinde 0,2500’e düşer; tüm satırları olay saymak da (0,3750) aynı yöne çeker.
Bu, örneklem küçüldüğü için ortaya çıkan bir gürültü değil, sistematik bir yanlılıktır ve yönü her veride aynıdır: \(d_j\) değişmediği, \(n_j\) yalnızca küçülebildiği için hiçbir çarpan büyüyemez (Alıştırma 3(d)). Veriden veriye değişen sapmanın büyüklüğüdür ve o, silinen kişinin kaç olay zamanının paydasında bulunduğuna bağlıdır. Alıştırma 3’te sansürlülerden yalnız birini silelim:
| Silinen kişi | Sansür zamanı | Bulunduğu paydalar (\(t_j\le6\)) | \(\widehat S(6)\) |
|---|---|---|---|
| 2 | 2 | \(t=1\) | \(\frac{6}{7}\cdot\frac{5}{6}\cdot\frac{3}{4}=0{,}5357\) |
| 4 | 5 | \(t=1\) ve \(3\) | \(\frac{6}{7}\cdot\frac{4}{5}\cdot\frac{3}{4}=0{,}5143\) |
| 6 | 7 | \(t=1\), \(3\) ve \(6\) | \(\frac{6}{7}\cdot\frac{4}{5}\cdot\frac{2}{3}=0{,}4571\) |
Kişi ne kadar geç sansürlenmişse o kadar çok paydada bulunur ve silinmesi tahmini o kadar aşağı çeker; ilk olaydan önce sansürlenen birini silmek sonucu hiç değiştirmez. Olay kodlamasına bakan bir denetim silinen satırı yakalamaz: geriye kalan satırların kodlaması doğrudur. Görev E’deki gibi denetim veriye değil uyuma konur; uyumun gözlem sayısı dosyadan okunan satır sayısıyla karşılaştırılır. Okuma anında n_okunan <- nrow(veri) kaydedilir, analizde stopifnot(uyum$n == n_okunan) çalıştırılır.
Surv() ve survfit() belgeleri. CRANcanlifins verisinin kullanıldığı çalışma; CASdatasets belgesi aynı çalışmanın 1995 tarihli ön sürümünü anar.