Kodu göster / gizle
library(readr)
library(ggplot2)
library(scales)IST5109 İleri Aktüerya Teknikleri · Sigorta Verileriyle İstatistiksel Programlama
Geçen hafta hasar sıklığını hesaplayamamıştık: dosyada yalnızca gerçekleşmiş hasarlar vardı, poliçelerin maruziyet süreleri yoktu. Bu hafta sıklığı ve büyüklüğü ayrı iki soru olarak kuruyoruz.
Sigorta portföyünde iki farklı rastgele büyüklük vardır: belirli bir dönemde kaç hasar gerçekleştiği ve gerçekleşen bir hasarın ne kadar olduğu. Bu hafta sıklık ile büyüklük/şiddet modellerini ayıracak, pozitif hasar tutarlarına aday dağılımlar uyduracak ve model çıktısını grafiklerle değerlendireceğiz.
Hazır paketler eniyileme işlemini güvenilir biçimde yapar. Buna karşın küçük bir örnekte tahmini açık formülle üretip paket sonucuyla karşılaştıracağız. Böylece paketin ne hesapladığını bilmeden onu kullanmayacağız; büyük sayısal algoritmaları da gereksiz yere yeniden yazmayacağız.
Oturum sonunda öğrenci:
fitdistrplus::fitdist() ile maksimum olabilirlik tahmini yapar;| Süre | Etkinlik |
|---|---|
| 0–30 dk | Toplam hasarın iki parçası; sıklık ve büyüklük için aday modeller |
| 30–60 dk | claims_long veri sözlüğü; Poisson, negatif binom, sıfır şişkin Poisson ve yarı-Poisson |
| 60–85 dk | danishuni veri sözlüğü; fitdistrplus ve actuar ile büyüklük dağılımlarının uydurulması; Q–Q grafiği ve kuyruk kuantilleri |
| 85–95 dk | Ara |
| 95–160 dk | R laboratuvarı: Danimarka yangın hasarları ve claims_long’un öbür yılları |
| 160–175 dk | Uyum, kuyruk riski ve model seçimi tartışması |
| 175–180 dk | Haftanın özeti ve açık sorular |
Bir portföyün bir dönemdeki toplam hasar tutarı
\[ S=X_1+X_2+\cdots+X_N \]
biçiminde yazılır. Toplamın iki rastgele parçası vardır:
Toplamdaki terimlerin sayısı da rastgeledir: \(N=0\) ise toplanacak hasar yoktur ve \(S=0\)’dır.
İki parça ayrı modellenir, çünkü verileri de ayrıdır. Sıklık modelinin verisi hasarsız poliçeleri de içermelidir: hiç hasar yapmamış bir poliçe, \(N=0\) olan bir gözlemdir. Büyüklük modeli ise yalnızca gerçekleşmiş, pozitif hasarları kullanır. Sıfırların neden oluştuğunu belirtmeden aynı sütuna iki modeli birden uygulamak hatadır.
Bu hafta önce \(N\)’yi, sonra \(X\)’i ele alıyoruz. Hasar sayısı için modeller bölümü Poisson’u ve üç alternatifini, Hasar büyüklüğü için üç aday bölümü büyüklük dağılımlarını tanıtır; ikisi de aşağıda gerçek veride aynı sırayla uydurulur. İki modeli birleştirip \(S\)’nin ortalamasını ve varyansını Hafta 5’te, dağılımının kendisini Hafta 12’de benzetimle hesaplayacağız.
Bu haftanın veri okuma, grafik ve eksen biçimlendirme paketlerini en başta yükleyelim:
library(readr)
library(ggplot2)
library(scales)Sayfanın kullandığı öbür üç paket, fitdistrplus, actuar ve MASS, yüklenmez; işlevleri paket::işlev() biçiminde çağrılır. :: paketi o çağrı için kendisi yükler ve işlevin hangi paketten geldiğini çağrıda gösterir.
Hasar sayısının ilk modeli Poisson’dur: önce formülünün nereden geldiğini, sonra yetmediği durumlar için kurulan üç alternatifi göreceğiz. Türetmeler, varsayılanı kapalı Türetmeyi göster kutularındadır; metin yalnız sonuçları ve ne anlama geldiklerini verir.
Basit Poisson modelinde bir poliçenin bir dönemde \(n\) hasar yapma olasılığı
\[ P(N=n)=e^{-\lambda}\frac{\lambda^n}{n!},\qquad n=0,1,2,\ldots \]
ile verilir. Modelin tek parametresi \(\lambda>0\)’dır; aşağıda göreceğimiz gibi dönem başına beklenen hasar sayısıdır, yani hasar sıklığıdır.
Formül nereden gelir? Poliçenin yılını \(r\) eşit ve çok kısa parçaya bölelim, örneğin dakikalara. Üç varsayım yapalım:
O zaman yıldaki hasar sayısı, \(r\) bağımsız denemedeki başarı sayısıdır ve binom dağılımı (binomial distribution) izler:
\[ P(N=n)=\binom{r}{n}\Bigl(\frac{\lambda}{r}\Bigr)^{n} \Bigl(1-\frac{\lambda}{r}\Bigr)^{r-n}. \]
Parçalar kısaldıkça, yani \(r\) büyüdükçe, bu olasılık yukarıdaki Poisson formülüne yaklaşır.
Bunu görmek için olasılığın üç çarpanını ayrı ayrı yeniden yazalım:
\[ \begin{aligned} &\binom{r}{n}=\frac{r(r-1)\cdots(r-n+1)}{n!},\\ &\Bigl(\frac{\lambda}{r}\Bigr)^{n}=\frac{\lambda^{n}}{r^{n}},\\ &\Bigl(1-\frac{\lambda}{r}\Bigr)^{r-n}\\ &\quad=\Bigl(1-\frac{\lambda}{r}\Bigr)^{r}\Bigl(1-\frac{\lambda}{r}\Bigr)^{-n}. \end{aligned} \]
Birinci satır, \(\binom{r}{n}=r!/\bigl(n!\,(r-n)!\bigr)\) kesrinde \((r-n)!\)’in sadeleşmesiyle çıkar: kesrin payında \(r\)’den başlayıp birer azalan \(n\) çarpan kalır. Üçüncü satır, üssün \(r-n=r+(-n)\) diye ikiye ayrılmasıdır (\(a^{u+v}=a^{u}a^{v}\)). Üç satırın sağ tarafları çarpılır ve kesirler yeniden eşlenir: \(n!\), \(\lambda^{n}\)’nin altına; \(r^{n}\), \(r(r-1)\cdots(r-n+1)\)’in altına yazılır:
\[ \begin{aligned} &P(N=n)\\ &=\frac{\lambda^{n}}{n!}\cdot\frac{r(r-1)\cdots(r-n+1)}{r^{n}}\\ &\quad\cdot\Bigl(1-\frac{\lambda}{r}\Bigr)^{r}\cdot\Bigl(1-\frac{\lambda}{r}\Bigr)^{-n}. \end{aligned} \]
\(r\) büyürken son üç çarpanın her biri bir sınıra gider:
Geriye \(\frac{\lambda^{n}}{n!}\cdot1\cdot e^{-\lambda}\cdot1\) \(=e^{-\lambda}\lambda^{n}/n!\), yani Poisson formülü kalır.
Poisson böylece çok sayıda kısa anda, birbirinden bağımsız ve tek tek seyrek gerçekleşen olayların sayısıdır.
Ortalama ve varyans neden \(\lambda\)? Ortalama, her değerin olasılığıyla çarpılıp toplanmasıdır. Poisson olasılıklarıyla hem ortalama hem varyans kapalı biçimde hesaplanır ve ikisi de \(\lambda\)’dır:
\[ E[N]=\lambda,\qquad\operatorname{Var}(N)=\lambda . \]
Ortalama. Tanımdan başlayıp her satırda tek bir işlem yapıyoruz:
\[ \begin{aligned} E[N]&=\sum_{n=0}^{\infty}n\,e^{-\lambda}\frac{\lambda^{n}}{n!}\\ &=\sum_{n=1}^{\infty}n\,e^{-\lambda}\frac{\lambda^{n}}{n!}\\ &=\sum_{n=1}^{\infty}e^{-\lambda}\frac{\lambda^{n}}{(n-1)!}\\ &=\lambda\sum_{n=1}^{\infty}e^{-\lambda}\frac{\lambda^{n-1}}{(n-1)!}\\ &=\lambda\sum_{k=0}^{\infty}e^{-\lambda}\frac{\lambda^{k}}{k!}\\ &=\lambda\cdot1=\lambda . \end{aligned} \]
Eşitlikler sırasıyla:
Varyans. \(E[N^{2}]\)’yi doğrudan toplamak yerine \(E[N(N-1)]\)’den başlarız: \(n^{2}\), \(n!\) ile sadeleşmez; \(n(n-1)\) ise sadeleşir, çünkü \(n!=n(n-1)\,(n-2)!\)’dir. Adımlar ortalamanınkiyle aynıdır. Farkı, \(n=0\) ve \(n=1\) terimlerinin ikisinin de düşmesi, toplamın dışına \(\lambda^{2}\) çıkması ve \(k=n-2\) yazılmasıdır:
\[ \begin{aligned} E[N(N-1)]&=\sum_{n=2}^{\infty}n(n-1)\,e^{-\lambda}\frac{\lambda^{n}}{n!}\\ &=\sum_{n=2}^{\infty}e^{-\lambda}\frac{\lambda^{n}}{(n-2)!}\\ &=\lambda^{2}\sum_{n=2}^{\infty}e^{-\lambda}\frac{\lambda^{n-2}}{(n-2)!}\\ &=\lambda^{2}\sum_{k=0}^{\infty}e^{-\lambda}\frac{\lambda^{k}}{k!}\\ &=\lambda^{2}\cdot1=\lambda^{2}. \end{aligned} \]
\(N^{2}=N(N-1)+N\)’dir (sağ taraf \(N^{2}-N+N\)). Beklenen değer toplamın her terimine ayrı ayrı uygulanır; varyans da ikinci momentten ortalamanın karesini çıkarır:
\[ \begin{aligned} E[N^{2}]&=E[N(N-1)]+E[N]\\ &=\lambda^{2}+\lambda,\\ \operatorname{Var}(N)&=E[N^{2}]-(E[N])^{2}\\ &=\lambda^{2}+\lambda-\lambda^{2}\\ &=\lambda . \end{aligned} \]
\(E[N^{2}]=\lambda^{2}+\lambda\) sonucunu karışımın varyansında yeniden kullanacağız.
Bir parametrenin maksimum olabilirlik tahmini (maximum likelihood estimate), gözlenen verinin o parametre altındaki olasılığını, yani olabilirliği, en büyük yapan değerdir. \(m\) bağımsız birimin her biri aynı süre gözlenmiş ve \(j\)’inci birimde \(n_j\) hasar sayılmışsa, \(\lambda\)’nın maksimum olabilirlik tahmini örnek ortalamasıdır:
\[ \widehat{\lambda}=\frac{1}{m}\sum_{j=1}^{m} n_j. \]
Aşağıdaki küçük örnek bunu log-olabilirliğin türevini sıfıra eşitleyerek bulur ve aynı yolu birimlerin farklı sürelerle gözlendiği duruma da uygular.
Dört eşit maruziyetli birimde hasar sayıları 0, 1, 0, 3 olsun.
Elle:
\[ \widehat{\lambda}=(0+1+0+3)/4=1. \]
Bu sayının neden maksimum olabilirlik tahmini olduğunu görelim. Dört sayının \(\lambda\) altında birlikte gözlenme olasılığı dört Poisson olasılığının çarpımıdır; logaritması, yani log-olabilirlik, çarpımı toplamaya çevirir. Dört birimin log-olabilirliği üç parçanın toplamıdır:
\[ \ell(\lambda)=-4\lambda+4\log\lambda-\log 6 . \]
Toplanan her terim, yukarıdaki \(P(N=n)=e^{-\lambda}\lambda^n/n!\) formülünün logaritmasıdır. Çarpımın logaritması logaritmaların toplamı olduğu için üç parçaya ayrılır:
\[ \log P(N=n)=-\lambda+n\log\lambda-\log n! . \]
Dört birimin her biri bu üç parçayı taşır ve log-olabilirlik onların toplamıdır:
\[ \begin{aligned}&\ell(\lambda)\\ &=\sum_{j=1}^{4}\log P(N=n_j)\\ &=\sum_{j=1}^{4}\left(-\lambda+n_j\log\lambda-\log n_j!\right)\\ &=-4\lambda+(0+1+0+3)\log\lambda\\ &\quad-(\log 0!+\log 1!+\log 0!+\log 3!)\\ &=-4\lambda+4\log\lambda-\log 6 . \end{aligned} \]
Birinci parça her birimde aynı \(-\lambda\)’dır ve dört kez toplanır. İkincide \(\log\lambda\)’nın katsayısı birimin hasar sayısıdır; dört hasar sayısının toplamı 4 olduğu için \(4\log\lambda\) kalır. Üçüncü parça \(\lambda\)’ya bağlı değildir: \(0!=1\), \(1!=1\) ve \(3!=6\) olduğundan toplamı \(\log 6=1{,}7918\)’dir. Eksi işaretiyle girer: aşağıdaki tablonun dördüncü sütununda her satırda aynı kalan −1,7918 budur.
Log-olabilirliği en büyük yapan \(\lambda\)’yı, türevini sıfıra eşitleyerek buluruz:
\[ \begin{aligned} \ell'(\lambda)&=-4+\frac{4}{\lambda}=0\\ \widehat{\lambda}&=4/4=1 . \end{aligned} \]
Türev terim terim alınır: \(-4\lambda\)’nın türevi \(-4\), \(4\log\lambda\)’nın türevi \(4/\lambda\)’dır; \(-\log 6\) ise \(\lambda\)’ya bağlı olmadığı için türevde kaybolur.
Genel durumda da öyledir: \(m\) birimde log-olabilirlik \(-m\lambda+\left(\sum n_j\right)\log\lambda\) ile bir sabitin toplamıdır. Türevi \(-m+\sum n_j/\lambda\) sıfıra eşitlenince \(\widehat{\lambda}=\sum n_j/m\), yani örnek ortalaması çıkar.
Bulunan noktanın bir tepe olduğunu, çukur olmadığını ikinci türev söyler: \(\ell''(\lambda)=-4/\lambda^2\) her \(\lambda>0\) için negatiftir. Başka bir deyişle türev \(\lambda<1\) iken pozitif, \(\lambda>1\) iken negatiftir; log-olabilirlik 1’e kadar artar, sonra azalır.
Poisson’da türevi sıfıra eşitleyen denklem kapalı biçimde çözülür. Aşağıda negatif binomun \(\theta\)’sında ve sıfır şişkin modelde çözülmez; orada optimize() ve optim() aynı tepeyi sayısal olarak arar.
Aynı sonucu sayıyla da görelim. Tablo log-olabilirliği tahminin kendisinde ve iki yanında 0,5 aralıkla hesaplar: 0,5; 1; 1,5 ve 2. Aralığın 0,5 olması bir seçimdir; önemli olan, değerlerin 1’in iki yanında durmasıdır. 1’in altında yalnız bir değer var: bir sonraki adım \(\lambda=0\)’dır ve orada log-olabilirlik tanımsızdır. Hasar sayısı 1 ve 3 olan iki birimin olasılığı \(\lambda=0\)’da sıfırdır ve sıfırın logaritması yoktur (\(4\log\lambda\) terimi \(-\infty\)’a gider). Dört değerde:
| \(\lambda\) | \(-4\lambda\) | \(4\log\lambda\) | \(-\log 6\) | \(\ell(\lambda)\) |
|---|---|---|---|---|
| 0,5 | −2 | −2,7726 | −1,7918 | −6,564 |
| 1 | −4 | 0 | −1,7918 | −5,792 |
| 1,5 | −6 | 1,6219 | −1,7918 | −6,170 |
| 2 | −8 | 2,7726 | −1,7918 | −7,019 |
En büyük log-olabilirlik \(\lambda=1\)’dedir, türevin bulduğu noktada. Tablo tek başına bunu kanıtlamaz: dört nokta yalnız 1’in bu dördünün en iyisi olduğunu gösterir, 1’e yakın bir değerin, örneğin 1,1’in, daha büyük olmadığını göstermez. Onu türev gösterdi. \(\lambda=1\)’deki \(-5{,}792\)’yi Adayları sıralamak bölümünde AIC ve BIC’ye çevireceğiz.
Açık kod:
Kod da metnin yolunu izler: önce log-olabilirlik, sonra türevi, sonra türevin sıfır olduğu nokta. Log-olabilirliği üç parçasıyla bir işlev olarak yazıp tablodaki dört \(\lambda\)’da hesaplayalım:
n <- c(0, 1, 0, 3)
log_olabilirlik <- function(lambda) {
  -length(n) * lambda + sum(n) * log(lambda) - sum(log(factorial(n)))
}
round(sapply(c(0.5, 1, 1.5, 2), log_olabilirlik), 3)
#> [1] -6.564 -5.792 -6.170 -7.019Dört sayı tablonun son sütunudur.
function(lambda) { … } — gövdesi üç parçanın kod hâlidir: -length(n) * lambda birinci parça (\(-4\lambda\)), sum(n) * log(lambda) ikincisi (\(4\log\lambda\)), sum(log(factorial(n))) üçüncüsü (\(\log 6\)). factorial() her sayının faktöriyelini verir.sapply(x, f) — Hafta 2’de gördüğümüz gibi f’yi x’in her öğesine uygular ve sonuçları bir vektörde toplar; burada log-olabilirliği dört \(\lambda\)’da birden hesaplar. Türevi de aynı biçimde yazalım ve 1’in iki yanında hesaplayalım:
turev <- function(lambda) -length(n) + sum(n) / lambda
turev(c(0.5, 0.9, 1, 1.1, 1.5))
#> [1] 4.0000000 0.4444444 0.0000000 -0.3636364 -1.3333333Türev 1’in altında pozitif, 1’de tam sıfır, üstünde negatiftir: log-olabilirlik 1’e kadar artar, sonra azalır. -length(n) türevdeki \(-4\), sum(n) / lambda de \(4/\lambda\)’dır.
Türevi sıfıra eşitleyip elle çözünce \(\widehat{\lambda}=\sum n_j/m\) çıkmıştı. Bu formülü açık bir döngüyle hesaplayalım:
toplam <- 0
for (deger in n) toplam <- toplam + deger
lambda_acik <- toplam / length(n)
lambda_acik
#> [1] 1Hazır fonksiyon ve model:
Aynı ortalamayı önce R’nin kendi işleviyle alalım:
lambda_hazir <- mean(n)
lambda_hazir
#> [1] 1Türev denklemini formüle başvurmadan da çözebiliriz. R’nin uniroot() işlevi turev’in sıfır olduğu noktayı sayısal olarak arar:
lambda_kok <- uniroot(turev, interval = c(0.1, 10), tol = 1e-10)$root
lambda_kok
#> [1] 1uniroot(f, interval) — bir işlevin sıfır olduğu noktayı verilen aralıkta arar; $root bulunan noktadır. Aralığın iki ucunda işlevin işaretleri farklı olmalıdır: turev 0,1’de pozitif, 10’da negatiftir. Uçlarda işaret aynıysa, örneğin c(2, 10) aralığında, çağrı “f() values at end points not of opposite sign” hatasıyla durur.tol = 1e-10 — aramanın ne kadar yakında duracağını söyler. Verilmezse: varsayılan hassasiyet yaklaşık 0,0001’dir; kök 1,0000009 çıkar ve aşağıdaki karşılaştırma TRUE yerine “Mean relative difference: 8.80453e-07” yazar. Şimdi aynı büyüklüğü bir modelden okuyalım. Burada glm() yalnızca sabit terim içeren bir Poisson modeli uydurur. glm() de olabilirliği en büyük yapan değeri sayısal olarak arar, ama \(\lambda\) için değil sabit terim, yani \(\log\lambda\) için. Nesnenin kendisi yazdırıldığında çağrıyı, sabit terimin tahminini ve modelin sapma ölçülerini birlikte gösterir:
fit <- glm(n ~ 1, family = poisson())
fit
#>
#> Call: glm(formula = n ~ 1, family = poisson())
#>
#> Coefficients:
#> (Intercept)
#> 2.754e-09
#>
#> Degrees of Freedom: 3 Total (i.e. Null); 3 Residual
#> Null Deviance: 6.592
#> Residual Deviance: 6.592 AIC: 13.58poisson() — glm()’e hem varyans varsayımını (varyans = ortalama) hem de bağlantı fonksiyonunu söyleyen aile nesnesidir. Varsayılan bağlantı logaritmadır, ve aşağıdaki satırda sabit terimin üssünün alınmasının tek nedeni budur. Verilmezse: family = gaussian() ile aynı veri sıradan doğrusal regresyon olur; katsayı doğrudan \(\lambda\) verir ve üs almak sonucu bozar.lambda_glm, sabit terimi geri dönüştürerek elde edilir:
lambda_glm <- exp(coef(fit)[1])
lambda_glm
#> (Intercept)
#> 1coef(model) — uydurulan modelin katsayı vektörünü döndürür; adları terim adlarıdır, burada "(Intercept)". [1] ilk katsayıyı adıyla birlikte seçer, bu yüzden lambda_glm adlandırılmış bir sayıdır.Formülü, hazır işlevi, türevin sayısal kökünü ve model tahminini şimdi ayrı bir blokta karşılaştıralım:
all.equal(lambda_acik, lambda_hazir)#> [1] TRUEall.equal(lambda_acik, lambda_kok)#> [1] TRUEall.equal(lambda_hazir, unname(lambda_glm))#> [1] TRUEunname(x) — vektörün adlarını siler. lambda_glm, coef()’ten geldiği için "(Intercept)" adını taşır; all.equal() ad farkını da bir fark sayar ve adı silinmemiş bir karşılaştırma TRUE yerine “names for current but not for target” yazar. lambda_hazir’ın zaten adı yoktur, onun için gerekmez.Üç all.equal() çağrısı da TRUE vermelidir; sayısal bir fark yazdırılıyorsa elle hesap ile paket sonucu aynı büyüklüğü tahmin etmiyor demektir.
Sigorta diliyle: bu dört birimde dönem başına ortalama bir hasar beklenir. Bu bir olasılık değil, maruziyet başına bir hızdır; dördüncü birimin tek dönemde üç hasar üretebilmesi de bundandır.
Farklı sürelerle gözlenen birimler. Türevi sıfıra eşitleme yolu, birimler farklı sürelerle gözlendiğinde de işler. \(j\)’inci birimin maruziyeti \(e_j\) poliçe-yıl ise hasar sayısı \(\text{Poisson}(\lambda e_j)\) olur ve türev sıfıra eşitlenince tahmin şu çıkar:
\[ \widehat{\lambda}=\frac{\sum_j n_j}{\sum_j e_j}. \]
Log-olabilirliğin üç parçasında \(\lambda\)’nın yerini \(\lambda e_j\) alır:
\[ \begin{aligned} &\ell(\lambda)\\ &=\sum_j\bigl(-\lambda e_j+n_j\log(\lambda e_j)-\log n_j!\bigr)\\ &=-\lambda\sum_j e_j+\Bigl(\sum_j n_j\Bigr)\log\lambda+c . \end{aligned} \]
İkinci satırda \(\log(\lambda e_j)=\log\lambda+\log e_j\) ayrıldı; \(\lambda\)’ya bağlı olmayan \(n_j\log e_j\) ve \(-\log n_j!\) terimleri \(c\) sabitinde toplandı. Türevde eşit maruziyetli durumdan tek fark, \(m\)’nin yerini \(\sum_j e_j\)’nin almasıdır:
\[ \begin{aligned} \ell'(\lambda)&=-\sum_j e_j+\frac{\sum_j n_j}{\lambda}=0,\\ \widehat{\lambda}&=\frac{\sum_j n_j}{\sum_j e_j}. \end{aligned} \]
Toplam hasar sayısı bölü toplam maruziyet: bütün \(e_j\)’ler 1 olunca \(\sum_j e_j=m\) olur ve örnek ortalamasına dönülür. Hafta 10’da bu fikri Poisson GLM içinde bir ofset (offset) ile genişleteceğiz.
Poisson’u türetirken iki şey varsaydık: her poliçe aynı \(\lambda\) ile, yani her anında aynı hasar olasılığıyla çalışır, ve hasarlar birbirinden bağımsızdır. Gerçek bir portföyde bu varsayımlar dört biçimde bozulabilir:
Aşırı yayılım standart hatayı nasıl küçültür? Dört birimde 0, 0, 0 ve 4 hasar gözlenmiş olsun. Ortalama 1’dir. Örnek varyansı, ortalamadan farkların karelerini toplayıp \(m-1=3\)’e böler: üç birimin farkı \(-1\), dördüncününki 3’tür; kareleri 1, 1, 1 ve 9’dur ve \(s^{2}=(1+1+1+9)/3=4\)’tür. Poisson varyansın ortalamaya eşit, yani 1 olmasını öngörür; gözlenen varyans bunun dört katıdır.
Ortalamanın standart hatası \(\sqrt{\operatorname{Var}(N)/m}\)’dir, çünkü \(m\) bağımsız sayının ortalamasının varyansı \(\operatorname{Var}(N)/m\)’dir. Poisson varyansın yerine ortalamayı koyup \(\sqrt{1/4}=0{,}5\) der, gözlenen varyansla \(\sqrt{4/4}=1\) çıkar: Poisson’un standart hatası verinin gösterdiğinin yarısıdır. Alıştırma 2, böyle bir oranın tek bir gözleme ne kadar bağlı olabileceğini sınar.
Poisson iyi bir başlangıç modelidir; otomatik olarak doğru model değildir. Heterojenlik ve yapısal sıfırlar için birer model, aşırı yayılımın standart hatalara etkisi için de bir düzeltme vardır. Önce heterojenliğin hasar sayısının dağılımına ne yaptığını görelim; alternatifler oradan çıkar.
Poisson her poliçenin aynı \(\lambda\)’ya sahip olduğunu varsayar. Poliçeler risk düzeyinde farklıysa, yani heterojenlik varsa, portföyün dağılımı tek bir Poisson değil, Poisson’ların bir karışımı (mixture) olur: rastgele seçilen bir poliçenin önce risk grubu, yani \(\lambda\)’sı, sonra o \(\lambda\) ile hasar sayısı belirlenir. \(g\)’inci grubun payı \(w_g\), hasar hızı \(\lambda_g\) ise bir poliçenin \(k\) hasar yapma olasılığı grupların Poisson olasılıklarının paylarla ağırlıklı ortalamasıdır:
\[ P(N=k)=\sum_{g}w_g\,e^{-\lambda_g}\frac{\lambda_g^{k}}{k!}. \]
Bu, hangi modeli seçtiğimizi değiştirir: Poisson’la kalırsak standart hataları küçük, çok hasarlı bir yılın olasılığını da yok denecek kadar küçük hesaplarız.
Karışımın ne yaptığını en küçük örnekle görelim. Portföyde iki tür poliçe eşit sayıda olsun:
| Grup | Poliçelerin payı | Yıllık hasar hızı \(\lambda\) |
|---|---|---|
| düşük riskli | 1/2 | 0,1 |
| yüksek riskli | 1/2 | 0,5 |
Grubu bilinen bir poliçenin beklenen hasar sayısı o grubun \(\lambda\)’sıdır; buna koşullu beklenen değer (conditional expectation) denir: \(E[N\mid\lambda]=\lambda\). Grubu bilmiyoruz. Karışımın olasılıkları grupların olasılıklarının paylarla ağırlıklı ortalaması olduğu için beklenen değeri de grupların beklenen değerlerinin ağırlıklı ortalamasıdır, yani \(\lambda\)’nın paylarla ağırlıklı ortalaması \(E[\lambda]\):
\[ \begin{aligned} E[N]=E[\lambda]&=\tfrac12\cdot0{,}1+\tfrac12\cdot0{,}5\\ &=0{,}3 . \end{aligned} \]
Bu karışımı aynı ortalamalı \(\text{Poisson}(0{,}3)\) ile karşılaştıracağız; fark üç yerde görünür.
1. Varyans büyür. Karışımda hasar sayısı iki nedenle oynar. Grup içi oynaklık: her grup kendi içinde Poisson’dur ve varyansı kendi \(\lambda\)’sıdır (0,1 ve 0,5); portföyde ortalaması \(E[\lambda]=0{,}3\). Gruplar arası oynaklık: poliçenin grubunu bilmeyiz; \(\lambda\) yarı yarıya 0,1 ya da 0,5’tir ve iki değer de ortalamadan 0,2 uzaktır. Varyans, ortalamadan uzaklığın karesinin ortalaması olduğu için \(\operatorname{Var}(\lambda)=\tfrac12\cdot0{,}2^{2}+\tfrac12\cdot0{,}2^{2}\) \(=0{,}04\)’tür.
Toplam varyans bu iki parçanın toplamıdır:
\[ \begin{aligned} \operatorname{Var}(N)&=\underbrace{E[\lambda]}_{\text{grup içi}} +\underbrace{\operatorname{Var}(\lambda)}_{\text{gruplar arası}}\\ &=0{,}3+0{,}04=0{,}34 . \end{aligned} \]
Ortalama. Yukarıdaki \(E[N]=E[\lambda]\) şöyle çıkar: grupların koşullu beklenen değerleri paylarla ağırlıklandırılır.
\[ \begin{aligned} E[N]&=\sum_g w_g\,E[N\mid\lambda_g]\\ &=\sum_g w_g\,\lambda_g=E[\lambda]. \end{aligned} \]
İkinci satırdaki toplam, \(\lambda\)’nın paylarla ağırlıklı ortalamasıdır, yani \(E[\lambda]\).
İkinci moment ve varyans. Poisson’da \(\lambda\)’sı bilinen bir poliçe için \(E[N^{2}]=\lambda+\lambda^{2}\) bulmuştuk; ortalamadaki gibi grupların değerleri paylarla ağırlıklandırılır:
\[ \begin{aligned} E[N^{2}]&=\sum_g w_g\,E[N^{2}\mid\lambda_g]\\ &=\sum_g w_g\,(\lambda_g+\lambda_g^{2})\\ &=\sum_g w_g\,\lambda_g+\sum_g w_g\,\lambda_g^{2}\\ &=E[\lambda]+E[\lambda^{2}]. \end{aligned} \]
Üçüncü satırdaki iki toplam, \(\lambda\)’nın ve \(\lambda^{2}\)’nin paylarla ağırlıklı ortalamalarıdır, yani \(E[\lambda]\) ile \(E[\lambda^{2}]\). Bunu varyansın tanımına koyup yine her satırda tek bir işlem yapıyoruz:
\[ \begin{aligned} \operatorname{Var}(N)&=E[N^{2}]-(E[N])^{2}\\ &=E[\lambda]+E[\lambda^{2}]-(E[\lambda])^{2}\\ &=E[\lambda]+\bigl(E[\lambda^{2}]-(E[\lambda])^{2}\bigr)\\ &=E[\lambda]+\operatorname{Var}(\lambda). \end{aligned} \]
Eşitlikler sırasıyla:
İki parçanın adları koşullu büyüklüklerden gelir. Poisson’da \(E[N\mid\lambda]=\operatorname{Var}(N\mid\lambda)=\lambda\) olduğu için:
Varyansı bu iki parçaya ayıran eşitlik her karışımda geçerlidir ve toplam varyans kuralı (law of total variance) adını taşır: \(\operatorname{Var}(N)\) \(=E[\operatorname{Var}(N\mid\lambda)]\) \(+\operatorname{Var}(E[N\mid\lambda])\). Hafta 5 aynı kuralı toplam hasar \(S\)’ye uygulayacak.
\(\text{Poisson}(0{,}3)\)’ün varyansı 0,3’tür; karışımda varyansın ortalamaya oranı \(0{,}34/0{,}3=1{,}13\) olur. Bir önceki bölümün aşırı yayılımı burada nedeniyle birlikte görünüyor. Gruplar birbirinden ne kadar farklıysa gruplar arası parça da o kadar büyür.
2. Sıfırlar artar. Bir poliçenin hasarsız kalma olasılığı \(P(N=0)=e^{-\lambda}\)’dır. Karışımda iki grubun olasılıklarının ortalaması alınır:
\[ \begin{aligned} \text{düşük riskli: }&e^{-0{,}1}=0{,}9048\\ \text{yüksek riskli: }&e^{-0{,}5}=0{,}6065\\ \text{karışım: }&\tfrac{1}{2}(0{,}9048+0{,}6065)\\ &=0{,}7557\\ \text{Poisson}(0{,}3)\text{: }&e^{-0{,}3}=0{,}7408 \end{aligned} \]
Neden artar? \(\lambda\) 0,3’ten 0,1’e inince sıfır olasılığı \(e^{-0{,}1}-e^{-0{,}3}=0{,}1640\) artar, 0,5’e çıkınca yalnızca \(e^{-0{,}3}-e^{-0{,}5}=0{,}1343\) azalır. Düşük riskli grubun kazandığı sıfır, yüksek riskli grubun kaybettiğinden fazladır.
Her grup portföyün yarısı olduğu için karışımın Poisson’dan fazla sıfırı, kazanç ile kaybın farkının yarısıdır:
\[ \tfrac12(0{,}1640-0{,}1343)\approx0{,}0149 . \]
Karışımın Poisson’dan farkını bu iki değişime ayırmak için \(e^{-0{,}3}\)’ü iki yarıya bölüp her yarıyı bir grubun terimiyle eşleştiriyoruz:
\[ \begin{aligned} &\tfrac12 e^{-0{,}1}+\tfrac12 e^{-0{,}5}-e^{-0{,}3}\\ &=\tfrac12\bigl(e^{-0{,}1}-e^{-0{,}3}\bigr)\\ &\quad-\tfrac12\bigl(e^{-0{,}3}-e^{-0{,}5}\bigr)\\ &=\tfrac12(0{,}1640-0{,}1343)\approx0{,}0149 . \end{aligned} \]
Bu bir rastlantı değildir: \(e^{-\lambda}\) dışbükey (convex) bir eğridir, yani iki noktasını birleştiren doğru parçası eğrinin üstünde kalır. Karışımın sıfır olasılığı o doğru parçasının ortası, Poisson’unki eğrinin \(\lambda=0{,}3\)’teki noktası olduğundan, grupları farklı her karışım aynı ortalamalı Poisson’dan çok sıfır üretir.
3. Kuyruk uzar, ortası incelir. Ortalama aynı kaldığına göre sıfırlara giden olasılık bir yerden gelmelidir. Hasar sayısının bütün dağılımını hesaplayalım. Tabloya üçüncü bir portföy de ekliyoruz: poliçelerin yarısı hiç hasar üretemiyor (\(\lambda=0\), yukarıda adı geçen yapısal sıfır), öbür yarısının \(\lambda\)’sı 0,6. Bu portföyün ortalaması da \(\tfrac12\cdot0+\tfrac12\cdot0{,}6\) \(=0{,}3\)’tür.
hasar_sayisi_olasiliklari <- function(lambda) {
  p <- c(dpois(0:2, lambda), ppois(2, lambda, lower.tail = FALSE))
  names(p) <- c("0", "1", "2", "3+")
  p
}

karisim_dagilimi <- rbind(
  poisson         = hasar_sayisi_olasiliklari(0.3),
  karisim         = (hasar_sayisi_olasiliklari(0.1) +
                       hasar_sayisi_olasiliklari(0.5)) / 2,
  yapisal_sifirli = (hasar_sayisi_olasiliklari(0) +
                       hasar_sayisi_olasiliklari(0.6)) / 2
)
round(karisim_dagilimi, 4)
#> 0 1 2 3+
#> poisson 0.7408 0.2222 0.0333 0.0036
#> karisim 0.7557 0.1969 0.0402 0.0073
#> yapisal_sifirli 0.7744 0.1646 0.0494 0.0116dpois(0:2, lambda) — Poisson olasılığıdır; 0:2 için 0, 1 ve 2 hasarın üç olasılığını döndürür. lambda = 0 verilince sıfır hasarın olasılığı 1, ötekilerinki 0’dır: hiç hasar üretemeyen bir poliçe her yıl sıfır yapar. ppois(2, lambda, lower.tail = FALSE) — 2’den büyük bir sayının olasılığını, yani \(P(N\ge3)\)’ü verir; tablonun “3+” sütunu budur. Verilmezse: ppois() alt kuyruğu, \(P(N\le2)\)’yi döndürür ve “3+” sütununa sessizce 0,9964 gibi bir sayı yazılır. (hasar_sayisi_olasiliklari(0.1) + hasar_sayisi_olasiliklari(0.5)) / 2 — poliçelerin yarısı bir gruptan, yarısı öbüründen olduğu için portföyde bir poliçenin \(k\) hasar yapma olasılığı iki grubunkinin ortalamasıdır: yukarıdaki karışım formülü, \(w_g=1/2\) ile.rbind() — üç portföyün satırlarını adlarıyla tek tabloda toplar.Üç satırın toplamı da 1’dir ve üç portföyün ortalaması da 0,3’tür; farklı olan, olasılığın nereye dağıldığıdır:
Karışım olasılığı ortadan alıp iki uca taşır: hasarsız yıllar da iki ya da daha çok hasarlı yıllar da sıklaşır, tek hasarlı yıllar seyrekleşir. Başlıktaki fazla sıfır ile uzun kuyruk budur; ikisi de aynı nedenden, poliçelerin birbirinden farklı olmasından doğar.
Örnek iki sınırı da gösterir:
Gerçek bir portföyde iki grup yerine binlerce poliçe vardır ve hiçbirinin \(\lambda\)’sı bilinmez. Negatif binom (negative binomial) dağılımı, her poliçenin \(\lambda\)’sının ortalaması \(\mu\) olan bir Gamma dağılımından geldiğini ve \(\lambda\)’sı belli bir poliçenin hasar sayısının \(\text{Poisson}(\lambda)\) olduğunu varsayan karışımdır: iki gruplu örnekteki iki değerin yerini sürekli bir dağılım alır.
Bunun için Gamma dağılımının yoğunluğu, ortalaması ve varyansı gerekiyor.
Gamma yoğunluğu. Gamma’nın biçimini şekil parametresi (shape parameter) \(\theta>0\) belirler; ikinci parametresi \(\beta>0\)’dır. Yoğunluğu:
\[ g(\lambda)=\frac{\beta^{\theta}}{\Gamma(\theta)}\, \lambda^{\theta-1}e^{-\beta\lambda},\qquad\lambda>0 . \]
Paydadaki \(\Gamma(\theta)\) bir sayıdır: gamma fonksiyonunun (gamma function) \(\theta\)’daki değeri.
\[ \Gamma(a)=\int_0^\infty t^{a-1}e^{-t}\,dt,\qquad a>0 . \]
R’de gamma() hesaplar. \(\Gamma(a+1)=a\,\Gamma(a)\) ve \(\Gamma(1)=1\)’dir; bu yüzden tamsayılarda \(\Gamma(k+1)=k!\)’dir: gamma fonksiyonu faktöriyelin tamsayı olmayan sayılara uzanmış biçimidir.
Kısmi integrasyonla (\(u=t^{a}\), \(dv=e^{-t}\,dt\)):
\[ \begin{aligned} \Gamma(a+1)&=\int_0^\infty t^{a}e^{-t}\,dt\\ &=\Big[-t^{a}e^{-t}\Big]_0^\infty\\ &\quad+a\int_0^\infty t^{a-1}e^{-t}\,dt\\ &=0+a\,\Gamma(a). \end{aligned} \]
Sınır terimi sıfırdır: \(t=0\)’da \(t^{a}=0\), \(t\to\infty\)’da \(e^{-t}\) her kuvvetten hızlı söner. \(\Gamma(1)=\int_0^\infty e^{-t}\,dt=1\) olduğu için \(\Gamma(k+1)=k\,\Gamma(k)=\cdots\) \(=k!\,\Gamma(1)=k!\)’dir.
Bir integral özdeşliği. Gamma’nın alanı, ortalaması, varyansı ve birazdan negatif binomun olasılıkları aynı biçimde bir integrale dayanır. Her \(a>0\) ve \(b>0\) için:
\[ \int_0^\infty\lambda^{a-1}e^{-b\lambda}\,d\lambda=\frac{\Gamma(a)}{b^{a}} . \]
\(a=\theta\), \(b=\beta\) alınınca integral \(\Gamma(\theta)/\beta^{\theta}\) olur: yoğunluğun önündeki \(\beta^{\theta}/\Gamma(\theta)\) çarpanı alanı tam 1 yapan sayıdır.
\(t=b\lambda\) koyuyoruz: \(\lambda=t/b\), \(d\lambda=dt/b\); \(\lambda\) 0’dan \(\infty\)’a giderken \(t\) de 0’dan \(\infty\)’a gider.
\[ \begin{aligned} &\int_0^\infty\lambda^{a-1}e^{-b\lambda}\,d\lambda\\ &=\int_0^\infty\Big(\frac{t}{b}\Big)^{a-1}e^{-t}\,\frac{dt}{b}\\ &=\frac{1}{b^{a-1}}\cdot\frac{1}{b}\int_0^\infty t^{a-1}e^{-t}\,dt\\ &=\frac{1}{b^{a}}\,\Gamma(a). \end{aligned} \]
İkinci satırda yerine koyma yapıldı, üçüncüde \(b\)’ye bağlı çarpanlar integralin dışına alındı; dördüncüde \(b^{a-1}\cdot b=b^{a}\) birleşti ve kalan integral \(\Gamma(a)\)’nın tanımıdır.
Ortalama ve varyans. Özdeşlik Gamma’nın ortalamasını ve varyansını verir: \(E[\lambda]=\theta/\beta\), \(\operatorname{Var}(\lambda)=\theta/\beta^{2}\). Ortalamanın \(\mu\) olması için \(\beta=\theta/\mu\) seçilir; o zaman:
\[ E[\lambda]=\mu,\qquad\operatorname{Var}(\lambda)=\frac{\mu^{2}}{\theta}. \]
Ortalama. Tanımdan başlayıp her satırda tek bir işlem yapıyoruz:
\[ \begin{aligned} E[\lambda]&=\int_0^\infty\lambda\,g(\lambda)\,d\lambda\\ &=\int_0^\infty\lambda\,\frac{\beta^{\theta}}{\Gamma(\theta)}\, \lambda^{\theta-1}e^{-\beta\lambda}\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)} \int_0^\infty\lambda^{\theta}e^{-\beta\lambda}\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)}\cdot \frac{\Gamma(\theta+1)}{\beta^{\theta+1}}\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)}\cdot \frac{\theta\,\Gamma(\theta)}{\beta^{\theta}\,\beta}\\ &=\frac{\theta}{\beta}. \end{aligned} \]
Eşitlikler sırasıyla:
İkinci moment ve varyans. \(E[\lambda^{2}]\) aynı adımlarla hesaplanır. Fark üçüncü satırdadır: \(\lambda^{2}\cdot\lambda^{\theta-1}=\lambda^{\theta+1}\) olduğu için özdeşlik \(a=\theta+2\) ile uygulanır ve \(\Gamma(a+1)=a\,\Gamma(a)\) iki kez kullanılır: \(\Gamma(\theta+2)=(\theta+1)\,\Gamma(\theta+1)\) \(=(\theta+1)\,\theta\,\Gamma(\theta)\).
\[ \begin{aligned} E[\lambda^{2}]&=\frac{\beta^{\theta}}{\Gamma(\theta)} \int_0^\infty\lambda^{\theta+1}e^{-\beta\lambda}\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)}\cdot \frac{\Gamma(\theta+2)}{\beta^{\theta+2}}\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)}\cdot \frac{(\theta+1)\,\theta\,\Gamma(\theta)}{\beta^{\theta}\,\beta^{2}}\\ &=\frac{\theta(\theta+1)}{\beta^{2}}. \end{aligned} \]
Varyans, ikinci momentten ortalamanın karesini çıkarır:
\[ \begin{aligned} \operatorname{Var}(\lambda)&=E[\lambda^{2}]-E[\lambda]^{2}\\ &=\frac{\theta(\theta+1)}{\beta^{2}}-\frac{\theta^{2}}{\beta^{2}}\\ &=\frac{\theta^{2}+\theta-\theta^{2}}{\beta^{2}}\\ &=\frac{\theta}{\beta^{2}}. \end{aligned} \]
Ortalamayı \(\mu\)’ye ayarlamak. \(\beta=\theta/\mu\) iki sonuca konur:
\[ \begin{aligned} E[\lambda]&=\frac{\theta}{\beta}=\frac{\theta}{\theta/\mu}=\mu,\\ \operatorname{Var}(\lambda)&=\frac{\theta}{\beta^{2}} =\frac{\theta}{\theta^{2}/\mu^{2}}\\ &=\frac{\theta\,\mu^{2}}{\theta^{2}}=\frac{\mu^{2}}{\theta}. \end{aligned} \]
Hasar sayısının ortalaması ve varyansı. Negatif binomda bir poliçenin hasar sayısı iki adımda oluşur: önce poliçenin \(\lambda\)’sı Gamma dağılımından gelir, sonra hasar sayısı o \(\lambda\) ile \(\text{Poisson}(\lambda)\)’dan gelir. İki gruplu örnekte de adımlar bunlardı; tek fark, \(\lambda\)’nın iki değerden biri değil, Gamma’nın verebileceği herhangi bir pozitif sayı olmasıdır. Her poliçe kendi \(\lambda\)’sıyla tek başına bir grup gibidir. Bu yüzden Fazla sıfır ve uzun kuyruk nereden gelir? bölümündeki iki eşitlik olduğu gibi geçerlidir:
\[ \begin{aligned} E[N]&=E[\lambda],\\ \operatorname{Var}(N)&=\underbrace{E[\lambda]}_{\text{grup içi}} +\underbrace{\operatorname{Var}(\lambda)}_{\text{gruplar arası}} . \end{aligned} \]
Gamma’nın işi, sağ taraftaki iki büyüklüğü vermektir. İki gruplu örnekte \(E[\lambda]\) ve \(\operatorname{Var}(\lambda)\) iki değerin paylarla ağırlıklı ortalamasından geliyordu; burada Gamma’nın az önce bulduğumuz ortalaması ve varyansıdır:
| Büyüklük | İki gruplu örnek | Negatif binom |
|---|---|---|
| \(\lambda\) nereden gelir? | 0,1 ya da 0,5, yarı yarıya | Gamma: ortalama \(\mu\), şekil \(\theta\) |
| \(E[\lambda]\), grup içi parça | 0,3 | \(\mu\) |
| \(\operatorname{Var}(\lambda)\), gruplar arası parça | 0,04 | \(\mu^{2}/\theta\) |
| \(\operatorname{Var}(N)\) | \(0{,}3+0{,}04=0{,}34\) | \(\mu+\mu^{2}/\theta\) |
Tablonun son sütunu negatif binomun ortalamasını ve varyansını verir:
\[ E[N]=\mu,\qquad\operatorname{Var}(N)=\mu+\frac{\mu^{2}}{\theta}. \]
Varyansın birinci terimi, \(\lambda\)’sı bilinen poliçelerin Poisson oynaklığının ortalamasıdır; ikinci terimi Gamma’nın varyansı, yani poliçelerin risk düzeyleri arasındaki farktır.
Poisson’un ortalaması da varyansı da \(\lambda\)’dır: \(E[N\mid\lambda]=\lambda\), \(\operatorname{Var}(N\mid\lambda)=\lambda\). Ortalama için koşullu ortalamanın ortalaması alınır, varyans için toplam varyans kuralı uygulanır:
\[ \begin{aligned} E[N]&=E\big[E[N\mid\lambda]\big]=E[\lambda]=\mu,\\ \operatorname{Var}(N)&=E\big[\operatorname{Var}(N\mid\lambda)\big]\\ &\quad+\operatorname{Var}\big(E[N\mid\lambda]\big)\\ &=E[\lambda]+\operatorname{Var}(\lambda)\\ &=\mu+\frac{\mu^{2}}{\theta}. \end{aligned} \]
\(\lambda\)’nın standart sapması \(\mu/\sqrt{\theta}\), yani ortalamasının \(1/\sqrt{\theta}\) katıdır. \(\theta\) küçüldükçe poliçelerin \(\lambda\)’ları birbirinden uzaklaşır ve heterojenlik artar. \(\theta\to\infty\) iken \(\operatorname{Var}(\lambda)=\mu^{2}/\theta\) sıfıra gider: bütün poliçelerin \(\lambda\)’sı \(\mu\) olur, ikinci terim kaybolur ve Poisson’a dönülür.
Olasılık fonksiyonu. İki gruplu örnekte grupların Poisson olasılıklarını paylarla ağırlıklandırıp topluyorduk. \(\lambda\) sürekli olunca toplamın yerini integral, payların yerini Gamma yoğunluğu alır:
\[ P(N=k)=\int_0^\infty e^{-\lambda}\frac{\lambda^{k}}{k!}\, g(\lambda)\,d\lambda . \]
İntegral, özdeşlikle kapalı biçimde alınır ve negatif binomun olasılık fonksiyonunu verir (\(k=0,1,2,\ldots\)):
\[ \begin{aligned} P(N=k)&=\frac{\Gamma(k+\theta)}{\Gamma(\theta)\,k!} \left(\frac{\theta}{\theta+\mu}\right)^{\theta}\\ &\quad\times\left(\frac{\mu}{\theta+\mu}\right)^{k}. \end{aligned} \]
İntegrali her satırda tek bir işlemle alıyoruz:
\[ \begin{aligned} &P(N=k)\\ &=\int_0^\infty e^{-\lambda}\frac{\lambda^{k}}{k!}\, g(\lambda)\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)\,k!}\int_0^\infty \lambda^{k}\lambda^{\theta-1}e^{-\lambda}e^{-\beta\lambda}\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)\,k!}\int_0^\infty \lambda^{k+\theta-1}e^{-(1+\beta)\lambda}\,d\lambda\\ &=\frac{\beta^{\theta}}{\Gamma(\theta)\,k!}\cdot \frac{\Gamma(k+\theta)}{(1+\beta)^{k+\theta}}. \end{aligned} \]
Eşitlikler sırasıyla:
Paydadaki \((1+\beta)^{k+\theta}\), \((1+\beta)^{\theta}(1+\beta)^{k}\) diye ikiye ayrılır ve her parça kendi payıyla eşleşir:
\[ \begin{aligned} &P(N=k)\\ &=\frac{\Gamma(k+\theta)}{\Gamma(\theta)\,k!}\cdot \frac{\beta^{\theta}}{(1+\beta)^{\theta}}\cdot\frac{1}{(1+\beta)^{k}}\\ &=\frac{\Gamma(k+\theta)}{\Gamma(\theta)\,k!} \left(\frac{\beta}{1+\beta}\right)^{\theta} \left(\frac{1}{1+\beta}\right)^{k}. \end{aligned} \]
Son olarak \(\beta=\theta/\mu\) konur; pay ile payda \(\mu\) ile çarpılınca iki oran sadeleşir ve yukarıdaki olasılık fonksiyonu çıkar:
\[ \begin{aligned} \frac{\beta}{1+\beta}&=\frac{\theta/\mu}{1+\theta/\mu} =\frac{\theta}{\theta+\mu},\\ \frac{1}{1+\beta}&=\frac{1}{1+\theta/\mu}=\frac{\mu}{\theta+\mu}. \end{aligned} \]
Karışım olduğu için aynı ortalamadaki Poisson’dan hem daha büyük bir varyans hem daha çok sıfır üretir.
İki gruplu örnekle bağlayalım. Orada \(\lambda\)’nın ortalaması 0,3, varyansı 0,04’tü. Aynı ortalama ve varyansı veren Gamma için \(\theta=\mu^{2}/\operatorname{Var}(\lambda)\) \(=0{,}09/0{,}04=2{,}25\); \(\lambda\)’nın standart sapması ortalamasının \(1/\sqrt{2{,}25}=0{,}67\) katıdır, iki gruplu örnekteki \(0{,}2/0{,}3\)’ün aynısı.
Bu negatif binomun varyansı ve sıfır olasılığı (\(k=0\)’da olasılık fonksiyonunun yalnızca \((\theta/(\theta+\mu))^{\theta}\) çarpanı kalır):
\[ \begin{aligned} \operatorname{Var}(N)&=0{,}3+0{,}09/2{,}25=0{,}34,\\ P(N=0)&=\left(\tfrac{2{,}25}{2{,}55}\right)^{2{,}25}=0{,}7546. \end{aligned} \]
Olasılık fonksiyonunu sınayalım: karışımın tanımındaki integrali sayısal olarak alıp R’nin negatif binom işlevinin verdiğiyle yan yana koyuyoruz:
negbin_integralden <- data.frame(
  hasar    = 0:3,
  integral = sapply(0:3, function(k) {
    integrate(function(lambda) dpois(k, lambda) *
                dgamma(lambda, shape = 2.25, rate = 2.25 / 0.3),
              lower = 0, upper = Inf)$value
  }),
  formul   = dnbinom(0:3, size = 2.25, mu = 0.3)
)
round(negbin_integralden, 6)
#> hasar integral formul
#> 1 0 0.754563 0.754563
#> 2 1 0.199737 0.199737
#> 3 2 0.038185 0.038185
#> 4 3 0.006364 0.006364dgamma(lambda, shape, rate) — Gamma yoğunluğu \(g(\lambda)\)’dır; shape \(\theta\)’dır, rate ise \(\beta=\theta/\mu=7{,}5\). integrate(f, lower, upper) — bir işlevin integralini sayısal olarak hesaplar; upper = Inf sonsuza kadar demektir, $value integralin değeridir.dnbinom(k, size, mu) — negatif binomun \(P(N=k)\) olasılığıdır, yani dpois()’un negatif binom karşılığı. size \(\theta\)’dır, mu ortalamadır.İki sütun altı ondalığa kadar aynıdır: 0,754563; 0,199737; 0,038185; 0,006364.
Varyans iki gruplu karışımınkiyle aynıdır, sıfır olasılığı neredeyse aynıdır (0,7546’ya karşı 0,7557). Dağılımın tamamını karışımınkiyle yan yana koyalım:
round(rbind(
  karisim = karisim_dagilimi["karisim", ],
  negatif_binom = c(dnbinom(0:2, size = 2.25, mu = 0.3),
                    pnbinom(2, size = 2.25, mu = 0.3, lower.tail = FALSE))
), 4)
#> 0 1 2 3+
#> karisim 0.7557 0.1969 0.0402 0.0073
#> negatif_binom 0.7546 0.1997 0.0382 0.0075pnbinom(2, size, mu, lower.tail = FALSE) — ppois() gibi, 2’den büyük bir sayının olasılığını verir.İki satırın hücreleri en çok 0,003 ayrışır: 0,7546; 0,1997; 0,0382; 0,0075 karşısında 0,7557; 0,1969; 0,0402; 0,0073. Negatif binom, iki gruplu karışımın \(\lambda\)’nın iki değer yerine sürekli bir dağılımdan geldiği biçimidir. Gerçek bir portföyde grupları saymak yerine tek bir sayı, \(\theta\), tahmin edilir.
Karışım tablosunun üçüncü satırındaki yapısal sıfırlı portföyün modeli sıfır şişkin Poisson (zero-inflated Poisson) adını taşır. Bu da iki gruplu bir karışımdır. Her poliçe \(\pi\) olasılıkla hiç hasar üretemeyen yapısal sıfır grubundadır, \(1-\pi\) olasılıkla ortalaması \(\lambda\) olan bir Poisson üretir. Sıfır iki yoldan gelebilir; sıfırdan büyük bir sayı ise yalnızca Poisson grubundan gelir:
\[ \begin{aligned} P(N=0)&=\pi+(1-\pi)e^{-\lambda},\\ P(N=k)&=(1-\pi)\,\frac{e^{-\lambda}\lambda^{k}}{k!},\quad k\ge1. \end{aligned} \]
Model fazla sıfırı yapısal sıfırlarla açıklar; sıfırdan büyük sayıların olasılıkları Poisson’unkilerin \(1-\pi\) katıdır, birbirlerine oranları değişmez.
O tablodaki yapisal_sifirli satırı bu modelin \(\pi=0{,}5\) ve \(\lambda=0{,}6\) ile kurulmuş hâlidir. İki olasılığı elle bulalım (\(e^{-0{,}6}=0{,}5488\)):
\[ \begin{aligned} P(N=0)&=0{,}5+(1-0{,}5)\,e^{-0{,}6}\\ &=0{,}5+0{,}5\cdot0{,}5488\\ &=0{,}7744,\\ P(N=1)&=(1-0{,}5)\,e^{-0{,}6}\,\frac{0{,}6^{1}}{1!}\\ &=0{,}5\cdot0{,}5488\cdot0{,}6\\ &=0{,}1646. \end{aligned} \]
İkisi de tablodaki sayılardır.
Ortalama ve varyans. Poliçenin hasar hızına \(\Lambda\) diyelim: \(\pi\) olasılıkla 0, \(1-\pi\) olasılıkla \(\lambda\)’dır. Hasar sayısına Fazla sıfır ve uzun kuyruk nereden gelir? bölümündeki toplam varyans kuralını uyguluyoruz:
\[ \begin{aligned} E[N]&=(1-\pi)\,\lambda,\\ \operatorname{Var}(N)&=(1-\pi)\,\lambda\,(1+\pi\lambda). \end{aligned} \]
Hızı belli olan bir poliçede hasar sayısının varyansı hızın kendisidir: Poisson grubunda \(\lambda\), yapısal sıfır grubunda 0. Bu yüzden grup içi parça \(E[\Lambda]=(1-\pi)\,\lambda\), gruplar arası parça \(\operatorname{Var}(\Lambda)=\pi\,(1-\pi)\,\lambda^{2}\)’dir.
Hızın ortalaması, ikinci momenti ve varyansı:
\[ \begin{aligned} E[\Lambda]&=\pi\cdot0+(1-\pi)\,\lambda\\ &=(1-\pi)\,\lambda,\\ E[\Lambda^{2}]&=\pi\cdot0^{2}+(1-\pi)\,\lambda^{2}\\ &=(1-\pi)\,\lambda^{2},\\ \operatorname{Var}(\Lambda)&=E[\Lambda^{2}]-E[\Lambda]^{2}\\ &=(1-\pi)\,\lambda^{2}-(1-\pi)^{2}\,\lambda^{2}\\ &=(1-\pi)\,\lambda^{2}\,\big[1-(1-\pi)\big]\\ &=\pi\,(1-\pi)\,\lambda^{2}. \end{aligned} \]
İki parça toplam varyans kuralına konur:
\[ \begin{aligned} E[N]&=E[\Lambda]=(1-\pi)\,\lambda,\\ \operatorname{Var}(N)&=E[\Lambda]+\operatorname{Var}(\Lambda)\\ &=(1-\pi)\,\lambda+\pi\,(1-\pi)\,\lambda^{2}\\ &=(1-\pi)\,\lambda\,(1+\pi\lambda). \end{aligned} \]
Son satırda iki terimin ortak çarpanı \((1-\pi)\lambda\) dışarı alındı.
Varyansın ortalamaya oranı \(1+\pi\lambda\)’dır ve \(\pi>0\) iken 1’i aşar: yapısal sıfırlar da aşırı yayılım üretir. Örneğimizde:
\[ \begin{aligned} E[N]&=(1-0{,}5)\cdot0{,}6=0{,}3,\\ \operatorname{Var}(N)&=0{,}3\cdot(1+0{,}5\cdot0{,}6)\\ &=0{,}3\cdot1{,}3=0{,}39. \end{aligned} \]
Ortalama karışımla ve Poisson’la aynı, varyans en büyüktür.
Sigorta diliyle: Poisson, karışım, negatif binom ve sıfır şişkin örneklerin dördü de poliçe başına 0,3 hasar bekler, ama hasar sayısının varyansı 0,3 ile 0,39 arasında, yani %30’a kadar değişir. Prim ortalamaya bakar; sermaye ve reasürans (reinsurance) kararları, yani riskin bir bölümünü başka bir sigortacıya devretme kararları, bu oynaklığa da bakar.
Üçüncü alternatif bir dağılım değil, bir düzeltmedir. Yarı-Poisson (quasi-Poisson) modeli Poisson’un ortalamasını olduğu gibi bırakır, yalnızca varyansın ortalamanın sabit bir katı olduğunu varsayar: \(\operatorname{Var}(N)=\phi\,\mu\). \(\phi\)’ye yayılım parametresi (dispersion parameter) denir; Poisson’da \(\phi=1\)’dir, aşırı yayılımda \(\phi>1\). Model bir olasılık fonksiyonu yazmaz, yalnızca ortalamayı ve varyansı belirtir; adındaki “yarı” bu eksikliği anlatır.
\(\phi\) nasıl tahmin edilir? Her birimde \((N_j-\mu_j)^{2}/\mu_j\) oranının beklenen değeri \(\phi\)’dir; \(\phi\) bu oranların ortalamasıyla tahmin edilir. \(\mu_j\) bilinmediği için yerine modelin \(j\)’inci birim için tahmini \(\widehat{\mu}_j\) konur ve toplam \(m\) yerine \(m-p\)’ye bölünür; \(p\) modelin parametre sayısıdır:
\[ \widehat{\phi}=\frac{1}{m-p}\sum_{j=1}^{m} \frac{(n_j-\widehat{\mu}_j)^{2}}{\widehat{\mu}_j}. \]
\(m-p\), var()’ın \(m-1\)’i gibi tahminden gelen küçülmeyi düzeltir.
Bir birimin ortalamasından farkının karesi, ortalamada o birimin varyansıdır. İki taraf \(\mu_j\)’ye bölününce her birim aynı \(\phi\)’yi verir:
\[ \begin{aligned} E\big[(N_j-\mu_j)^{2}\big]&=\operatorname{Var}(N_j)=\phi\,\mu_j,\\ E\!\left[\frac{(N_j-\mu_j)^{2}}{\mu_j}\right]&=\phi. \end{aligned} \]
Tahmin Poisson’unkiyle aynıdır, çünkü ortalama için aynı denklem çözülür. Standart hata ise \(\sqrt{\phi}\) katına çıkar:
\[ \sqrt{\frac{\operatorname{Var}(N)}{m}}=\sqrt{\phi}\cdot\sqrt{\frac{\mu}{m}}. \]
İkinci çarpan, \(\sqrt{\mu/m}\), Poisson’un standart hatasıdır.
Poisson ne zaman yetersiz kalabilir? bölümündeki standart hatada varyansın yerine \(\phi\mu\) yazılır ve karekök iki çarpana ayrılır:
\[ \begin{aligned} \sqrt{\frac{\operatorname{Var}(N)}{m}}&=\sqrt{\frac{\phi\,\mu}{m}}\\ &=\sqrt{\phi}\cdot\sqrt{\frac{\mu}{m}}. \end{aligned} \]
0, 0, 0 ve 4 örneğinde \(\widehat{\mu}=1\) ve \(p=1\)’dir; her birimin \((n_j-1)^{2}/1\) değeri toplanıp \(m-p=3\)’e bölünür:
\[ \begin{aligned} \widehat{\phi}&=\tfrac{1}{3}\big[(0-1)^{2}+(0-1)^{2}\\ &\qquad+(0-1)^{2}+(4-1)^{2}\big]\\ &=\frac{1+1+1+9}{3}=\frac{12}{3}=4. \end{aligned} \]
Paydalar 1 olduğu için \(\widehat{\phi}\) örnek varyansıyla aynı sayıdır. Standart hata Poisson’un 0,5’inin \(\sqrt{4}=2\) katına çıkar: \(\sqrt{4}\cdot\sqrt{1/4}=2\cdot0{,}5=1\).
Aynı sayıları glm() de verir. Küçük çalışılmış örnekteki sabit terimli Poisson modelini kuruyoruz, yalnızca aile quasipoisson() oluyor:
asiri_yayilim_ornegi <- c(0, 0, 0, 4)
yari_poisson_ornegi <- glm(asiri_yayilim_ornegi ~ 1, family = quasipoisson())
round(summary(yari_poisson_ornegi)$coefficients, 4)
#> Estimate Std. Error t value Pr(>|t|)
#> (Intercept) 0 1 0 1family = quasipoisson() — poisson() ile aynı bağlantıyı (logaritma) ve aynı tahmin denklemini kullanır, ama \(\phi\)’yi veriden tahmin eder ve standart hataları \(\sqrt{\phi}\) ile çarpar.summary(model)$coefficients — özetin katsayı tablosudur: tahmin, standart hata, test istatistiği ve p değeri.Tahmin 0’dır, çünkü sabit terim \(\log\widehat{\mu}=\log1\)’dir. glm() standart hatayı \(\log\mu\) için verir. \(\log\mu\)’deki küçük bir değişim, \(\mu\)’deki değişimin \(\mu\)’ye bölümüne, yani göreli değişime yaklaşık eşittir; bu yüzden \(\log\widehat{\mu}\)’nün standart hatası, \(\widehat{\mu}\)’nünkünün \(\widehat{\mu}\)’ye bölümüdür. Burada \(\widehat{\mu}=1\) olduğu için iki ölçekte aynı sayı çıkar: standart hata 1’dir, Poisson’un 0,5’inin \(\sqrt{4}=2\) katı.
Üç alternatifin Poisson’un hangi eksiğine yanıt verdiği:
| Model | Yanıt verdiği eksik | Ne değişir? |
|---|---|---|
| Negatif binom | heterojenlik: poliçelerin \(\lambda\)’sı farklı | varyans \(\mu+\mu^{2}/\theta\) olur; sıfırlar ve çok hasarlı poliçeler artar |
| Sıfır şişkin Poisson | yapısal sıfır: hiç hasar üretemeyen poliçeler | \(P(N=0)\) artar; varyans \((1-\pi)\lambda(1+\pi\lambda)\) olur; sıfır dışındaki sayılar Poisson biçiminde kalır |
| Yarı-Poisson | aşırı yayılımın standart hatalara etkisi | tahmin aynı kalır; standart hatalar \(\sqrt{\phi}\) katına büyür |
Toplamın ikinci parçası, tek bir hasarın büyüklüğü \(X\)’tir. \(X\) pozitif bir tutardır ve dağılımı sağa çarpıktır: hasarların çoğu küçüktür, birkaçı çok büyüktür. Bu bölüm üç aday dağılımı tanıtır.
Sürekli bir \(X\)’i dört işlevle betimleriz:
R’de her dağılımın bu işlevleri aynı önekleri taşır: d yoğunluk, p dağılım fonksiyonu, q kuantil işlevi, r rastgele sayı üretimi (lognormal için dlnorm(), plnorm(), qlnorm()). Bir p işlevine lower.tail = FALSE verilince \(F(x)\) yerine aşma olasılığı \(S(x)\) döner.
\(Y\) normal dağılıyorsa \(X=e^{Y}\) lognormal dağılır; başka bir deyişle \(\log X\) normaldir. Yalnızca pozitif değer alır ve sigorta tutarlarında sık kullanılan bir başlangıç modelidir. İki parametresi, \(Y=\log X\)’in ortalaması \(\mu\) ve standart sapması \(\sigma\)’dır (R’de meanlog ve sdlog): tutarın değil, logaritmasının ortalaması ve standart sapması.
Dağılım fonksiyonu ve yoğunluk. \(\Phi\) standart normalin dağılım fonksiyonu olsun. \(x>0\) için dağılım fonksiyonu ve onun türevi olan yoğunluk:
\[ \begin{aligned} F(x)&=\Phi\!\left(\frac{\log x-\mu}{\sigma}\right),\\ f(x)&=\frac{1}{x\,\sigma\sqrt{2\pi}}\\ &\quad\times\exp\!\left(-\frac{(\log x-\mu)^{2}}{2\sigma^{2}}\right). \end{aligned} \]
Normal yoğunlukta bulunmayan \(1/x\) çarpanı, \(x\)’ten \(\log x\)’e geçişin türevinden gelir.
\[ \begin{aligned} F(x)&=P(X\le x)\\ &=P(Y\le\log x)\\ &=P\!\left(\frac{Y-\mu}{\sigma}\le\frac{\log x-\mu}{\sigma}\right)\\ &=\Phi\!\left(\frac{\log x-\mu}{\sigma}\right). \end{aligned} \]
İkinci satırda olay değişmez, çünkü \(X=e^{Y}\) ve \(\log\) artan bir işlevdir. Üçüncüde eşitsizliğin iki tarafından \(\mu\) çıkarılır ve iki taraf \(\sigma>0\)’a bölünür; eşitsizliğin yönü değişmez. Dördüncüde \((Y-\mu)/\sigma\) standart normal olduğu için olasılık \(\Phi\)’dir.
Yoğunluk \(F\)’nin türevidir. Kısaltma için \(z=(\log x-\mu)/\sigma\) yazalım; standart normalin yoğunluğu \(\varphi(z)=e^{-z^{2}/2}/\sqrt{2\pi}\)’dir:
\[ \begin{aligned} f(x)&=\frac{d}{dx}\,\Phi(z)\\ &=\varphi(z)\,\frac{dz}{dx}\\ &=\varphi(z)\,\frac{1}{x\,\sigma}\\ &=\frac{1}{x\,\sigma\sqrt{2\pi}}\\ &\quad\times\exp\!\left(-\frac{(\log x-\mu)^{2}}{2\sigma^{2}}\right). \end{aligned} \]
Eşitlikler sırasıyla:
Medyan, ortalama ve varyans. \(Y\)’nin medyanı \(\mu\)’dür ve \(\log\) artan olduğu için \(X\)’in medyanı \(e^{\mu}\)’dür. Ortalama ve ikinci moment, \(E[X]=E[e^{Y}]\) ve \(E[X^{2}]=E[e^{2Y}]\) olduğu için normalin \(E[e^{tY}]\) beklenen değerinden çıkar:
\[ E[e^{tY}]=e^{\mu t+\sigma^{2}t^{2}/2}. \]
\(t=1\) ve \(t=2\) konunca iki moment, onlardan da varyans ve standart sapmanın ortalamaya oranı çıkar:
\[ \begin{aligned} E[X]&=e^{\mu+\sigma^{2}/2},\\ E[X^{2}]&=e^{2\mu+2\sigma^{2}},\\ \operatorname{Var}(X)&=e^{2\mu+\sigma^{2}}\left(e^{\sigma^{2}}-1\right),\\ \frac{\sqrt{\operatorname{Var}(X)}}{E[X]}&=\sqrt{e^{\sigma^{2}}-1}. \end{aligned} \]
\(E[e^{tY}]\), \(e^{ty}\)’yi \(Y\)’nin yoğunluğuyla çarpıp integralini almaktır; iki üstel çarpanın üsleri toplanır:
\[ \begin{aligned} &E[e^{tY}]\\ &=\int_{-\infty}^{\infty}e^{ty}\, \frac{e^{-(y-\mu)^{2}/(2\sigma^{2})}}{\sigma\sqrt{2\pi}}\,dy\\ &=\int_{-\infty}^{\infty}\frac{1}{\sigma\sqrt{2\pi}}\, e^{\,ty-(y-\mu)^{2}/(2\sigma^{2})}\,dy. \end{aligned} \]
Üsteki ifadeyi \(\nu=\mu+\sigma^{2}t\) kısaltmasıyla kareye tamamlıyoruz:
\[ \begin{aligned} &ty-\frac{(y-\mu)^{2}}{2\sigma^{2}}\\ &=-\frac{y^{2}-2\mu y+\mu^{2}-2\sigma^{2}ty}{2\sigma^{2}}\\ &=-\frac{y^{2}-2\nu y+\mu^{2}}{2\sigma^{2}}\\ &=-\frac{(y-\nu)^{2}-\nu^{2}+\mu^{2}}{2\sigma^{2}}\\ &=-\frac{(y-\nu)^{2}}{2\sigma^{2}}+\frac{\nu^{2}-\mu^{2}}{2\sigma^{2}}\\ &=-\frac{(y-\nu)^{2}}{2\sigma^{2}}+\mu t+\frac{\sigma^{2}t^{2}}{2}. \end{aligned} \]
Eşitlikler sırasıyla:
Son satırın \(y\)’ye bağlı olmayan iki terimi integralin dışına çıkar. İçeride ortalaması \(\nu\), standart sapması \(\sigma\) olan normalin yoğunluğu kalır ve her yoğunluğun integrali 1’dir:
\[ \begin{aligned} E[e^{tY}]&=e^{\mu t+\sigma^{2}t^{2}/2}\\ &\quad\times\int_{-\infty}^{\infty} \frac{e^{-(y-\nu)^{2}/(2\sigma^{2})}}{\sigma\sqrt{2\pi}}\,dy\\ &=e^{\mu t+\sigma^{2}t^{2}/2}. \end{aligned} \]
\(t=1\) ve \(t=2\) konunca:
\[ \begin{aligned} E[X]&=E[e^{Y}]=e^{\mu+\sigma^{2}/2},\\ E[X^{2}]&=E[e^{2Y}]=e^{2\mu+4\sigma^{2}/2}\\ &=e^{2\mu+2\sigma^{2}},\\ \operatorname{Var}(X)&=E[X^{2}]-E[X]^{2}\\ &=e^{2\mu+2\sigma^{2}}-\big(e^{\mu+\sigma^{2}/2}\big)^{2}\\ &=e^{2\mu+2\sigma^{2}}-e^{2\mu+\sigma^{2}}\\ &=e^{2\mu+\sigma^{2}}\,e^{\sigma^{2}}-e^{2\mu+\sigma^{2}}\\ &=e^{2\mu+\sigma^{2}}\left(e^{\sigma^{2}}-1\right). \end{aligned} \]
Standart sapmanın ortalamaya oranında varyansın ilk çarpanının karekökü, \(\sqrt{e^{2\mu+\sigma^{2}}}=e^{\mu+\sigma^{2}/2}\), ortalamanın kendisidir ve sadeleşir:
\[ \begin{aligned} \frac{\sqrt{\operatorname{Var}(X)}}{E[X]} &=\frac{e^{\mu+\sigma^{2}/2}\sqrt{e^{\sigma^{2}}-1}}{e^{\mu+\sigma^{2}/2}}\\ &=\sqrt{e^{\sigma^{2}}-1}. \end{aligned} \]
Ortalama medyanın \(e^{\mu+\sigma^{2}/2}/e^{\mu}=e^{\sigma^{2}/2}\) katıdır; \(\sigma>0\) olduğu için hep üstünde kalır, sağa çarpıklık formülde böyle görünür. Standart sapmanın ortalamaya oranı da yalnızca \(\sigma\)’ya bağlıdır: \(\sigma\) büyüdükçe dağılım sağa uzar ve ortalama medyandan uzaklaşır.
Parametre tahmini. Lognormalin maksimum olabilirlik tahminleri, logaritmaların ortalaması ve paydası \(n\) olan standart sapmasıdır; Lognormal tahminleri: kapalı biçim, payda ve model ortalaması bölümü nedenini verir ve veride uygular.
Sayısal örnek. \(\mu=0{,}8\) ve \(\sigma=0{,}7\) olsun. Formüllerdeki üsler:
\[ \begin{aligned} \sigma^{2}&=0{,}7^{2}=0{,}49,\\ \mu+\sigma^{2}/2&=0{,}8+0{,}245=1{,}045,\\ 2\mu+\sigma^{2}&=1{,}6+0{,}49=2{,}09. \end{aligned} \]
Formüller şu sayıları verir:
| Büyüklük | \(\mu=0{,}8\), \(\sigma=0{,}7\) ile |
|---|---|
| medyan | \(e^{0{,}8}=2{,}23\) |
| ortalama | \(e^{1{,}045}=2{,}84\) |
| varyans | \(e^{2{,}09}(e^{0{,}49}-1)\) \(=8{,}085\cdot0{,}6323=5{,}112\) |
| standart sapma / ortalama | \(\sqrt{0{,}6323}=0{,}795\) |
Ortalama medyanın \(e^{0{,}245}=1{,}28\) katıdır; \(0{,}245=\sigma^{2}/2\).
Aşma olasılığı \(S(x)=1-F(x)\) \(=1-\Phi\big((\log x-\mu)/\sigma\big)\)’dir. \(x=10\)’da elle:
\[ \begin{aligned} z&=\frac{\log 10-0{,}8}{0{,}7}=\frac{2{,}3026-0{,}8}{0{,}7}\\ &=\frac{1{,}5026}{0{,}7}=2{,}1466,\\ S(10)&=1-\Phi(2{,}1466)\\ &=1-0{,}9841=0{,}0159. \end{aligned} \]
Bu lognormalde hasarların yaklaşık %1,6’sı 10’u aşar.
Gamma dağılımını Negatif binom bölümünde poliçelerin \(\lambda\)’ları için kullandık; burada hasar tutarının dağılımıdır. Lognormal gibi yalnızca pozitif değer alır ve sağa çarpıktır. Yoğunluk fonksiyonu (\(x>0\)), oradaki \(g(\lambda)\)’nın \(\theta\) yerine \(\alpha\), \(\lambda\) yerine \(x\) yazılmış hâlidir:
\[ f(x)=\frac{\beta^{\alpha}}{\Gamma(\alpha)}\,x^{\alpha-1}e^{-\beta x}. \]
Formülün üç parçası vardır:
shape. Yoğunluğun biçimini belirler: \(\alpha\le1\) iken yoğunluk sıfırın yakınında en yüksektir ve hep azalır; \(\alpha>1\) iken önce artar, sonra azalır.rate. Tersi \(1/\beta\)’ya ölçek parametresi (scale parameter) denir ve tutarın biriminde ölçülür: tutarlar \(c\) katına çıkarsa ölçek de \(c\) katına çıkar (oran \(\beta/c\) olur), \(\alpha\) değişmez. dgamma(), rate yerine scale \(=1/\beta\) argümanını da kabul eder; adsız yazılan üçüncü argüman rate sayılır.Momentler. Negatif binom bölümünde \(\lambda\) için türettiğimiz ortalama ve varyans, \(\theta\) yerine \(\alpha\) ile aynen geçer; ikinci moment de oradaki gibi \(\Gamma(\alpha+2)=(\alpha+1)\,\alpha\,\Gamma(\alpha)\)’dan gelir:
\[ \begin{aligned} E[X]&=\frac{\alpha}{\beta},\\ E[X^{2}]&=\frac{\alpha(\alpha+1)}{\beta^{2}},\\ \operatorname{Var}(X)&=\frac{\alpha}{\beta^{2}}=\frac{E[X]^{2}}{\alpha}. \end{aligned} \]
Varyans ortalamanın karesiyle orantılı olduğu için standart sapma ortalamayla orantılıdır. Oranlarında \(\beta\) sadeleşir:
\[ \frac{\sqrt{\operatorname{Var}(X)}}{E[X]}=\frac{1}{\sqrt{\alpha}}. \]
\[ \begin{aligned} \operatorname{Var}(X)&=\frac{\alpha}{\beta^{2}} =\frac{1}{\alpha}\cdot\frac{\alpha^{2}}{\beta^{2}}\\ &=\frac{E[X]^{2}}{\alpha},\\ \frac{\sqrt{\operatorname{Var}(X)}}{E[X]} &=\frac{\sqrt{\alpha}/\beta}{\alpha/\beta}\\ &=\frac{\sqrt{\alpha}}{\alpha}=\frac{1}{\sqrt{\alpha}}. \end{aligned} \]
Oran ortalamaya bağlı değildir. Ortalaması iki kat büyük bir hasar türünün standart sapması da iki kat büyüktür; tutarlar her büyüklükte ortalamalarına göre aynı ölçüde oynar.
Gamma’nın çarpıklığı (skewness), yani üçüncü merkezi momentin standart sapmanın küpüne bölümü, \(2/\sqrt{\alpha}\)’dır; \(\alpha\) büyüdükçe Gamma simetrikleşir.
Aşma olasılığı. \(S(x)=\int_x^\infty f(t)\,dt\) integralinin, \(\alpha\) tamsayı değilse, kapalı bir formülü yoktur; pgamma(..., lower.tail = FALSE) onu sayısal olarak hesaplar.
Sayısal örnek. \(\alpha=2{,}5\) ve \(\beta=0{,}8\) olsun:
| Büyüklük | \(\alpha=2{,}5\), \(\beta=0{,}8\) ile |
|---|---|
| ortalama | \(2{,}5/0{,}8=3{,}125\) |
| \(E[X^{2}]\) | \(2{,}5\cdot3{,}5/0{,}8^{2}=8{,}75/0{,}64=13{,}672\) |
| varyans | \(2{,}5/0{,}8^{2}=2{,}5/0{,}64=3{,}906\) |
| standart sapma | \(\sqrt{3{,}906}=1{,}976\) |
| standart sapma / ortalama | \(1{,}976/3{,}125=0{,}632\) |
| çarpıklık | \(2/\sqrt{2{,}5}=1{,}26\) |
Bu dağılım, çok büyük tutarlara lognormal ya da Gamma’dan daha fazla olasılık verebilen ağır kuyruklu bir modeldir. “Sıfır başlangıçlı” adı tanım aralığının sıfırdan başladığını söyler; klasik Pareto yalnızca bir alt sınırın üstündeki tutarları tanımlar. actuar paketi bu biçimi dpareto() adıyla verir; literatürde Pareto II ya da Lomax olarak da anılır.
Dağılım en kısa biçimde aşma olasılığıyla tanımlanır (\(x>0\)):
\[ S(x)=P(X>x)=\left(\frac{\theta}{\theta+x}\right)^{\alpha}. \]
\(S(0)=1\)’dir ve \(x\) büyüdükçe \(S(x)\) sıfıra iner. İki parametresi vardır:
shape) ve kuyruğun ağırlığını belirler: parantezin içi 0 ile 1 arasında olduğundan \(\alpha\) küçüldükçe her \(x\)’te aşma olasılığı büyür.scale) ve tutarın biriminde ölçülür: tutarlar \(c\) katına çıkarsa \(\theta\) da \(c\) katına çıkar, \(\alpha\) değişmez. Yoğunluk. \(F=1-S\) olduğu için yoğunluk \(f(x)=F'(x)=-S'(x)\)’tir:
\[ f(x)=\frac{\alpha\,\theta^{\alpha}}{(\theta+x)^{\alpha+1}}. \]
\(S\) yerine \(\theta^{\alpha}(\theta+x)^{-\alpha}\) yazılır. \(\theta^{\alpha}\) sabit bir çarpandır; \((\theta+x)^{-\alpha}\)’nın türevi kuvvet kuralıyla alınır ve içteki \(\theta+x\)’in türevi 1’dir:
\[ \begin{aligned} f(x)&=-\frac{d}{dx}\,\theta^{\alpha}(\theta+x)^{-\alpha}\\ &=-\theta^{\alpha}\cdot(-\alpha)\,(\theta+x)^{-\alpha-1}\\ &=\alpha\,\theta^{\alpha}\,(\theta+x)^{-(\alpha+1)}\\ &=\frac{\alpha\,\theta^{\alpha}}{(\theta+x)^{\alpha+1}}. \end{aligned} \]
Üçüncü satırda iki eksi işareti birbirini götürdü, dördüncüde negatif üslü çarpan paydaya alındı.
Ortalama. Pozitif bir \(X\) için ortalama, aşma olasılığının integralidir, \(E[X]=\int_0^\infty S(t)\,dt\): \(X\), \([0,X)\) aralığının uzunluğudur ve bir \(t\ge0\) noktası bu aralıkta ancak \(X>t\) ise, yani \(S(t)\) olasılıkla bulunur. Pareto II’de bu integral açıkça alınır:
\[ E[X]=\frac{\theta}{\alpha-1},\qquad\alpha>1 . \]
\(\alpha\le1\) ise integral sonsuzdur ve ortalama yoktur.
\[ \begin{aligned} E[X]&=\int_0^\infty\theta^{\alpha}(\theta+x)^{-\alpha}\,dx\\ &=\theta^{\alpha}\left[\frac{(\theta+x)^{1-\alpha}}{1-\alpha}\right]_0^\infty\\ &=\theta^{\alpha}\left(0-\frac{\theta^{1-\alpha}}{1-\alpha}\right)\\ &=\theta^{\alpha}\cdot\frac{\theta^{1-\alpha}}{\alpha-1}\\ &=\frac{\theta}{\alpha-1}. \end{aligned} \]
Eşitlikler sırasıyla:
Üçüncü satırdaki sıfır yalnızca \(\alpha>1\) iken doğrudur, çünkü ancak o zaman \(1-\alpha\) üssü negatiftir.
Varyans. Aynı gerekçe ikinci momente de uygulanır: \(X^{2}=\int_0^{X}2t\,dt\) ve bir \(t\) noktası \([0,X)\) aralığında ancak \(X>t\) ise bulunur, bu yüzden \(E[X^{2}]=\int_0^\infty 2t\,S(t)\,dt\)’dir. Pareto II’de bu integral ve ondan çıkan varyans:
\[ \begin{aligned} E[X^{2}]&=\frac{2\theta^{2}}{(\alpha-1)(\alpha-2)},\\ \operatorname{Var}(X)&=\frac{\alpha\,\theta^{2}}{(\alpha-1)^{2}(\alpha-2)}. \end{aligned} \]
İntegrali almak için \(t\)’yi \((\theta+t)-\theta\) diye yazıyoruz; böylece içeride yalnızca \(\theta+t\)’nin kuvvetleri kalır. Bunların integrali ortalamadaki hesabın aynısıdır: \(a>1\) için \(\int_0^\infty(\theta+t)^{-a}\,dt=\theta^{1-a}/(a-1)\).
\[ \begin{aligned} E[X^{2}]&=\int_0^\infty 2t\,\theta^{\alpha}(\theta+t)^{-\alpha}\,dt\\ &=2\theta^{\alpha}\int_0^\infty\big[(\theta+t)-\theta\big]\\ &\qquad\times(\theta+t)^{-\alpha}\,dt\\ &=2\theta^{\alpha}\int_0^\infty(\theta+t)^{1-\alpha}\,dt\\ &\quad-2\theta^{\alpha+1}\int_0^\infty(\theta+t)^{-\alpha}\,dt\\ &=2\theta^{\alpha}\,\frac{\theta^{2-\alpha}}{\alpha-2}\\ &\quad-2\theta^{\alpha+1}\,\frac{\theta^{1-\alpha}}{\alpha-1}\\ &=\frac{2\theta^{2}}{\alpha-2}-\frac{2\theta^{2}}{\alpha-1}\\ &=2\theta^{2}\,\frac{(\alpha-1)-(\alpha-2)}{(\alpha-1)(\alpha-2)}\\ &=\frac{2\theta^{2}}{(\alpha-1)(\alpha-2)}. \end{aligned} \]
Eşitlikler sırasıyla:
Varyans, ikinci momentten ortalamanın karesini çıkarır; iki kesir \((\alpha-1)^{2}(\alpha-2)\) paydasında birleşir:
\[ \begin{aligned} &\operatorname{Var}(X)\\ &=E[X^{2}]-E[X]^{2}\\ &=\frac{2\theta^{2}}{(\alpha-1)(\alpha-2)}-\frac{\theta^{2}}{(\alpha-1)^{2}}\\ &=\frac{\theta^{2}\big[2(\alpha-1)-(\alpha-2)\big]}{(\alpha-1)^{2}(\alpha-2)}\\ &=\frac{\alpha\,\theta^{2}}{(\alpha-1)^{2}(\alpha-2)}. \end{aligned} \]
Köşeli parantezin içi \(2\alpha-2-\alpha+2=\alpha\)’dır.
\(k\)’inci momentte \(t^{k-1}\) aynı yolla \(\theta+t\)’nin kuvvetlerine açılır; en büyüğü \((\theta+t)^{k-1-\alpha}\)’dır ve integrali \((\theta+t)^{k-\alpha}\)’yı verir. Bu terim üst sınırda ancak \(\alpha>k\) iken sıfıra gider.
\(E[X^{k}]\) ancak \(\alpha>k\) iken sonludur: ortalama yalnızca \(\alpha>1\), varyans yalnızca \(\alpha>2\) iken vardır. Ortalamaya ya da varyansa dayanan bir hesaba geçmeden önce tahmin edilen \(\alpha\)’ya bu nedenle bakılır.
Sayısal örnek. \(\alpha=3\) ve \(\theta=6\) olsun; \(x=10\)’da \(\theta+x=16\)’dır:
| Büyüklük | \(\alpha=3\), \(\theta=6\) ile |
|---|---|
| yoğunluk, \(x=10\) | \(3\cdot6^{3}/16^{4}=648/65.536=0{,}00989\) |
| ortalama | \(6/(3-1)=6/2=3\) |
| \(E[X^{2}]\) | \(2\cdot6^{2}/(2\cdot1)=72/2=36\) |
| varyans | \(36-3^{2}=36-9=27\) |
| standart sapma / ortalama | \(\sqrt{27}/3=\sqrt{3}=1{,}73\) |
| aşma olasılığı, \(x=10\) | \((6/16)^{3}=0{,}0527\) |
Tablodaki oranın genel biçimi:
\[ \frac{\sqrt{\operatorname{Var}(X)}}{E[X]}=\sqrt{\frac{\alpha}{\alpha-2}}. \]
Varyansın karekökünü ortalamaya, \(\theta/(\alpha-1)\)’e bölüyoruz. Karekökten \(\theta/(\alpha-1)\) çarpanı çıkar ve ortalamayla sadeleşir:
\[ \begin{aligned} &\frac{\sqrt{\operatorname{Var}(X)}}{E[X]}\\ &=\sqrt{\frac{\alpha\,\theta^{2}}{(\alpha-1)^{2}(\alpha-2)}} \cdot\frac{\alpha-1}{\theta}\\ &=\frac{\theta}{\alpha-1}\sqrt{\frac{\alpha}{\alpha-2}} \cdot\frac{\alpha-1}{\theta}\\ &=\sqrt{\frac{\alpha}{\alpha-2}}. \end{aligned} \]
\(\alpha=3\)’te oran \(\sqrt{3/1}=\sqrt{3}\)’tür, tablodaki gibi. Hasarların %5,3’ü 10’u aşar.
Yukarıdaki üç örneğin ortalamaları birbirine yakındır, standart sapmaları ise ayrılır. Standart sapma, yukarıdaki üç tablonun varyansının kareköküdür: \(\sqrt{5{,}112}\), \(\sqrt{3{,}906}\) ve \(\sqrt{27}\).
| lognormal | Gamma | Pareto II | |
|---|---|---|---|
| ortalama | 2,84 | 3,125 | 3 |
| standart sapma | 2,26 | 1,98 | 5,20 |
Asıl fark kuyruktadır. Her birinin 10, 20 ve 50’yi aşma olasılığını hesaplayalım:
kuyruk_olasiliklari <- rbind(
  lognormal = plnorm(c(10, 20, 50), meanlog = 0.8, sdlog = 0.7,
                     lower.tail = FALSE),
  gamma     = pgamma(c(10, 20, 50), shape = 2.5, rate = 0.8,
                     lower.tail = FALSE),
  pareto_ii = (6 / (6 + c(10, 20, 50)))^3
)
colnames(kuyruk_olasiliklari) <- c("10", "20", "50")
signif(kuyruk_olasiliklari, 3)
#> 10 20 50
#> lognormal 0.01590 8.54e-04 4.38e-06
#> gamma 0.00684 5.94e-06 8.39e-16
#> pareto_ii 0.05270 1.23e-02 1.23e-03plnorm(q, meanlog, sdlog, lower.tail = FALSE) ve pgamma(q, shape, rate, lower.tail = FALSE) — \(P(X>q)\)’yu, yani aşma olasılığını verir. Pareto II’ninki yukarıdaki \(\left(\theta/(\theta+x)\right)^{\alpha}\) formülünün kendisidir.colnames(x) <- c("10", "20", "50") — matrisin sütunlarına ad verir; burada her sütun, aşılma olasılığı sorulan tutardır.signif(x, 3) — her sayıyı üç anlamlı basamağa yuvarlar. Çok küçük sayılar bilimsel gösterimle yazılır: 8.39e-16, \(8{,}39\cdot10^{-16}\) demektir.10’u aşma olasılıkları birbirine yakındır: lognormal 0,0159, Gamma 0,00684, Pareto II 0,0527; en büyüğü en küçüğünün 7,7 katıdır.
Tutar büyüdükçe ayrılırlar: 50’yi aşma olasılığı Pareto II’de hâlâ binde bir dolayındadır (0,00123), lognormalde milyonda dört (\(4{,}38\cdot10^{-6}\)), Gamma’da \(10^{-15}\)’in altındadır.
Farkı, tutar iki katına çıkınca aşma olasılığının ne oranda küçüldüğü açıklar. Tablonun ilk iki sütunundan:
| Model | \(P(X>10)\) | \(P(X>20)\) | \(P(X>20)/P(X>10)\) |
|---|---|---|---|
| Gamma | 0,00684 | \(5{,}94\cdot10^{-6}\) | 0,00087 |
| lognormal | 0,0159 | 0,000854 | 0,054 |
| Pareto II | 0,0527 | 0,0123 | 0,23 |
Pareto II’nin \(2^{\alpha}\)’sı, tutar iki katına çıkınca \(\theta\)’ların sadeleşmesinden gelir:
\[ \begin{aligned} \frac{S(2x)}{S(x)}&=\left(\frac{\theta}{\theta+2x}\cdot \frac{\theta+x}{\theta}\right)^{\alpha}\\ &=\left(\frac{\theta+x}{\theta+2x}\right)^{\alpha}. \end{aligned} \]
\(x\), \(\theta\)’ya göre büyükse parantezin içi \(x/(2x)=1/2\)’ye yaklaşır ve oran \((1/2)^{\alpha}=1/8\)’e iner. \(x=10\)’da \(\theta=6\) henüz küçük sayılmaz: oran \((16/26)^{3}=0{,}233\)’tür, tablodaki 0,23 budur.
Ortalamaları birbirine yakın üç model büyük bir hasarın olasılığına bu kadar farklı yanıt verdiği için büyüklük modelini seçmek, kuyruk riskini de seçmektir. Kuyruk: Q–Q grafiği ve yüksek kuantiller bölümü aynı soruyu Danish verisinde soracak.
Bir modeli veriye uydurmak, modelin veriye uyduğunu göstermez. Uyumu bu hafta iki yoldan okuyoruz. Tablolar ve grafikler modelin beklediğini gözlenenle yan yana koyar ve modelin nerede yanıldığını gösterir. Sayısal ölçütler ise adayları sıralar ve hangisinin daha iyi olduğunu söyler. Biri öbürünün yerine geçmez: en iyi aday da kötü olabilir.
Dört araç kullanıyoruz: sayım verisi için gözlenen–beklenen sıklık tablosu ile ki-kare uyum testi (chi-squared goodness-of-fit test), sürekli veri için histogram ile Q–Q grafiği (quantile–quantile plot). Histogram dağılımın genel biçimini gösterir ama kuyruğu göstermez, çünkü büyük tutarların çubukları neredeyse boştur. Dördünü de paketlerle uydurma bölümleri gerçek veride kurar; tabloyu ve Q–Q grafiğini aşağıda önce küçük örneklerde kuruyoruz.
\(m\) poliçelik bir portföyde \(k\) hasarlı poliçelerin beklenen sayısı \(E_k=m\,P(N=k)\)’dir, çünkü her poliçe \(k\) hasarı \(P(N=k)\) olasılıkla yapar. Beklenen sayıların \(m\)’ye toplanması için son hücre “\(k\) ya da daha fazla” biçiminde kurulur.
Tabloyu Küçük çalışılmış örnek: Poisson bölümündeki dört birimde kuralım: 0, 1, 0, 3 sayılarında iki birim hiç hasar yapmamış, biri bir, biri üç hasar yapmış. \(\widehat{\lambda}=1\) olan Poisson’un her sayı için beklediği birim sayısı \(4\,P(N=k)\)’dir; örneğin \(E_0=4\,e^{-1}=4\cdot0{,}3679\) \(=1{,}472\). Kod tabloyu kurar:
ornek_tablo <- rbind(
  gozlenen = c("0" = sum(n == 0), "1" = sum(n == 1), "2" = sum(n == 2),
               "3+" = sum(n >= 3)),
  beklenen = length(n) * c(dpois(0:2, lambda_acik),
                           ppois(2, lambda_acik, lower.tail = FALSE))
)
round(ornek_tablo, 3)
#> 0 1 2 3+
#> gozlenen 2.000 1.000 0.000 1.000
#> beklenen 1.472 1.472 0.736 0.321ppois(2, lambda_acik, lower.tail = FALSE) — 2’den büyük bir sayının olasılığını, yani \(P(N\ge3)\)’ü verir; son hücre budur. Dört olasılığın toplamı 1, beklenen sayıların toplamı 4’tür.Model iki uçta az bekliyor: sıfır hasar için 1,472 birim (gözlenen 2), üç ve daha fazlası için 0,321 (gözlenen 1). Aradaki 1 ve 2 hasar için ise fazla bekliyor: 1,472 ve 0,736 (gözlenen 1 ve 0).
Beklenen sayıların hepsi 5’in altında olduğu için bu tabloya ki-kare testi uygulanmaz: dört gözlem bir sınama için yetmez, tablo yalnızca modelin nerede yanıldığını gösterir. Sıklık bölümündeki 40.000 poliçede de Poisson sıfırları ve çok hasarlı poliçeleri az, tek hasarlıları fazla bekleyecek.
Tablonun farklarını tek bir sayıda toplayan istatistik, Hafta 2’deki bağımsızlık testinin istatistiğidir. \(O_k\) \(k\)’inci hücrede gözlenen, \(E_k\) modelin beklediği sayı olmak üzere:
\[ \chi^{2}=\sum_{k}\frac{(O_k-E_k)^{2}}{E_k}. \]
Hafta 2’de beklenen sayı satır ve sütun toplamlarından geliyordu; burada uydurulan modelden gelir. Farkın karesini \(E_k\)’ye bölmek farkı hücrenin büyüklüğüne göre ölçer: bir sayımın varyansı kabaca ortalamasıdır, bu yüzden model doğruysa \(O_k\), \(E_k\)’nin çevresinde kabaca \(\sqrt{E_k}\) kadar oynar. Her terim farkı bu oynaklığa bölüp karesini alır:
\[ \frac{(O_k-E_k)^{2}}{E_k}=\left(\frac{O_k-E_k}{\sqrt{E_k}}\right)^{2}. \]
Serbestlik derecesi. Model doğruysa ve hücrelerin beklenen sayıları yeterince büyükse \(\chi^{2}\) yaklaşık olarak bir ki-kare dağılımına uyar. Bu dağılımın tek parametresi, serbestlik derecesi \(\nu\), farklardan kaçının gerçekten serbest olduğunu sayar. \(h\) hücre sayısı, \(p\) veriden tahmin edilen parametre sayısı olmak üzere:
\[ \nu=h-1-p. \]
İki çıkarmanın iki nedeni var:
p değeri, model doğru olsaydı en az bu büyüklükte bir \(\chi^{2}\) görme olasılığıdır: \(\nu\) serbestlik dereceli ki-kare dağılımının, hesaplanan istatistiğin sağında kalan alanı. Küçük bir p değeri, farkın şansla açıklanamayacağını söyler. Büyük bir p değeri ise modeli doğrulamaz: küçük bir veri küçük bir sapmayı yakalamaya yetmeyebilir.
Küçük hücreler. Ki-kare dağılımına yaklaşım, her hücrede beklenen sayı yeterince büyükken geçerlidir; yaygın kural en az 5’tir. Küçük bir \(E_k\)’ye bölmek tek bir poliçenin farkını büyütür. Böyle hücreler komşusuyla birleştirilir; sıklık bölümündeki “4+” hücresi böyle doğar.
Hafta 2’deki chisq.test()’e gözlenen sayılar ve hücre olasılıkları verilirse aynı istatistiği hesaplar, ama serbestlik derecesini \(h-1\) alır: tahmin edilen parametreyi düşmez ve bunun için uyarı da vermez. Parametresi veriden tahmin edilmiş bir modelde p değerini pchisq() ile, \(\nu=h-1-p\) ile hesaplarız.
\(n\) gözlem küçükten büyüğe dizilince \(i\)’inci gözleme \(x_{(i)}\) denir. Altında \(i-1\) gözlem vardır; kendisi yarım sayılınca gözlemlerin yaklaşık \((i-0{,}5)/n\)’lik kısmı \(x_{(i)}\)’nin altında kalır (\(i/n\) alınsaydı en büyük gözlemin kuantili \(F^{-1}(1)\), yani sonsuz olurdu). Q–Q grafiği her gözlemi modelin aynı olasılıktaki kuantiline karşı çizer (\(i=1,\ldots,n\)):
\[ \left(F^{-1}\!\left(\frac{i-0{,}5}{n}\right),\; x_{(i)}\right). \]
Model doğruysa noktalar \(y=x\) doğrusunun çevresinde durur; en büyük gözlemler sağ üst uca düştüğü için kuyruktaki uyumsuzluk en açık burada görünür.
Grafiği beş hasarlık bir örnekte kuralım: 1,2; 1,5; 2,0; 3,1 ve 9,0 mDKK. Model olarak lognormali alıyoruz. Parametrelerini, Lognormal bölümünde andığımız gibi, logaritmaların ortalaması ve paydası \(n\) olan standart sapmasıyla bulalım:
bes_hasar <- c(1.2, 1.5, 2.0, 3.1, 9.0)
qq_ornek_parametre <- c(
  meanlog = mean(log(bes_hasar)),
  sdlog = sqrt(mean((log(bes_hasar) - mean(log(bes_hasar)))^2))
)
round(qq_ornek_parametre, 4)
#> meanlog sdlog
#> 0.9219 0.7122meanlog 0,9219, sdlog 0,7122 çıkmalıdır.
Şimdi her gözleme sırasının olasılığını, \((i-0{,}5)/5\)’i, ve modelin o olasılıktaki kuantilini verelim. Lognormalin kuantili, \(F(x)=p\) eşitliğinin \(x\) için çözümüdür. \(z_p=\Phi^{-1}(p)\) standart normalin \(p\) kuantilidir, R’de qnorm(p). Eşitliğin çözümü lognormalin kuantil işlevini verir:
\[ F^{-1}(p)=e^{\mu+\sigma z_p}. \]
\(F(x)=p\) eşitliğinde \(F(x)\)’in yerine Lognormal bölümündeki dağılım fonksiyonu yazılır ve eşitlik satır satır \(x\) için çözülür:
\[ \begin{aligned} \Phi\!\left(\frac{\log x-\mu}{\sigma}\right)&=p,\\ \frac{\log x-\mu}{\sigma}&=z_p,\\ \log x&=\mu+\sigma z_p,\\ x&=e^{\mu+\sigma z_p}. \end{aligned} \]
İkinci satır iki tarafa \(\Phi^{-1}\)’i uygular, üçüncüsü iki tarafı \(\sigma\) ile çarpıp \(\mu\) ekler, dördüncüsü iki tarafın üssünü alır.
qq_ornek <- data.frame(
  sira = 1:5,
  olasilik = (1:5 - 0.5) / 5,
  kuramsal = qlnorm((1:5 - 0.5) / 5,
                    meanlog = qq_ornek_parametre[["meanlog"]],
                    sdlog = qq_ornek_parametre[["sdlog"]]),
  gozlenen = sort(bes_hasar)
)
qq_ornek
#> sira olasilik kuramsal gozlenen
#> 1 1 0.1 1.009196 1.2
#> 2 2 0.3 1.730514 1.5
#> 3 3 0.5 2.514093 2.0
#> 4 4 0.7 3.652477 3.1
#> 5 5 0.9 6.263071 9.0qlnorm(p, meanlog, sdlog) — lognormalin kuantil işlevi: dağılım fonksiyonunun p değerini aldığı tutarı, \(e^{\mu+\sigma z_p}\)’yi verir.sort(bes_hasar) — gözlemleri küçükten büyüğe dizer; \(i\)’inci satır \(i\)’inci en küçük gözlemdir. Grafikte her satır bir noktadır. geom_abline(slope = 1, intercept = 0) \(y=x\) doğrusunu çizer; noktalar ona göre okunur:
ggplot(qq_ornek, aes(x = kuramsal, y = gozlenen)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2, colour = "#1A2238") +
  geom_point(colour = "#1F4E79", size = 2.5) +
  scale_x_continuous(labels = label_number(decimal.mark = ",")) +
  scale_y_continuous(labels = label_number(decimal.mark = ",")) +
  labs(x = "Kuramsal kuantil (mDKK)", y = "Gözlenen hasar (mDKK)") +
  theme_minimal(base_size = 12)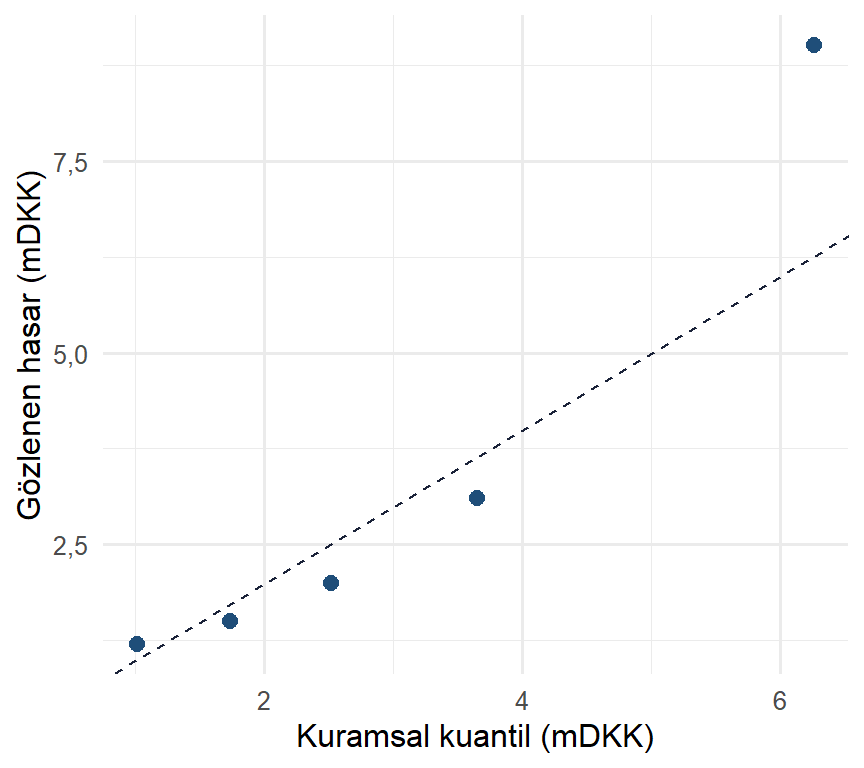
Ortadaki üç nokta doğrunun biraz altında; en büyük hasar ise, 9,0 mDKK, modelin %90 kuantilinin (6,26 mDKK) belirgin biçimde üstünde: model bu küçük örnekte en büyük hasarı olduğundan küçük tahmin ediyor. Beş noktayla bu bir kanıt değildir, grafiğin nasıl okunduğunu gösterir; aynı okumayı büyüklük bölümünde 2.167 Danish hasarında yapacağız.
Sayısal ölçütlerin üçü de log-olabilirlikten başlar; \(\widehat{f}\), tahmin edilen parametrelerle kurulmuş olasılık ya da yoğunluk fonksiyonudur.
Log-olabilirlik (log-likelihood) — gözlenen her değerin model altındaki olasılığının (sürekli veride yoğunluğunun) logaritmalarının toplamıdır:
\[ \ell=\sum_{i=1}^{n}\log\widehat{f}(x_i). \]
Büyüğü daha iyidir. Ama bir toplam olduğu için gözlem sayısı ya da tutarların birimi değişince de değişir (Alıştırma 13); yalnızca aynı veriye uydurulmuş modeller arasında karşılaştırılabilir.
AIC — Akaike bilgi ölçütü (Akaike information criterion) — \(k\) tahmin edilen parametre sayısı olmak üzere:
\[ \mathrm{AIC}=2k-2\ell. \]
Küçüğü daha iyidir.
BIC — Bayes bilgi ölçütü (Bayesian information criterion) — \(n\) gözlem sayısı olmak üzere:
\[ \mathrm{BIC}=k\log n-2\ell. \]
Küçüğü daha iyidir.
Terimlerin anlamı. İki ölçütün de ikinci terimi, \(-2\ell\), uyumsuzluğu ölçer; birinci terim bir cezadır. Cezanın neden gerektiğini iç içe modeller (nested models), yani biri öbürünün bir parametresi sabitlenerek ya da bir sınıra götürülerek elde edilen modeller gösterir: Poisson, negatif binomun \(\theta\to\infty\) sınırı ve sıfır şişkin Poisson’un \(\pi=0\) hâlidir; Gamma’nın \(\alpha=1\) hâli üstel dağılımdır (exponential distribution). Büyük model küçüğün parametre değerlerini de seçebildiği için parametre eklemek log-olabilirliği küçültemez; log-olabilirlik tek başına karmaşık modeli kayırır.
Uydurulan bir modelin kendi verisindeki log-olabilirliği, yeni bir veride alacağından ortalama olarak yaklaşık \(k\) büyüktür; AIC \(=-2(\ell-k)\) bu iyimserliği düzeltir (Burnham ve Anderson, 2002). BIC’de parametre başına ceza \(\log n\)’dir ve \(n>e^{2}\approx7{,}4\) olunca AIC’nin 2’sini aşar: büyük veride BIC az parametreli modele daha yatkındır.
İki ölçütün farkında \(-2\ell\) sadeleşir ve yalnız cezaların farkı kalır:
\[ \mathrm{BIC}-\mathrm{AIC}=k(\log n-2). \]
İkinci satırda iki tanım yerine konur, üçüncüde \(-2\ell\) ile \(+2\ell\) birbirini götürür, dördüncüde \(k\) ortak çarpan olarak dışarı alınır:
\[ \begin{aligned} &\mathrm{BIC}-\mathrm{AIC}\\ &=(k\log n-2\ell)-(2k-2\ell)\\ &=k\log n-2k\\ &=k(\log n-2). \end{aligned} \]
Parametre sayıları eşitse bu fark her modelde aynıdır, bu yüzden iki ölçüt aynı sıralamayı verir; ayrışabilmeleri için parametre sayılarının farklı olması gerekir (Alıştırma 5(e)).
Üç ölçütü Küçük çalışılmış örnek: Poisson bölümündeki dört birimde elle hesaplayalım. Orada log-olabilirliği \(\ell(\lambda)=-4\lambda+4\log\lambda-\log 6\) olarak yazmış ve tepesini \(\widehat{\lambda}=1\)’de bulmuştuk. Tahmin edilen tek parametre \(\lambda\) olduğu için \(k=1\); gözlem dört birimdir, \(n=4\). \(\log 1=0\) olduğundan:
\[ \begin{aligned} \ell(\widehat{\lambda})&=-4\cdot1+4\log1-\log6\\ &=-4-\log 6\\ &=-4-1{,}7918=-5{,}792,\\ \mathrm{AIC}&=2\cdot1-2\cdot(-5{,}792)\\ &=2+11{,}584=13{,}584,\\ \mathrm{BIC}&=1\cdot\log 4-2\cdot(-5{,}792)\\ &=1{,}386+11{,}584=12{,}970. \end{aligned} \]
Aynı üç sayıyı önce açık kodla bulalım. Log-olabilirlik, dört gözlemin log-olasılıklarının toplamıdır:
log_olabilirlik_elle <- sum(dpois(n, lambda_acik, log = TRUE))
log_olabilirlik_elle
#> [1] -5.791759dpois(n, lambda_acik, log = TRUE) — olasılıkların kendisi yerine logaritmalarını döndürür; dört logaritmanın toplamı log-olabilirliktir.İki ölçüt bu sayıdan, \(k\)’den ve \(n\)’den gelir:
olcut_elle <- c(
  aic = 2 * 1 - 2 * log_olabilirlik_elle,
  bic = 1 * log(length(n)) - 2 * log_olabilirlik_elle
)
round(olcut_elle, 3)
#> aic bic
#> 13.584 12.970Paket aynı sayıları uydurulmuş modelden okur. Küçük örnekteki fit, dört birime uydurulmuş sabit terimli Poisson modelidir:
olcut_paket <- c(
  log_olabilirlik = as.numeric(logLik(fit)),
  aic = AIC(fit),
  bic = BIC(fit)
)
round(olcut_paket, 3)
#> log_olabilirlik aic bic
#> -5.792 13.584 12.970logLik(fit) — uydurulmuş modelin log-olabilirliğini, parametre sayısı (df) ve gözlem sayısı (nobs) öznitelikleriyle birlikte döndürür; as.numeric() öznitelikleri atıp yalnızca sayıyı bırakır.AIC(fit) ve BIC(fit) — aynı modelin iki ölçütünü yukarıdaki formüllerle hesaplar; \(k\)’yi ve \(n\)’yi modelin kendisinden alır.Üç yolu ayrı bir blokta karşılaştıralım:
uyum_kontrol <- isTRUE(all.equal(
  unname(c(log_olabilirlik_elle, olcut_elle)), unname(olcut_paket)
))
stopifnot(uyum_kontrol)
uyum_kontrol
#> [1] TRUETRUE, açık kodun ve paketin aynı üç sayıyı verdiğini söyler; yukarıda elle bulduğumuz üç sayı bunların yuvarlanmış hâlidir. FALSE çıksaydı en olası neden \(k\)’nin ya da \(n\)’nin yanlış sayılmasıdır; AIC() ile BIC() ikisini de modelden okur.
Burada \(n=4\) olduğu için BIC’nin parametre başına cezası (\(\log 4\approx1{,}39\)) AIC’ninkinden (2) küçüktür ve BIC, AIC’nin altında kalır. Sıklık bölümündeki 40.000 poliçede aynı ceza \(\log 40.000\approx10{,}6\)’dır.
Tek bir modelin AIC’si ya da BIC’si kendi başına bir şey söylemez: sayılar ancak aynı veriye uydurulmuş başka bir modelinkiyle karşılaştırılınca anlam kazanır. Karşılaştırmalar aşağıda: sıklıkta üç dağılım, büyüklükte üç aday.
Bir AIC farkının ne kadar güçlü bir kanıt olduğunu olabilirliklere dönerek okuruz. \(\mathrm{AIC}=-2(\ell-k)\) olduğu için iki modelin farkı \(\Delta=2[(\ell_1-k_1)-(\ell_2-k_2)]\)’dir; 1 güçlü, 2 zayıf modeldir. Bu yüzden \(e^{-\Delta/2}=e^{\ell_2-k_2}/e^{\ell_1-k_1}\), verinin zayıf model altındaki cezalı olabilirliğinin güçlü model altındakine oranıdır: zayıf modelin göreli olabilirliği (relative likelihood). Parametre sayıları eşitse cezalar sadeleşir ve oran olabilirliklerin kendi oranıdır.
Fark 10’u aşınca (oran 0,0067’nin altında) zayıf model için destek neredeyse kalmaz; 2’yi aşmıyorsa (oran 0,37’den büyük) iki model de kayda değer destek görür (Burnham ve Anderson, 2002).
AIC ve BIC yalnızca karşılaştırılan adaylar arasında sıralama yapar. Bütün adaylar kötü olabilir; bunu sıralama değil, yukarıdaki tablo ve grafikler gösterir. En düşük AIC kuyrukta doğru risk tahmini de garanti etmez. Bunu sınamanın yolu, modeli uydurulmadığı bir veride denemektir: dış örnek doğrulaması (out-of-sample validation).
Bu notu okumak için bir şey indirmeniz gerekmez: bütün çıktılar sayfada zaten duruyor. Kodu kendi bilgisayarınızda çalıştırmak isterseniz dersin veri dosyalarını buradan indirebilirsiniz:
İndirdiğiniz dosyaları betiğinizin yanında bir data/derived/ klasörüne koyarsanız aşağıdaki yollar olduğu gibi çalışır.
Kaynağından yeni bir kopya indirmeyin. İki dosya da bir R paketindeki veri kümesinden alındı, ama paketteki tablolar dersin kopyasıyla aynı biçimde değildir:
fitdistrplus paketindeki danishuni tablosunda tutarlar bugün dersin kopyasıyla aynıdır, ama tablo iki sütunludur (tarih ve tutar) ve tutar sütununun adı Loss’tur. Aşağıdaki kod loss adını aradığı için o tabloda çalışmaz.insuranceData paketindeki ClaimsLong tablosunda da sayılar aynıdır, ama kimlik sütununun adı policyID’dir; laboratuvarın kodu policy_id adını arar.Uydurmaya sıklıktan, \(S=X_1+\cdots+X_N\) toplamındaki \(N\)’den başlıyoruz. Sıklığın verisi hasarsız poliçeleri de içermeli; bir araç sigortası portföyünün yıllık hasar sayılarıyla çalışıyoruz. Önce Poisson’u uyduracak, yetersiz kaldığı yeri ölçecek, sonra Hasar sayısı için modeller bölümünde tanıttığımız üç alternatifi aynı veride deneyeceğiz. Modellerin türetmeleri o bölümdedir; burada her modeli kodla uyduruyor, sonucun ne söylediğini ve bir sonraki modele neden geçtiğimizi tartışıyoruz. Büyüklük modelleri bir sonraki bölümde.
claims_long.csv neyi anlatıyor?Dosya nedir? claims_long.csv, 40.000 araç sigortası poliçesinin üç yıl boyunca her yıl kaç hasar bildirdiğini tutar. Gerçek bir portföy değildir: insuranceData paketinin belgesine göre de Jong ve Heller’in (2008) kitabındaki araç sigortası verisine dayanarak üretilmiş bir benzetim verisidir. Sayıları bir sigortacının deneyimi gibi değil, yöntemi sınamak için kurulmuş bir portföy gibi okuyun.
Nereden geldi? data_manifest.csv bu dosya için kaynağı insuranceData paketinin ClaimsLong veri kümesi, kopyanın alındığı tarihi 25 Eylül 2026 ve satır sayısını 120.000 olarak kaydeder; lisans alanında insuranceData paketinin GPL-2 lisansı ile özgün veri kümesinin kaynak gösteriminin korunduğu yazılıdır. Dersin kopyası paketteki tablonun sütunlarını değiştirmeden taşır; yalnızca policyID sütununun adı policy_id olmuştur.
Dosyanın kendisi. claims_long.csv dosyasını buradan indirebilirsiniz — 120.000 satır, altı sütun. Kodu kendi bilgisayarınızda çalıştıracaksanız onu yukarıda anlatılan data/derived/ klasörüne koyun.
Bir satır neyi temsil ediyor? Bir satır bir poliçenin bir yılıdır: her poliçe dosyada üç kez, period 1, 2 ve 3 olarak geçer. Her satır tam bir yılı kapsadığı için maruziyet bütün satırlarda aynıdır ve hasar sayısı doğrudan yıllık sayı olarak okunur. Bu, Küçük çalışılmış örnek: Poisson bölümündeki eşit maruziyet koşuludur. Bu dosya \(N\)’nin dosyasıdır.
Sütunlar. Adlar dosyadan geldiği için İngilizcedir.
| Sütun | Anlamı | Birim | Kodlama ve değer alanı |
|---|---|---|---|
policy_id |
Poliçe kimliği | — | Tam sayı, 1 ile 40.000 arası; her kimlik üç satırda geçer |
agecat |
Sürücünün yaş kategorisi | — | Paket belgesine göre 1 (en genç) ile 6 arası. Dosyada ise 1, 2, 4, 5, 6 ve 10 değerleri vardır, 3 yoktur; belge farkı açıklamaz. Bu hafta agecat’ı yalnızca poliçeleri gruplamak için kullanıyoruz, kodların sırasına anlam yüklemiyoruz |
valuecat |
Aracın değer kategorisi | — | Belgeye göre 1 ile 6 arası, 1. kategori 9 olarak yeniden kodlanmıştır; dosyada 2, 3, 4, 5, 6 ve 9 vardır |
period |
Gözlem yılı | yıl | 1, 2 ya da 3 |
numclaims |
O yıl bildirilen hasar sayısı | adet | Negatif olmayan tam sayı; birinci yılda 0 ile 27, üç yılda 0 ile 43 arası |
claim |
O yıl en az bir hasar oldu mu | — | 0 = hayır, 1 = evet; tam olarak numclaims > 0 |
Hangi soruyu yanıtlıyoruz? Bir poliçenin bir yılda bildirdiği hasar sayısı Poisson dağılımıyla temsil edilebilir mi; edilemiyorsa hangi alternatif, hangi nedenle daha iyi uyar?
Neyi yanıtlayamaz?
Önce dosyanın beklenen yerde olup olmadığına bakalım:
sayim_yolu <- file.path("data", "derived", "claims_long.csv")
file.exists(sayim_yolu)
#> [1] TRUETRUE görmelisiniz; FALSE ise dosyayı yukarıdaki bağlantıdan indirip data/derived/ klasörüne koyun. Şimdi dosyayı okuyalım:
sayim_verisi <- read_csv(sayim_yolu, show_col_types = FALSE)
sayim_verisi
#> # A tibble: 120,000 × 6
#> policy_id agecat valuecat period numclaims claim
#> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 1 2 9 1 0 0
#> 2 1 2 9 2 0 0
#> 3 1 2 9 3 0 0
#> 4 2 4 9 1 0 0
#> 5 2 4 9 2 0 0
#> 6 2 4 9 3 0 0
#> 7 3 2 2 1 0 0
#> 8 3 2 2 2 2 1
#> 9 3 2 2 3 1 1
#> 10 4 2 2 1 0 0
#> # ℹ 119,990 more rowsBaşlık 120.000 satır ve altı sütun gösterir; ilk üç satır aynı poliçenin üç yılıdır. Birinci yılın hasar sayılarını bir vektöre alıp hangi sayının kaç kez geçtiğine bakalım:
hasar_sayisi <- sayim_verisi$numclaims[sayim_verisi$period == 1]
table(hasar_sayisi)
#> hasar_sayisi
#> 0 1 2 3 4 5 6 7 8 9 10 11 12
#> 34764 3704 875 301 129 87 39 22 17 17 9 8 7
#> 13 15 16 17 20 21 23 25 27
#> 6 3 2 3 2 2 1 1 1sayim_verisi$period == 1 — her satır için TRUE ya da FALSE üreten bir koşuldur; köşeli parantez içinde kullanılınca yalnızca TRUE olan satırlar, yani birinci yıl seçilir. Sonuç 40.000 poliçenin 40.000 sayısıdır.40.000 poliçenin 34.764’ü yılı hasarsız geçirmiş, 3.704’ü tek hasar bildirmiş; en çok hasar bildiren poliçenin sayısı 27’dir. Dağılımın biçimini dört sayı özetler:
sayim_ozeti <- c(
  police = length(hasar_sayisi),
  ortalama = mean(hasar_sayisi),
  varyans = var(hasar_sayisi),
  oran = var(hasar_sayisi) / mean(hasar_sayisi),
  sifir_payi = mean(hasar_sayisi == 0)
)
round(sayim_ozeti, 4)
#> police ortalama varyans oran sifir_payi
#> 40000.0000 0.2152 0.6689 3.1075 0.8691var(hasar_sayisi) — örnek varyansı \(s^{2}\)’dir: ortalamadan farkların karelerinin toplamını, yani kareler toplamı \(\sum_j(n_j-\bar{n})^{2}\)’yi, \(m-1\)’e böler.mean(hasar_sayisi == 0) — hasar_sayisi == 0 her poliçe için TRUE ya da FALSE üretir; mean() TRUE’yu 1, FALSE’u 0 sayar. Bu yüzden ortalama, hasarsız poliçelerin payıdır.Ortalama 0,2152, varyans 0,6689: varyans ortalamanın 3,1075 katıdır. Poisson’da ikisi eşit olmalıydı (\(E[N]=\operatorname{Var}(N)=\lambda\)). Poisson ne zaman yetersiz kalabilir? bölümünün ilk nedeni, aşırı yayılım, burada 40.000 poliçelik bir portföyde karşımızda. Poliçelerin %86,9’u hasarsızdır.
Varyansın ortalamadan büyük olması bölümün geri kalanını yönlendirir. Önce Poisson’un standart hatasının neden küçük çıktığını göreceğiz. Sonra bu fazlalığın iki olası nedenini, poliçeler arasındaki risk farkını ve hiç hasar üretmeyen poliçeleri (Fazla sıfır ve uzun kuyruk nereden gelir?), negatif binom ve sıfır şişkin Poisson ile sınayacağız.
Poisson’un maksimum olabilirlik tahmini örnek ortalamasıdır, \(\widehat{\lambda}=\bar{n}\) (Küçük çalışılmış örnek: Poisson). Paketi tahmin için değil, modelleri karşılaştırmak için gereken log-olabilirliği ve standart hatayı her modelde aynı biçimde verdiği için kullanıyoruz:
fit_poisson <- fitdistrplus::fitdist(hasar_sayisi, "pois")
fit_poisson
#> Fitting of the distribution ' pois ' by maximum likelihood
#> Parameters:
#> estimate Std. Error
#> lambda 0.21525 0.002319702fitdistrplus::fitdist(hasar_sayisi, "pois") — dağılımın adından dpois() işlevini bulur, log-olabilirliği onunla kurar ve optim() ile sayısal olarak en büyük yapar. Büyüklük bölümünde sürekli dağılımlara da aynı çağrıyla uygulanacak. Çıktının estimate sütunu tahmindir, \(\widehat{\lambda}=0{,}21525\): örnek ortalamasının kendisi. Özet tablosundaki 0,2152 aynı sayıdır; bellekte 0,2152499… olarak durduğu için dört ondalığa aşağı yuvarlanır. Tepedeki log-olabilirlik, −25.795,27, fit_poisson$loglik öğesindedir; öbür modeller bu sayıyla karşılaştırılacak.
Standart hata. Std. Error sütunundaki 0,002319702 log-olabilirliğin tepedeki eğriliğinden gelir. Tepe ne kadar sivriyse, yani log-olabilirlik tepeden uzaklaşınca ne kadar hızlı düşüyorsa, veri tepeden uzak değerleri o kadar kesin dışlar ve tahmin o kadar kesindir. Sivriliği ikinci türev ölçer; büyük örneklerde maksimum olabilirlik tahmininin standart hatası yaklaşık olarak şudur:
\[ \operatorname{se}(\widehat{\lambda})\approx\frac{1}{\sqrt{-\ell''(\widehat{\lambda})}} . \]
Sayfanın geri kalanında buna eğrilik kuralı diyoruz; paket ikinci türevi sayısal olarak alır. Poisson’da ikinci türev \(-\sum_j n_j/\lambda^{2}\), tepede \(-m/\widehat{\lambda}\)’dır ve kural \(\sqrt{\widehat{\lambda}/m}\) verir: Poisson ne zaman yetersiz kalabilir? bölümündeki ortalamanın standart hatası, \(\sqrt{\operatorname{Var}(N)/m}\), varyansın yerine ortalama konmuş olarak.
Burada varyans ortalamanın 3,1075 katı olduğu için gerçekçi standart hata Poisson’un verdiğinin \(\sqrt{3{,}1075}=1{,}763\) katıdır: 0,00232 yerine yaklaşık 0,0041. Tahmin aynı kalır, değişen ona ne kadar güvenebileceğimizdir: Poisson’la kalırsak güven aralıkları olduğundan dar çıkar. Yarı-Poisson’u uydurmak bölümü aynı düzeltmeyi bir modelle yapacak.
Standart hata ortalamanın ne kadar kesin bilindiğini söyler, modelin hasar sayılarının dağılımını tutturup tutturmadığını söylemez; çok hasarlı bir yılın olasılığı ise dağılımın uçlarına bağlıdır. Uyumu Gözlenen–beklenen sıklık tablosu bölümündeki gibi okuyacağız.
Dört ve daha fazla hasarı tek hücrede topluyoruz: Poisson 4 hasar için yalnızca 2,9 poliçe, 5 ve daha fazlası için 0,1 poliçe bekler; beklenen sayısı bu kadar küçük hücreler birleştirilir (Ki-kare uyum testi). Önce gözlenen sayılar:
gozlenen <- table(factor(pmin(hasar_sayisi, 4), levels = 0:4,
                         labels = c("0", "1", "2", "3", "4+")))
gozlenen
#>
#> 0 1 2 3 4+
#> 34764 3704 875 301 356pmin(hasar_sayisi, 4) — her öğeyi 4 ile karşılaştırıp küçük olanı alır; 4’ten büyük sayılar 4 olur, yani 4 ve üstü tek hücreye düşer.factor(..., levels = 0:4, labels = ...) — beş hücrenin hepsini sabit sırayla kurar ve son hücreye “4+” adını verir. Böylece hiç gözlenmeyen bir sayı olsaydı bile hücresi 0 ile tabloda kalırdı.Poisson’un beklediği sayılar, olasılıkların poliçe sayısıyla çarpımıdır: \(E_k=40.000\,P(N=k)\). Kod beş olasılığı uydurulan \(\widehat{\lambda}\) ile dpois() ve ppois()’dan hesaplar:
poisson_beklenen <- length(hasar_sayisi) *
  c(dpois(0:3, fit_poisson$estimate[["lambda"]]),
    ppois(3, fit_poisson$estimate[["lambda"]], lower.tail = FALSE))
round(poisson_beklenen, 1)
#> [1] 32253.6 6942.6 747.2 53.6 3.0ppois(3, lambda, lower.tail = FALSE) — \(P(N\ge4)\)’ü, yani son hücrenin olasılığını verir; beş olasılığın toplamı 1’dir.İki satırı yan yana koyalım:
round(rbind(gozlenen = c(gozlenen), poisson = poisson_beklenen,
            fark = c(gozlenen) - poisson_beklenen), 1)
#> 0 1 2 3 4+
#> gozlenen 34764.0 3704.0 875.0 301.0 356
#> poisson 32253.6 6942.6 747.2 53.6 3
#> fark 2510.4 -3238.6 127.8 247.4 353fark — gözlenen eksi beklenen. Artı bir fark modelin o hücreyi eksik, eksi bir fark fazla beklediğini gösterir.Poisson sıfırları eksik bekliyor (34.764 gözlenene karşı 32.253,6), tek hasarı neredeyse iki kat fazla bekliyor (3.704’e karşı 6.942,6) ve 4 ya da daha fazla hasar bildiren 356 poliçenin yerine yalnızca 3,0 poliçe öngörüyor. Ortalamayı tutturan bir model, dağılımın iki ucunda birden yanılıyor.
Fazla sıfır ile uzun kuyruğun birlikte görülmesi, Fazla sıfır ve uzun kuyruk nereden gelir? bölümündeki karışım örneğinin gösterdiği şeydir: poliçelerin risk düzeyi farklıysa tek bir Poisson hem sıfırları hem çok hasarlı poliçeleri eksik sayar. Hasar sayısı için modeller bölümünde tanıttığımız üç alternatifi sırayla uyduralım.
Negatif binom, poliçelerin risk düzeyindeki farkı bir parametreyle ölçer. İki parametresi ortalama \(\mu\) ve poliçeler arasındaki risk farkını ölçen \(\theta\)’dır; R’de \(\theta\), dnbinom() ve fitdist() içinde size adını taşır. Önce log-olabilirliği kendimiz yazıp en büyük yapıyoruz, çünkü bu yol paketlerin içeride ne yaptığını ve \(\theta\)’nın neden sayısal arandığını gösterir; sonra aynı modeli iki paketle uyduruyoruz.
Log-olabilirlik. Negatif binom bölümündeki olasılık fonksiyonunun logaritması alınınca çarpımlar toplama, bölümler farka, üsler çarpana döner. Bir poliçe için:
\[ \begin{aligned} &\log P(N=k)\\ &=\log\Gamma(k+\theta)-\log\Gamma(\theta)-\log k!\\ &\quad+\theta\log\frac{\theta}{\theta+\mu} +k\log\frac{\mu}{\theta+\mu}. \end{aligned} \]
Log-olabilirlik \(\ell\), bu terimlerin poliçeler üzerinden toplamıdır. Aşağıdaki işlevin sum() içindeki satırı beş terimi bu sırayla yazar; y, \(k\)’nin yerindeki hasar sayıları vektörüdür.
\(\mu\) neden örnek ortalamasına sabitlenir? Bir parametre sabit tutularak öbürüne göre alınan türeve kısmi türev (partial derivative) denir ve \(\partial/\partial\mu\) ile gösterilir. \(\mu\) yalnız son iki terimde geçer; \(\theta\) sabitken onların türevi alınıp poliçeler üzerinden toplanınca her poliçede aynı olan bir çarpan dışarı çıkar:
\[ \frac{\partial\ell}{\partial\mu} =\frac{\theta}{\mu(\theta+\mu)}\sum_j(n_j-\mu). \]
Öndeki çarpan pozitiftir ve \(\theta\) yalnız onda durur. Türev bu yüzden, \(\theta\) ne olursa olsun, \(\sum_j(n_j-\mu)=0\) olduğunda, yani \(\mu=\bar{n}\)’de sıfırdır: negatif binomda da \(\mu\)’nün maksimum olabilirlik tahmini örnek ortalamasıdır. Aşağıdaki işlev \(\mu\)’yü bu yüzden mean(y) ile sabitler; iki parametreli arama, tek bilinmeyeni \(\theta\) olan bir aramaya iner.
\(\theta\) neden sayısal olarak aranır? \(\log\Gamma\)’nın türevine digamma işlevi (digamma function) denir; \(\psi\) ile gösterilir, R’de digamma()’dır. \(\mu\) yerine \(\bar{n}\) konup \(\theta\)’ya göre türev alınınca \(\log\Gamma\) terimlerinden iki \(\psi\) gelir, öbür terimler sadeleşir ve sıfıra eşitlenecek denklem şu olur:
\[ \begin{aligned} \ell'(\theta)&=\sum_{j}\big(\psi(n_j+\theta)-\psi(\theta)\big)\\ &\quad+m\log\frac{\theta}{\theta+\bar{n}}=0 . \end{aligned} \]
\(\theta\) hem \(\psi\)’nin hem logaritmanın içindedir; Poisson’un denkleminin tersine, onu yalnız bırakan bir cebir yoktur. Bu yüzden optimize(), log-olabilirliği en büyük yapan \(\theta\)’yı bir aralıkta sayısal olarak arar.
nb_log_olabilirlik <- function(theta, y) {
  mu <- mean(y)
  sum(lgamma(y + theta) - lgamma(theta) - lgamma(y + 1) +
        theta * log(theta / (theta + mu)) + y * log(mu / (theta + mu)))
}
theta_elle <- optimize(nb_log_olabilirlik, interval = c(0.01, 10),
                       y = hasar_sayisi, maximum = TRUE, tol = 1e-10)$maximum
theta_elle
#> [1] 0.1687502\(\widehat{\theta}\) yaklaşık 0,1688 çıkmalıdır.
lgamma(x) — \(\log\Gamma(x)\)’tir. \(\Gamma(x)\) büyük \(x\)’te taşar (gamma(172) Inf’tir); logaritma bunu önler ve çarpımı toplamaya çevirir. lgamma(y + 1) \(\log k!\)’dir, çünkü tam sayılarda \(\Gamma(k+1)=k!\)’dir (Negatif binom bölümü). optimize(f, interval, ..., maximum = TRUE) — tek değişkenli bir işlevin verilen aralıktaki en uç noktasını arar. Türev kullanmaz: aralığı, içindeki noktalarda işlevin değerlerini karşılaştırarak adım adım daraltır. Varsayılanı en küçüğü aramaktır; maximum = TRUE en büyüğü aratır. Sonucun $maximum öğesi \(\theta\)’nın kendisidir.y = hasar_sayisi — optimize() denediği değeri işlevin ilk bağımsız değişkenine, theta’ya koyar; adıyla verilen öbür bağımsız değişkenleri işleve olduğu gibi geçirir.interval = c(0.01, 10) — aramanın aralığıdır. \(\theta\) pozitif olmalı ve tepe bu aralığın içinde kalmalıdır: bulunan 0,1688 iki uçtan da uzaktır, yani arama bir uca dayanmadı. tol = 1e-10 — aramanın duyarlılığıdır. Varsayılan duyarlılık yaklaşık \(10^{-4}\)’tür; bulunan \(\theta\)’yı aşağıdaki paketlerin sonucuyla karşılaştırırken farkın aramanın erken durmasından gelmemesi için daha sıkı istiyoruz. İki paketle. Birincisi Poisson’u uydurduğumuz fitdist()’tir; Modelleri karşılaştırmak bölümü negatif binomun log-olabilirliğini, AIC’sini ve ki-kare testini onun nesnesinden alır:
fit_negbin <- fitdistrplus::fitdist(hasar_sayisi, "nbinom")
fit_negbin
#> Fitting of the distribution ' nbinom ' by maximum likelihood
#> Parameters:
#> estimate Std. Error
#> size 0.1687754 0.004372567
#> mu 0.2152705 0.003499564İkincisi, R ile birlikte gelen MASS paketinin negatif binom GLM’idir; sabit terimli hâliyle aynı soruyu yanıtlar. Onu da uyduruyoruz, çünkü negatif binomu bir GLM olarak kurar: laboratuvarın Görev B’si \(\theta\)’yı yıl yıl bu işlevle hesaplar, Hafta 10 da aynı işleve risk sınıflarını ve ofseti ekler:
negbin_glm <- MASS::glm.nb(hasar_sayisi ~ 1)
summary(negbin_glm)
#>
#> Call:
#> MASS::glm.nb(formula = hasar_sayisi ~ 1, init.theta = 0.1687501489,
#> link = log)
#>
#> Coefficients:
#> Estimate Std. Error z value Pr(>|z|)
#> (Intercept) -1.53596 0.01626 -94.48 <2e-16 ***
#> ---
#> Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
#>
#> (Dispersion parameter for Negative Binomial(0.1688) family taken to be 1)
#>
#> Null deviance: 15514 on 39999 degrees of freedom
#> Residual deviance: 15514 on 39999 degrees of freedom
#> AIC: 42152
#>
#> Number of Fisher Scoring iterations: 1
#>
#>
#> Theta: 0.16875
#> Std. Err.: 0.00437
#>
#> 2 x log-likelihood: -42147.56100MASS::glm.nb(y ~ 1) — glm()’in negatif binom karşılığıdır. \(\theta\)’yı yukarıdaki \(\ell'(\theta)=0\) denklemini çözerek bulur; standart hatasını da eğrilik kuralıyla, ikinci türevden alır. Özetin sonunda Theta ile standart hatasını (0,0044) yazar. Coefficients — sabit terim, −1,53596, \(\log\widehat{\mu}\)’dür: glm() gibi glm.nb() de ortalamanın logaritmasını tahmin eder. Üssü örnek ortalamasıdır, çünkü glm.nb() \(\mu\)’nün denklemini tam çözer. Üç yol aynı \(\widehat{\theta}\)’ya varır, çünkü üçü de yukarıdaki log-olabilirliği en büyük yapar: elle yazdığımız işlev ve glm.nb() 0,16875, fitdist() 0,16878 bulur. fitdist() iki parametreyi optim() ile birlikte arar ve tepenin neredeyse düz çevresinde biraz erken durur; \(\mu\)’yü de bu yüzden örnek ortalaması 0,21525 yerine 0,21527 bulur.
Sigorta diliyle: \(\widehat{\theta}=0{,}169\) küçük bir sayıdır. Negatif binom bölümünde gördüğümüz gibi \(\lambda\)’nın standart sapması ortalamasının \(1/\sqrt{\theta}\) katıdır: burada 2,43 katı, iki gruplu örnekte 0,67’ydi. Poliçelerin beklenen hasar sayıları birbirinden çok uzaktır; portföyü tek bir \(\lambda\) ile anlatmak bu farkı yok sayar.
Varyans da aynı bölümdeki iki parçaya ayrılır:
\[ \operatorname{Var}(N)=\mu+\frac{\mu^{2}}{\theta}. \]
Grup içi parça \(\widehat{\mu}=0{,}2153\), gruplar arası parça \(\widehat{\mu}^{2}/\widehat{\theta}=0{,}2746\)’dır. Modelin varyansı 0,4898’dir ve bunun %56’sı poliçeler arasındaki risk farkından gelir. Negatif binomun beklediği sayılar:
negbin_beklenen <- length(hasar_sayisi) *
  c(dnbinom(0:3, size = fit_negbin$estimate[["size"]],
            mu = fit_negbin$estimate[["mu"]]),
    pnbinom(3, size = fit_negbin$estimate[["size"]],
            mu = fit_negbin$estimate[["mu"]], lower.tail = FALSE))
round(rbind(gozlenen = c(gozlenen), negatif_binom = negbin_beklenen,
            fark = c(gozlenen) - negbin_beklenen), 1)
#> 0 1 2 3 4+
#> gozlenen 34764.0 3704.0 875 301.0 356.0
#> negatif_binom 34817.3 3293.9 1079 437.2 372.7
#> fark -53.3 410.1 -204 -136.2 -16.7dnbinom() ve pnbinom() — Negatif binom bölümünde tanıttığımız işlevler; size ile mu burada uydurulan tahminlerden gelir.Model iki ucu tutturuyor. Sıfır hücresinde 34.817,3 poliçe bekliyor, gözlenen 34.764: fark −53,3, beklenenin binde 1,5’i. 4+ hücresinde 372,7 bekliyor, gözlenen 356: fark −16,7.
Ortayı tutturamıyor: tek hasarlı poliçeleri 3.293,9 bekliyor, gözlenen 3.704 (fark +410,1); iki ve üç hasarlıları da fazla bekliyor (farklar −204,0 ve −136,2). Ortalamayı tutturduğu hâlde varyansı tutturmuyor: ima ettiği varyans 0,4898, gözlenen 0,6689.
Varyanstaki açık en uçtan gelir. 10 ya da daha fazla hasar bildiren poliçeleri sayıp modelin beklediğiyle karşılaştıralım:
c(gozlenen = sum(hasar_sayisi >= 10),
  negatif_binom = length(hasar_sayisi) *
    pnbinom(9, size = fit_negbin$estimate[["size"]],
            mu = fit_negbin$estimate[["mu"]], lower.tail = FALSE))
#> gozlenen negatif_binom
#> 45.000000 5.940715pnbinom(9, ..., lower.tail = FALSE) — 9’dan büyük, yani 10 ya da daha fazla hasarın olasılığıdır.45 poliçe var, model 5,9 bekler. Bu birkaç poliçe varyansı tek başına büyütür, çünkü kareler toplamına her poliçe ortalamadan uzaklığının karesi kadar katkı yapar: 20 hasarlı bir poliçe yaklaşık 391, hasarsız bir poliçe 0,046. Kareler toplamındaki paylarına bakalım:
sum((hasar_sayisi[hasar_sayisi >= 10] - mean(hasar_sayisi))^2) /
  sum((hasar_sayisi - mean(hasar_sayisi))^2)
#> [1] 0.3454355Poliçelerin binde biri olan bu 45 poliçe, kareler toplamının %34,5’ini taşır. Model onları gözlenenin yaklaşık sekizde biri kadar beklediği için (45’e karşı 5,9) varyansı eksik tutar. \(\theta\)’nın denkleminde varyansı tutturan bir koşul yoktur: olabilirlik her poliçeye eşit ağırlık verir ve \(\widehat{\theta}\) bu 45 poliçeyi tutturmak için öbür poliçelerin olasılığından vazgeçmez.
Bunun bedeli Hafta 5’te görülecek: toplam hasarın varyansı hasar sayısının varyansını da içerir, bu yüzden varyansı eksik tutan bir sıklık modeli portföyün riskini de eksik gösterir.
Bu modeli hazır uyduran paketler (örneğin pscl) dersin paket listesinde yok. Bu yüzden log-olabilirliği kendimiz yazıp iki parametre, \(\pi\) ve \(\lambda\), üzerinde en büyük yapıyoruz. Her poliçe, Sıfır şişkin Poisson bölümündeki iki olasılıktan kendi hasar sayısına uyanın logaritmasını katar: hasarsız poliçeler birinci toplamı, hasarlı poliçeler ikinci toplamı oluşturur.
\[ \begin{aligned} \ell(\pi,\lambda)&=\sum_{n_j=0}\log\big(\pi+(1-\pi)e^{-\lambda}\big)\\ &\quad+\sum_{n_j\ge1}\log\Big((1-\pi)\,\frac{e^{-\lambda}\lambda^{n_j}}{n_j!}\Big). \end{aligned} \]
Formüldeki iki toplamı kod poliçe poliçe kurar. İşlev iki şey alır: p, aranan iki parametrenin dönüştürülmüş hâli, ve y, hasar sayıları. Önce işlevi yazıp aramanın başlayacağı noktada, \(\pi=0{,}5\) ve \(\lambda=1\)’de, değerini hesaplayalım:
zip_log_olabilirlik <- function(p, y) {
  pi0 <- plogis(p[1])
  lambda <- exp(p[2])
  olasilik <- ifelse(y == 0, pi0 + (1 - pi0) * exp(-lambda),
                     (1 - pi0) * dpois(y, lambda))
  sum(log(olasilik))
}
zip_log_olabilirlik(c(0, 0), hasar_sayisi)
#> [1] -26032.35İşlevin satırları formülü sırayla yazar:
plogis(p[1]) ve exp(p[2]) — optim() parametreleri bütün sayı doğrusunda arar; \(\pi=1{,}2\) ya da \(\lambda=-0{,}5\) gibi bir nokta denerse olasılığın logaritması tanımsızdır (NaN). plogis(a) \(=1/(1+e^{-a})\) her sayıyı 0 ile 1 arasına, exp() pozitif sayılara taşır. c(0, 0) bu yüzden \(\pi=0{,}5\) ve \(\lambda=1\) demektir. ifelse(y == 0, A, B) — her poliçe için iki olasılıktan birini seçer: hasarsız poliçeye birinci toplamdaki \(\pi+(1-\pi)e^{-\lambda}\)’yı, hasarlı poliçeye ikinci toplamdaki \((1-\pi)\,e^{-\lambda}\lambda^{n_j}/n_j!\)’i yazar. Sonuç, her poliçenin kendi hasar sayısına verilen olasılıktır.sum(log(olasilik)) — bu olasılıkların logaritmalarını toplar; formülün iki toplamı böylece tek bir toplamda birleşir.Başlangıç noktasında log-olabilirlik −26.032,35’tir. optim() bu noktadan yola çıkar ve değeri büyüten yönde adım adım ilerler:
zip_uyum <- optim(c(0, 0), zip_log_olabilirlik, y = hasar_sayisi,
                  method = "BFGS", control = list(fnscale = -1))
c(pi = plogis(zip_uyum$par[1]), lambda = exp(zip_uyum$par[2]),
  log_olabilirlik = zip_uyum$value)
#> pi lambda log_olabilirlik
#> 8.031339e-01 1.093383e+00 -2.230398e+04Model poliçelerin %80,3’ünü yapısal sıfır sayıyor; kalanların ortalaması \(\widehat{\lambda}=1{,}093\). Log-olabilirlik başlangıçtaki −26.032,35’ten tepedeki −22.303,98’e çıktı: tepe, veriye en yüksek olasılığı veren \(\pi\) ile \(\lambda\) çiftidir.
optim(başlangıç, f, method = "BFGS") — çok değişkenli bir işlevin en uç noktasını adım adım arar; "BFGS" her adımda eğimi iki yakın noktanın farkından sayısal olarak alır.control = list(fnscale = -1) — optim() varsayılan olarak en küçüğü arar; işlevi \(-1\) ile ölçekleyerek en büyüğü aratır. Verilmezse: optim() log-olabilirliği küçültmeye çalışır, değerin sonlu olmadığı bir noktaya varır ve “non-finite finite-difference value” hatasıyla durur. zip_uyum$par — bulunan iki değerdir, ama \(\pi\) ile \(\lambda\)’nın kendisi değil, dönüştürülmüş hâlleri: (1,4060; 0,0893). Bloğun son satırı onları plogis() ve exp() ile geri çevirir. zip_uyum$value — tepedeki log-olabilirliktir. fnscale yalnızca aramanın yönünü değiştirir; value, işlevin kendi değeridir.Log-olabilirliğin hangi poliçelerden geldiğini görmek için işlevi tek bir poliçeye uygulayalım: zip_log_olabilirlik(zip_uyum$par, k), \(k\) hasarlı bir poliçenin olasılığının logaritmasıdır. Bunu verideki her hasar sayısı için hesaplayıp o sayıdaki poliçe sayısıyla çarpınca toplamın parçaları çıkar:
zip_katkilari <- data.frame(hasar = sort(unique(hasar_sayisi)),
                            police = as.vector(table(hasar_sayisi)))
zip_katkilari$log_olasilik <- sapply(zip_katkilari$hasar, function(k)
  zip_log_olabilirlik(zip_uyum$par, k))
zip_katkilari$katki <- zip_katkilari$police * zip_katkilari$log_olasilik
round(zip_katkilari, 2)
#> hasar police log_olasilik katki
#> 1 0 34764 -0.14 -4877.29
#> 2 1 3704 -2.63 -9739.07
#> 3 2 875 -3.23 -2829.06
#> 4 3 301 -4.24 -1277.01
#> 5 4 129 -5.54 -714.60
#> 6 5 87 -7.06 -614.20
#> 7 6 39 -8.76 -341.73
#> 8 7 22 -10.62 -233.61
#> 9 8 17 -12.61 -214.35
#> 10 9 17 -14.72 -250.19
#> 11 10 9 -16.93 -152.37
#> 12 11 8 -19.24 -153.91
#> 13 12 7 -21.63 -151.44
#> 14 13 6 -24.11 -144.66
#> 15 15 3 -29.28 -87.84
#> 16 16 2 -31.96 -63.92
#> 17 17 3 -34.71 -104.12
#> 18 20 2 -43.27 -86.54
#> 19 21 2 -46.22 -92.45
#> 20 23 1 -52.27 -52.27
#> 21 25 1 -58.49 -58.49
#> 22 27 1 -64.87 -64.87sort(unique(hasar_sayisi)) ve table(hasar_sayisi) — verideki 22 farklı hasar sayısı ve her birinde kaç poliçe olduğu. İkisi de küçükten büyüğe sıralıdır, bu yüzden satırlar eşleşir. zip_katkilari$log_olasilik <- ... — tabloya yeni bir sütun ekler.katki — o hasar sayısındaki poliçelerin hepsinin log-olabilirliğe katkısı: poliçe sayısı çarpı bir poliçenin log-olasılığı.İlk satır formülün birinci toplamıdır: 34.764 hasarsız poliçe −4.877,29 katar. Öbür 21 satır ikinci toplamı oluşturur ve −17.426,69 katar; ikisinin toplamı optim()’in bulduğu −22.303,98’dir.
Kuyruktaki satırlar modelin zayıf yerini gösterir. Ortalaması \(\widehat{\lambda}=1{,}093\) olan bir Poisson 10 ya da daha fazla hasarı neredeyse imkânsız sayar: 27 hasarlı poliçenin log-olasılığı −64,87, yani olasılığı \(6{,}7\cdot10^{-29}\)’dur. Veride böyle 45 poliçe vardır ve log-olabilirliğe birlikte −1.212,88 katarlar, toplamın %5,4’ü.
Model neden hasarsız payı ve hasarlıların ortalamasını tam tutturur? Modelin sıfır olasılığına \(p_0=\pi+(1-\pi)e^{-\lambda}\) diyelim. Gözlenen sıfırların hepsi yapısal değildir: uydurulan modelin %86,9’luk sıfır olasılığının 80,3 puanı yapısal sıfırlardan, 6,6 puanı da hasar üretebildiği hâlde yılı hasarsız geçiren poliçelerden gelir. Bu olasılık, gözlenen hasarsız payın, \(34.764/40.000=0{,}8691\)’in, kendisidir.
Nedeni, hasarlı bir poliçenin olasılığının iki çarpana ayrılmasıdır. Birincisi “en az bir hasar” olasılığıdır: \(1\)’den \(p_0\)’ı çıkarıp \(1-\pi\)’yi ortak çarpan alınca \(1-p_0=(1-\pi)(1-e^{-\lambda})\) olur. İkincisi, hasarlı olduğu bilinen bir poliçenin tam \(k\) hasar bildirme olasılığıdır:
\[ \begin{aligned} &(1-\pi)\,\frac{e^{-\lambda}\lambda^{k}}{k!}\\ &=(1-p_0)\cdot\frac{e^{-\lambda}\lambda^{k}}{k!\,(1-e^{-\lambda})} . \end{aligned} \]
İkinci çarpan sıfırı kesilmiş Poisson (zero-truncated Poisson) dağılımıdır: Poisson’dan sıfırı atar, kalan olasılıkları toplamları 1 olsun diye \(1-e^{-\lambda}\)’ya böler. Yalnızca \(\lambda\)’ya bağlıdır. Böylece log-olabilirlik iki ayrı soruya bölünür ve her soruyu bir parametre yanıtlar:
İki sonuç birlikte modelin ortalamasını, \((1-\pi)\lambda\)’yı (Sıfır şişkin Poisson bölümü), örnek ortalamasına eşitler: hasarlı poliçelerin payı ile hasarlıların ortalamasının çarpımı bütün portföyün ortalamasıdır, \((1-p_0)\cdot\lambda/(1-e^{-\lambda})\) \(=(1-\pi)\lambda\). Aşağıdaki blok iki sonucu uydurulan değerlerle sınıyor: beklenen hasarsız poliçe sayısı gözlenene, modelin ortalaması örnek ortalamasına eşit mi?
zip_kontrol <- isTRUE(all.equal(
  length(hasar_sayisi) * (plogis(zip_uyum$par[1]) +
    (1 - plogis(zip_uyum$par[1])) * exp(-exp(zip_uyum$par[2]))),
  sum(hasar_sayisi == 0), tolerance = 1e-6)) &&
  isTRUE(all.equal((1 - plogis(zip_uyum$par[1])) * exp(zip_uyum$par[2]),
                   mean(hasar_sayisi), tolerance = 1e-6))
stopifnot(zip_kontrol)
zip_kontrol
#> [1] TRUETRUE görmelisiniz. FALSE, optim()’in en büyüğe ulaşmadan durduğunu ya da olabilirliğin yanlış yazıldığını gösterirdi.
Beklenen sayılar Poisson’unkiyle aynı biçimde hesaplanır; yalnızca sıfır hücresine yapısal sıfırlar eklenir, öbür hücreler \(1-\widehat{\pi}\) ile küçülür:
zip_beklenen <- length(hasar_sayisi) *
  c(plogis(zip_uyum$par[1]) +
      (1 - plogis(zip_uyum$par[1])) * exp(-exp(zip_uyum$par[2])),
    (1 - plogis(zip_uyum$par[1])) * dpois(1:3, exp(zip_uyum$par[2])),
    (1 - plogis(zip_uyum$par[1])) *
      ppois(3, exp(zip_uyum$par[2]), lower.tail = FALSE))
round(rbind(gozlenen = c(gozlenen), sifir_sisik = zip_beklenen,
            fark = c(gozlenen) - zip_beklenen), 1)
#> 0 1 2 3 4+
#> gozlenen 34764 3704 875.0 301.0 356.0
#> sifir_sisik 34764 2885 1577.2 574.8 198.9
#> fark 0 819 -702.2 -273.8 157.1Sıfır hücresinde 34.764 poliçe bekliyor, gözlenenin kendisi; farkın 0 çıkması hasarsız payı tutturmanın sonucudur. Öbür dört hücrenin hepsinde fark negatif binomunkinden büyüktür:
Yanılgının nedeni modelin yapısındadır. Sıfırı kesilmiş Poisson’un tek parametresi \(\lambda\)’dır; \(\lambda\) hasarlıların ortalamasını tutturacak biçimde seçilince dağılımın biçimi de belirlenmiş olur: sıfırdan büyük sayıların birbirine oranı Poisson’unkidir (Sıfır şişkin Poisson bölümü). Verideki hasarlı poliçeler bu biçimden daha dağınıktır: gözlenen sayılarda tek hasar ve 4+ daha çok, iki ve üç hasar daha azdır.
Karışım örneğinin dersi burada: fazla sıfır, sıfırların yapısal olduğunu kanıtlamaz; aynı sıfırları heterojenlik de üretir. Hangi mekanizmanın çalıştığını tablonun geri kalanı söyler. Karışım tablosunda yapısal sıfırlı portföy de karışımdan aynı yönde ayrılıyordu: tek hasar 0,1646’ya karşı 0,1969, iki hasar 0,0494’e karşı 0,0402. Veri bu bakımdan karışıma benziyor, yani yapısal sıfırlardan çok heterojenliği destekliyor.
Yarı-Poisson bir olasılık dağılımı olmadığı için fitdist() onu uyduramaz: uyduracağı bir olasılık işlevi yoktur. Onu glm() uydurur. Yarı-Poisson’un Poisson’dan neyi değiştirdiğini görmek için Poisson’u da aynı işlevle uyduruyoruz; iki katsayı tablosu aynı ölçekte olur ve satır satır karşılaştırılabilir:
poisson_glm <- glm(hasar_sayisi ~ 1, family = poisson())
summary(poisson_glm)$coefficients
#> Estimate Std. Error z value Pr(>|z|)
#> (Intercept) -1.535955 0.01077696 -142.5222 0summary(model)$coefficients — Yarı-Poisson bölümündeki katsayı tablosu.glm(), Küçük çalışılmış örnek: Poisson bölümündeki gibi \(\lambda\)’yı değil sabit terimi, \(\beta=\log\lambda\)’yı tahmin eder: \(-1{,}535955\), yani \(\log 0{,}21525\). Standart hatası da bu ölçektedir; Yarı-Poisson bölümünde gördüğümüz gibi \(\lambda\) ölçeğindeki standart hatanın tahmine bölümüdür. Tablodaki 0,01077696 bu yüzden fit_poisson’ın 0,002319702’sinden farklıdır.
yari_poisson <- glm(hasar_sayisi ~ 1, family = quasipoisson())
summary(yari_poisson)$coefficients
#> Estimate Std. Error t value Pr(>|t|)
#> (Intercept) -1.535955 0.01899776 -80.84929 0family = quasipoisson() — Yarı-Poisson bölümündeki aile: tahmin Poisson’unkiyle aynı, standart hatalar \(\sqrt{\phi}\) katı.İki tablonun tahmin sütunu aynıdır (−1,536, üssü 0,21525), çünkü yarı-Poisson ortalama için Poisson’la aynı denklemi çözer. Değişen yalnızca standart hatadır; oranını ve \(\phi\)’nin tahminini yan yana koyalım:
c(yayilim = summary(yari_poisson)$dispersion,
  se_orani = summary(yari_poisson)$coefficients[1, 2] /
    summary(poisson_glm)$coefficients[1, 2])
#> yayilim se_orani
#> 3.107509 1.762813summary(model)$dispersion — özetin \(\widehat{\phi}\) öğesi: Poisson’da 1’e sabittir, yarı-Poisson’da Yarı-Poisson bölümündeki formülle tahmin edilir. \(\widehat{\phi}=3{,}1075\), Birinci yılın hasar sayıları bölümündeki varyans/ortalama oranıyla dört ondalığa kadar aynıdır. Nedeni Yarı-Poisson bölümündeki formüldür: sabit terimli modelde her poliçenin \(\widehat{\mu}_j\)’si örnek ortalaması \(\bar{n}\)’dir ve \(p=1\)’dir; ortak payda toplamın dışına çıkınca kalan kesir örnek varyansı \(s^{2}\)’dir:
\[ \begin{aligned} \widehat{\phi}&=\frac{1}{m-1}\sum_{j=1}^{m}\frac{(n_j-\bar{n})^{2}}{\bar{n}}\\ &=\frac{s^{2}}{\bar{n}} . \end{aligned} \]
Varyans \(\phi\) katına çıkınca standart hata \(\sqrt{\phi}\) katına çıkar (Yarı-Poisson bölümü): bloğun se_orani’sı 1,763’tür, yani \(\sqrt{\widehat{\phi}}\). Tahmin, yani ortalama sıklık ve ona dayanan prim, değişmez; değişen, o tahmine ne kadar güvenebileceğimizdir. Poisson’un standart hatası belirsizliği 1,763 kat küçük gösterir ve onunla kurulan güven aralıkları o kadar dar çıkar.
Bu fark bir risk faktörünün etkisini sınarken sonucu değiştirebilir: Hafta 10’da bir tarife modelinde, Poisson’un standart hatasıyla anlamlı görünen bölge etkilerinin yarı-Poisson’la anlamlılığını yitirdiğini göreceğiz.
Yarı-Poisson bir olasılık dağılımı tanımlamaz; log-olabilirliği, AIC’si ve beklenen sıklık tablosu yoktur. Aşağıdaki karşılaştırmada bu sütunlar onun için boş kalır; girebildiği sütun varyanstır. Yaptığı tek şey belirsizliği gerçekçi ölçmektir: sıfırları da kuyruğu da açıklamaz.
Fiyatlamada hangi modeli kullanacağımıza iki soruyla karar veriyoruz: hangisi veriyi bütün olarak daha iyi açıklıyor (AIC ve BIC) ve hangisi tablonun hangi hücresinde ne kadar yanılıyor (ki-kare testi). Olasılık dağılımı tanımlayan üç modelin log-olabilirliği, AIC’si ve BIC’si; dördüncü satırda yarı-Poisson. Son sütun dört modelin de verebildiği tek ölçüdür: hasar sayısına biçtikleri varyans.
model_karsilastirma <- data.frame(
  model = c("Poisson", "negatif binom", "sifir sisik Poisson", "yari-Poisson"),
  parametre = c(1, 2, 2, 2),
  log_olabilirlik = c(fit_poisson$loglik, fit_negbin$loglik, zip_uyum$value, NA),
  aic = c(fit_poisson$aic, fit_negbin$aic, 2 * 2 - 2 * zip_uyum$value, NA),
  bic = c(fit_poisson$bic, fit_negbin$bic,
          2 * log(length(hasar_sayisi)) - 2 * zip_uyum$value, NA),
  varyans = c(fit_poisson$estimate[["lambda"]],
              fit_negbin$estimate[["mu"]] +
                fit_negbin$estimate[["mu"]]^2 / fit_negbin$estimate[["size"]],
              (1 - plogis(zip_uyum$par[1])) * exp(zip_uyum$par[2]) *
                (1 + plogis(zip_uyum$par[1]) * exp(zip_uyum$par[2])),
              summary(yari_poisson)$dispersion * exp(coef(yari_poisson)[[1]]))
)
model_karsilastirma
#> model parametre log_olabilirlik aic bic varyans
#> 1 Poisson 1 -25795.27 51592.54 51601.14 0.2152500
#> 2 negatif binom 2 -21073.78 42151.56 42168.75 0.4898448
#> 3 sifir sisik Poisson 2 -22303.98 44611.96 44629.15 0.4042680
#> 4 yari-Poisson 2 NA NA NA 0.6688913parametre — tahmin edilen parametre sayısı \(k\): Poisson’da \(\lambda\); negatif binomda \(\mu\) ve \(\theta\); sıfır şişkin Poisson’da \(\pi\) ve \(\lambda\); yarı-Poisson’da \(\mu\) ve \(\phi\).NA — R’nin “değer yok” işaretidir. data.frame() her sütunda dört değer ister; yarı-Poisson’un log-olabilirliği olmadığı için o hücreye ve ondan hesaplanan AIC ile BIC hücrelerine NA yazılır.varyans — her modelin \(\operatorname{Var}(N)\) formülü, kendi bölümünden: Poisson’da \(\lambda\), negatif binomda \(\mu+\mu^{2}/\theta\), sıfır şişkin Poisson’da \((1-\pi)\lambda(1+\pi\lambda)\), yarı-Poisson’da \(\phi\mu\).2 * 2 - 2 * zip_uyum$value — fitdist() AIC’yi ve BIC’yi nesnede saklar, optim() hesaplamaz. Sıfır şişkin Poisson’unkileri Adayları sıralamak bölümündeki formüllerle, \(\text{AIC}=2k-2\ell\) ve \(\text{BIC}=k\log m-2\ell\), \(k=2\) ve \(m=40.000\) ile biz yazıyoruz. AIC sırası açık: negatif binom 42.151,56; sıfır şişkin Poisson 44.611,96; Poisson 51.592,54.
BIC aynı sırayı veriyor: 42.168,75; 44.629,15; 51.601,14. Parametre başına cezası \(\log 40.000\approx10{,}6\)’dır, AIC’nin 2’sinden ağır; ama en yakın iki model arasında bile log-olabilirlik farkı bini aştığı için daha ağır ceza sırayı değiştirmez.
Varyans sütunu başka bir soruyu yanıtlıyor. Verinin varyansı 0,6689’dur; onu dört ondalığa kadar tutturan tek model yarı-Poisson’dur. Bunu açıkladığı için değil, ölçtüğü için yapar: Yarı-Poisson’u uydurmak bölümünde gördüğümüz gibi \(\widehat{\phi}=s^{2}/\bar{n}\)’dir, bu yüzden \(\widehat{\phi}\,\widehat{\mu}=s^{2}\) olur.
AIC’de birinci olan negatif binom bile varyansı eksik tutar:
AIC her poliçeye verilen olasılığı ölçer, varyans sütunu ise oynaklığın büyüklüğünü. Negatif binom olasılıkları en iyi dağıtan modeldir, ama Negatif binomu uydurmak bölümündeki 10 ya da daha fazla hasarlı 45 poliçeyi seyrek beklediği için varyansı eksik tutar. Yarı-Poisson varyansı tutturur ama hiçbir hücreye olasılık vermez: 4+ hücresinde kaç poliçe bekleneceğini söyleyemez, bu yüzden aşağıdaki tabloya da ki-kare testine de giremez.
Sıklık tablolarını da yan yana koyalım:
round(rbind(gozlenen = c(gozlenen), poisson = poisson_beklenen,
            negatif_binom = negbin_beklenen, sifir_sisik = zip_beklenen), 1)
#> 0 1 2 3 4+
#> gozlenen 34764.0 3704.0 875.0 301.0 356.0
#> poisson 32253.6 6942.6 747.2 53.6 3.0
#> negatif_binom 34817.3 3293.9 1079.0 437.2 372.7
#> sifir_sisik 34764.0 2885.0 1577.2 574.8 198.9Negatif binom beş hücrenin üçünde (tek hasar, üç hasar ve 4+) gözlenene en yakın modeldir. Sıfır hücresini sıfır şişkin model tam tutturur, çünkü tahmini öyle kuruldu; iki hasar hücresinde ise Poisson daha yakındır (747,2’ye karşı negatif binomun 1.079,0’ı; gözlenen 875). Hiçbir model her hücreye oturmaz.
Farkların şans eseri olup olmadığını ki-kare uyum testiyle sınayalım; gofstat() aynı hücreleri kullansın diye kırılımları biz veriyoruz:
fitdistrplus::gofstat(list(fit_poisson, fit_negbin), chisqbreaks = 0:3,
                      fitnames = c("Poisson", "negatif binom"))
#> Chi-squared statistic: 44213.15 132.8966
#> Degree of freedom of the Chi-squared distribution: 3 2
#> Chi-squared p-value: 0 1.386355e-29
#> the p-value may be wrong with some theoretical counts < 5
#> Chi-squared table:
#> obscounts theo Poisson theo negatif binom
#> <= 0 34764 32253.593201 34817.2677
#> <= 1 3704 6942.585936 3293.8606
#> <= 2 875 747.195811 1078.9658
#> <= 3 301 53.611299 437.2224
#> > 3 356 3.013752 372.6835
#>
#> Goodness-of-fit criteria
#> Poisson negatif binom
#> Akaike's Information Criterion 51592.54 42151.56
#> Bayesian Information Criterion 51601.14 42168.75fitdistrplus::gofstat(list(...)) — uydurulmuş modelleri aynı veride karşılaştırır: ki-kare istatistiği, serbestlik derecesi, p değeri, AIC ve BIC. Yalnızca fitdistrplus’ın uydurma nesnelerini kabul eder; sıfır şişkin Poisson’u optim() ile uydurduğumuz için onun testini aşağıda kendimiz kuracağız.chisqbreaks = 0:3 — hücreleri 0, 1, 2, 3 ve “3’ten büyük” olarak kurar, yani yukarıdaki tablonun hücrelerini. Verilmezse: gofstat() hücreleri kendisi seçer; bu veride 0, 1, 2, 3–4 ve “4’ten büyük” hücrelerini kurar ve negatif binomun istatistiği 132,9 yerine 167,1 çıkar, tablomuzla karşılaştırılamaz. Çıktıda ki-kare istatistiğinin yanında iki satıra bakalım:
Degree of freedom — Poisson’da \(5-1-1=3\), negatif binomda \(5-1-2=2\): hücre sayısından 1 ve tahmin edilen parametre sayısı çıkar (Ki-kare uyum testi). Chi-squared p-value — Poisson’da R 0 yazar, çünkü olasılık R’nin bir sayı olarak tutabileceği en küçük değerden de küçüktür; negatif binomda \(1{,}4\cdot10^{-29}\)’dur. Poisson’un ki-kare istatistiği 44.213, negatif binomunki 132,9; negatif binomun p değeri yaklaşık \(10^{-29}\)’dur. Çıktıdaki uyarı Poisson içindir: “3’ten büyük” hücresinde beklenen sayısı 3,0’dır, 5’in altında.
Negatif binom en iyi adaydır, ama doğru model değildir: model doğru olsaydı bu büyüklükte bir fark pratikte hiç görülmezdi. Adayları sıralamak bölümünün sonundaki uyarının dediği gibi, AIC yalnızca adaylar arasında sıralama yapar. 40.000 poliçelik bir örnekte test küçük sapmaları da yakalar; bu yüzden asıl soru modelin reddedilip reddedilmediği değil, hangi hücrede ne kadar yanıldığıdır.
Her hücrenin katkısı \((O_k-E_k)^{2}/E_k\)’dir (Ki-kare uyum testi) ve istatistik bu katkıların toplamıdır. Katkıları hücre hücre görelim:
ki_kare_katkilari <- rbind(
  poisson = (c(gozlenen) - poisson_beklenen)^2 / poisson_beklenen,
  negatif_binom = (c(gozlenen) - negbin_beklenen)^2 / negbin_beklenen
)
round(ki_kare_katkilari, 1)
#> 0 1 2 3 4+
#> poisson 195.4 1510.7 21.9 1141.6 41343.6
#> negatif_binom 0.1 51.1 38.6 42.4 0.7Satır toplamları gofstat()’ın iki istatistiğidir. Poisson’un 44.213’ünün 41.343,6’sı, yani %93,5’i, tek bir hücreden, 4+’dan gelir: 356 poliçenin yerine 3,0 beklemek. Negatif binomun 132,9’u ise ortadaki üç hücreye dağılır (51,1; 38,6; 42,4); iki uçta katkısı 1’in altındadır. Negatif binom kuyruğu tutturur, ortayı tutturamaz.
Sıfır şişkin Poisson’un testini aynı hücrelerle kendimiz kuralım ve üç modelin p değerini ki-kare dağılımından hesaplayalım:
ki_kare_testi <- data.frame(
  model = c("Poisson", "negatif binom", "sifir sisik Poisson"),
  ki_kare = c(sum(ki_kare_katkilari["poisson", ]),
              sum(ki_kare_katkilari["negatif_binom", ]),
              sum((c(gozlenen) - zip_beklenen)^2 / zip_beklenen)),
  serbestlik = 5 - 1 - c(1, 2, 2)
)
ki_kare_testi$p_degeri <- pchisq(ki_kare_testi$ki_kare,
                                 df = ki_kare_testi$serbestlik,
                                 lower.tail = FALSE)
ki_kare_testi
#> model ki_kare serbestlik p_degeri
#> 1 Poisson 44213.1455 3 0.000000e+00
#> 2 negatif binom 132.8966 2 1.386355e-29
#> 3 sifir sisik Poisson 799.6973 2 2.228113e-174pchisq(q, df, lower.tail = FALSE) — df serbestlik dereceli ki-kare dağılımında q’yu aşma olasılığı, yani p değeri. pchisq() önek kuralına uyar: ki-kare dağılımının dağılım fonksiyonudur, lower.tail = FALSE sağ kuyruğu verir.İlk iki satır gofstat()’ın sayılarıdır. Sıfır şişkin Poisson’un ki-kare istatistiği 799,7’dir, negatif binomunkinin altı katı; p değeri yaklaşık \(10^{-174}\)’tür. Sıfır hücresini tam tutturduğu için o hücreden istatistiğe hiçbir katkı gelmez; 799,7’nin hepsi öbür dört hücreden, çoğu da tek ve iki hasar hücrelerinden gelir. Üç model de reddedilir; negatif binom en az kötü olandır.
Poliçeler arasındaki farkı gözlenen bir değişken açıklıyor mu? Yaş farkın tek kaynağı olsaydı aynı yaş kategorisindeki poliçelerin risk düzeyi aynı olur, kategorinin içinde hasar sayıları Poisson’a uyar ve varyans/ortalama oranı 1’e yakın çıkardı. Oranı yaş kategorilerinin içinde hesaplayalım:
yas_grubu_orani <- tapply(hasar_sayisi,
                          sayim_verisi$agecat[sayim_verisi$period == 1],
                          function(v) var(v) / mean(v))
round(yas_grubu_orani, 2)
#> 1 2 4 5 6 10
#> 3.62 3.69 2.89 2.90 2.63 2.82sayim_verisi$agecat[sayim_verisi$period == 1] — birinci yılın satırlarındaki yaş kategorileridir; hasar_sayisi ile aynı koşulla, aynı sırada seçildiği için her hasar sayısının yanına kendi poliçesinin yaşı düşer.function(v) var(v) / mean(v) — tapply()’ın her yaş kategorisinin hasar sayılarına ayrı ayrı uyguladığı adsız işlevdir: o kategorinin varyans/ortalama oranını verir.Oran her yaş kategorisinin içinde 2,63 ile 3,69 arasında kalır: farkı yaş açıklamaz. Poliçeleri ayıran şey gözlenmeyen bir risk düzeyidir. Açıklayıcı değişkenli modellere Hafta 10’da geçeceğiz. Bu farkın kalıcı olup olmadığını, yani aynı poliçelerin sonraki yıllarda da çok hasar bildirip bildirmediğini laboratuvarın Görev B’si ölçüyor.
Sigorta diliyle: Poisson’la fiyatlanan bir portföyde ortalama prim doğru çıkar, ama bir yılda dört ya da daha fazla hasar bildiren poliçe neredeyse imkânsız sayılır; 356 poliçenin yerine 3,0. Reasürans, sermaye ve hasarsızlık indirimi gibi kararların hepsi o kuyruğa bakar; yarı-Poisson belirsizliği düzeltir ama o kuyruğu vermez, negatif binom verir.
Şimdi toplamın ikinci parçasına, \(X\)’e geçiyoruz: gerçekleşmiş bir hasarın büyüklüğü. Önce Danimarka yangın hasarları dosyasını tanıyacak, sonra Hasar büyüklüğü için üç aday bölümündeki üç dağılımı ona uyduracağız.
danishuni.csv neyi anlatıyor?Büyüklük modellerinin bütün sayıları tek sütunlu bir dosyadan gelir; sayının neyin sayısı olduğunu ve hangi birimde okunduğunu dosyanın kendisi söylemez.
Dosya nedir? danishuni.csv, bir reasürans şirketinin kayıtlarına geçmiş büyük yangın hasarlarının tutarlarını tutar. Tutarlar 1985 değerlerine göre enflasyon düzeltmesi yapılmış milyon Danimarka kronu (mDKK) biriminde yazılıdır.
Nereden geldi? data_manifest.csv bu dosya için kaynağı fitdistrplus paketinin danishuni veri kümesi, kopyanın alındığı tarihi 24 Ağustos 2026 ve satır sayısını 2.167 olarak kaydeder; lisans alanında da fitdistrplus paketinin GPL (>= 2) lisansı ile özgün veri kümesinin kaynak gösteriminin korunduğu yazılıdır. Paket belgesi kaynağı şöyle anlatır: hasarlar Copenhagen Reinsurance’ta derlenmiştir ve 1980–1990 dönemini kapsar. Elinizdeki dosya dersin sabit kopyasıdır, yani dönem boyunca değişmez. Bunun tek bir nedeni var: aynı kodu çalıştıran herkes aynı sayıyı görsün.
Dosyanın kendisi. danishuni.csv dosyasını buradan indirebilirsiniz — 2.167 satır, tek sütun. Dersin bütün veri dosyaları tek bir depoda durur. Dosyayı nereye koymanız gerektiği yukarıda, Veri dosyaları: nerede duruyor, nasıl indirilir? bölümünde yazılı.
Bir satır neyi temsil ediyor? Bir satır bir yangın hasarıdır — bir poliçe değil, bir poliçe-yılı değil, bir sigortalı değil. Aynı binada iki ayrı yangın çıkmışsa dosyada iki satır vardır ve bu iki satırı birbirine bağlayacak bir poliçe kimliği yoktur. Ayrım yukarıdaki \(S=X_1+X_2+\cdots+X_N\) kuruluşuyla doğrudan bağlantılıdır: bu dosya \(X\)’lerin dosyasıdır, \(N\)’nin dosyası değildir.
Sütunlar. Dosyada tek sütun vardır; adı, dosyadan geldiği için İngilizcedir.
| Sütun | Anlamı | Birim | Kodlama ve değer alanı |
|---|---|---|---|
loss |
Bir yangın hasarının toplam tutarı | milyon Danimarka kronu (mDKK) | Sürekli ve pozitif ondalık sayı; kategori kodu yoktur. Değerler 1985 fiyat düzeyine getirilmiştir, yani 1980 ile 1990 hasarları aynı ölçekte karşılaştırılabilir |
Bu sütunda yanlış okumaya açık olan şey bir tamsayı kodu değil, birimdir. Buradaki bir 2, iki milyon Danimarka kronu demektir; iki kron ya da iki bin kron değil. Birimi yanlış okuyan öğrenci hiçbir uyarı almaz: uydurma yine yakınsar, grafikler yine çizilir. Yanlış okunan, tutar taşıyan her sayıdır: ortalama, kuantiller, ölçek parametreleri ve bunlardan çıkarılan prim–sermaye yorumu; şekil parametreleri ise birimden bağımsızdır (Alıştırma 13).
Hangi soruyu yanıtlıyoruz? Bu hafta dosyaya tek bir soru soruyoruz: gerçekleşmiş bir yangın hasarının büyüklüğü hangi dağılımla temsil edilebilir, ve aday dağılımlar büyük hasarlar bölgesinde birbirinden nerede ayrılır? Lognormal, Gamma ve Pareto II’yi bu sütuna uyduracak, uyumu histogram ve Q–Q grafiğiyle değerlendirecek, sonra aşağıdaki kutuda anlatılan seçilim eşiğini modele katacağız.
Dosyada yalnızca gerçekleşmiş hasarların tutarı vardır: poliçe sayısı, maruziyet süresi ve hasarsız dönemler yoktur; hasarın tarihi de bu kopyada yoktur. Dolayısıyla:
claims_long.csv ile ele aldık;Önce dosyanın beklenen yerde olup olmadığına bakalım:
veri_yolu <- file.path("data", "derived", "danishuni.csv")
file.exists(veri_yolu)
#> [1] TRUETRUE görmelisiniz. Şimdi dosyayı okuyup tablonun kendisine bakalım:
veri <- read_csv(veri_yolu, show_col_types = FALSE)
veri
#> # A tibble: 2,167 × 1
#> loss
#> <dbl>
#> 1 1.68
#> 2 2.09
#> 3 1.73
#> 4 1.78
#> 5 4.61
#> 6 8.73
#> 7 7.90
#> 8 2.21
#> 9 1.49
#> 10 2.80
#> # ℹ 2,157 more rowsÇıktı sözlükteki tek sütunu, loss’u, ondalıklı sayı (<dbl>) olarak gösterir. Hesaplar bu sütunun sayı vektörüyle yapılır; hasar o vektördür ve aşağıdaki özet dosyanın uçlarını toplar:
hasar <- veri$loss

c(gozlem_sayisi = length(hasar), en_kucuk = min(hasar),
  medyan = median(hasar), en_buyuk = max(hasar))
#> gozlem_sayisi en_kucuk medyan en_buyuk
#> 2167.000000 1.000000 1.778154 263.250366Özette gözlem sayısı 2.167, en küçük değer 1 mDKK çıkmalıdır; sözlüğün söz ettiği seçilim eşiği, en_kucuk değerinin kendisidir.
Tutarlar 1 ile 263 mDKK arasında, okunması kolay sayılardır; birimi değiştirmiyoruz. Aşağıdaki formüllerde tutarlar \(x_1,\ldots,x_n\) diye yazıldığı için vektöre kodda da x adını veriyoruz; hasar ile aynı vektördür. Sütuna ilk bakışı özet istatistiklerle atalım:
x <- hasar
summary(x)
#> Min. 1st Qu. Median Mean 3rd Qu. Max.
#> 1.000 1.321 1.778 3.385 2.967 263.250Özette medyan 1,78 mDKK, ortalama ise yaklaşık 3,39 mDKK çıkmalıdır; en büyük değer 263,25 mDKK’dır. Ortalamanın medyanın belirgin biçimde üzerinde kalması ve en büyük değerin bu kadar uzakta durması sağa çarpıklığın ilk işaretidir.
Adayları teker teker uyduruyoruz. Uyumlar eşiği yok sayar: her adayın tanım aralığı 0’dan başlar, veri ise 1 mDKK’dan; bunun bedelini Gövde bölümü ölçer. İlk aday lognormaldir; fitdist() nesnesi yazdırıldığında hangi dağılımın hangi yöntemle uydurulduğunu ve parametre tahminlerini standart hatalarıyla birlikte gösterir.
fit_lnorm <- fitdistrplus::fitdist(x, "lnorm")
fit_lnorm
#> Fitting of the distribution ' lnorm ' by maximum likelihood
#> Parameters:
#> estimate Std. Error
#> meanlog 0.7869501 0.01539288
#> sdlog 0.7165545 0.01088431meanlog 0,7870, sdlog 0,7166 çıkar; Std. Error sütunu ikisinin standart hatasıdır, 0,0154 ve 0,0109. Dört sayının da hangi formülden geldiği aşağıda, Lognormal tahminleri: kapalı biçim, payda ve model ortalaması bölümündedir.
İkinci aday Gamma’dır. Nesnenin biçimi aynıdır; değişen, parametrelerin adları ve değerleridir:
fit_gamma <- fitdistrplus::fitdist(x, "gamma")
fit_gamma
#> Fitting of the distribution ' gamma ' by maximum likelihood
#> Parameters:
#> estimate Std. Error
#> shape 1.2975373 0.03548267
#> rate 0.3832863 0.01273203İki tahmin kümesini yan yana okuyabilmek için tek bir listede toplayalım:
list(lognormal = fit_lnorm$estimate, gamma = fit_gamma$estimate)#> $lognormal
#> meanlog sdlog
#> 0.7869501 0.7165545
#>
#> $gamma
#> shape rate
#> 1.2975373 0.3832863Lognormalin iki parametresi tutarın değil logaritmasınındır; Gamma’nınkiler tutarın kendi dağılımının şekli ve oranıdır: \(\widehat{\alpha}=1{,}2975\), \(\widehat{\beta}=0{,}3833\). Üçüncü adayı da uydurduktan sonra üçünü aynı ölçütlerle sıralayacağız.
Pareto yoğunluk ve dağılım fonksiyonları actuar paketinden gelir, ama fitdist() onları doğrudan bulamaz. Aşağıdaki küçük sarmalayıcı işlevler (wrapper) bu yüzden tanımlanır: her biri yalnızca aynı adlı actuar işlevini çağırır. Laboratuvar betiğindekilerle birebir aynıdırlar.
dpareto <- function(x, shape, scale, log = FALSE) {
  actuar::dpareto(x, shape = shape, scale = scale, log = log)
}
ppareto <- function(q, shape, scale, lower.tail = TRUE, log.p = FALSE) {
  actuar::ppareto(q, shape = shape, scale = scale,
                  lower.tail = lower.tail, log.p = log.p)
}
qpareto <- function(p, shape, scale, lower.tail = TRUE, log.p = FALSE) {
  actuar::qpareto(p, shape = shape, scale = scale,
                  lower.tail = lower.tail, log.p = log.p)
}
rpareto <- function(n, shape, scale) {
  actuar::rpareto(n, shape = shape, scale = scale)
}

dpareto(c(1, 10), shape = 2, scale = 10)
#> [1] 0.150263 0.025000Son satır sarmalayıcının çalıştığını gösterir: Sıfır başlangıçlı Pareto / Pareto II bölümündeki yoğunluğun \(\alpha=2\) ve \(\theta=10\) ile 1 ve 10’daki değerleri 0,1503 ve 0,025’tir.
fitdist(..., distr = "pareto") — dağılım adından yola çıkar ve dpareto, ppareto, qpareto işlevlerini arama yolunda (search path), yani çalışma ortamında ve library() ile açılmış paketlerde arar; actuar:: önekli çağrılar bu aramaya girmez. Sarmalayıcılar tanımlanmazsa paket kurulu olsa bile fitdist() “The dpareto function must be defined” hatasıyla durur.log = FALSE argümanı — fitdist() yoğunluk işlevinde log argümanı varsa logaritmayı ondan ister, yoksa kendisi alır; argüman zorunlu değildir (log’suz bir sarmalayıcı aynı tahminleri verir). Ama tanımlandıysa actuar::dpareto()’ya aktarılmalıdır; aktarılmazsa uyum “error code 7” hatasıyla durur.lower.tail ve log.p — ppareto ile qpareto’daki bu iki argüman actuar’daki asıl işlevlere olduğu gibi aktarılır; Alıştırma 11 aşma olasılığını lower.tail = FALSE ile alır.Eniyileme algoritmasını öğrenci yazmaz; başlangıç noktasının makul olması ve yakınsama uyarılarının incelenmesi gerekir. Öğrenme hedefi algoritmayı kopyalamak değil, girdiyi, parametreleştirmeyi, yakınsamayı ve çıktıyı denetlemektir.
Pareto uyumunu aynı biçimde kuruyoruz; bu kez başlangıç noktasını ve parametrelerin alt sınırını biz veriyoruz:
fit_pareto <- fitdistrplus::fitdist(
  x, "pareto",
  start = list(shape = 2, scale = mean(x)),
  lower = c(shape = 1e-6, scale = 1e-6)
)
fit_pareto$estimate
#> shape scale
#> 5.366987 13.836646Yakınsayan uyum shape için 5,37, scale için 13,84 dolayında değerler vermelidir. Alıştırma 4 tam olarak bu iki sayıyı kullanır.
start = list(shape = 2, scale = mean(x)) — aramanın başladığı nokta. \(\alpha=2\)’de Pareto II’nin ortalaması \(\theta/(\alpha-1)=\theta\)’dır; \(\theta\)’yı örnek ortalamasına eşitlemek, aramayı ortalaması veriyle aynı, 3,39 mDKK olan bir modelden başlatır. lower = c(shape = 1e-6, scale = 1e-6) — iki parametreye alt sınır koyar; Pareto II’de ikisi de pozitif olmalıdır. Sınır verilmezse arama yer yer negatif değerler dener ve actuar o noktalarda yoğunluğu hesaplayamaz. Üç adayı, sıklık modellerinde yaptığımız gibi log-olabilirlik, AIC ve BIC ile sıralayalım:
buyukluk_karsilastirma <- data.frame(
  model = c("Lognormal", "Gamma", "Pareto II"),
  log_olabilirlik = c(fit_lnorm$loglik, fit_gamma$loglik, fit_pareto$loglik),
  aic = c(fit_lnorm$aic, fit_gamma$aic, fit_pareto$aic),
  bic = c(fit_lnorm$bic, fit_gamma$bic, fit_pareto$bic)
)
buyukluk_karsilastirma
#> model log_olabilirlik aic bic
#> 1 Lognormal -4057.897 8119.795 8131.157
#> 2 Gamma -4767.096 9538.191 9549.554
#> 3 Pareto II -4622.833 9249.666 9261.029Bu sıralamada lognormal açık farkla birinci: log-olabilirliği −4.057,897, AIC’si 8.119,79. Pareto II ikinci (9.249,67), Gamma son (9.538,19); BIC aynı sırayı verir (8.131,16; 9.261,03; 9.549,55).
Tablodaki sayılar Adayları sıralamak bölümündeki tanımlardan gelir: \(\mathrm{AIC}=2k-2\ell\) ve \(\mathrm{BIC}=k\log n-2\ell\). Üç adayın da iki parametresi olduğundan (\(k=2\)) cezalar her modelde aynıdır ve sıralamayı yalnızca log-olabilirlik belirler; üç modelin AIC ve BIC’sini Alıştırma 5 elle hesaplatır.
Sıralama hangi adayın daha iyi olduğunu söyler, iyi olup olmadığını söylemez. Aşağıdaki histogram bu üç uyumun eşikte yanıldığını gösterecek.
Lognormalin yoğunluğu, \(\log x\)’in normal yoğunluğunun \(1/x\) ile çarpımıdır (Lognormal bölümü). Bu çarpan parametre içermez; log-olabilirliğe yalnızca \(-\sum\log x_i\) diye bir sabit ekler. Tahminler bu yüzden normal dağılımın tahminleridir, logaritmalara uygulanmış hâliyle. \(\mu\)’ye göre türev \(\sum(\log x_i-\mu)/\sigma^{2}\), \(\sigma\)’ya göre türev \(-n/\sigma+K/\sigma^{3}\)’tür, \(K=\sum(\log x_i-\mu)^{2}\). İkisi sıfıra eşitlenince:
\[ \begin{aligned} \widehat{\mu}&=\frac1n\sum_{i=1}^{n}\log x_i,\\ \widehat{\sigma}&=\sqrt{\frac1n\sum_{i=1}^{n}(\log x_i-\widehat{\mu})^{2}} . \end{aligned} \]
İki tahmin de aramaya gerek kalmadan formülle yazılır; buna kapalı biçimli çözüm (closed-form solution) denir. \(\widehat{\mu}\) logaritmaların ortalamasıdır ve \(\sigma\)’yı bilmeden bulunur. \(\widehat{\sigma}\)’nın paydasındaki \(n\), \(n\) gözlemin her birinin log-olabilirliğe taşıdığı \(-\log\sigma\) teriminden gelir. fit_lnorm’un 0,7870 ve 0,7166’sı bu iki formülün değeridir.
Standart hatalar. Tepede ikinci türevler \(\mu\) için \(-n/\widehat{\sigma}^{2}\), \(\sigma\) için \(-2n/\widehat{\sigma}^{2}\)’dir. Karma türev \(\sum(\log x_i-\mu)\) ile orantılıdır ve \(\widehat{\mu}\)’de bu toplam sıfırdır. Poisson’u uydurmak bölümündeki eğrilik kuralı, \(\operatorname{se}=1/\sqrt{-\ell''}\), bu yüzden iki parametreye ayrı ayrı uygulanır:
\[ \begin{aligned} \operatorname{se}(\widehat{\mu})&=\frac{\widehat{\sigma}}{\sqrt{n}},\\ \operatorname{se}(\widehat{\sigma})&=\frac{\widehat{\sigma}}{\sqrt{2n}} . \end{aligned} \]
fit_lnorm’un Std. Error sütunundaki 0,0154 ve 0,0109 bunlardır. İkisi de \(\sqrt{n}\) ile küçülür; 2.167 hasar iki parametreyi dar biçimde belirler. Küçük bir standart hata modelin doğru olduğunu söylemez, yalnızca bu modelin içinde tahminin kesin olduğunu söyler. Modelin veriye uyup uymadığını aşağıdaki histogram ve Q–Q grafiği sınar.
Payda. R’nin sd()’si varyansı ortalamada yansız yapmak için \(n-1\)’e böler, maksimum olabilirlik ise \(n\)’ye. Paketin sdlog’unu sd(log(x)) ile denetlemek isteyen biri bu yüzden iki farklı büyüklüğü karşılaştırır. Formülü, paketin değerini ve sd()’ninkini yan yana koyalım:
payda_karsilastirmasi <- list(
  sonuclar = c(mle_payda_n = sqrt(mean((log(x) - mean(log(x)))^2)),
               paket_sdlog = fit_lnorm$estimate[["sdlog"]],
               sd_payda_n_eksi_1 = sd(log(x))),
  uyumlu = isTRUE(all.equal(fit_lnorm$estimate[["sdlog"]], sd(log(x)),
                            tolerance = 1e-5))
)
payda_karsilastirmasi
#> $sonuclar
#> mle_payda_n paket_sdlog sd_payda_n_eksi_1
#> 0.7165545 0.7165545 0.7167199
#>
#> $uyumlu
#> [1] FALSEİlk iki sayı aynıdır: paketin sdlog’u paydası \(n\) olan formüldür. sd()’nin değeri dördüncü ondalıkta ayrışır, 0,7166 ile 0,7167, ve uyumlu alanı FALSE çıkar: sd() ile yazılmış bir denetim, maksimum olabilirlik kodu doğru olsa bile başarısız olurdu. İki değerin oranı \(\sqrt{(n-1)/n}\)’dir; 2.167 gözlemde 1’e çok yakındır, birkaç gözlemlik bir örnekte belirgin biçimde küçülür (Alıştırma 3).
log(x) — R’de log() doğal logaritmadır, tabanı \(e\)’dir; meanlog ile sdlog, tutarların doğal logaritmasının ortalaması ve standart sapmasıdır. Hafta 2’de kullandığımız scale_x_log10()’un tabanı ise 10’dur. Taban-10 logaritmasıyla hesaplanan bir sdlog \(\ln(10)\approx2{,}30\) kat küçük çıkar ve dlnorm() ile çizilen eğri veriye hiç benzemez; bunu haber veren bir hata iletisi çıkmaz. Model ortalaması. meanlog logaritmik ölçekte bir konum parametresidir, para birimindeki ortalama hasar değildir: \(e^{0{,}7870}=2{,}20\) mDKK uydurulan lognormalin medyanıdır. Ortalamayı Lognormal bölümündeki formül verir:
\[ E[X]=e^{\widehat{\mu}+\widehat{\sigma}^{2}/2}=2{,}84\ \text{mDKK}. \]
Örnek ortalaması 3,39 mDKK’dır; model ortalaması ondan yaklaşık %16 düşüktür. Bu lognormalle fiyatlanan bir teminat, hasar başına beklenen tutarı gözlenenden %16 düşük hesaplar.
Nedeni, tahminin neyi tutturduğudur: lognormalin türev denklemleri logaritmaların ortalamasını ve yayılımını tutturur, tutarların ortalamasını değil. Logaritma büyük tutarları sıkıştırır: 263,25 mDKK’lık en büyük hasar log ölçeğinde 5,57’dir ve tahmini, tutar ölçeğinde olduğu kadar yukarı çekemez.
Lognormalde iki türev denklemi formülle çözüldü. Gamma ile Pareto II’de de log-olabilirliğin türevlerini sıfıra eşitleyebiliriz; ama ortaya çıkan iki denklemden biri, parametreyi yalnız bırakacak biçimde cebirle çözülemez. fitdist() tepeyi bu yüzden sayısal olarak arar. Denklemler yine de işe yarar: tahminin veride neyi tutturduğunu söylerler.
Gamma. Gamma bölümündeki yoğunluktan kurulan log-olabilirliğin iki türev denklemi şunlardır; \(\bar{x}\) örnek ortalaması, \(\overline{\log x}\) logaritmaların ortalamasıdır, yani lognormalin \(\widehat{\mu}\)’sü:
\[ \begin{aligned} \frac{\widehat{\alpha}}{\widehat{\beta}}&=\bar{x},\\ \log\widehat{\alpha}-\psi(\widehat{\alpha})&=\log\bar{x}-\overline{\log x} . \end{aligned} \]
Birincisi \(\beta\)’ya göre türevden gelir: \(n\alpha/\beta-\sum x_i=0\). İkincisi \(\alpha\)’ya göre türevden gelir: \(\log\Gamma(\alpha)\)’nın türevi, Negatif binomu uydurmak bölümündeki digamma işlevi \(\psi(\alpha)\)’dır ve \(\beta\) yerine birinci denklemden gelen \(\alpha/\bar{x}\) konunca denklem tek bilinmeyene iner.
Birinci denklem, Gamma’nın ortalaması \(\alpha/\beta\) olduğu için (Gamma bölümü), modelin ortalamasını örnek ortalamasına eşitler: uydurulan Gamma’nın ortalaması 3,385 mDKK’dır, örnek ortalamasının kendisi. Lognormal ise ortalamayı tutturmuyordu (2,84).
Bu, ortalamaya dayanan bir prim için Gamma’yı çekici gösterir, ama yukarıdaki sıralamada Gamma sonuncudur: ortalamayı tutturmak dağılımın biçimini tutturmak değildir. Uydurulan Gamma’nın standart sapması ortalamasının 0,88 katıdır (\(1/\sqrt{\widehat{\alpha}}\), Gamma bölümü); verinin standart sapması ise ortalamasının 2,51 katı.
İkinci denklemin sağ tarafı veriden gelen tek bir sayıdır, 0,4324: ortalamanın logaritması ile logaritmaların ortalaması arasındaki fark. Tutarların hepsi eşit olsaydı fark sıfır olurdu; tutarlar yayıldıkça büyür. Sol taraf \(\alpha\) büyüdükçe azaldığı için büyük bir fark küçük bir \(\widehat{\alpha}\), yani büyük bir standart sapma / ortalama oranı verir.
Ama \(\psi\)’nin içinden \(\alpha\)’yı çekecek bir cebir yoktur; denklem ancak sayısal çözülür. fitdist() kökü \(\widehat{\alpha}=1{,}2975\)’te bulur; \(\widehat{\beta}\) birinci denklemden 0,3833’tür.
Pareto II. Sıfır başlangıçlı Pareto / Pareto II bölümündeki yoğunluktan kurulan log-olabilirliğin iki türev denklemi şunlardır:
\[ \begin{aligned} \alpha&=\frac{n}{\sum_{i=1}^{n}\log(1+x_i/\theta)},\\ \frac{n\alpha}{\theta}&=(\alpha+1)\sum_{i=1}^{n}\frac{1}{\theta+x_i} . \end{aligned} \]
Birincisi \(\alpha\)’ya göre türevin sıfır olmasından, \(\theta\) verilmiş sayılarak \(\alpha\) yalnız bırakılınca çıkar; ikincisi \(\theta\)’ya göre türevin sıfır olmasıdır. Birinci denklem \(\alpha\)’nın neyi ölçtüğünü söyler: tutarlar \(\theta\)’ya göre ne kadar büyükse paydadaki toplam o kadar büyür ve \(\alpha\) o kadar küçülür, yani kuyruk ağırlaşır.
Birinci denklem ikinciye konunca \(\theta\) hem \(\log(1+x_i/\theta)\) toplamının hem \(1/(\theta+x_i)\) toplamının içinde kalır ve yalnız bırakılamaz. fitdist()’in 5,37 ve 13,84’ü bu yüzden sayısal aramadan gelir; iki denklem de bu noktada sağlanır.
Pareto II de ortalamayı tutturmaz: modelin ortalaması \(\widehat{\theta}/(\widehat{\alpha}-1)\) 3,17 mDKK’dır, örneğinki 3,39. Tahmin denklemleri her modelin veride neyi tutturduğunu söyler, modelin veriye uyup uymadığını söylemez; onu log-olabilirliğin sıralaması, aşağıdaki histogram ve Q–Q grafiği söyler.
AIC lognormalin üç aday içinde en iyisi olduğunu söyledi, ama modellerin hangi tutarlarda yanıldığını söylemez. Bunu görmek için eşiği yok sayan üç uyumu tek bir histogram üzerinde karşılaştıracağız. Çizimden önce üzerinde çalışacağımız aralığı belirleyelim: en büyük gözlemler yatay ekseni dağılımın gövdesi okunamayacak kadar uzattığı için üst sınırı quantile(x, 0.99) ile alıyoruz.
ust_sinir <- unname(quantile(x, 0.99))
ust_sinir
#> [1] 26.04253ust_sinir 26,04 mDKK’dır: hasarların %99’u bu değerin altında kalır. quantile() varsayılan yöntemde \(p\) kuantilinin sıralı gözlemler arasındaki yerini \(h=1+(n-1)p\) alır; \(h\) tam sayı değilse iki komşu gözlemin arasında doğrusal ilerler.
Yoğunlukları bu sınıra kadar uzanan eşit aralıklı bir noktalar dizisi üzerinde hesaplayacağız. izgara o dizidir; ilk değeri verinin en küçük gözlemidir:
izgara <- seq(min(x), ust_sinir, length.out = 300)
head(izgara)
#> [1] 1.000000 1.083754 1.167509 1.251263 1.335017 1.418771seq(min(x), ust_sinir, length.out = 300) — iki uç arasında eşit aralıklı 300 sayı; her model eğrisi bu noktalardaki yoğunluk değerlerinden çizilir. Şimdi üç modelin yoğunluğunu aynı ızgarada hesaplayıp uzun biçimli tek bir çerçevede toplayalım. yogunluk_egrileri çerçevesinin her satırı bir modeli bir tutarla eşler; yogunluk sütunu o noktadaki yoğunluk değeridir:
yogunluk_egrileri <- data.frame(
  tutar = rep(izgara, 3),
  yogunluk = c(
    dlnorm(izgara,
                  meanlog = fit_lnorm$estimate[["meanlog"]],
                  sdlog = fit_lnorm$estimate[["sdlog"]]),
    dgamma(izgara,
                  shape = fit_gamma$estimate[["shape"]],
                  rate = fit_gamma$estimate[["rate"]]),
    dpareto(izgara,
            shape = fit_pareto$estimate[["shape"]],
            scale = fit_pareto$estimate[["scale"]])
  ),
  model = factor(
    rep(c("Lognormal", "Gamma", "Pareto II"), each = length(izgara)),
    levels = c("Lognormal", "Gamma", "Pareto II")
  )
)

head(yogunluk_egrileri)
#> tutar yogunluk model
#> 1 1.000000 0.3046155 Lognormal
#> 2 1.083754 0.3159531 Lognormal
#> 3 1.167509 0.3231734 Lognormal
#> 4 1.251263 0.3268566 Lognormal
#> 5 1.335017 0.3275565 Lognormal
#> 6 1.418771 0.3257808 Lognormalrep(izgara, 3) — ızgarayı uç uca üç kez yazar, çünkü aynı tutar değeri üç modelin her birinde bir kez yer alacaktır. rep(..., each = ) biçimi ise her öğeyi arka arkaya tekrarlar; model sütununda bilerek o kullanılıyor, böylece iki sütun doğru hizalanır.dlnorm(), dgamma(), dpareto() — üç modelin yoğunluk işlevleri: d öneki yoğunluk demektir (Hasar büyüklüğü için üç aday bölümündeki önek kuralı). d yerine p yazmak hata vermez: grafiğe yoğunluk yerine 0 ile 1 arasında artan bir eğri çizer ve histogramın yanında tanınmayacak kadar yanlış görünür.Çizim bloğu yalnızca çizim yapar: gri histogram gözlenen dağılımı, üç renkli çizgi de yogunluk_egrileri’nin 900 satırını gösterir; geom_line() her modelin 300 noktasını sırayla düz çizgilerle birleştirir.
ggplot(data.frame(tutar = x), aes(x = tutar)) +
  geom_histogram(
    aes(y = after_stat(density)),
    binwidth = ust_sinir / 40, boundary = 1,
    fill = "grey85", colour = "white"
  ) +
  geom_line(
    data = yogunluk_egrileri,
    aes(x = tutar, y = yogunluk, colour = model),
    linewidth = 0.9
  ) +
  scale_colour_manual(
    values = c("Lognormal" = "#1F4E79", "Gamma" = "#2E75B6",
               "Pareto II" = "#F28E2B")
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  coord_cartesian(xlim = c(0, ust_sinir)) +
  labs(
    x = "Hasar tutarı (milyon DKK)", y = "Yoğunluk", colour = "Model"
  ) +
  theme_minimal(base_size = 12)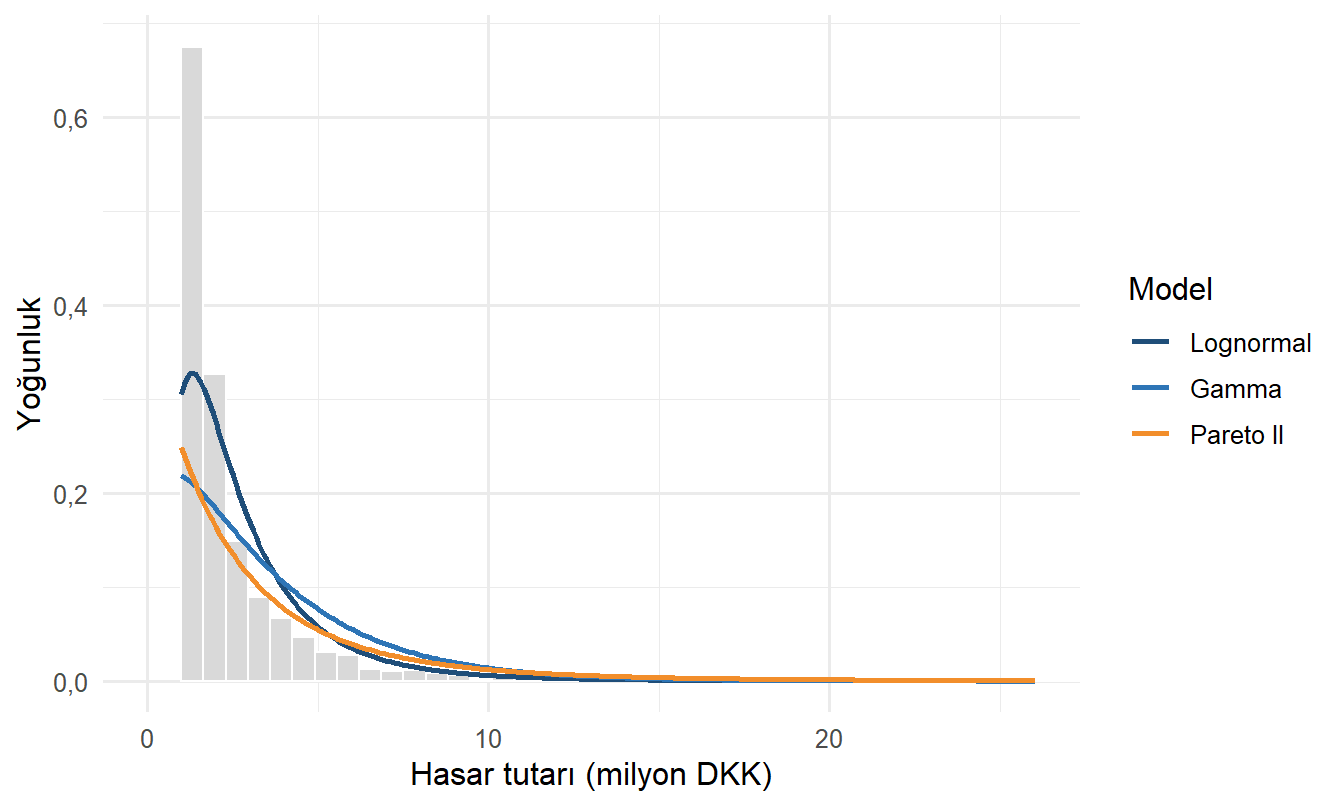
aes(y = after_stat(density)) — histogramın düşey eksenini sayım yerine yoğunluğa çevirir. after_stat(), ggplot2’nin kendi hesapladığı bir büyüklüğü (burada density) estetiğe bağlamanın yoludur. Verilmezse: eksen sayım olur ve yoğunluk eğrileri — değerleri 1’in altında kaldığı için — histogramın tabanına yapışır; iki şey aynı grafikte karşılaştırılamaz hâle gelir.geom_line(data = , aes(...)) — katmanın kendi verisini kullanır. Buradaki ggplot() çağrısı ham tutarlarla kurulmuştur; yoğunluk eğrileri başka bir çerçeveden gelir ve katman düzeyinde data = vermek ikisini tek grafikte birleştirmenin yoludur.Bu grafiği iki aşamada kuralım. Ayrım basittir: önce ölçüt, sonra adaylar.
Aşama 1 — yalnızca gözlenen dağılım. Yukarıda açıklanan after_stat(density) sayesinde düşey eksen yoğunluktur; bu aşama o ekseni tek başına gösterir. Karşılaştırmanın ölçütü budur — eğriler bunun altına ya da üstüne düşecektir.
ggplot(data.frame(tutar = x), aes(x = tutar)) +
  geom_histogram(
    aes(y = after_stat(density)),
    binwidth = ust_sinir / 40, boundary = 1,
    fill = "grey85", colour = "white"
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  coord_cartesian(xlim = c(0, ust_sinir)) +
  labs(
    x = "Hasar tutarı (milyon DKK)", y = "Yoğunluk", colour = "Model"
  ) +
  theme_minimal(base_size = 12)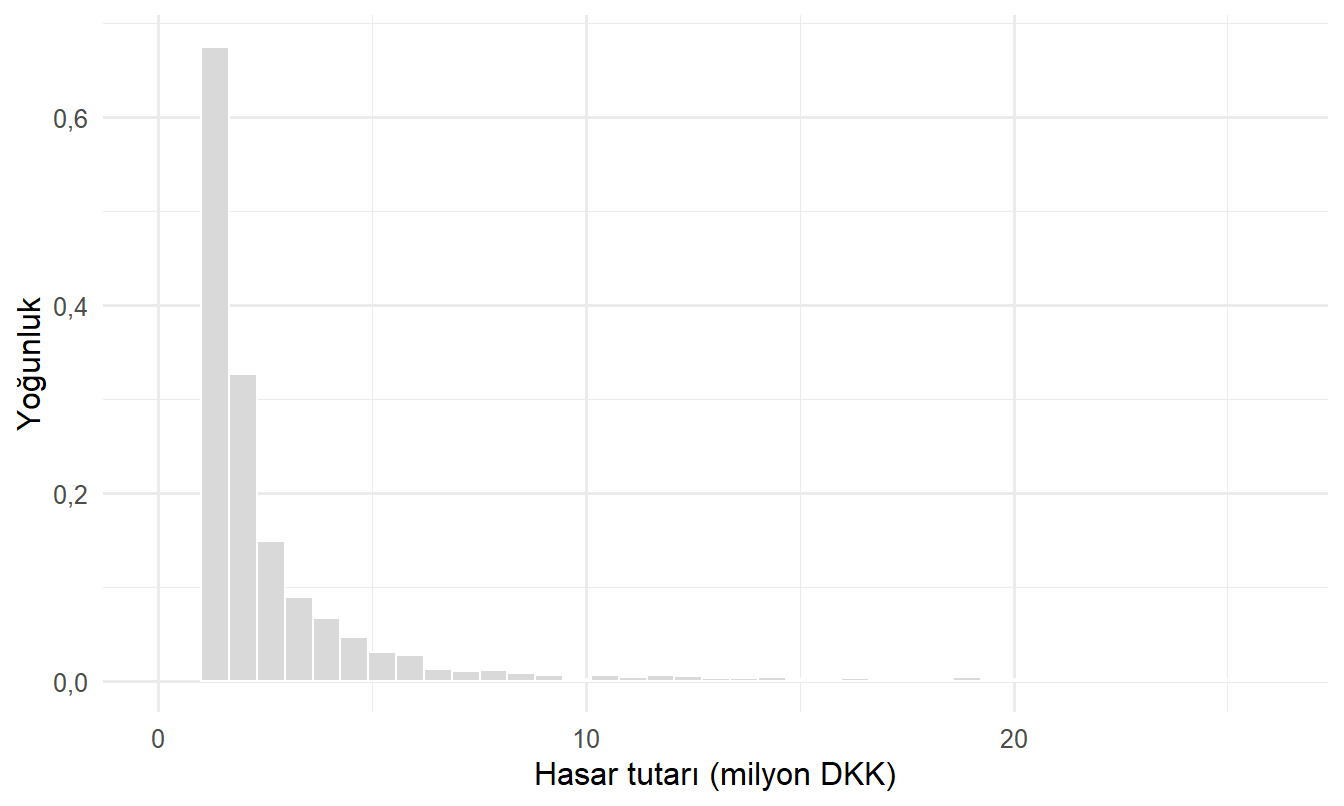
Bu aşamanın argümanları:
binwidth = ust_sinir / 40 — kutucuk genişliği, \(26{,}04/40=0{,}651\) mDKK. Bu bir seçimdir: daha dar kutucuk ilk çubuğu yükseltir, daha geniş kutucuk alçaltır, ama ilk çubuk her genişlikte en yüksek çubuk kalır. boundary = 1 — kutucuk sınırlarını 1 mDKK’dan başlatır, yani ilk kutucuk tam eşikte açılır. Genişlik 0,651 mDKK olduğu için boundary = 0 yazılsaydı sınırlar 0; 0,651; 1,302 … olur ve eşik 0,651 ile 1,302 arasındaki kutucuğun içine düşerdi: o kutucuğun yarısından fazlası boş kalır, ilk çubuk 0,37’ye iner ve en yüksek çubuk ikinci kutucuğa (0,51) kayar. Grafikte veride olmayan bir tepe görünür. fill = "grey85" ve colour = "white" — çubuğun içi ve kenarı; histogram renksizdir, çünkü renk modelleri ayırır.coord_cartesian(xlim = c(0, ust_sinir)) — yatay eksene yakınlaştırır. ust_sinir verinin %99’luk kuantilidir. Verilmezse: eksen en büyük gözleme, yani 263 mDKK’ya kadar uzar ve dağılımın gövdesi soldaki birkaç piksele sıkışır. Aynı işi scale_x_continuous(limits = ...) ile yapmak aynı şey değildir: o, aralığın dışındaki satırları çizimden önce atar, dolayısıyla histogramın yoğunluğu da yeniden hesaplanır.labels = label_number(...) iki ekseni Türkçe sayı biçimine çevirir, base_size = 12 bütün yazıları birlikte büyütür.Aşama 2 — üç aday eğri. Tek eklenen katman geom_line(), tek eklenen ölçek scale_colour_manual()’dır; histogram hiç değişmez. Bu aşama yukarıdaki asıl bloğun tamamıdır.
ggplot(data.frame(tutar = x), aes(x = tutar)) +
  geom_histogram(
    aes(y = after_stat(density)),
    binwidth = ust_sinir / 40, boundary = 1,
    fill = "grey85", colour = "white"
  ) +
  geom_line(
    data = yogunluk_egrileri,
    aes(x = tutar, y = yogunluk, colour = model),
    linewidth = 0.9
  ) +
  scale_colour_manual(
    values = c("Lognormal" = "#1F4E79", "Gamma" = "#2E75B6",
               "Pareto II" = "#F28E2B")
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  coord_cartesian(xlim = c(0, ust_sinir)) +
  labs(
    x = "Hasar tutarı (milyon DKK)", y = "Yoğunluk", colour = "Model"
  ) +
  theme_minimal(base_size = 12)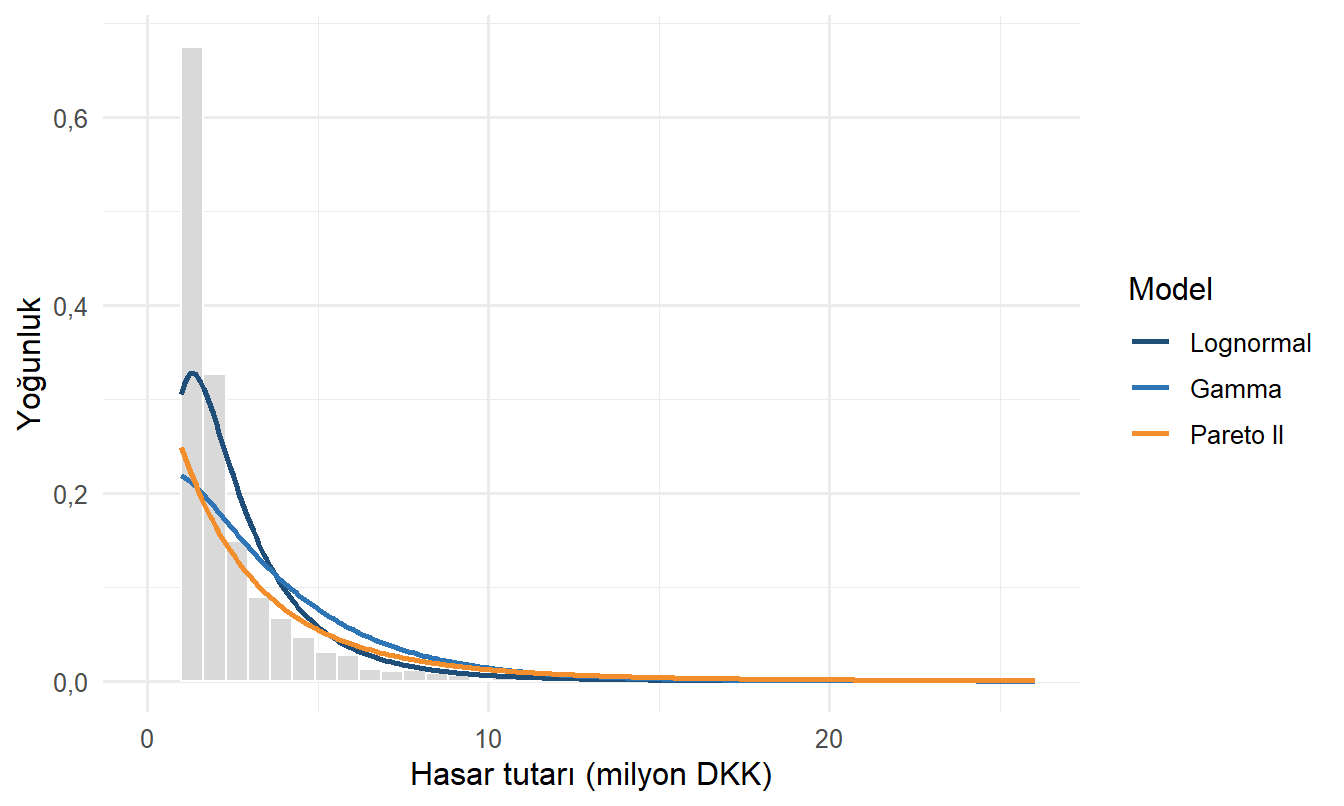
linewidth = 0.9 — eğrilerin kalınlığı; histogramın üzerinde kaybolmayacak, ama çubukları da örtmeyecek kadar.İki aşamayı yan yana okumanın kazancı şudur: birinci aşamada eşikteki ilk çubuğun 0,67’lik yüksekliği veriden gelir; ikinci aşamada eğrilerin en yükseği 0,33’te kalır. Yani uyumsuzluk eğrilerin yanlış çizilmesinden değil, üçünün de o yığılmayı üretememesinden gelmektedir.
Grafiği olasılıklarla okuyalım. Yoğunluk ölçeğinde bir çubuğun alanı o kutucuktaki gözlemlerin payıdır; bir modelin aynı kutucuğa verdiği olasılık da eğrisinin o aralıktaki alanı, yani dağılım fonksiyonunun iki uçtaki farkıdır. Üç modelin de veriden en çok ayrıldığı yer eşikteki ilk kutucuktur, 1 ile 1,651 mDKK arası. Orada veriyi ve üç modeli yan yana koyalım:
ilk_kutucuk_olasiligi <- c(
  veri      = mean(x <= 1 + ust_sinir / 40),
  lognormal = plnorm(1 + ust_sinir / 40,
                     meanlog = fit_lnorm$estimate[["meanlog"]],
                     sdlog = fit_lnorm$estimate[["sdlog"]]) -
    plnorm(1, meanlog = fit_lnorm$estimate[["meanlog"]],
           sdlog = fit_lnorm$estimate[["sdlog"]]),
  gamma     = pgamma(1 + ust_sinir / 40,
                     shape = fit_gamma$estimate[["shape"]],
                     rate = fit_gamma$estimate[["rate"]]) -
    pgamma(1, shape = fit_gamma$estimate[["shape"]],
           rate = fit_gamma$estimate[["rate"]]),
  pareto_ii = ppareto(1 + ust_sinir / 40,
                      shape = fit_pareto$estimate[["shape"]],
                      scale = fit_pareto$estimate[["scale"]]) -
    ppareto(1, shape = fit_pareto$estimate[["shape"]],
            scale = fit_pareto$estimate[["scale"]])
)
round(ilk_kutucuk_olasiligi, 3)
#> veri lognormal gamma pareto_ii
#> 0.439 0.209 0.136 0.142Veride %43,9, lognormalde %20,9, Pareto II’de %14,2, Gamma’da %13,6. En iyi model bile eşiğin hemen üstündeki hasarların yarısından azını bekliyor; grafikte 0,67’lik ilk çubuğun bütün eğrilerin üstünde kalması budur.
Eğrilerin eşikte bu kadar alçak kalmasının bir nedeni var: üç modelin de tanım aralığı 0’dan başlar, veri ise 1 mDKK’dan. Uydurulan her model olasılığının bir bölümünü hiç gözlem olmayan 0–1 aralığına koyar ve o bölüm eşiğin üstünde eksik kalır. Her modelin 1 mDKK’nın altına koyduğu olasılık:
esik_alti_olasilik <- c(
  lognormal = plnorm(1, meanlog = fit_lnorm$estimate[["meanlog"]],
                     sdlog = fit_lnorm$estimate[["sdlog"]]),
  gamma     = pgamma(1, shape = fit_gamma$estimate[["shape"]],
                     rate = fit_gamma$estimate[["rate"]]),
  pareto_ii = ppareto(1, shape = fit_pareto$estimate[["shape"]],
                      scale = fit_pareto$estimate[["scale"]])
)

round(esik_alti_olasilik, 3)
#> lognormal gamma pareto_ii
#> 0.136 0.200 0.312Lognormal olasılığının %13,6’sını, Gamma %20,0’ını, Pareto II %31,2’sini eşiğin altına koyuyor.
plnorm(1, meanlog, sdlog) ve pgamma(1, shape, rate) — p öneki dağılım fonksiyonudur, burada \(P(X\le1)\); ppareto() sarmalayıcıdır.Veride eşiğin altında hiçbir şey olmadığı için bu, modellerin baştan yanlış kurulduğunu gösterir: sorun yalnız hangi dağılımın seçildiği değil, üçünün de eşiği hesaba katmamasıdır. Bir gözlemin ancak bir eşiği aştığında kaydedilmesine sol kesme (left truncation) denir. Aynı durum sağkalım verisinde, gözleme belli bir yaştan sonra giren kişilerde de görülür.
Eşiği modele katmanın yolu, her hasarın yoğunluğunu eşiği aşma olasılığına bölmektir, \(f(x)/P(X>1)\); model böylece olasılığının tamamını eşiğin üstüne verir. Bu hafta bu düzeltmeyi yapmıyoruz: aşağıdaki kuyruk karşılaştırması ve alıştırmalar eşiği yok sayan bu üç uyumla çalışır; sonuçları da bu kısıtla okunur.
Histogram dağılımın gövdesini gösterdi; kuyruğu göstermez, çünkü büyük tutarların çubukları neredeyse boştur. Oysa reasürans ve sermaye kararları tam o bölgeye bakar. Eşiği yok sayan üç uyumun kuyruğuna Uyum nasıl değerlendirilir? bölümündeki Q–Q grafiğiyle bakalım. Önce sıralanmış gözlemlere karşılık gelen kuramsal olasılıkları üretelim. ppoints() bu olasılıkları 0 ile 1 arasına, uçlara değmeden yerleştirir; 10’dan fazla gözlemde tam olarak \((i-0{,}5)/n\)’dir (Q–Q grafiği):
qq_olasilik <- ppoints(length(x))
head(qq_olasilik)
#> [1] 0.0002307337 0.0006922012 0.0011536687 0.0016151361 0.0020766036
#> [6] 0.0025380711Son olasılık 0,99977’dir: grafiğin en sağdaki noktası modeli aşağıdaki tablonun %99,9 kuantilinden de ötede sınar.
Bir modelin \(p\) kuantili, dağılım fonksiyonunun \(p\)’ye eşit olduğu tutardır: \(F(q)=p\). qq_veri çerçevesi üç modelin bu kuantillerini sıralı gözlemlerle yan yana koyar; her satırı bir model için bir kuramsal–gözlenen çiftidir:
qq_veri <- data.frame(
  kuramsal = c(
    qlnorm(qq_olasilik, meanlog = fit_lnorm$estimate[["meanlog"]],
           sdlog = fit_lnorm$estimate[["sdlog"]]),
    qgamma(qq_olasilik, shape = fit_gamma$estimate[["shape"]],
           rate = fit_gamma$estimate[["rate"]]),
    qpareto(qq_olasilik, shape = fit_pareto$estimate[["shape"]],
            scale = fit_pareto$estimate[["scale"]])
  ),
  gozlenen = rep(sort(x), 3),
  model = factor(
    rep(c("Lognormal", "Gamma", "Pareto II"), each = length(x)),
    levels = c("Lognormal", "Gamma", "Pareto II")
  )
)

head(qq_veri)
#> kuramsal gozlenen model
#> 1 0.1786096 1 Lognormal
#> 2 0.2221266 1 Lognormal
#> 3 0.2473952 1 Lognormal
#> 4 0.2662677 1 Lognormal
#> 5 0.2817038 1 Lognormal
#> 6 0.2949494 1 Lognormalqlnorm(), qgamma(), qpareto() — kuantil işlevleri (önek kuralındaki q): bir olasılıktan değer verir.İlk satırda lognormal en küçük hasara, 1 mDKK’ya, 0,18 mDKK biçiyor: model kuantillerini veride hiç olmayan, eşiğin altındaki tutarlardan başlatır.
Noktaları çizelim; kesikli doğru, kuramsal kuantil ile gözlenen kuantilin eşit olduğu yeri gösterir:
p_qq <- ggplot(qq_veri, aes(x = kuramsal, y = gozlenen)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2,
                       colour = "#1A2238") +
  geom_point(aes(colour = model),
                      alpha = 0.45, size = 0.9, show.legend = FALSE) +
  facet_wrap(~ model, scales = "free") +
  scale_colour_manual(
    values = c("Lognormal" = "#1F4E79", "Gamma" = "#2E75B6",
               "Pareto II" = "#F28E2B")
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  labs(
    x = "Kuramsal kuantil (milyon DKK)", y = "Gözlenen kuantil (milyon DKK)"
  ) +
  theme_minimal(base_size = 12)

p_qq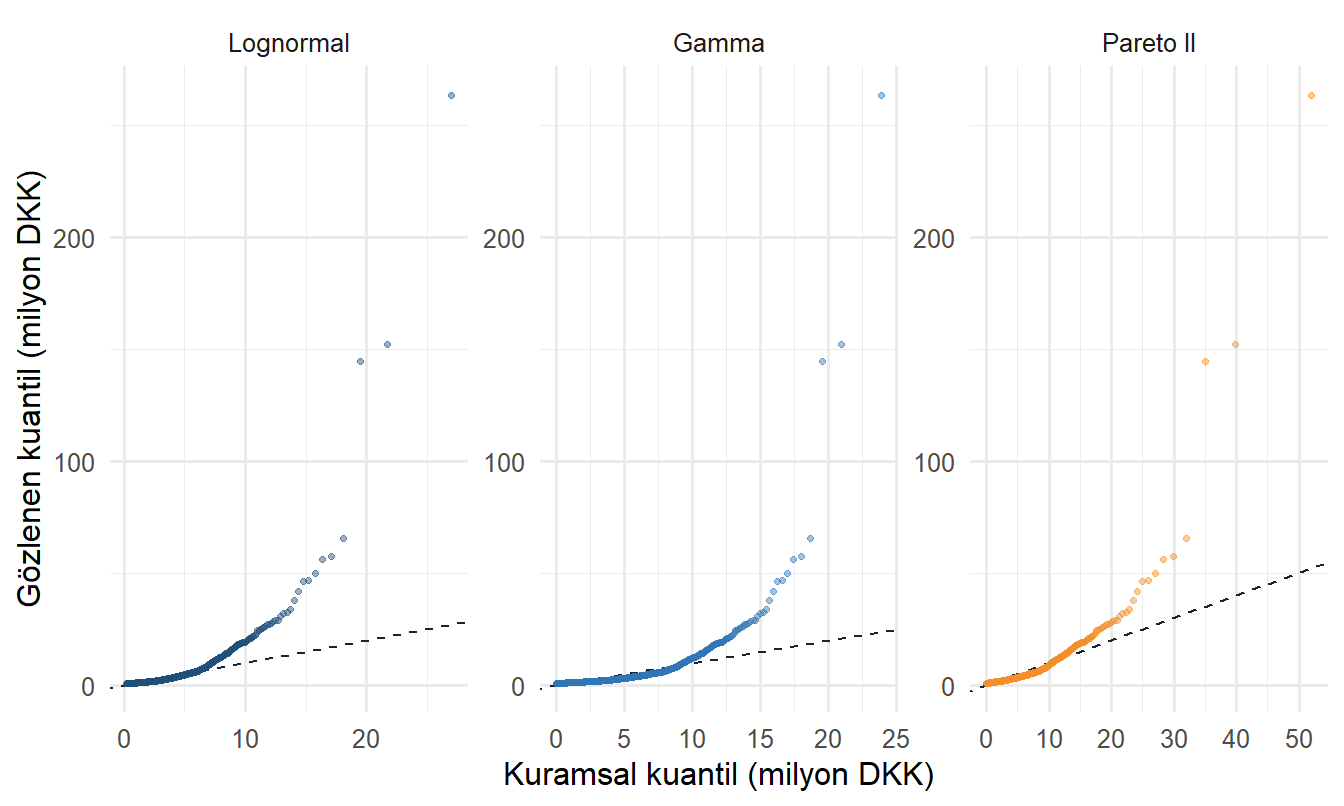
geom_abline(slope = 1, intercept = 0) — veriden gelmeyen, denklemle tanımlanan bir doğru çizer; burada \(y=x\) referansıdır ve Q–Q grafiğinin okunma ölçütüdür: noktalar bu doğru üzerindeyse kuramsal ve gözlenen kuantiller örtüşüyor demektir. Verilmezse: grafik yine çizilir ama okuyucu neye göre “sapma” diyeceğini bilemez.Bu grafik iki aşamada kurulur ve ikinci aşama, ilkinin neden okunamaz olduğunu göstermek için vardır.
Aşama 1 — üç model tek panelde. Noktalar ile referans doğrusu aynı eksene çizilir:
ggplot(qq_veri, aes(x = kuramsal, y = gozlenen)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2,
                       colour = "#1A2238") +
  geom_point(aes(colour = model),
                      alpha = 0.45, size = 0.9, show.legend = FALSE) +
  scale_colour_manual(
    values = c("Lognormal" = "#1F4E79", "Gamma" = "#2E75B6",
               "Pareto II" = "#F28E2B")
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  labs(
    x = "Kuramsal kuantil (milyon DKK)", y = "Gözlenen kuantil (milyon DKK)"
  ) +
  theme_minimal(base_size = 12)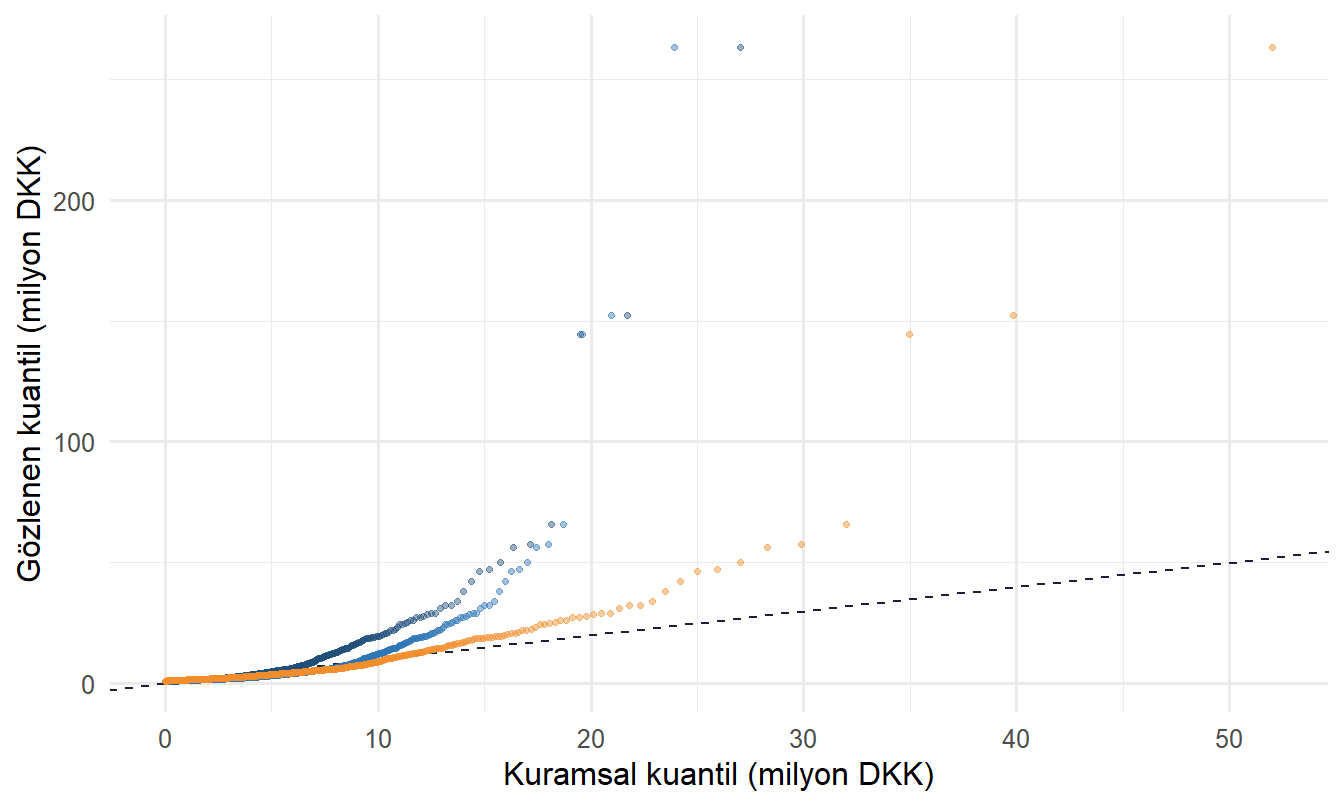
Bu aşamanın argümanları:
alpha = 0.45 — nokta saydamlığı. Üst üste binen noktaların koyulaşması yoğunluğu gösterir. Verilmezse: noktalar birbirini tamamen örter ve bulutun içindeki yoğunluk farkı görünmez.size = 0.9 küçük noktalar (2.000’den fazla nokta var); colour = "#1A2238" ve linetype = 2 kesikli, mürekkep renkli referans doğrusu; show.legend = FALSE göstergesiz noktalar (model adı ikinci aşamada panel başlığı olur); labels = label_number(...) ve base_size = 12 Türkçe sayı biçimi ve yazı boyutu.Aşama 2 — panellere ayırma. Tek eklenen katman facet_wrap()’tir ve grafiği okunur kılan tek şey odur. Bu aşama yukarıdaki asıl bloğun tamamıdır.
ggplot(qq_veri, aes(x = kuramsal, y = gozlenen)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2,
                       colour = "#1A2238") +
  geom_point(aes(colour = model),
                      alpha = 0.45, size = 0.9, show.legend = FALSE) +
  facet_wrap(~ model, scales = "free") +
  scale_colour_manual(
    values = c("Lognormal" = "#1F4E79", "Gamma" = "#2E75B6",
               "Pareto II" = "#F28E2B")
  ) +
  scale_x_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  scale_y_continuous(
    labels = label_number(big.mark = ".", decimal.mark = ",")
  ) +
  labs(
    x = "Kuramsal kuantil (milyon DKK)", y = "Gözlenen kuantil (milyon DKK)"
  ) +
  theme_minimal(base_size = 12)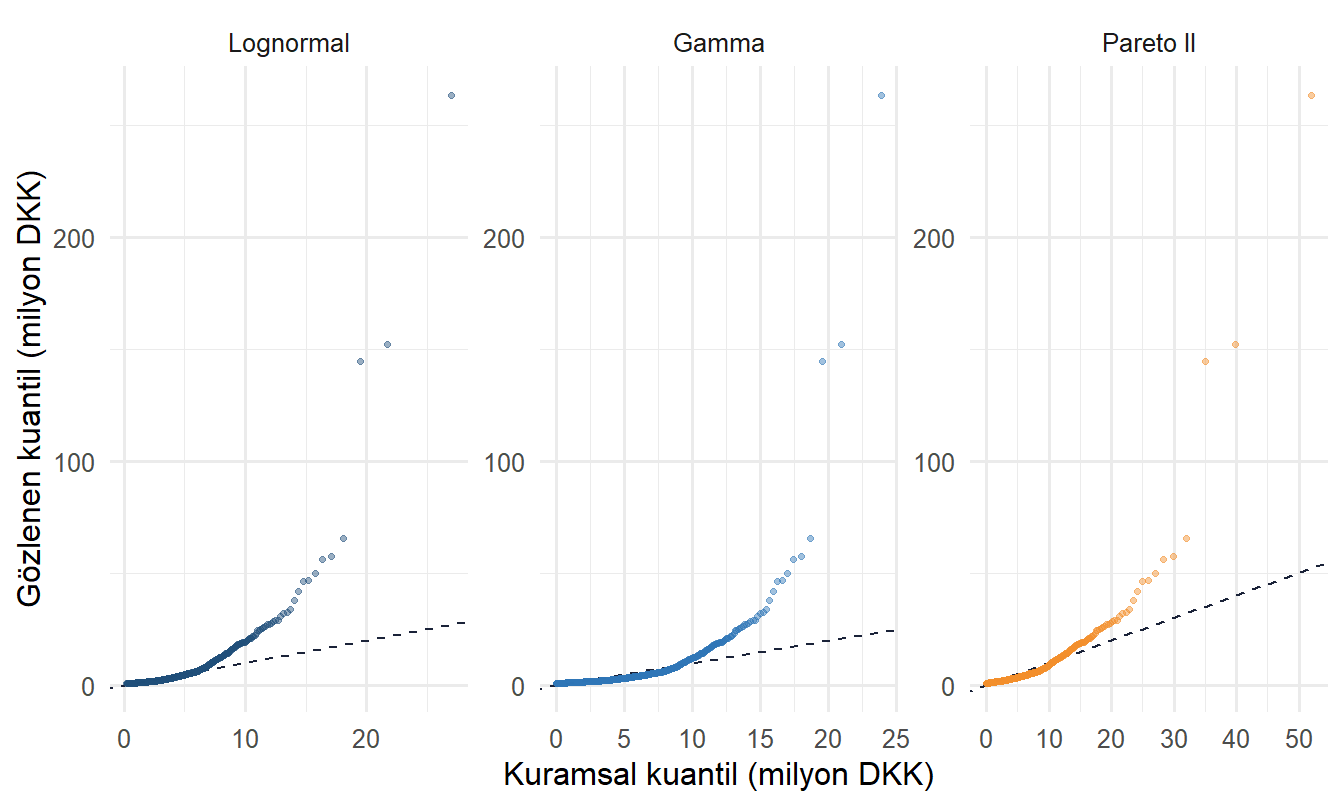
facet_wrap(~ model) — veriyi model sütununun düzeylerine böler ve her düzey için ayrı bir panel çizer.scales = "free" — her panelin kendi eksen aralığını kullanmasına izin verir. Verilmezse: üç panel de ortak ve en geniş aralığa göre ölçeklenir — yani birinci aşamadaki sıkışmanın aynısı, bu kez üç panele bölünmüş olarak. Bedeli de vardır ve söylenmesi gerekir: ayrı ölçeklerde paneller doğrudan karşılaştırılamaz; her panel yalnızca kendi kesikli doğrusuna göre okunur, bir panelin sapması ötekinin sapmasından “daha büyük” diye okunamaz.Üç panelde de noktalar önce doğrunun yakınında ilerler, kuyrukta doğrunun çok üstüne çıkar: son 232 nokta (lognormal), son 117 nokta (Gamma) ve son 96 nokta (Pareto II) doğrunun üstündedir. Geçiş, kuramsal kuantilin 5,35; 9,04 ve 10,87 mDKK olduğu yerdedir. Üç model de büyük hasarları küçük tahmin eder.
En büyük hasar, 263,25 mDKK, lognormalin o noktadaki kuantilinin 9,74, Gamma’nınkinin 11,00, Pareto II’ninkinin 5,06 katıdır.
Sol alt köşede bu ölçekte gözle seçilmeyen bir sapma daha vardır: kuramsal kuantillerin ilk 295’i (lognormal), 434’ü (Gamma) ve 677’si (Pareto II) 1 mDKK’nın altındadır. Bunlar Gövde bölümünde modellerin 1’in altına koyduğu %13,6, %20,0 ve %31,2’lik paydır; veride 1’in altında hasar olmadığı için bu noktaların hepsi doğrunun üstündedir.
Paneller ayrı ölçekli olduğu için kuyruğu ortak bir ölçekte de okuyalım: verinin ve üç modelin %99 ve %99,9 kuantilleri.
kuyruk_kuantilleri <- rbind(
  veri        = quantile(x, c(0.99, 0.999)),
  Lognormal   = qlnorm(c(0.99, 0.999),
                       meanlog = fit_lnorm$estimate[["meanlog"]],
                       sdlog = fit_lnorm$estimate[["sdlog"]]),
  Gamma       = qgamma(c(0.99, 0.999),
                       shape = fit_gamma$estimate[["shape"]],
                       rate = fit_gamma$estimate[["rate"]]),
  `Pareto II` = qpareto(c(0.99, 0.999),
                        shape = fit_pareto$estimate[["shape"]],
                        scale = fit_pareto$estimate[["scale"]])
)

round(kuyruk_kuantilleri, 2)
#> 99% 99.9%
#> veri 26.04 131.55
#> Lognormal 11.63 20.11
#> Gamma 13.71 19.98
#> Pareto II 18.80 36.28%99 kuantilinde veri 26,04 mDKK; Pareto II 18,80, Gamma 13,71, lognormal 11,63 mDKK öngörüyor.
%99,9’da veri 131,55’e çıkarken Pareto II 36,28, lognormal 20,11, Gamma 19,98 mDKK veriyor.
Üç model de kuyruğu küçük tahmin eder. Veriye en yakın olan Pareto II bile %99’da verinin 0,72, %99,9’da 0,28 katındadır; AIC’de birinci olan lognormal %99’da verinin yarısına bile ulaşmaz (0,45) ve bu kuantilde veriden en uzak modeldir.
Verinin satırı Gövde: histogram ve uydurulan yoğunluklar bölümündeki ara değer kuralıyla, model satırları kuantil işlevleriyle bulunur. Pareto II’de kuantilin kapalı bir biçimi vardır: aşma olasılığı \(S(q)=\left(\theta/(\theta+q)\right)^{\alpha}\)’yı \(1-p\)’ye eşitleyip \(q\) için çözmek şunu verir:
\[ q_p=\theta\left[(1-p)^{-1/\alpha}-1\right]. \]
Kuyruğun ağırlığı, aşma olasılığı küçüldükçe kuantilin ne kadar hızlı büyüdüğüdür. %99’dan %99,9’a geçerken aşma olasılığı on kat küçülür; verinin kuantili 5,05 katına çıkar, Pareto II’ninki 1,93, lognormalinki 1,73, Gamma’nınki 1,46 katına.
Pareto II’de bu hızı formüldeki \((1-p)^{-1/\alpha}\) terimi verir ve \(\alpha\) küçüldükçe artar. Uydurulan \(\widehat{\alpha}=5{,}37\) büyük olduğu için terim yavaş büyür: Pareto II ağır kuyruklu olabilen bir aile olduğu hâlde bu uyumun kuyruğu veriye göre incedir.
Karşılaştırmanın hedefi de kesin bir sayı değildir. Verinin %99,9 kuantili 2.164’üncü ve 2.165’inci gözlemin, 65,71 ve 144,66 mDKK’nın, arasındaki 79 mDKK’lık boşluğa düşer.
En büyük hasar, 263,25 mDKK, dosyada olmasaydı kuantil bir gözlem aşağı kayar, 57,41 ile 65,71 mDKK’nın arasına düşer ve 64,34 mDKK olurdu: tek bir hasar çıkınca yarısından aşağı iner. Aynı hasar çıkınca %99 kuantili ise 26,04’ten yalnız 25,52’ye iner, çünkü orada komşu gözlemlerin farkı 1 mDKK’nın altındadır.
Verinin kendi yüksek kuantili tek bir sıçramaya dayandığı için oynaktır. Bir modelin %99,9’da veriye yakın ya da uzak düşmesi bu yüzden %99’dakinden çok daha az şey söyler.
AIC sıralaması kuyruğun sırası değildir: AIC’de birinci olan lognormal %99’da veriden en uzak, AIC’de ikinci olan Pareto II en yakın modeldir. Sıralamayı hangi hasarların belirlediğini Alıştırma 6, bu durumda ne yapılacağını Alıştırma 12 soruyor.
Laboratuvar gövdenin yöntemlerini gövdenin bakmadığı yerlere taşır: sıklıkta birinci yıldan öbür iki yıla, büyüklükte ortalamadan en büyük hasarların payına. İki görevin her biri gövdenin yanıtlamadığı bir soruyu sorar:
| Görev | Soru | Veri |
|---|---|---|
| A | Ortalama hasarın ne kadarı birkaç büyük hasara dayanıyor? | danishuni.csv, %99 kuantilinin üstü |
| B | Sıklıktaki model sıralaması ikinci ve üçüncü yılda da geçerli mi; üç yılı birleştirmek standart hatayı nasıl değiştirir? | claims_long.csv, üç yıl |
Görevler gövdenin x, ust_sinir, sayim_verisi ve zip_log_olabilirlik() nesnelerini hazır kullanır; indirilebilir betik bunları # Gorev A satırından önce kendisi kurar, sonrası bu sayfadaki bloklarla aynıdır.
Gövde ust_sinir’ı, yani verinin %99 kuantilini (26,04 mDKK), histogramın yatay eksenini sınırlamak için kullandı. Aynı sınırı şimdi ters yönde kullanıyoruz: grafiğin dışında kalan bölgede kaç hasar ve ne kadar para var?
kuyruk <- x[x > ust_sinir]

round(sort(kuyruk), 2)
#> [1] 26.21 27.26 27.34 27.83 28.63 29.03 29.04 31.06 32.39 32.47
#> [11] 34.14 38.15 42.09 46.50 47.02 50.07 56.23 57.41 65.71 144.66
#> [21] 152.41 263.25x[x > ust_sinir] — köşeli parantezin içindeki mantıksal vektör yalnızca üst sınırı aşan gözlemleri seçer. sort() onları küçükten büyüğe dizer, böylece listenin sağ ucunda dosyanın en büyük üç hasarı görünür.Listede 22 hasar var: en küçüğü 26,21; en büyük üçü 144,66; 152,41 ve 263,25 mDKK.
Bu hasarların sayıca ve tutarca payını yan yana koyalım:
kuyruk_payi <- c(
  gozlem_sayisi     = length(kuyruk),
  gozlem_payi_yuzde = 100 * length(kuyruk) / length(x),
  tutar_payi_yuzde  = 100 * sum(kuyruk) / sum(x)
)

round(kuyruk_payi, 2)
#> gozlem_sayisi gozlem_payi_yuzde tutar_payi_yuzde
#> 22.00 1.02 17.57Gözlemlerin %1,02’si, toplam tutarın %17,57’sini taşıyor.
Bu tek başına bir hata belirtisi değildir: ağır kuyruklu veride toplamın önemli bir bölümünü birkaç gözlemin taşıması beklenir. Ortalamanın ne kadarının bu 22 kayda dayandığını, kayıtları çıkarıp ortalama ile medyanın tepkisine bakarak ölçelim:
kirpma_etkisi <- c(
  ortalama_tumu   = mean(x),
  ortalama_kirpik = mean(x[x <= ust_sinir]),
  medyan_tumu     = median(x),
  medyan_kirpik   = median(x[x <= ust_sinir])
)

round(kirpma_etkisi, 4)
#> ortalama_tumu ortalama_kirpik medyan_tumu medyan_kirpik
#> 3.3851 2.8189 1.7782 1.7657Ortalama 3,3851’den 2,8189’a, %16,7 düşüyor; medyan 1,7782’den 1,7657’ye, yalnız binde yedi iniyor.
Fark iki ölçünün tanımından gelir: ortalama her gözlemi tutarıyla ağırlıklandırır, medyan yalnızca sırasıyla.
Ortalamaya dayanan bir primin altıda biri (%16,7) bu 22 kayıttan gelir. Kayıtlar on bir yıla (1980–1990) dağılmıştır, yılda ortalama iki tane; başka bir on bir yılda bu büyüklükte hasarların sayısı da tutarı da farklı olabilir ve prim onlarla birlikte oynar.
Gövde sıklık modellerini yalnızca birinci yılda karşılaştırdı. Aynı 40.000 poliçenin ikinci ve üçüncü yılı da sayim_verisi’nde duruyor. Üç soru soruyoruz:
Önce üç yılın özetini yan yana koyalım:
yil_ozeti <- t(sapply(1:3, function(yil) {
  y <- sayim_verisi$numclaims[sayim_verisi$period == yil]
  c(yil = yil, ortalama = mean(y), varyans = var(y), oran = var(y) / mean(y),
    sifir_payi = mean(y == 0))
}))
round(yil_ozeti, 4)
#> yil ortalama varyans oran sifir_payi
#> [1,] 1 0.2152 0.6689 3.1075 0.8691
#> [2,] 2 0.2394 0.8132 3.3972 0.8586
#> [3,] 3 0.2721 1.0718 3.9390 0.8440Birinci satır gövdenin sayim_ozeti’dir. Varyans/ortalama oranı her yıl 1’in çok üstünde ve büyüyor (3,1075; 3,3972; 3,9390): gövdenin aşırı yayılım bulgusu birinci yıla özgü değildir.
Ortalama da artıyor (0,2152; 0,2394; 0,2721), hasarsız poliçelerin payı azalıyor (0,8691; 0,8586; 0,8440).
Dört modeli her yıl için yeniden uyduralım; sıfır şişkin Poisson için gövdenin zip_log_olabilirlik() işlevini olduğu gibi kullanıyoruz:
yil_modelleri <- t(sapply(1:3, function(yil) {
  y <- sayim_verisi$numclaims[sayim_verisi$period == yil]
  negbin <- MASS::glm.nb(y ~ 1)
  zip <- optim(c(0, 0), zip_log_olabilirlik, y = y, method = "BFGS",
               control = list(fnscale = -1))
  c(yil = yil, theta = negbin$theta, theta_se = negbin$SE.theta,
    aic_poisson = AIC(glm(y ~ 1, family = poisson())),
    aic_negbin = AIC(negbin), aic_zip = 2 * 2 - 2 * zip$value,
    yayilim = summary(glm(y ~ 1, family = quasipoisson()))$dispersion)
}))
round(yil_modelleri, 4)
#> yil theta theta_se aic_poisson aic_negbin aic_zip yayilim
#> [1,] 1 0.1688 0.0044 51592.54 42151.56 44611.96 3.1075
#> [2,] 2 0.1741 0.0043 55963.87 45065.68 48050.86 3.3972
#> [3,] 3 0.1841 0.0042 61842.27 48866.82 52910.71 3.9390Sütunlar gövdeden tanıdığımız büyüklüklerdir. optim() bir model nesnesi döndürmediği için AIC() sıfır şişkin Poisson’u tanımaz; onun AIC’sini gövdedeki gibi \(2k-2\ell\) ile, \(k=2\) alarak yazıyoruz.
Birinci yılın satırı gövdenin Modelleri karşılaştırmak tablosudur ve gövdenin yargısı üç yılda da aynı: AIC her yıl negatif binomda en küçük, sonra sıfır şişkin Poisson, en büyük Poisson’da. Negatif binomun sıfır şişkin Poisson’a üstünlüğü birinci yılda yaklaşık 2.460, üçüncü yılda 4.044 AIC birimidir: gövdenin seçimi birinci yılın bir rastlantısı değildir.
\(\widehat{\theta}\) yıldan yıla az değişiyor (0,1688; 0,1741; 0,1841). \(\lambda\)’nın standart sapması ortalamasının \(1/\sqrt{\theta}\) katıdır (Negatif binom); bu her yıl 2,3–2,4 eder. Ortalama hasar sayısı artarken poliçelerin risk düzeyleri arasındaki göreli fark benzer kalıyor.
Yarı-Poisson’un \(\widehat{\phi}\)’si (yayilim) her yıl o yılın varyans/ortalama oranıdır, çünkü sabit terimli modelde \(\widehat{\phi}=s^{2}/\bar{n}\)’dir (Yarı-Poisson’u uydurmak).
İkinci soru için aynı poliçenin yıllarını yan yana dizmemiz gerekiyor. Her yılın satırları poliçe kimliğine göre aynı sıradaysa, üç yılın vektörü bir matrisin üç sütunu olabilir; önce bunu denetliyoruz:
stopifnot(
  identical(sayim_verisi$policy_id[sayim_verisi$period == 1],
            sayim_verisi$policy_id[sayim_verisi$period == 2]),
  identical(sayim_verisi$policy_id[sayim_verisi$period == 1],
            sayim_verisi$policy_id[sayim_verisi$period == 3])
)
yil_matrisi <- sapply(1:3, function(yil) {
  sayim_verisi$numclaims[sayim_verisi$period == yil]
})
colnames(yil_matrisi) <- paste0("yil_", 1:3)
head(yil_matrisi)
#> yil_1 yil_2 yil_3
#> [1,] 0 0 0
#> [2,] 0 0 0
#> [3,] 0 2 1
#> [4,] 0 2 0
#> [5,] 0 0 0
#> [6,] 0 0 0stopifnot(identical(...)) — üç yılın kimlik sırası aynı değilse hesabı durdurur. Bu dosyada sıra aynıdır; denetim, sıranın farklı olduğu bir dosyada matrisin farklı poliçeleri yan yana koyacağı için oradadır.Her satır bir poliçe, her sütun bir yıldır.
Üçüncü yılla birinci yıl arasındaki farkı poliçe poliçe alalım:
yil_farki <- yil_matrisi[, "yil_3"] - yil_matrisi[, "yil_1"]
summary(yil_farki)
#> Min. 1st Qu. Median Mean 3rd Qu. Max.
#> -8.00000 0.00000 0.00000 0.05685 0.00000 18.00000Ortalama fark 0,05685: bir poliçe üçüncü yıl birinci yıla göre ortalama 0,05685 hasar daha fazla bildiriyor.
Bu fark gürültü mü? Standart hatayı iki yolla hesaplayalım: yılları iki bağımsız örneklem sayarak ve aynı poliçeleri eşleştirerek (\(m=40.000\) poliçe; \(s_1^{2}\) ve \(s_3^{2}\) iki yılın, \(s_{\text{fark}}^{2}\) poliçe farklarının varyansı):
\[ \begin{aligned} \mathrm{SE}_{\text{bağımsız}}&=\sqrt{\frac{s_1^{2}}{m}+\frac{s_3^{2}}{m}},\\ \mathrm{SE}_{\text{eşleştirilmiş}}&=\frac{s_{\text{fark}}}{\sqrt{m}}. \end{aligned} \]
Birincisinde bağımsız iki büyüklüğün farkının varyansı varyanslarının toplamıdır; ikincisi farkı tek bir değişken sayar ve ona ortalamanın standart hatasını, \(s/\sqrt{m}\)’yi, uygular.
fark_ozeti <- c(
  ortalama_fark = mean(yil_farki),
  se_bagimsiz = sqrt(var(yil_matrisi[, "yil_1"]) / nrow(yil_matrisi) +
                       var(yil_matrisi[, "yil_3"]) / nrow(yil_matrisi)),
  se_eslestirilmis = sd(yil_farki) / sqrt(length(yil_farki))
)
round(fark_ozeti, 5)
#> ortalama_fark se_bagimsiz se_eslestirilmis
#> 0.05685 0.00660 0.00364Bağımsız sayarsak standart hata 0,00660, eşleştirince 0,00364 çıkıyor.
Fark eşleştirilmiş standart hatanın 15,6 katıdır. Rastlantısal bir farkta bu oran yaklaşık standart normal dağılır ve mutlak değeri 1,96’yı yalnız %5 olasılıkla aşar; 15,6 gürültüyle açıklanamaz. Artış bu poliçelerde gerçektir: birinci yılın sıklığıyla kurulmuş bir tarife üçüncü yıl için düşük kalırdı.
Eşleştirme standart hatayı neredeyse yarıya indiriyor, çünkü aynı poliçenin iki yılı birlikte hareket eder: poliçenin kendi risk düzeyi iki yılın sayısında da bulunur ve fark alınınca düşer.
Üçüncü sorunun, yani üç yılı birleştirmenin bedelinin kaynağı da bu birlikte harekettir. Onu korelasyon (correlation) ölçer: iki değişkenin kovaryansını (covariance), yani ortalamalarından sapmalarının çarpımlarının ortalamasını, iki standart sapmanın çarpımına böler, \(r=\operatorname{Cov}/(s_1s_3)\). Sonuç birimden bağımsızdır ve −1 ile 1 arasındadır; 0 doğrusal bir ilişki olmadığını gösterir. Üç yılın hasar sayıları arasındaki korelasyonlar:
round(cor(yil_matrisi), 3)#> yil_1 yil_2 yil_3
#> yil_1 1.000 0.709 0.714
#> yil_2 0.709 1.000 0.732
#> yil_3 0.714 0.732 1.000cor(yil_matrisi) — her sütun çiftinin korelasyonunu 3×3 bir matriste verir; köşegen 1’dir ve matris simetriktir.Köşegenin dışında üç korelasyon var: birinci ile ikinci yıl 0,709, birinci ile üçüncü 0,714, ikinci ile üçüncü 0,732. Aynı poliçenin yılları birbirinden bağımsız değildir.
Korelasyon, eşleştirmenin standart hatayı ne kadar küçülttüğünü de söyler. Bir farkın varyansı iki varyansın toplamından iki kat kovaryansın çıkarılmasıdır; korelasyonun tanımından \(\operatorname{Cov}=r\,s_1s_3\) olduğu için:
\[ s_{\text{fark}}^{2}=s_1^{2}+s_3^{2}-2\,r\,s_1s_3 . \]
İki yılı bağımsız saymak \(r=0\) almak, yani son terimi atmaktır. Bu veride \(r=0{,}714\) olduğu için atılan terim büyüktür: farkların varyansı iki yılın varyansları toplamının üçte birinden azına iner ve eşleştirilmiş standart hata bu yüzden neredeyse yarıdır.
Bağımlılığı doğrudan görmek için poliçeleri birinci yılda hasar bildirip bildirmediklerine göre ayıralım ve üçüncü yıllarına bakalım:
kalicilik <- tapply(
  yil_matrisi[, "yil_3"],
  ifelse(yil_matrisi[, "yil_1"] > 0, "ilk_yil_hasarli", "ilk_yil_hasarsiz"),
  mean
)
round(kalicilik, 3)
#> ilk_yil_hasarli ilk_yil_hasarsiz
#> 1.164 0.138Birinci yılı hasarlı geçen 5.236 poliçe üçüncü yıl ortalama 1,164 hasar bildiriyor, hasarsız geçen 34.764 poliçe 0,138: 8,4 kat fark.
Bütün poliçelerin \(\lambda\)’sı aynı ve yıllar bağımsız olsaydı birinci yıl üçüncü yıl hakkında bir şey söylemezdi: iki grubun üçüncü yıl ortalaması da portföyünkinin (0,2721) çevresinde olurdu. Oysa hasarlı grup bunun 4,3 katını, hasarsız grup yarısını bildiriyor.
Gövdenin heterojenlik yorumu burada doğrudan görünür: poliçelerin \(\lambda\)’ları farklıdır ve \(\lambda\)’sı yüksek bir poliçe iki yılda da çok hasar bildirir. Ama aynı tablo, bir yıl hasar yapmanın sonraki yılların riskini artırdığı bir portföyde de çıkardı; tablo iki açıklamayı ayıramaz.
Son olarak üç yılın ortalama hasar sayısının standart hatasını iki biçimde hesaplayalım: 120.000 satırı bağımsız sayarak ve birim olarak poliçeyi, yani her poliçenin üç yıllık ortalamasını (\(\bar{Y}\)) tek gözlem sayarak:
havuz_se <- c(
  satir_bazinda = sd(sayim_verisi$numclaims) / sqrt(nrow(sayim_verisi)),
  police_bazinda = sd(rowMeans(yil_matrisi)) / sqrt(nrow(yil_matrisi))
)
round(havuz_se, 5)
#> satir_bazinda police_bazinda
#> 0.00266 0.00414rowMeans(yil_matrisi) — her satırın, yani her poliçenin üç yıllık ortalamasını verir. Poliçe bazında standart hata bu 40.000 ortalamadan hesaplanır.Satırları bağımsız sayan standart hata 0,00266, poliçe bazındaki 0,00414: satırları bağımsız saymak standart hatayı yaklaşık %36 küçük gösteriyor. Aynı poliçenin üç yılı üç bağımsız gözlem değildir; birim poliçedir.
Oranın büyüklüğünü de korelasyon verir. Yılların varyansları eşit (\(s^{2}\)), her yıl çiftinin korelasyonu \(\bar{r}\) olsun. Üç yılın toplamının varyansı üç varyans ile her biri iki kez sayılan üç kovaryansın (\(\bar{r}s^{2}\)) toplamıdır; \(\bar{Y}\) toplamın üçte biri olduğu için varyansı bunun dokuzda biridir. Poliçe bazındaki standart hata \(m\) poliçe ortalamasından, satır bazındaki \(3m\) satırdan hesaplanır; oranlarında \(s^{2}\) ve \(m\) sadeleşir:
\[ \begin{aligned} \operatorname{Var}(\bar{Y})&=\frac{s^{2}}{3}\,(1+2\bar{r}),\\ \frac{\mathrm{SE}_{\text{poliçe}}}{\mathrm{SE}_{\text{satır}}}&=\sqrt{1+2\bar{r}}. \end{aligned} \]
Satırları bağımsız saymak \(\bar{r}=0\) almak, yani bir poliçenin üç yılını üç ayrı poliçe kadar bilgi saymaktır. Bu veride üç korelasyonun ortalaması \(\bar{r}=0{,}718\)’dir; formül oranı 1,56 öngörür, iki standart hatanın oranı 1,55’tir. Yılların varyansları tam eşit olmadığı için (0,6689; 0,8132; 1,0718) formül yaklaşıktır.
Poliçeler arasındaki kalıcı risk farkını bir sonraki yılın fiyatına taşıyan kredibilite (credibility) ve deneyim fiyatlaması (experience rating) bu bağımlılığın üzerine kurulur: bir poliçenin geçmiş hasarları gelecekteki riski hakkında bilgi taşır.
Aşağıdaki alıştırmalar haftanın sıklık–büyüklük ayrımını, dağılım uydurmayı ve model değerlendirmesini pekiştirmek içindir. Önce kendi çözümünüzü oluşturun, ardından her kutudaki Çözümü göster düğmesiyle karşılaştırın. Bir alıştırma gövdedeki ya da laboratuvardaki bir tabloya veya teste dayanıyorsa, o tablo ve sonuçlar alıştırmanın içinde yeniden verilmiştir. Bazı çözümlerdeki bloklar gövdenin nesnelerini (x ve uydurulan modeller, fit_*) kullanır. Yıldızlı (★) alıştırma daha fazla yorum gerektirir.
Alıştırma 1 (Sıklık verisi ile büyüklük verisini ayırma). Her biri bir poliçe-yıl maruziyetle gözlenen beş poliçe-dönemi aşağıdadır:
| Poliçe | Hasar sayısı | Gerçekleşen hasar tutarları |
|---|---|---|
| P001 | 0 | — |
| P002 | 1 | 12.000 TL |
| P003 | 0 | — |
| P004 | 2 | 5.000 TL ve 41.000 TL |
| P005 | 1 | 8.000 TL |
(a) Eşit maruziyette Poisson’un maksimum olabilirlik tahmini toplam hasar sayısının birim sayısına, burada toplam maruziyete (5 poliçe-yıl) bölümüdür (Küçük çalışılmış örnek: Poisson): \(\widehat{\lambda}=(0+1+0+2+1)/5\) \(=4/5=0{,}80\).
Birimi hasar / poliçe-yıldır: bu bir olasılık değil, maruziyet başına olay hızıdır. En az bir hasarı olan poliçelerin oranı \(3/5=0{,}60\)’tır; hız 0,80 ondan büyüktür, çünkü P004’ün iki hasarını da sayar. Oran 1’i aşamaz, hız aşabilir.
(b) Büyüklük modeli yalnızca gerçekleşmiş hasarları kullanır; P004’ün iki hasarı ayrı sayılır ve dört tutarın toplamı 66.000 TL’dir:
\[ \bar{x}=\frac{66.000}{4}=16.500\ \text{TL}. \]
Sıralı tutarlar 5.000; 8.000; 12.000 ve 41.000 TL’dir; gözlem sayısı çift olduğu için medyan ortadaki ikisinin ortalamasıdır, \((8.000+12.000)/2=10.000\) TL.
Ortalama medyanın belirgin biçimde üzerindedir, çünkü 41.000 TL’lik tek hasar toplamın %62’sini taşır (\(41.000/66.000=0{,}62\)); bu ayrışma sağa çarpıklığın ilk işaretidir.
(c) \(66.000/5=13.200\) TL, poliçe-dönemi başına toplam hasar tutarının, yani \(S\)’nin ortalamasıdır. Aynı sayı (a) ile (b)’nin çarpımıdır, çünkü 66.000 TL hem dört hasarın hem beş poliçenin toplamıdır. Kesrin payı ve paydası 4 ile çarpılınca iki oran ayrılır: \(4/5\) hasar sayısının poliçe sayısına, \(66.000/4\) tutar toplamının hasar sayısına bölümüdür:
\[ \begin{aligned} \frac{66.000}{5}&=\frac{4}{5}\cdot\frac{66.000}{4}\\ &=0{,}80\times16.500\\ &=13.200. \end{aligned} \]
13.200 TL “bir poliçe bir dönemde ortalama ne kadar hasar tutarı üretir?” sorusunu yanıtlar; “bir hasar olduğunda ortalama ne kadardır?” sorusunun yanıtı (b)’deki 16.500 TL’dir. Fark hasarsız iki poliçenin sıfırlarıdır: onlar \(N\) modeline aittir, \(X\) dağılımına değil; aynı sütuna iki modeli birden uygulamak bu haftanın uyardığı hatadır.
Alıştırma 2 (Poisson’un ortalama–varyans denetimi). Eşit maruziyetli sekiz birimde bir yıl boyunca gözlenen hasar sayıları şöyledir:
\[ 0,\ 0,\ 1,\ 0,\ 2,\ 0,\ 1,\ 4. \]
glm(y ~ 1, family = poisson())) sabit terim \(\widehat{\lambda}\) ile nasıl ilişkili olur?var()) hesaplayın ve Poisson modelinin gerektirdiği değerle karşılaştırın.(a) Eşit maruziyette maksimum olabilirlik tahmini örnek ortalamasıdır: \(\widehat{\lambda}=8/8=1\).
Poisson GLM’de bağlantı logaritmadır, \(\log\lambda=\beta_0\): glm() aynı olabilirliği \(\lambda\) yerine \(\beta_0\) üzerinde en büyük yapar (Küçük çalışılmış örnek: Poisson). Yalnız sabit terimli modelde bu yüzden \(\widehat{\beta}_0=\log\widehat{\lambda}=\log 1=0\) bulunur; sabit terimin üssü, \(e^{0}=1\), elle hesaplanan \(\widehat{\lambda}\)’dır.
(b) Örnek varyansı, ortalamadan sapmaların karelerinin toplamını \(n-1\)’e böler. Ortalama 1 olduğu için her birimin sapması \(n_j-1\)’dir:
| birim | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | toplam |
|---|---|---|---|---|---|---|---|---|---|
| \(n_j\) | 0 | 0 | 1 | 0 | 2 | 0 | 1 | 4 | 8 |
| \(n_j-1\) | −1 | −1 | 0 | −1 | 1 | −1 | 0 | 3 | 0 |
| \((n_j-1)^{2}\) | 1 | 1 | 0 | 1 | 1 | 1 | 0 | 9 | 14 |
\[ s^{2}=\frac{14}{8-1}=2 . \]
Poisson’da varyans ortalamaya eşittir; uydurulan model \(\widehat{\lambda}=1\) büyüklüğünde bir varyans öngörür, gözlenen ise bunun iki katıdır: \(s^{2}/\widehat{\lambda}=2\).
(c) Hayır. Yalnızca sekiz gözlem vardır ve fazlalığın tamamı tek bir gözlemden, 4’ten gelir. O birim çıkarılınca kalan yedi gözlemde dört 0, iki 1 ve bir 2 vardır; toplamları 4, ortalamaları \(\widehat{\lambda}=4/7=0{,}571\)’dir.
Her gözlemin ortalamadan sapması paydası 7 olan bir kesirdir: 0 için \(0-4/7=-4/7\), 1 için \(1-4/7=3/7\), 2 için \(2-4/7=10/7\). Sapmaların karelerini her değerin kaç kez geçtiğiyle çarpıp toplayalım:
\[ \begin{aligned} &\sum_{j}\big(n_j-\tfrac{4}{7}\big)^{2}\\ &=4\cdot\frac{16}{49}+2\cdot\frac{9}{49}+\frac{100}{49}\\ &=\frac{64+18+100}{49}=\frac{182}{49}\\ &=3{,}714. \end{aligned} \]
Örnek varyansı bu toplamı \(7-1=6\)’ya böler; oran da varyansı \(\widehat{\lambda}\)’ya böler:
\[ \begin{aligned} s^{2}&=\frac{3{,}714}{6}=0{,}619,\\ \frac{s^{2}}{\widehat{\lambda}}&=\frac{0{,}619}{0{,}571}=1{,}08. \end{aligned} \]
Oran 2’den 1,08’e iner ve Poisson’un öngördüğü 1’e çok yakın kalır. Tek bir gözlemin döndürebildiği bir bulgu aşırı yayılımın kanıtı değil, incelemenin gerekçesidir; karar için daha çok gözlem ve bir alternatifle aynı veride karşılaştırma gerekir. Sıklık bölümü bunu claims_long.csv’nin 40.000 poliçelik birinci yılında yapmıştı:
| Ölçü | Değer |
|---|---|
| ortalama hasar sayısı | 0,2152 |
| varyans | 0,6689 |
| varyans / ortalama | 3,1075 |
| Poisson’un AIC’si | 51.592,54 |
| negatif binomun AIC’si | 42.151,56 |
Orada sonuç tek bir gözleme dayanmaz: en büyük sayıyı (27) çıkarmak oranı 3,11’den yalnızca 3,03’e indirir.
En büyük 100 sayı, yani poliçelerin %0,25’i çıkarılsa bile oran 1,88’dir ve Poisson’un öngördüğü 1’in belirgin biçimde üstünde kalır.
Negatif binom da Poisson’dan \(51.592{,}54-42.151{,}56\) \(=9.440{,}98\) AIC birimi iyidir; bu, Adayları sıralamak bölümündeki 10 sınırının çok üstündedir.
Alıştırma 3 (Lognormal MLE’yi elle hesaplama). Beş pozitif yangın hasarı ve logaritmaları aşağıdadır:
| \(x\) (mDKK) | \(\log x\) |
|---|---|
| 1,20 | 0,1823 |
| 2,00 | 0,6931 |
| 3,50 | 1,2528 |
| 6,00 | 1,7918 |
| 20,00 | 2,9957 |
meanlog) tahminini hesaplayın.sdlog) tahminini maksimum olabilirlik formülüyle hesaplayın; aynı logaritmalarda sd() hangi değeri verirdi ve iki sayının oranı nedir?(a) Lognormal tahminleri: kapalı biçim, payda ve model ortalaması bölümünde bulduğumuz gibi \(\widehat{\mu}\) logaritmaların ortalamasıdır. Logaritmaların toplamı 6,9157’dir:
\[ \widehat{\mu}=\frac{6{,}9157}{5}=1{,}3831 . \]
(b) Maksimum olabilirlikte \(\widehat{\sigma}^{2}\) sapma karelerinin ortalamasıdır, yani payda \(n\)’dir. Her logaritmadan \(\widehat{\mu}=1{,}3831\)’i çıkarıp kareleri alalım:
| \(\log x\) | \(\log x-\widehat{\mu}\) | \((\log x-\widehat{\mu})^{2}\) |
|---|---|---|
| 0,1823 | −1,2008 | 1,4419 |
| 0,6931 | −0,6900 | 0,4761 |
| 1,2528 | −0,1303 | 0,0170 |
| 1,7918 | 0,4087 | 0,1670 |
| 2,9957 | 1,6126 | 2,6005 |
| toplam | 4,7025 |
\[ \begin{aligned} \widehat{\sigma}&=\sqrt{4{,}7025/5}\\ &=\sqrt{0{,}9405}=0{,}9698 . \end{aligned} \]
R’nin sd() işlevi \(n-1\)’e böler: \(s=\sqrt{4{,}7025/4}=1{,}0843\). İki sayı aynı kareler toplamından gelir ve oranlarında o toplam sadeleşir:
\[ \begin{aligned} \frac{\widehat{\sigma}}{s} &=\frac{\sqrt{4{,}7025/5}}{\sqrt{4{,}7025/4}}\\ &=\sqrt{\frac{4{,}7025}{5}\cdot\frac{4}{4{,}7025}}\\ &=\sqrt{\frac{4}{5}}=0{,}8944. \end{aligned} \]
Kalan \(\sqrt{4/5}\), \(n=5\) için \(\sqrt{(n-1)/n}\)’dir: oran yalnız \(n\)’ye bağlıdır. Beş gözlemde MLE \(1-0{,}8944=0{,}106\), yani %10,6 küçüktür ve \(n\) büyüdükçe oran 1’e yaklaşır.
Notun 2.167 hasarında iki sayı ancak dördüncü ondalıkta ayrılır: MLE sdlog 0,7166, sd(log(x)) 0,7167. Gövdedeki denetimin uyumlu bayrağı bu yüzden FALSE olmuştu: sd() ile yazılmış bir denetim, MLE kodu doğru olduğu hâlde başarısız olurdu.
(c) Hayır. \(\exp(\widehat{\mu})\), logaritmaların ortalamasının üssüdür. Logaritmaların toplamı çarpımın logaritması olduğu için bu sayı, beş tutarın geometrik ortalaması (geometric mean), yani çarpımlarının beşinci köküdür:
\[ \begin{aligned} e^{\widehat{\mu}}&=\exp\Big(\frac{1}{5}\sum_{i=1}^{5}\log x_i\Big)\\ &=\exp\Big(\frac{1}{5}\log\prod_{i=1}^{5}x_i\Big)\\ &=\Big(\prod_{i=1}^{5}x_i\Big)^{1/5}\\ &=(1{,}2\cdot2\cdot3{,}5\cdot6\cdot20)^{1/5}\\ &=1.008^{1/5}=3{,}99\ \text{mDKK}. \end{aligned} \]
Eşitlikler sırasıyla:
Bu sayı uydurulan lognormalin medyanıdır, çünkü lognormalin medyanı \(e^{\mu}\)’dür (Lognormal bölümü).
Para birimindeki ortalama başka iki sayıdır. Beş tutarın aritmetik ortalaması \((1{,}2+2+3{,}5+6+20)/5\) \(=32{,}70/5=6{,}54\) mDKK’dır.
Lognormalin ima ettiği ortalama \(E[X]=\exp(\mu+\sigma^{2}/2)\) formülünden gelir (Lognormal bölümü). (a)’daki \(\widehat{\mu}=1{,}3831\) ve (b)’deki \(\widehat{\sigma}^{2}=0{,}9405\) yerine konur:
\[ \begin{aligned} E[X]&=\exp\Big(1{,}3831+\frac{0{,}9405}{2}\Big)\\ &=\exp(1{,}3831+0{,}47025)\\ &=\exp(1{,}85335)\\ &=6{,}38\ \text{mDKK}. \end{aligned} \]
Üç sayı üç ayrı sorunun yanıtıdır; meanlog bunların hiçbiri değildir, logaritmik ölçekte bir konumdur ve para birimiyle okunamaz.
Alıştırma 4 (Pareto II kuyruk olasılığı). Gövdede Danish verisine fitdist() ile eşiği yok sayarak uydurulan Pareto II modelinin iki ondalığa yuvarlanmış tahminleri \(\widehat{\alpha}=5{,}37\) (shape) ve \(\widehat{\theta}=13{,}84\) mDKK’dır (scale). Sağkalım fonksiyonu, yani bir hasarın \(x\)’i aşma olasılığı, gövdede verilmiştir: \(P(X>x)=\left(\theta/(\theta+x)\right)^{\alpha}\).
(a) Sağkalım fonksiyonu bir oranın \(\alpha\)’ncı kuvvetidir. Önce iki oranı hesaplarız:
\[ \begin{aligned} \frac{13{,}84}{13{,}84+10}&=\frac{13{,}84}{23{,}84}=0{,}5805,\\[3pt] \frac{13{,}84}{13{,}84+50}&=\frac{13{,}84}{63{,}84}=0{,}2168. \end{aligned} \]
Buradan \(P(X>10)=0{,}5805^{5{,}37}\) \(=0{,}0539\) ve \(P(X>50)=0{,}2168^{5{,}37}\) \(=0{,}000272\).
Model 10 mDKK’nın üstünü %5,4 olasılıkla bekler. 2.167 hasarda bu \(2.167\times0{,}0539=116{,}8\) hasar demektir; veride 109 hasar, yani \(109/2.167=\%5{,}03\) vardır.
(b) \(\alpha=2\) alınınca yalnızca üs değişir:
\[ P(X>50)=0{,}2168^{2}=0{,}0470, \]
yani yaklaşık %4,7. Bu, \(\alpha=5{,}37\) ile bulunan olasılığın \(0{,}0470/0{,}000272\approx173\) katıdır.
Taban \(\theta/(\theta+x)\) 1’den küçük olduğu için üs küçüldükçe kuvvet büyür. Büyük \(x\)’te \(x\) iki katına çıkınca olasılık yaklaşık \(2^{\alpha}\)’ya bölünür (Üç adayın kuyruğu): \(\alpha=5{,}37\) iken \(2^{5{,}37}=41{,}4\)’e, \(\alpha=2\) iken 4’e. Kuyruğun ağırlığını \(\alpha\) belirler.
(c) Uydurulan parametrelerle
\[ \begin{aligned} E[X]&=\frac{13{,}84}{5{,}37-1}\\ &=\frac{13{,}84}{4{,}37}=3{,}17\ \text{mDKK}. \end{aligned} \]
Verinin örnek ortalaması 3,385 mDKK’dır. Model ortalaması üç ondalıkla \(13{,}84/4{,}37=3{,}167\)’dir; model ortalamayı \((3{,}385-3{,}167)/3{,}385\) \(=0{,}064\), yani %6,4 düşük verir, ama aynı büyüklüktedir.
Formül gövdeden gelir (Sıfır başlangıçlı Pareto / Pareto II): ortalama sağkalım fonksiyonunun altındaki alandır ve bu alan yalnız \(\alpha>1\) iken sonludur; \(\alpha\le1\)’de sınırsız büyür, yani ortalama sonsuzdur.
\(\alpha=0{,}80\) ile model sonlu bir risk primi (risk premium), yani hasar başına beklenen tutara dayanan bir prim üretemez; bu yüzden parametre tahminleri yalnız AIC ile değil, ortalamanın ve varyansın sonlu olup olmadığına bakılarak da denetlenir. Bu uyumda \(\widehat{\alpha}=5{,}37>2\) olduğu için ikisi de sonludur.
Alıştırma 5 (AIC’yi elle hesaplama). fitdistrplus::fitdist(), dersin Danish verisinde (\(n=2.167\) pozitif hasar) eşiği yok sayan uyumlarda aşağıdaki log-olabilirlikleri üretir. Üç modelin de iki parametresi vardır.
| Model | Log-olabilirlik \(\ell\) | Parametre sayısı \(k\) |
|---|---|---|
| Lognormal | −4.057,897 | 2 |
| Gamma | −4.767,096 | 2 |
| Pareto II | −4.622,833 | 2 |
(a) Ceza terimi her modelde \(2k=4\)’tür; log-olabilirliği \(-2\) ile çarpıp 4 ekleriz:
| Model | \(-2\ell\) | \(2k\) | AIC |
|---|---|---|---|
| Lognormal | 8.115,794 | 4 | 8.119,794 |
| Gamma | 9.534,192 | 4 | 9.538,192 |
| Pareto II | 9.245,666 | 4 | 9.249,666 |
İki ondalığa yuvarlanınca bunlar, gövdenin sıralama tablosunda (buyukluk_karsilastirma) yazdırılan 8.119,79; 9.538,19 ve 9.249,67’dir.
(b) AIC’de küçük olan iyidir. Sıralama lognormal (8.119,79), Pareto II (9.249,67) ve Gamma (9.538,19) biçimindedir. En iyi ile ikinci arasındaki fark \(9.249{,}666-8.119{,}794\) \(=1.129{,}872\)’dir.
Gövdedeki kurala göre (Adayları sıralamak) AIC farkı 10’u aşınca zayıf model için destek neredeyse kalmaz; buradaki fark bu sınırın yüz katından fazladır.
(c) İki modelin AIC farkında aynı türden terimler bir araya toplanır:
\[ \begin{aligned} &\mathrm{AIC}_1-\mathrm{AIC}_2\\ &=(-2\ell_1+2k_1)-(-2\ell_2+2k_2)\\ &=-2(\ell_1-\ell_2)+2(k_1-k_2). \end{aligned} \]
\(k_1=k_2\) olduğunda ikinci terim sıfırdır: \(2k\) bütün modellere aynı sabiti ekler ve sıralama yalnız log-olabilirliğe indirgenir. Ceza terimi ancak parametre sayıları farklı olduğunda sıralamayı değiştirebilir; örneğin iki parametreli lognormal ile üç parametreli bir karışım dağılımı karşılaştırıldığında. Ayrıca AIC’nin karşılaştırılabilir olması için üç modelin de aynı veriye ve aynı ölçeğe uydurulmuş olması gerekir (Alıştırma 13).
(d) \(\log 2.167=7{,}681\), yani her modelde \(k\log n=2\cdot7{,}681\) \(=15{,}362\)’dir:
| Model | \(-2\ell\) | \(k\log n\) | BIC |
|---|---|---|---|
| Lognormal | 8.115,794 | 15,362 | 8.131,156 |
| Gamma | 9.534,192 | 15,362 | 9.549,554 |
| Pareto II | 9.245,666 | 15,362 | 9.261,028 |
Sıralama değişmez: \(k\) eşit olduğu için her modelin BIC’si AIC’sinden aynı \(k\log n-2k=k(\log n-2)\) kadar büyüktür (Adayları sıralamak). Burada \(2\,(7{,}681-2)\) \(=2\cdot5{,}681=11{,}362\).
(e) İki ölçüt de \(-2\ell\)’ye bir ceza ekler: A için \(-2\cdot(-200)=400\), B için \(-2\cdot(-197{,}5)=395\). AIC’nin cezası \(2k\), BIC’ninki \(k\log n\)’dir ve \(\log 100=4{,}605\):
\[ \begin{aligned} \mathrm{AIC}_A&=400+2{\cdot}2=404,\\ \mathrm{AIC}_B&=395+2{\cdot}4=403,\\ \mathrm{BIC}_A&=400+2{\cdot}4{,}605=409{,}21,\\ \mathrm{BIC}_B&=395+4{\cdot}4{,}605=413{,}42. \end{aligned} \]
AIC B’yi, BIC A’yı seçer.
B’nin log-olabilirlikteki üstünlüğü \(-2\ell\) ölçeğinde 5 birimdir. AIC iki fazla parametre için 4 birim ceza keser, BIC ise \(2\log 100=9{,}21\): kazanç birinde cezayı aşar, öbüründe aşmaz.
\(n\) gözlemde \(\mathrm{BIC}_A=2\log n+400\) ve \(\mathrm{BIC}_B=4\log n+395\)’tir. BIC’nin de B’yi seçmesi için \(\mathrm{BIC}_B<\mathrm{BIC}_A\) olmalıdır. İki yandan \(2\log n+395\) çıkarılır, iki yan 2’ye bölünür ve üssü alınır:
\[ \begin{aligned} 4\log n+395&<2\log n+400\\ 2\log n&<5\\ \log n&<2{,}5\\ n&<e^{2{,}5}\approx12{,}2. \end{aligned} \]
Gözlem sayısı en çok 12 olmalıdır: \(n=12\)’de B’nin BIC’si daha küçüktür, \(n=13\)’te A’nınki.
Bu haftanın karşılaştırmalarında iki ölçüt hep aynı modeli seçer: sıklıkta farklar binlerce birimdir, büyüklükte üç adayın parametre sayısı eşittir. Ayrışma, kazancın ceza düzeyinde kaldığı yerde olur.
Alıştırma 6 (★ En düşük AIC ve kuyruk riski). Dersin Danish verisinde \(n=2.167\) hasar vardır. Bir modelde bir hasarın \(x\)’i aşma olasılığı \(S(x)\)’tir; \(n\) hasar içinde \(x\)’i aşanların beklenen sayısı bu yüzden \(n\,S(x)\)’tir. Aşağıdaki tablo her eşik için gözlenen hasar sayısını gövdenin üç modelinin beklediği sayıyla karşılaştırır:
| Eşik (mDKK) | Gözlenen | Lognormal | Gamma | Pareto II |
|---|---|---|---|---|
| 10 | 109 | 37,3 | 83,2 | 117,0 |
| 25 | 24 | 0,75 | 0,34 | 8,5 |
| 50 | 7 | 0,014 | 0,000028 | 0,59 |
(a) Kuyrukta gözlenene en yakın model Pareto II’dir, ama o da yetmez. 10 mDKK’da 109 hasara karşı 117,0 bekler, lognormal ise 37,3 ile üçte birini. 25 ve 50 mDKK’da üç model de gözlenenin çok altındadır: 24 hasara karşı Pareto II 8,5, lognormal 0,75 bekler.
Fark sayımın kendi rastlantısallığıyla açıklanamaz. Poisson’da bir sayımın standart sapması ortalamasının kareköküdür: 8,5 bekleyen bir sayım için \(\sqrt{8{,}5}\approx2{,}9\). Gözlenen 24, beklenenin 15,5 üstündedir; beş standart sapmadan fazla.
AIC’deki farkın kaynağını görmek için iki modelin her hasara verdiği log-yoğunluk farkını üç tutar aralığında toplayalım:
bolge_farki <- tapply(
  dpareto(x, fit_pareto$estimate[["shape"]], fit_pareto$estimate[["scale"]],
          log = TRUE) -
    dlnorm(x, fit_lnorm$estimate[["meanlog"]], fit_lnorm$estimate[["sdlog"]],
           log = TRUE),
  cut(x, c(0, 5, 10, Inf)),
  sum
)
round(bolge_farki, 2)
#> (0,5] (5,10] (10,Inf]
#> -776.97 29.34 182.70dpareto(x, ..., log = TRUE) — her hasarın Pareto II altındaki log-yoğunluğu; 2.167 hasarda toplamı modelin log-olabilirliğidir. Lognormalinki aynı biçimde çıkarılır.cut(x, c(0, 5, 10, Inf)) — hasarları üç tutar aralığına ayırır (Hafta 2); alt sınır 0 olduğu için tam 1 mDKK’lık hasarlar ilk aralığa girer. Pareto II, 5 mDKK’ya kadar olan 1.913 hasarda 776,97 birim geridedir; 5 ile 10 arasındaki 145 hasarda 29,34, 10’un üstündeki 109 hasarda 182,70 birim öndedir. Üç parçanın toplamı log-olabilirlik farkıdır, −564,94; AIC farkının, 1.129,87’nin, yarısı.
Yarısı olmasının nedeni Alıştırma 5(c)’deki farktır: iki modelin de iki parametresi olduğu için AIC farkı log-olabilirlik farkının 2 katıdır.
Log-olabilirlik her hasarı bir kez sayar: 2.167 hasarın 1.913’ü 5 mDKK’nın altındadır ve sıralamayı onlar belirler. 5 mDKK’nın üstündeki \(145+109=254\) hasarda Pareto II toplam \(29{,}34+182{,}70=212{,}04\) birim öndedir. Seçim, işin hangi bölgeye baktığına bağlıdır.
(b) Gamma, 50 mDKK’nın üstünde bir hasarı 2.167 hasarda 0,000028 kez bekler; veride 7 kez görülmüştür, beklenenin yaklaşık 250.000 katı. Böyle bir modelle hesaplanan üç büyüklük sistematik olarak düşük çıkar:
Alıştırma 11 bu sonuncuyu hesaplar. Gamma’nın hafif kuyruğu model ailesinden gelir: yoğunluğu üstel azalır.
(c) İki sorun vardır.
Cümlenin bir de zaman ve kaynak sorunu vardır: veri 1980–1990 dönemine aittir, 1985 fiyatlarına getirilmiştir ve tek bir reasürörün kayıtlarından derlenmiştir. Bugünkü Danimarka için bir tarife düzeyi değildir.
Alıştırma 7 (Aynı sıfırlar, farklı mekanizma). Bir portföyde yıllık hasar sayısının ortalaması 0,2’dir. Üç model bu ortalamayı aynen veriyor: Poisson; \(\theta=0{,}5\) olan negatif binom; \(\pi=0{,}6\) olan sıfır şişkin Poisson.
(a) Negatif binomun varyansı \(\mu+\mu^{2}/\theta\)’dır (Negatif binom bölümü). \(\mu=0{,}2\) ve \(\theta=0{,}5\) ile \(\operatorname{Var}(N)=0{,}2+0{,}2^{2}/0{,}5\) \(=0{,}2+0{,}04/0{,}5\) \(=0{,}2+0{,}08=0{,}28\).
Poisson’da varyans ortalamaya eşittir: 0,2. Negatif binomun varyansı bunun \(0{,}28/0{,}2=1{,}4\) katıdır; fazlası, 0,08, poliçelerin \(\lambda\)’larının birbirinden farklı olmasından gelen gruplar arası parçadır.
(b) Sıfır şişkin Poisson’un ortalaması \((1-\pi)\lambda\)’dır (yapısal sıfır grubunun ortalaması 0, Poisson grubununki \(\lambda\)): \((1-0{,}6)\,\lambda=0{,}4\,\lambda=0{,}2\), yani \(\lambda=0{,}2/0{,}4=0{,}5\).
(c) Üç modelin sıfır olasılığı:
İki alternatif Poisson’dan daha çok sıfır üretir ve birbirine çok yakındır: aralarındaki fark \(0{,}8452-0{,}8426=0{,}0026\), göreli olarak \(0{,}0026/0{,}8426=0{,}003\), yani binde 3’tür.
(d) Poisson: \(P(N=2)=e^{-0{,}2}\,0{,}2^{2}/2!\) \(=0{,}8187\cdot0{,}04/2\) \(=0{,}8187\cdot0{,}02=0{,}0164\).
Negatif binomda \(P(N=2)\), olasılık fonksiyonunun \(k=2\)’deki üç çarpanının çarpımıdır. İlk çarpanda Negatif binom bölümündeki \(\Gamma(\theta+2)=(\theta+1)\,\theta\,\Gamma(\theta)\) kullanılır ve \(\Gamma(\theta)\) sadeleşir:
\[ \begin{aligned} \frac{\Gamma(\theta+2)}{\Gamma(\theta)\,2!} &=\frac{(\theta+1)\,\theta\,\Gamma(\theta)}{\Gamma(\theta)\cdot2}\\ &=\frac{\theta(\theta+1)}{2}\\ &=\frac{0{,}5\cdot1{,}5}{2}=0{,}375. \end{aligned} \]
İkinci çarpan (c)’deki \((0{,}5/0{,}7)^{0{,}5}=0{,}8452\)’dir, üçüncüsü \(\big(\mu/(\theta+\mu)\big)^{2}=(0{,}2/0{,}7)^{2}\):
\[ \begin{aligned} &P(N=2)\\ &=0{,}375\cdot0{,}8452\cdot\Big(\frac{0{,}2}{0{,}7}\Big)^{2}\\ &=0{,}375\cdot0{,}8452\cdot0{,}0816\\ &=0{,}0259. \end{aligned} \]
Sıfır şişkin Poisson’da iki hasar yalnızca Poisson grubundan gelir: \((1-\pi)\,e^{-\lambda}\lambda^{2}/2\). Burada \(\lambda^{2}/2=0{,}5^{2}/2\) \(=0{,}25/2=0{,}125\) ve sonuç \(0{,}4\cdot0{,}6065\cdot0{,}125\) \(=0{,}0303\)’tür.
Sıfırlarda binde 3 olan göreli fark, iki hasar hücresinde \(0{,}0303/0{,}0259=1{,}17\), yani %17’ye çıkar. İki mekanizmayı sıfırlar değil, tablonun geri kalanı ayırır.
claims_long.csv’nin birinci yılında gözlenen ve üç modelin beklediği poliçe sayıları şöyleydi:
| Hasar sayısı | 0 | 1 | 2 | 3 | 4+ |
|---|---|---|---|---|---|
| gözlenen | 34.764 | 3.704 | 875 | 301 | 356 |
| Poisson | 32.253,6 | 6.942,6 | 747,2 | 53,6 | 3,0 |
| negatif binom | 34.817,3 | 3.293,9 | 1.079,0 | 437,2 | 372,7 |
| sıfır şişkin Poisson | 34.764,0 | 2.885,0 | 1.577,2 | 574,8 | 198,9 |
Sıfır şişkin Poisson sıfır hücresini 34.764 ile tam tutturur, çünkü maksimum olabilirlikte uydurulan sıfır sayısı gözlenene eşittir (sıklık bölümündeki zip_kontrol); bedelini bir hasar hücresinde 819 poliçe eksik, iki hasar hücresinde 702 poliçe fazla bekleyerek öder.
Negatif binom aynı iki hücrede daha az yanılır: 410 poliçe eksik, 204 poliçe fazla bekler.
Bu alıştırmalar hesaplamadan çok, kullanılan ölçünün anlamını ve analizin sınırlılıklarını kısa biçimde tartışmak içindir. Önce yanıtınızı oluşturun, ardından ilgili Çözümü göster düğmesiyle karşılaştırın.
Alıştırma 8 (Sıfırlar ve büyüklük modeli). Hasarsız poliçeleri pozitif büyüklük modeline eklemek neden yanlıştır?
Yanıtın iki yanı vardır: kavramsal bir hata ve onun hesaptaki üç farklı izi.
Kavram. Hasarsız bir poliçe “0 TL büyüklüğünde bir hasar” değil, hiç hasar olmaması demektir. Bu bilgi \(S=X_1+\cdots+X_N\) kuruluşunda \(N\)’ye, yani sıklık modeline aittir; \(X\) yalnızca gerçekleşmiş hasarların tutarıdır. Sıfırlar \(X\) dağılımına karıştırılırsa ortalama ve kuantiller aşağı çekilir: Alıştırma 1’in dört hasarına iki poliçenin sıfırı eklenirse ortalama \(66.000/4=16.500\) TL’den \(66.000/6=11.000\) TL’ye iner.
Bu 11.000 TL hiçbir sorunun yanıtı değildir: payda dört hasar ile iki poliçenin toplamıdır. Hasar başına büyüklük 16.500 TL, poliçe başına toplam tutar ise Alıştırma 1’deki 13.200 TL’dir.
Hesaptaki izi. Danish verisine 300 sıfır ekleyip üç modeli, gövdenin ilk uyumları gibi eşiği yok sayarak, yeniden uyduralım:
sifirli_hasar <- c(x, rep(0, 300))
summary(sifirli_hasar)
#> Min. 1st Qu. Median Mean 3rd Qu. Max.
#> 0.000 1.170 1.642 2.973 2.670 263.250Lognormal \(\log 0=-\infty\) yüzünden hemen hata verir; Gamma ise vermez:
sifirli_gamma <- fitdistrplus::fitdist(sifirli_hasar, "gamma")
round(rbind(
  sifirsiz = c(n = fit_gamma$n, fit_gamma$estimate,
               log_olabilirlik = fit_gamma$loglik),
  sifirli = c(n = sifirli_gamma$n, sifirli_gamma$estimate,
              log_olabilirlik = sifirli_gamma$loglik)
), 4)
#> n shape rate log_olabilirlik
#> sifirsiz 2167 1.2975 0.3833 -4767.096
#> sifirli 2467 1.2977 0.3833 -4767.096Sonuç nesnesi 2.467 gözlem kullandığını yazar, ama log-olabilirlik sıfırsız verideki −4.767,096’nın aynısıdır ve tahminler ancak dördüncü ondalıkta ayrılır (shape 1,2975’e karşı 1,2977).
Sıfırlar hesaba fiilen girmemiştir. Nedeni şudur: şekil parametresi \(\alpha\) 1’den büyükken Gamma yoğunluğundaki \(x^{\alpha-1}\) çarpanı \(x=0\)’da 0’dır; burada \(\alpha=1{,}2975\) ve \(0^{0{,}2975}=0\). Yoğunluk 0, logaritması \(-\infty\) olur ve fitdist() olabilirliği toplarken sonlu olmayan terimleri sessizce atlar. Kendi bilgisayarınızda göreceğiniz tek iz bir “NaNs produced” uyarısıdır.
Pareto II’de sıfırlar olabilirliğe girer, çünkü 0’daki yoğunluğu sonludur. Sıfır başlangıçlı Pareto / Pareto II bölümündeki yoğunlukta \(x=0\) konur ve \(\theta^{\alpha+1}=\theta^{\alpha}\,\theta\) yazılır:
\[ \begin{aligned} f(0)&=\frac{\alpha\,\theta^{\alpha}}{(\theta+0)^{\alpha+1}}\\ &=\frac{\alpha\,\theta^{\alpha}}{\theta^{\alpha}\,\theta}\\ &=\frac{\alpha}{\theta}=\frac{5{,}37}{13{,}84}=0{,}388. \end{aligned} \]
sifirli_pareto <- fitdistrplus::fitdist(
  sifirli_hasar, "pareto",
  start = list(shape = 2, scale = mean(sifirli_hasar)),
  lower = c(shape = 1e-6, scale = 1e-6)
)
round(rbind(
  sifirsiz = c(fit_pareto$estimate,
               ortalama = fit_pareto$estimate[["scale"]] /
                 (fit_pareto$estimate[["shape"]] - 1)),
  sifirli = c(sifirli_pareto$estimate,
              ortalama = sifirli_pareto$estimate[["scale"]] /
                (sifirli_pareto$estimate[["shape"]] - 1))
), 2)
#> shape scale ortalama
#> sifirsiz 5.37 13.84 3.17
#> sifirli 4.04 8.36 2.75Sıfırlar dağılımı aşağı çeker: \(\alpha\) 5,37’den 4,04’e, \(\theta\) 13,84’ten 8,36’ya iner ve model ortalaması \(\theta/(\alpha-1)\) 3,17 mDKK’dan 2,75 mDKK’ya düşer.
Hata alınmadığı için Gamma ve Pareto II’deki iki durum, lognormaldeki açık hatadan daha tehlikelidir: biri sıfırları sessizce yok sayar, öbürü onlarla sessizce başka bir dağılım uydurur. Sıfırların neden oluştuğunu belirtmeden aynı sütuna iki modeli birden uygulamak, notun başında, Toplam hasar bölümünde uyarılan hatadır.
Alıştırma 9 (Aşırı yayılım uyarısı). Hasar sayılarının varyansı ortalamalarından çok büyükse hangi uyarıyı alırız?
Aldığımız uyarı aşırı yayılım şüphesidir: veri, Poisson’un \(\operatorname{Var}(N)=E[N]\) kısıtıyla bağdaşmıyor olabilir. Uyarının üç yanı vardır.
Tahmini değil, belirsizliği etkiler. \(\widehat{\lambda}\) hâlâ makul bir ortalama tahminidir. Ama Poisson standart hatayı varyansın yerine ortalamayı koyarak hesaplar; varyans ortalamanın \(\phi\) katıysa gerçek standart hata bunun \(\sqrt{\phi}\) katıdır (Poisson’u uydurmak). claims_long.csv’nin birinci yılında \(\phi=3{,}1075\)’tir; gerçek standart hata Poisson’un verdiği 0,00232 değil, yaklaşık \(0{,}00232\cdot\sqrt{3{,}1075}\) \(=0{,}00232\cdot1{,}763=0{,}0041\)’dir. Güven aralıkları olduğundan dar, anlamlılık kararları fazla iddialı çıkar.
Nedeni söylemez. Aynı belirtiyi dört farklı neden üretir; ilk üçü Poisson ne zaman yetersiz kalabilir? bölümünde anlatıldı:
Küçük örneklemde kanıt değildir. Alıştırma 2’de fazlalığın tamamı tek bir gözlemden geliyordu; o gözlem çıkarılınca oran 2’den 1,08’e iniyordu.
Doğru yanıt modeli hemen değiştirmek değil, önce farklı gözlem sürelerini maruziyetle hesaba katmak (Hafta 10’daki ofset), sonra Poisson’u bir alternatifle aynı veride karşılaştırmaktır. Sıklık bölümü bunu claims_long.csv’de yaptı; ki-kare uyum testi 0, 1, 2, 3 ve 4+ hücreleriyle üç modele uygulanmıştı. Yarı-Poisson bir olasılık dağılımı tanımlamadığı için AIC’si ve ki-karesi yoktur:
| Model | AIC | Ki-kare uyum istatistiği | Ne gösterdi |
|---|---|---|---|
| Poisson | 51.592,54 | 44.213 | 4+ hücresinde 356 poliçe yerine 3,0 bekler |
| negatif binom | 42.151,56 | 132,9 | en iyi aday, ama \(p\approx10^{-29}\): tam oturmaz |
| sıfır şişkin Poisson | 44.611,96 | 799,7 | sıfırları tutturur, 1 ve 2 hasar hücrelerinde yanılır |
| yarı-Poisson | — | — | \(\widehat{\phi}=3{,}1075\); standart hataları \(\sqrt{3{,}1075}=1{,}763\) katına çıkarır |
Alıştırma 10 (Logaritmik ölçek ve ortalama). Lognormal meanlog, para birimindeki ortalama hasar mıdır? Değilse, uydurulan lognormalin ortalamasının medyanına oranını sdlog cinsinden yazın, Danish verisi için hesaplayın ve sdlog büyüdükçe bu oranın nasıl değiştiğini söyleyin.
Hayır. meanlog, tutarların değil logaritmalarının ortalamasıdır; logaritmik ölçekte bir konum parametresidir ve mDKK biriminde okunamaz. Gövdenin eşiği yok sayan uyumunda \(\widehat{\mu}=0{,}7870\) bulunmuştu. Üssü \(\exp(0{,}7870)=2{,}20\) mDKK ortalama değil, uydurulan lognormalin medyanıdır (Alıştırma 3(c)).
Lognormalin ortalaması \(E[X]=\exp(\mu+\sigma^{2}/2)\)’dir (Lognormal bölümü). Ortalamanın medyana oranında üs iki çarpana ayrılır (\(e^{a+b}=e^{a}e^{b}\)) ve \(e^{\mu}\) sadeleşir:
\[ \begin{aligned} \frac{E[X]}{\text{medyan}}&=\frac{e^{\mu+\sigma^{2}/2}}{e^{\mu}}\\ &=\frac{e^{\mu}\,e^{\sigma^{2}/2}}{e^{\mu}}\\ &=e^{\sigma^{2}/2}. \end{aligned} \]
Oran meanlog’dan bağımsızdır, yalnızca sdlog’a bağlıdır. Danish verisinde \(\widehat{\sigma}=0{,}7166\) ve medyan 2,20 mDKK ile:
\[ \begin{aligned} \frac{\widehat{\sigma}^{2}}{2}&=\frac{0{,}7166^{2}}{2}\\ &=\frac{0{,}51352}{2}=0{,}2568,\\ e^{0{,}2568}&=1{,}29,\\ E[X]&=2{,}20\cdot1{,}29\\ &=2{,}84\ \text{mDKK}. \end{aligned} \]
Model ortalaması örnek ortalamasının (3,39 mDKK) \(1-2{,}84/3{,}39=0{,}16\), yani %16 altında kalır.
Fark eşiği yok saymaktan gelir: bu model olasılığının %13,6’sını hiç gözlem olmayan 1 mDKK’nın altına koyar ve kuyruğu hafiftir. Örnek ortalaması ise büyük hasarlara duyarlıdır.
sdlog büyüdükçe oran hızla büyür, çünkü \(\sigma\) üste karesiyle girer: \(\sigma=1\) için \(e^{0{,}5}=1{,}65\), \(\sigma=2\) için \(e^{2}=7{,}39\). \(\sigma\) iki katına çıkınca üs dört katına çıkar.
sdlog da tutarın standart sapması değil, logaritmasının standart sapmasıdır. Para birimindeki bir büyüklüğü rapor edecekseniz dönüşümü açıkça yapıp hangi ölçüyü (medyan mı, ortalama mı) verdiğinizi yazmalısınız.
Alıştırma 11 (Kuyruk seçimi ve sermaye). Büyük hasarlar için ağır kuyruk seçimi prim ve sermayeyi nasıl etkileyebilir?
Ağır kuyruklu bir model, aynı gövdeye uyarken büyük hasarlara belirgin biçimde daha fazla olasılık verir. Bu, kuyruğa bakan üç büyüklüğü yükseltir: büyük hasar yükünü, riske dayalı sermaye ihtiyacını ve önceliğin üstündeki reasürans katmanının fiyatını (üçünün tanımı Alıştırma 6(b)’de). Tersi de doğrudur: kuyruğu hafif bir model seçmek primi ve sermayeyi sistematik olarak düşük hesaplatır.
Etkiyi reasürans katmanında ölçelim. Öncelik \(d\) olan bir hasar fazlası anlaşmasında reasürör her hasarın \(d\)’yi aşan kısmını, \(\max(X-d,\,0)\)’ı öder; hasar başına beklenen ödeme, aşma olasılığının \(d\)’den sonraki alanıdır (gövdedeki alan düşüncesi, Sıfır başlangıçlı Pareto / Pareto II):
\[ E[\max(X-d,\,0)]=\int_d^{\infty}S(t)\,dt . \]
Veride aynı büyüklük, her hasarın \(d\)’yi aşan kısmının ortalamasıdır. İki öncelik için üç modelle hesaplayalım:
oncelik_ustu_beklenen <- function(d) {
  c(veri = mean(pmax(x - d, 0)),
    Lognormal = integrate(function(t) plnorm(t,
      meanlog = fit_lnorm$estimate[["meanlog"]],
      sdlog = fit_lnorm$estimate[["sdlog"]], lower.tail = FALSE),
      d, Inf)$value,
    Gamma = integrate(function(t) pgamma(t,
      shape = fit_gamma$estimate[["shape"]],
      rate = fit_gamma$estimate[["rate"]], lower.tail = FALSE),
      d, Inf)$value,
    `Pareto II` = integrate(function(t) ppareto(t,
      shape = fit_pareto$estimate[["shape"]],
      scale = fit_pareto$estimate[["scale"]], lower.tail = FALSE),
      d, Inf)$value)
}
oncelik_ustu_tablosu <- rbind(`d = 10` = oncelik_ustu_beklenen(10),
                              `d = 25` = oncelik_ustu_beklenen(25))
signif(oncelik_ustu_tablosu, 3)
#> veri Lognormal Gamma Pareto II
#> d = 10 0.708 0.05780 0.106000 0.295
#> d = 25 0.342 0.00192 0.000415 0.035pmax(x - d, 0) — Hafta 2’de gördüğümüz pmax(): her hasar için \(x-d\) ile 0’ın büyüğünü alır.Öncelik 10 mDKK iken veri hasar başına 0,708 mDKK’lık bir reasürans ödemesi gösterir. Pareto II 0,295 ile bunun %42’sini bekler, Gamma 0,106 ile %15’ini, lognormal 0,0578 ile %8’ini.
Öncelik 25 mDKK’ya çıkınca veri 0,342 gösterir. Pareto II 0,0350 ile onda birini bekler, lognormal 0,00192 ile binde altısını, Gamma 0,000415 ile binde birini.
Üç model de katmanı düşük fiyatlar; kuyruğu en ağır olan Pareto II bile, çünkü uydurulan \(\widehat{\alpha}=5{,}37\) onun kuyruğunu inceltir (Kuyruk: Q–Q grafiği ve yüksek kuantiller).
Parametrenin ne anlama geldiği de bu karara girer: Pareto II’de \(\alpha\le1\) olduğunda ortalama sonsuzdur (Alıştırma 4(c)) ve model sonlu bir risk primi üretemez. Bütün bu sayılar öğretim örneğidir; enflasyon düzeltmeli, seçilim eşiğinin üstünde toplanmış tarihsel bir veriden güncel bir tarife düzeyi çıkarılamaz.
Alıştırma 12 (AIC ve kuyruk uyumu). En düşük AIC’li modelin Q–Q grafiği kuyrukta kötüyse ne yaparsınız? Notun Danish verisinde bu durum ortaya çıktı: AIC’de birinci olan lognormal kuyruğu çok küçük tahmin ediyordu. Verinin ve modellerin kuyruk kuantilleri (mDKK) ile AIC’leri:
| %99 kuantili | %99,9 kuantili | AIC | |
|---|---|---|---|
| veri | 26,04 | 131,55 | — |
| Lognormal | 11,63 | 20,11 | 8.119,79 |
| Gamma | 13,71 | 19,98 | 9.538,19 |
| Pareto II | 18,80 | 36,28 | 9.249,67 |
Bu, yanıtı “duruma bağlı” olan ama ölçütü net bir sorudur: karar hangi bölgeye bakıyorsa model o bölgeye göre seçilir.
Önce tablodaki durumu ölçelim. Lognormal %99 kuantilinde verinin \(11{,}63/26{,}04=0{,}45\) katına, %99,9’da \(20{,}11/131{,}55=0{,}15\) katına ulaşır. Kuyruğa en yakın model AIC’de ikinci olan Pareto II’dir, ama o da yetmez: \(18{,}80/26{,}04=0{,}72\) ve \(36{,}28/131{,}55=0{,}28\).
AIC sıralamasını gövdedeki hasarlar belirler (Alıştırma 6(a)). Sorunun bir kaynağı da modellerin kuruluşudur: üç uyum da eşiği yok sayar ve olasılığın bir bölümünü hiç gözlem olmayan 1 mDKK’nın altına koyar (Gövde: histogram ve uydurulan yoğunluklar). Kuyruk kuantilleriyle karşılaştırmanın da bir sınırı vardır: verinin %99,9 kuantili tek bir sıçramaya dayanır; en büyük hasar dosyada olmasaydı 64,34 mDKK çıkardı.
Yapılmaması gereken şey, uyumu düzeltmek için büyük gözlemleri silmektir: onlar gürültü değil, modellenmesi gereken riskin kendisidir. Görev A’da en büyük %1’lik 22 hasar toplam tutarın %17,57’sini taşıyordu. Hangi modelin neden ve hangi bölge için seçildiği raporda açıkça yazılır.
Alıştırma 13 (Ölçek değişimi ve parametreler). Verinin para birimini değiştirmek hangi parametreleri ve hangi sonuçları değiştirir? Notta Danish verisine (mDKK) eşiği yok sayarak uydurulan parametreler ve AIC’ler şunlardı:
| Model | Parametreler | AIC |
|---|---|---|
| Lognormal | meanlog = 0,7870, sdlog = 0,7166 |
8.119,79 |
| Gamma | shape = 1,2975, rate = 0,3833 |
9.538,19 |
| Pareto II | shape (\(\alpha\)) = 5,3670, scale (\(\theta\)) = 13,8366 |
9.249,67 |
Tutarları bir \(c>0\) sabitiyle çarpalım: \(Y=cX\). Üç şeyi ayrı ayrı izleyelim.
1. Parametreler. Ölçek parametreleri \(c\) katına çıkar, şekil parametreleri değişmez:
meanlog \(\mu+\log c\) olur, sdlog aynı kalır.rate \(c\)’ye bölünür, shape değişmez (Gamma bölümü).scale \(c\) katına çıkar, \(\alpha\) değişmez (Sıfır başlangıçlı Pareto / Pareto II bölümü).Danish verisinde mDKK’dan bin DKK’ya geçelim (\(c=1000\)):
bin_dkk_uyumlari <- list(
  lognormal = fitdistrplus::fitdist(x * 1000, "lnorm"),
  gamma = fitdistrplus::fitdist(x * 1000, "gamma")
)
signif(rbind(
  mDKK = c(fit_lnorm$estimate, fit_gamma$estimate),
  bin_DKK = c(bin_dkk_uyumlari$lognormal$estimate,
              bin_dkk_uyumlari$gamma$estimate)
), 6)
#> meanlog sdlog shape rate
#> mDKK 0.78695 0.716555 1.29754 0.383286000
#> bin_DKK 7.69471 0.716555 1.29723 0.000383266meanlog 0,78695’ten 7,69471’e çıkar; fark \(7{,}69471-0{,}78695\) \(=6{,}90776\), tam olarak \(\log 1000\)’dir. sdlog 0,716555’te kalır.
Gamma’da rate 0,383286’dan 0,000383266’ya, yani binde birine iner. shape kuramda aynı kalmalıdır; 1,29754’ten 1,29723’e oynaması, sayısal aramanın biraz farklı bir yerde durmasıdır.
2. Log-olabilirlik ve AIC. Bunlar değişir, çünkü yoğunluk birim başınadır. \(Y=cX\)’in dağılım fonksiyonu \(X\)’inkinden gelir; yoğunluk onun türevidir ve zincir kuralı, içteki \(y/c\)’nin türevi olan \(1/c\) çarpanını getirir:
\[ \begin{aligned} F_Y(y)&=P(cX\le y)\\ &=P(X\le y/c)=F_X(y/c),\\ f_Y(y)&=\frac{d}{dy}F_X(y/c)\\ &=f_X(y/c)\cdot\frac{1}{c}. \end{aligned} \]
Logaritma alınınca çarpan bir çıkarma olur: \(\log f_Y(y)=\log f_X(y/c)-\log c\). Her gözlemde \(y_i/c=x_i\) olduğu için \(n\) gözlemin toplamında \(\log c\) \(n\) kez çıkar; AIC \(\ell\)’yi \(-2\) ile çarptığı için kayma \(+2n\log c\) olur:
\[ \begin{aligned} \ell_Y&=\sum_{i=1}^{n}\big[\log f_X(x_i)-\log c\big]\\ &=\ell_X-n\log c,\\ \mathrm{AIC}_Y&=2k-2\ell_Y\\ &=2k-2\ell_X+2n\log c\\ &=\mathrm{AIC}_X+2n\log c . \end{aligned} \]
Danish’te \(2n\log c=2\cdot2.167\cdot6{,}90776\) \(=4.334\cdot6{,}90776\) \(=29.938{,}2\). Bu kayma bütün modellere aynı miktarda uygulandığından farklar korunur:
round(c(
  lognormal_kaymasi = bin_dkk_uyumlari$lognormal$aic - fit_lnorm$aic,
  formul_2n_log_c = 2 * length(x) * log(1000),
  gamma_eksi_lognormal_mDKK = fit_gamma$aic - fit_lnorm$aic,
  gamma_eksi_lognormal_bin_DKK = bin_dkk_uyumlari$gamma$aic -
    bin_dkk_uyumlari$lognormal$aic
), 1)
#> lognormal_kaymasi formul_2n_log_c
#> 29938.2 29938.2
#> gamma_eksi_lognormal_mDKK gamma_eksi_lognormal_bin_DKK
#> 1418.4 1418.4Lognormalin AIC’si 8.119,8’den 38.058,0’a, yani tam 29.938,2 kadar kayar. Lognormal ile Gamma arasındaki AIC farkı iki ölçekte de 1.418,4’tür.
Gözlemlerin sırası, Q–Q görüntüsü ve model sıralaması aynı kalır; ham AIC değerleri ise ancak aynı veriye ve aynı ölçeğe uydurulmuş modeller arasında karşılaştırılabilir. Bu yüzden bir dönüşüm yapıldığında raporda mutlaka belirtilmelidir.
3. Başlangıç değeri. Kuramda Pareto II’de de yalnızca scale değişmelidir; sayısal sonuç ise aramanın başlangıç değerine bağlıdır. Notun start = list(shape = 2, scale = mean(x)) ile başlayan Pareto çağrısı bin DKK’da “error code 7” ile durur: lower = sınırlarıyla kullanılan eniyileme yineleme sınırına ulaşıp yakınsamamıştır.
Kron biriminde (\(c=10^{6}\)) aynı çağrı hata vermez ama tepeye ulaşmadan durur: \(\alpha\) 1,78’de kalır ve AIC’si, doğru çözümün kron birimine kaydırılmış AIC’sinden 275,03 birim kötüdür.
Başlangıç ölçeğe uydurulunca (bin DKK’da \(\alpha=5\), \(\theta=14.000\)) arama tepeyi bulur: \(\alpha=5{,}391\), \(\theta=13.909\). Bu tahmin mDKK’daki 5,367 ve 13,837’den (bin DKK’da 13.837) biraz farklıdır, ama AIC farkı yalnızca 0,002’dir: olabilirlik bu doğrultuda neredeyse düzdür.
Notun Pareto uyumundaki uyarı bunun içindir: eniyileme algoritmasını öğrenci yazmaz, ama başlangıç değerinin makul olması ve yakınsama uyarılarının incelenmesi gerekir.
fitdist(), başlangıç değerleri ve uyum grafikleri. doi:10.18637/jss.v064.i04claims_long.csv’nin kaynağı olan ClaimsLong benzetim verisi bu kitabın araç sigortası verisine dayanır; kopyanın kaynağı ve lisansı data_manifest.csv içinde kayıtlıdır.MASS paketi ve negatif binom GLM’i, glm.nb().fitdistrplus paketindeki danishuni veri açıklaması. Derste veriyi bu paketten değil, Veri dosyaları bölümündeki bağlantıdan indirilen ve dönem boyunca değişmeyen ders kopyasından okuyoruz; kopyanın kaynağı ve lisansı data_manifest.csv içinde kayıtlıdır. Paket belgesinin gösterdiği kaynak Embrechts, P., Klüppelberg, C. ve Mikosch, T. (1997). Modelling Extremal Events for Insurance and Finance. Springer; verinin kullanıldığı çalışma McNeil, A. J. (1997). Estimating the tails of loss severity distributions using extreme value theory. ASTIN Bulletin, 27(1), 117–137. doi:10.2143/AST.27.1.563210